> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Point aggregation
> Understand the two point aggregation modes for W&B line plots: 전체 충실도 bucketed sampling and random sampling.
선형 플롯에서 포인트 집계 방법을 사용하여 데이터 시각화의 정확도와 성능을 개선하세요. 이 페이지에서는 사용 가능한 두 가지 집계 모드와 각 모드를 설정하는 방법을 설명합니다. 이를 통해 워크스페이스에 적합한 세부 수준과 렌더링 속도 간의 균형을 선택할 수 있습니다. 사용 가능한 포인트 집계 모드는 [전체 충실도](#full-fidelity)와 [랜덤 샘플링](#random-sampling)의 두 가지 유형입니다. W\&B는 기본적으로 전체 충실도 모드를 사용합니다.
전체 충실도
전체 충실도는 기본 집계 방법으로, 데이터의 극값을 보존합니다. 이 섹션에서는 전체 충실도의 작동 방식, 주요 장점, 단일 차트 또는 전체 워크스페이스에서 활성화하는 방법을 설명합니다.
전체 충실도 모드를 사용하면 W\&B가 x축을 동적 버킷으로 나눕니다. 선당 포인트 수는 차트 크기와 run 수에 맞춰 조정됩니다. 각 버킷 내 최솟값과 최댓값을 계산하고(선택적으로 음영 표시에 사용), 각 버킷의 마지막 값(평균값이 아님)을 사용하여 주 선을 그립니다.
포인트 집계에 전체 충실도 모드를 사용하면 세 가지 주요 장점이 있습니다:
* 극값 및 급등 보존: 데이터의 극값과 급등을 유지합니다.
* 최소 및 최대 포인트의 표시 방식 설정: W\&B App에서 대화형으로 극값(최소/최대)을 음영 영역으로 표시할지 결정할 수 있습니다.
* 데이터 충실도를 유지하며 데이터 탐색: 특정 데이터 포인트를 확대하면 W\&B가 x축 버킷 크기를 다시 계산합니다. 따라서 정확도를 유지하면서 데이터를 탐색할 수 있습니다. W\&B는 이전에 계산한 집계 결과를 캐시에 저장하여 로딩 시간을 줄이며, 이는 대규모 데이터셋을 탐색할 때 유용합니다.
전체 충실도 선형 플롯을 표시하는 방법은 두 가지입니다:
* **밴드** (기본값): 각 버킷 내 최솟값과 최댓값을 음영 밴드로 표시하고, 선은 전체 추세를 보여줍니다.
* **선**: 포인트를 직접 연결하여 급등과 급락을 더 쉽게 파악할 수 있습니다.
전체 충실도 켜기
W\&B는 기본적으로 전체 충실도 모드를 사용합니다. 수동으로 설정하려면 다음 단계를 따르세요:
1. 워크스페이스로 이동하세요.
2. 화면 오른쪽 상단의 **Add panels** 버튼 왼쪽에 있는 톱니바퀴 아이콘을 선택하세요.
3. 나타나는 UI 슬라이더에서 **선형 플롯**을 선택하세요.
4. **포인트 집계** 섹션에서 **전체 충실도**를 선택하세요.
5. **전체 충실도 display** 드롭다운에서 **밴드** 또는 **선**을 선택하세요.
6. **Smoothing** 알고리즘과 설정을 구성하세요.
7. **Aggregation**을 **평균**, **최소** 또는 **최대**로 설정하세요.
8. **Apply**를 클릭하세요.
1. 워크스페이스로 이동하세요.
2. 왼쪽 탭에서 **워크스페이스** 아이콘을 선택하세요.
3. 설정하려는 선형 플롯 패널에 마우스를 올린 다음 톱니바퀴 아이콘을 클릭하세요.
4. 나타나는 모달에서 **포인트 집계 방법**을 **전체 충실도**로 설정하세요.
5. **전체 충실도 display** 드롭다운에서 **밴드** 또는 **선**을 선택하세요.
6. **Smoothing** 알고리즘과 설정을 구성하세요.
7. **Apply**를 클릭하세요.
음영은 각 버킷 내의 변동성을 시각화하여 포인트가 선 주위에 얼마나 퍼져 있는지 확인할 수 있게 합니다. 전체 충실도 선형 플롯의 음영 영역은 다음을 표시할 수 있습니다:
* **최소/최대**: 각 X축 포인트에서 최솟값과 최댓값 사이의 영역에 음영을 표시합니다. 음영 영역은 각 버킷에서 가장 낮은 값부터 가장 높은 값까지 모든 포인트를 보여줍니다:
```math theme={"system"}
\text{Min/Max Range} = [\min(x_1, x_2, \ldots, x_n),\ \max(x_1, x_2, \ldots, x_n)]
```
여기서 $x_1, x_2, \ldots, x_n$은 해당 버킷의 값입니다.
* **표준 편차**: 각 X축 포인트에서 표준 편차를 사용하여 값의 변동성을 계산하고, 결과 영역에 음영을 표시합니다.
```math theme={"system"}
SD = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \overline{x})^2}
```
* **표준 오차**: 각 X축 포인트에서 값을 표본 크기의 제곱근으로 나누어 표본 오차의 가능성을 계산합니다:
```math theme={"system"}
SE = \frac{SD}{\sqrt{n}}
```
* **없음**: 음영을 표시하지 않습니다(기본값).
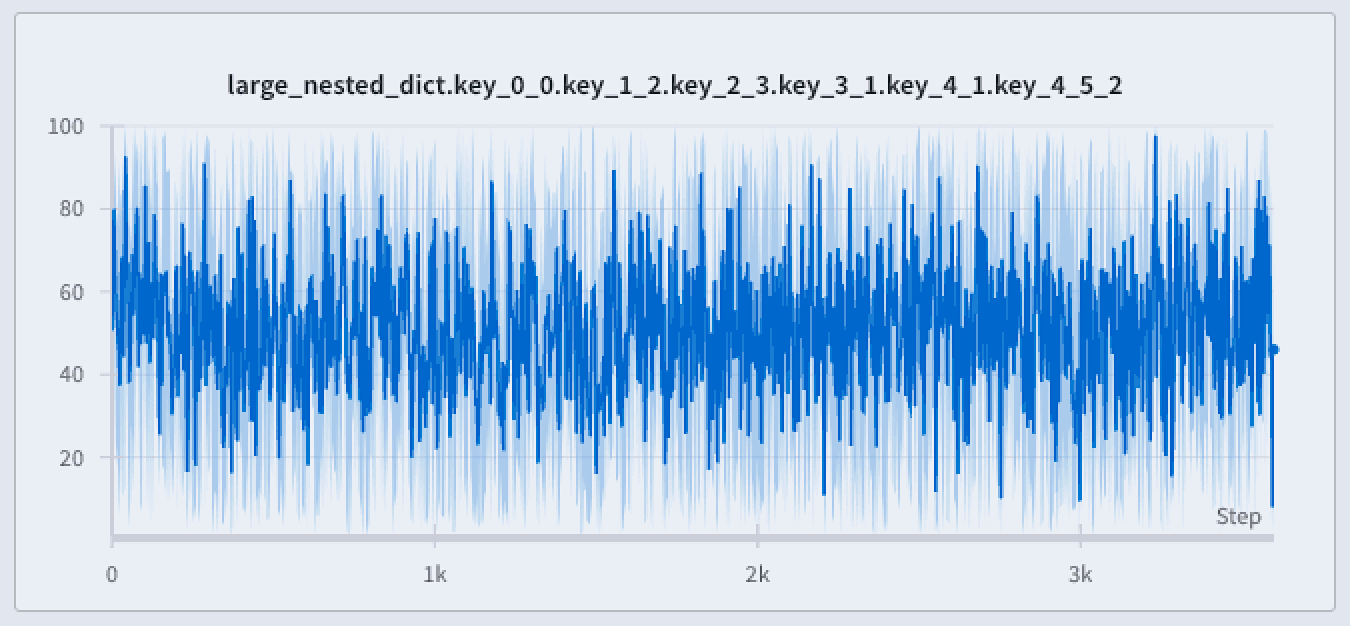
다음 이미지는 파란색 선형 플롯을 보여줍니다. 연한 파란색 음영 영역은 각 버킷의 최솟값과 최댓값을 나타냅니다.
 음영을 설정하려면:
1. 워크스페이스로 이동하세요.
2. 선형 플롯에 마우스를 올린 다음 톱니바퀴 아이콘을 클릭하세요.
3. **Data** 탭에서 필요한 경우 **포인트 집계**를 **전체 충실도**로 설정한 다음 평활화 알고리즘을 설정하세요.
4. **Grouping** 탭에서 **Group runs**를 켜세요. 선택 사항으로, **Group by**를 run 속성으로 설정하세요.
5. **Agg**를 **평균**(기본값), **최소** 또는 **최대**로 설정하세요.
6. **Range**를 **최소/최대**, **Std Dev**, **Std Err** 또는 **None**으로 설정하세요.
7. **Apply**를 클릭하세요.
데이터 충실도를 유지하면서 데이터 탐색하기
극값이나 급격한 상승과 같은 중요한 데이터 포인트를 놓치지 않고 데이터셋의 특정 영역을 분석하세요. 선형 플롯을 확대하면 W\&B는 각 버킷 내 최솟값, 최댓값, 마지막 값을 계산하는 데 사용하는 버킷 크기를 조정합니다.
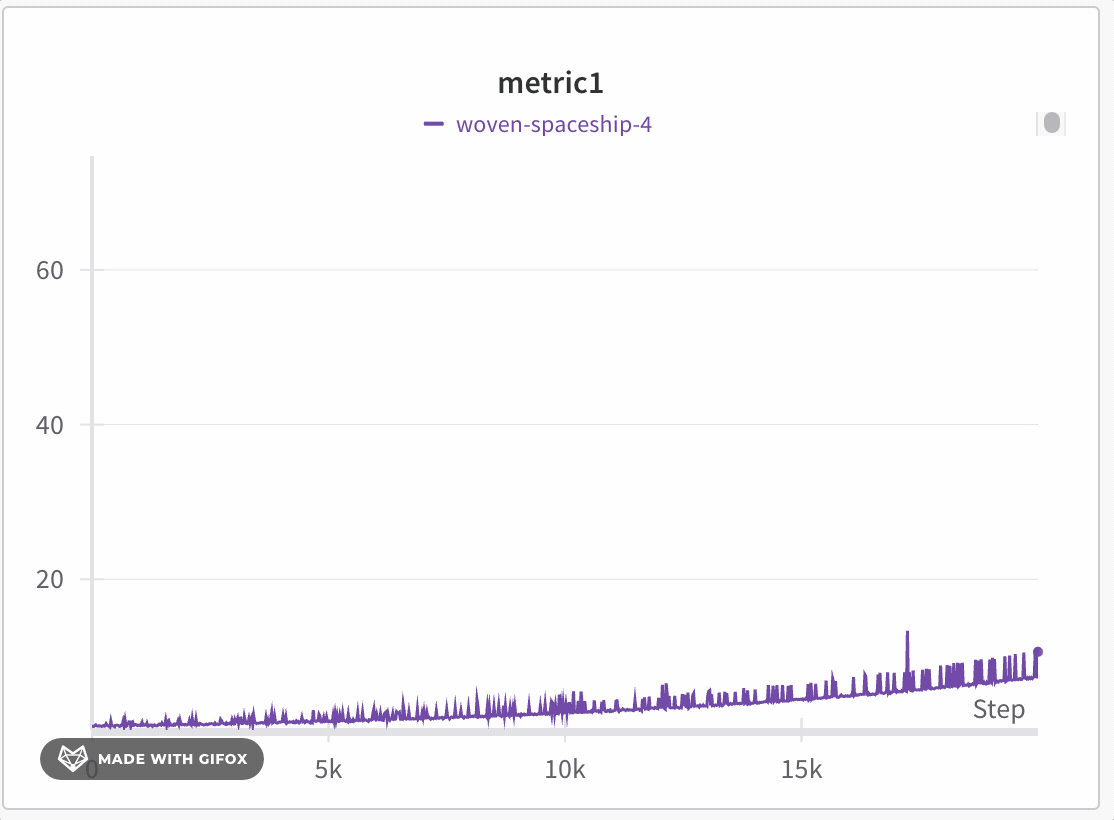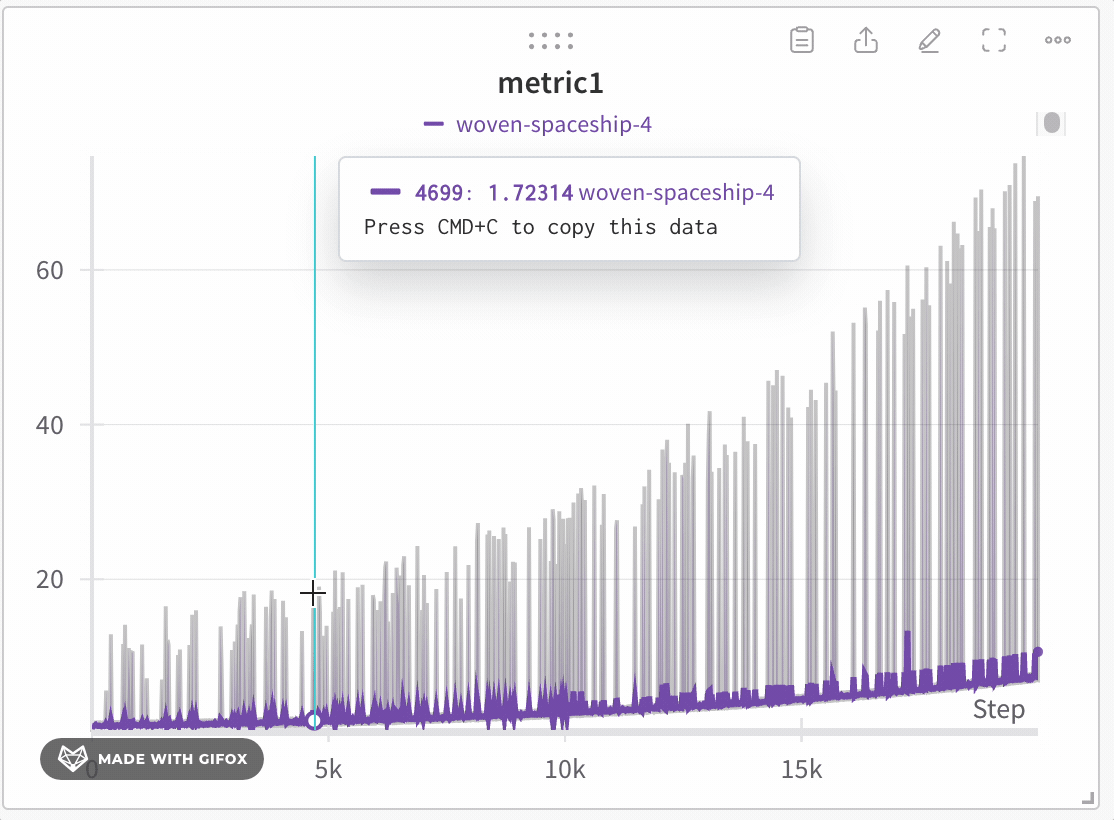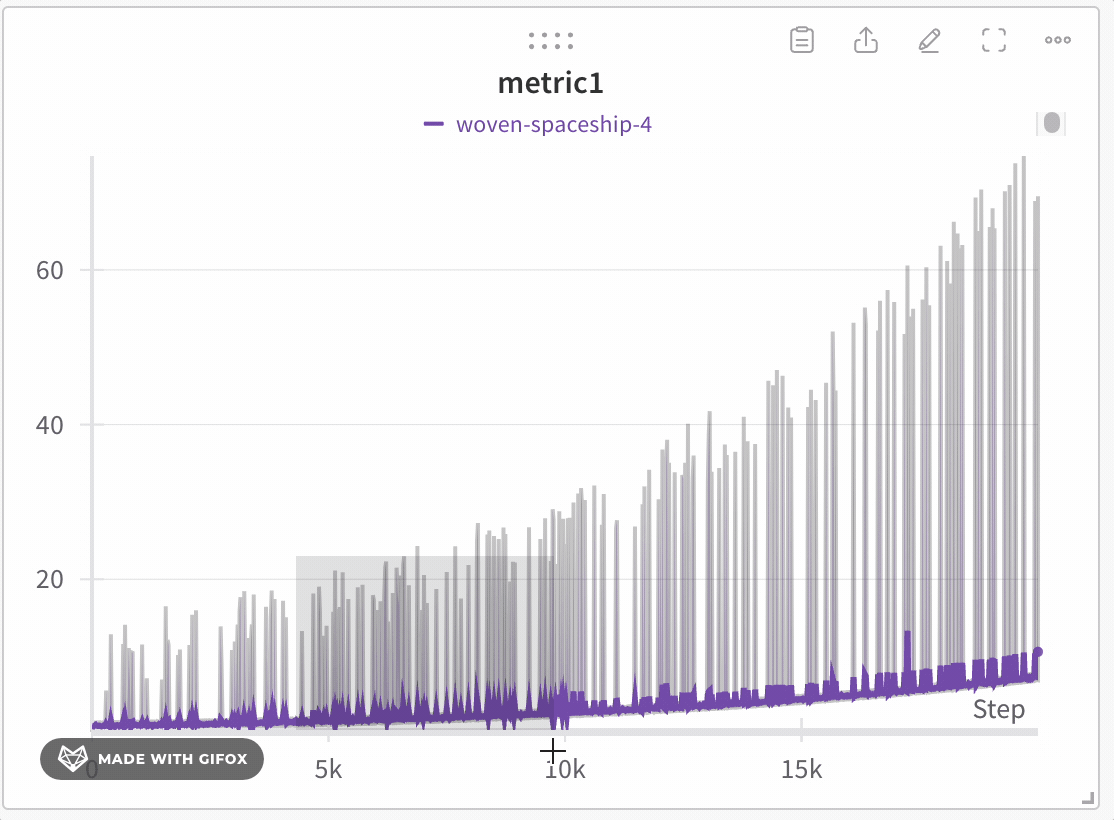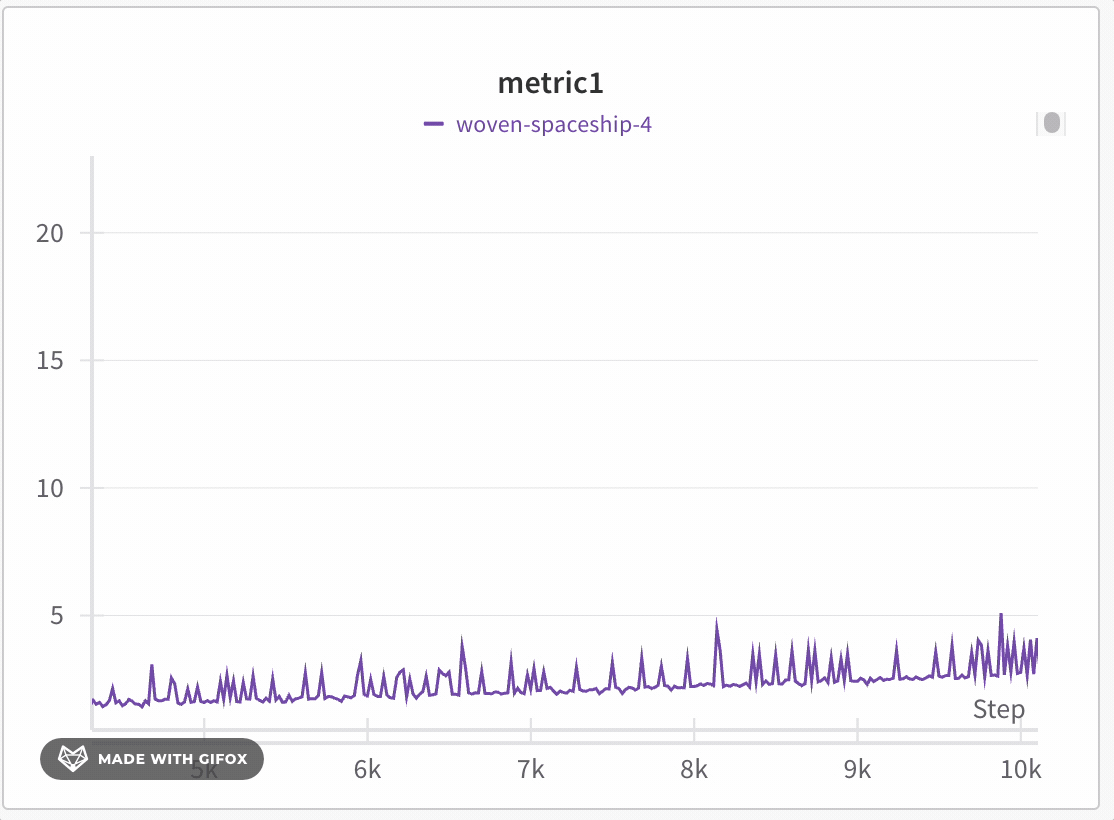 W\&B는 동적 구간화를 사용하여 x축을 버킷으로 나눕니다. 선마다 표시되는 데이터 포인트 수는 차트 크기와 run 수에 따라 조정됩니다. 차트 크기가 작거나 run이 많으면 차트의 응답성을 유지하고 더 많은 선을 표시할 수 있도록 선마다 표시되는 데이터 포인트 수가 줄어들 수 있습니다. 각 버킷에 대해 W\&B는 다음 값을 계산합니다.
* **최솟값**: 해당 버킷에서 가장 낮은 값입니다(음영 표시에 사용).
* **최댓값**: 해당 버킷에서 가장 높은 값입니다(음영 표시에 사용).
* **선 값**: 해당 버킷의 마지막 값으로, 선을 그리는 데 사용됩니다.
W\&B는 전체 데이터 표현을 유지하고 모든 플롯에 극값을 포함하는 방식으로 버킷의 값을 표시합니다. 선은 각 버킷의 마지막 값을 기준으로 그려집니다. 충분히 확대하면 전체 충실도 모드에서 추가 집계 없이 모든 데이터 포인트를 렌더링할 수 있습니다. 정확한 임계값은 현재 차트 크기와 run 수에 따라 달라집니다.
선형 플롯을 확대하려면 다음 단계를 따르세요.
1. W\&B 프로젝트로 이동하세요.
2. 왼쪽 탭에서 **워크스페이스** 아이콘을 선택하세요.
3. 선택 사항: 워크스페이스에 선형 플롯 패널을 추가하거나 기존 선형 플롯 패널로 이동하세요.
4. 클릭하고 드래그하여 확대할 특정 영역을 선택하세요.
**선형 플롯 그룹화 및 표현식**
선형 플롯 그룹화를 사용하면 W\&B는 선택한 모드에 따라 다음과 같이 처리합니다.
* **윈도우 없는 샘플링(그룹화)**: 여러 run의 데이터 포인트를 x축에 맞춰 정렬합니다. 여러 데이터 포인트가 같은 x값을 공유하면 W\&B는 평균을 계산합니다. 그렇지 않으면 개별 데이터 포인트로 표시됩니다.
* **윈도우 기반 샘플링(그룹화 및 표현식)**: x축을 250개 버킷 또는 가장 긴 선의 데이터 포인트 수 중 더 작은 수로 나눕니다. W\&B는 각 버킷 내 데이터 포인트의 평균을 계산합니다.
* **전체 충실도(그룹화 및 표현식)**: 윈도우 없는 샘플링과 유사하지만 성능과 세부 정보의 균형을 맞추기 위해 run마다 최대 500개의 데이터 포인트를 가져옵니다.
랜덤 샘플링
랜덤 샘플링은 데이터 충실도보다 렌더링 속도를 우선시하는 대안적인 집계 방법입니다. 더 빠른 차트 성능이 필요하고 모든 극값을 보존할 필요가 없을 때 사용하세요.
랜덤 샘플링은 무작위로 샘플링한 1,500개의 데이터 포인트를 사용하여 선형 플롯을 렌더링합니다. 샘플링 과정에서 데이터 포인트가 제외되므로 이상치나 급격한 상승을 발견하기가 더 어려워집니다.
랜덤 샘플링은 비결정적으로 샘플링합니다. 따라서 데이터의 이상치나 급격한 상승이 제외되는 경우가 있어 데이터 정확도가 낮아집니다.
랜덤 샘플링 활성화
기본적으로 W\&B는 전체 충실도 모드를 사용합니다. 랜덤 샘플링을 활성화하려면 다음 단계를 따르세요:
1. W\&B 프로젝트로 이동하세요.
2. 왼쪽 탭에서 **워크스페이스** 아이콘을 선택하세요.
3. 화면 오른쪽 상단의 **Add panels** 버튼 바로 왼쪽에 있는 톱니바퀴 아이콘을 선택하세요.
4. 표시되는 UI 슬라이더에서 **선형 플롯**을 선택하세요.
5. **포인트 집계** 섹션에서 **랜덤 샘플링**을 선택하세요.
1. W\&B 프로젝트로 이동하세요.
2. 왼쪽 탭에서 **워크스페이스** 아이콘을 선택하세요.
3. 랜덤 샘플링을 활성화할 선형 플롯 패널을 선택하세요.
4. 표시되는 모달의 **포인트 집계 방법** 섹션에서 **랜덤 샘플링**을 선택하세요.
샘플링되지 않은 데이터에 액세스
랜덤 샘플링으로 필요한 데이터 포인트가 제외되더라도 프로그래밍 방식으로 샘플링되지 않은 전체 메트릭 이력에 액세스할 수 있습니다. [Public API](/ko/products/wandb/ref/python/public-api/runs)를 사용하면 run 중에 로깅된 메트릭의 전체 이력에 액세스할 수 있습니다. 다음 예시는 특정 run에서 손실 값을 가져와 처리하는 방법을 보여줍니다.
```python theme={"system"}
# W&B API 초기화
api = wandb.Api()
run = api.run("l2k2/examples-numpy-boston/i0wt6xua")
# 'Loss' 메트릭의 이력 가져오기
history = run.scan_history(keys=["Loss"])
# history에서 loss 값 추출
losses = [row["Loss"] for row in history]
```