> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# スレッドをトレースする
> スレッドを使用して、LLM アプリケーションのマルチターンの会話をトレースおよび分析します。
W\&B Weave の *スレッド* を使用すると、LLM アプリケーションにおけるマルチターンの会話をトラッキングおよび分析できます。スレッドは関連する Call を共通の `thread_id` でグループ化します。これにより、セッション全体を可視化し、ターンをまたいで会話レベルのメトリクスをトラッキングできます。スレッドはプログラムから作成でき、Weights & Biases UI で可視化できます。
スレッドを使い始めるには、次の手順に従います。
1. スレッドの基本を理解します。
* [ユースケース](#use-cases)
* [定義](#definitions)
* [UI の概要](#ui-overview)
* [API 仕様](#api-specification)
2. 一般的な使用パターンや実際のユースケースを示すコードサンプルを試します。
* [基本的な使用例](#basic-thread-creation)
* [高度な使用例](#manual-agent-loop-implementation)
ユースケース
スレッドは、次のようなものを整理・分析したい場合に役立ちます。
* マルチターンの会話
* セッションベースのワークフロー
* 相互に関連する一連の操作
スレッドを使用すると、Call をコンテキストごとにグループ化できるため、複数のステップにわたってシステムがどのように応答するかを把握しやすくなります。たとえば、1 つのユーザーセッション、エージェントによる一連の意思決定、あるいはインフラストラクチャー層とビジネスロジック層にまたがる複雑なリクエストをトラッキングできます。
スレッドとターンを使用してアプリケーションを構成すると、メトリクスが整理され、Weights & Biases UI での可視性も向上します。低レベルの Op をすべて確認する代わりに、重要な高レベルのステップに集中できます。
定義
スレッド
*スレッド* は、共通の会話コンテキストを共有する、関連する Call を論理的にまとめたグループです。スレッドには次の特徴があります。
* 一意の `thread_id` を持つ
* 1 つ以上の *ターン* を含む
* Call をまたいでコンテキストを保持する
* ユーザーセッション全体、または一連のインタラクションフローを表す
ターン
*ターン* は、スレッド内の上位レベルの操作で、UI ではスレッドビューの各行として表示されます。各ターンには次の特徴があります。
* 会話またはワークフローにおける 1 つの論理的なステップを表します
* スレッドコンテキストの直接の子であり、ネストされた下位レベルの Call を含む場合があります (これらはスレッドレベルの統計には表示されません)
Call
*Call* とは、アプリケーション内で `@weave.op` でデコレートされた関数の実行を指します。
* *ターン Call* は、新しいターンを開始する最上位の操作です。
* *Nested Call* は、ターン内で実行される下位の操作です。
トレース
*トレース* は、単一の操作の Call スタック全体を取得します。スレッドは、同じ論理的な会話またはセッションに属するトレースをグループ化します。つまり、スレッドは複数のターンで構成され、各ターンが会話の一部を表します。トレースの詳細については、[トレースの概要](/ja/products/wandb/weave/guides/tracking/tracing)を参照してください。
UI の概要
Weave プロジェクトのサイドバーで **Threads** を選択すると、[Threads list view](#threads-list-view) が開きます。
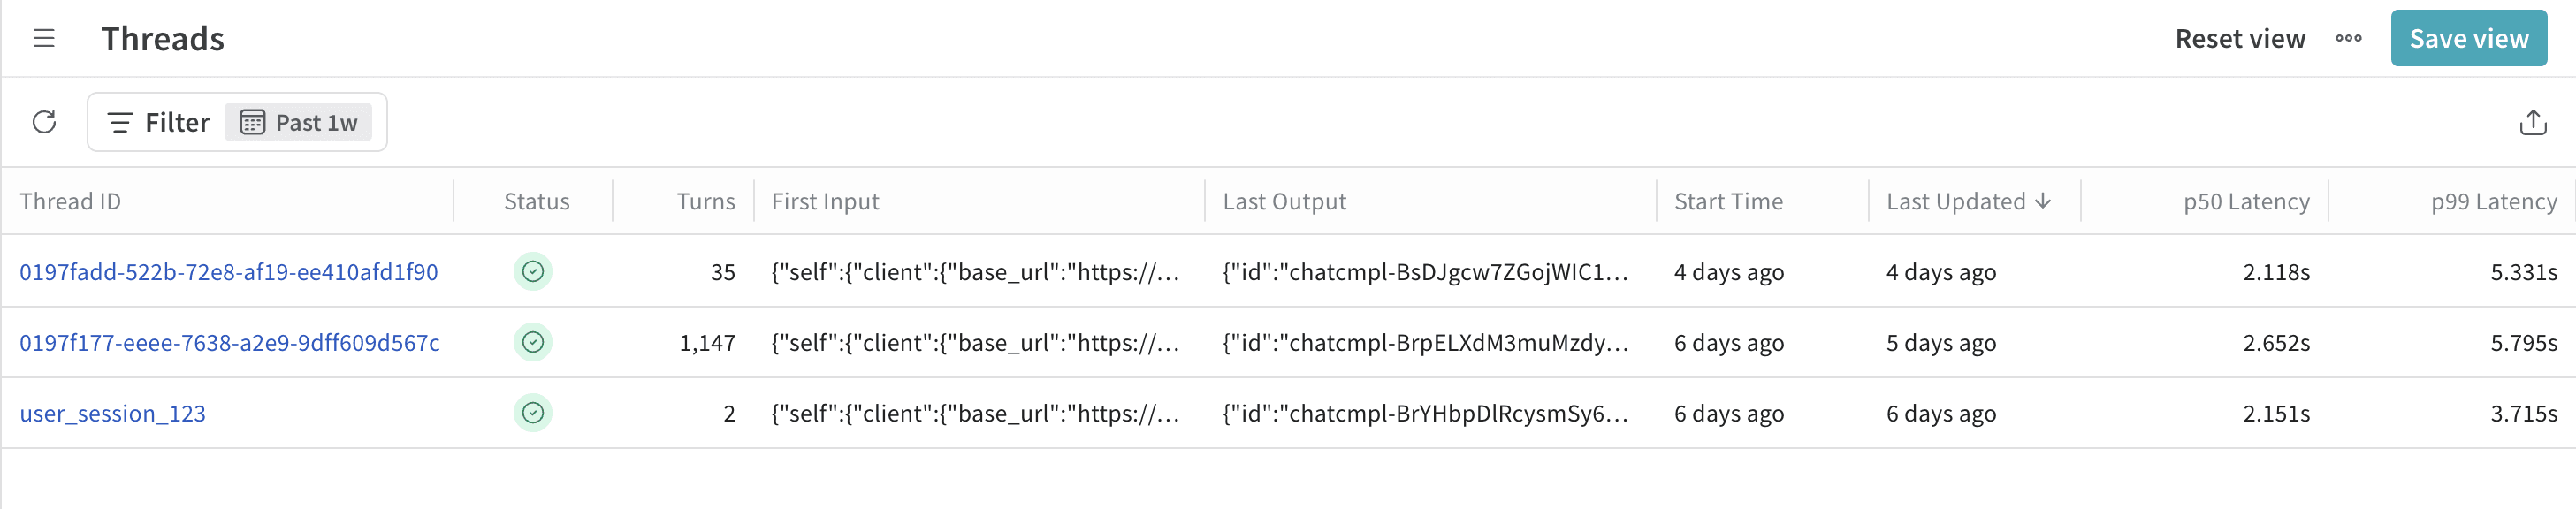
Threads list view
* project 内の最近のスレッドを一覧表示します。
* 列には、ターン数、開始時刻、最終更新日時が表示されます。
* 行をクリックすると、その[詳細ドロワー](#threads-detail-drawer)が開きます。
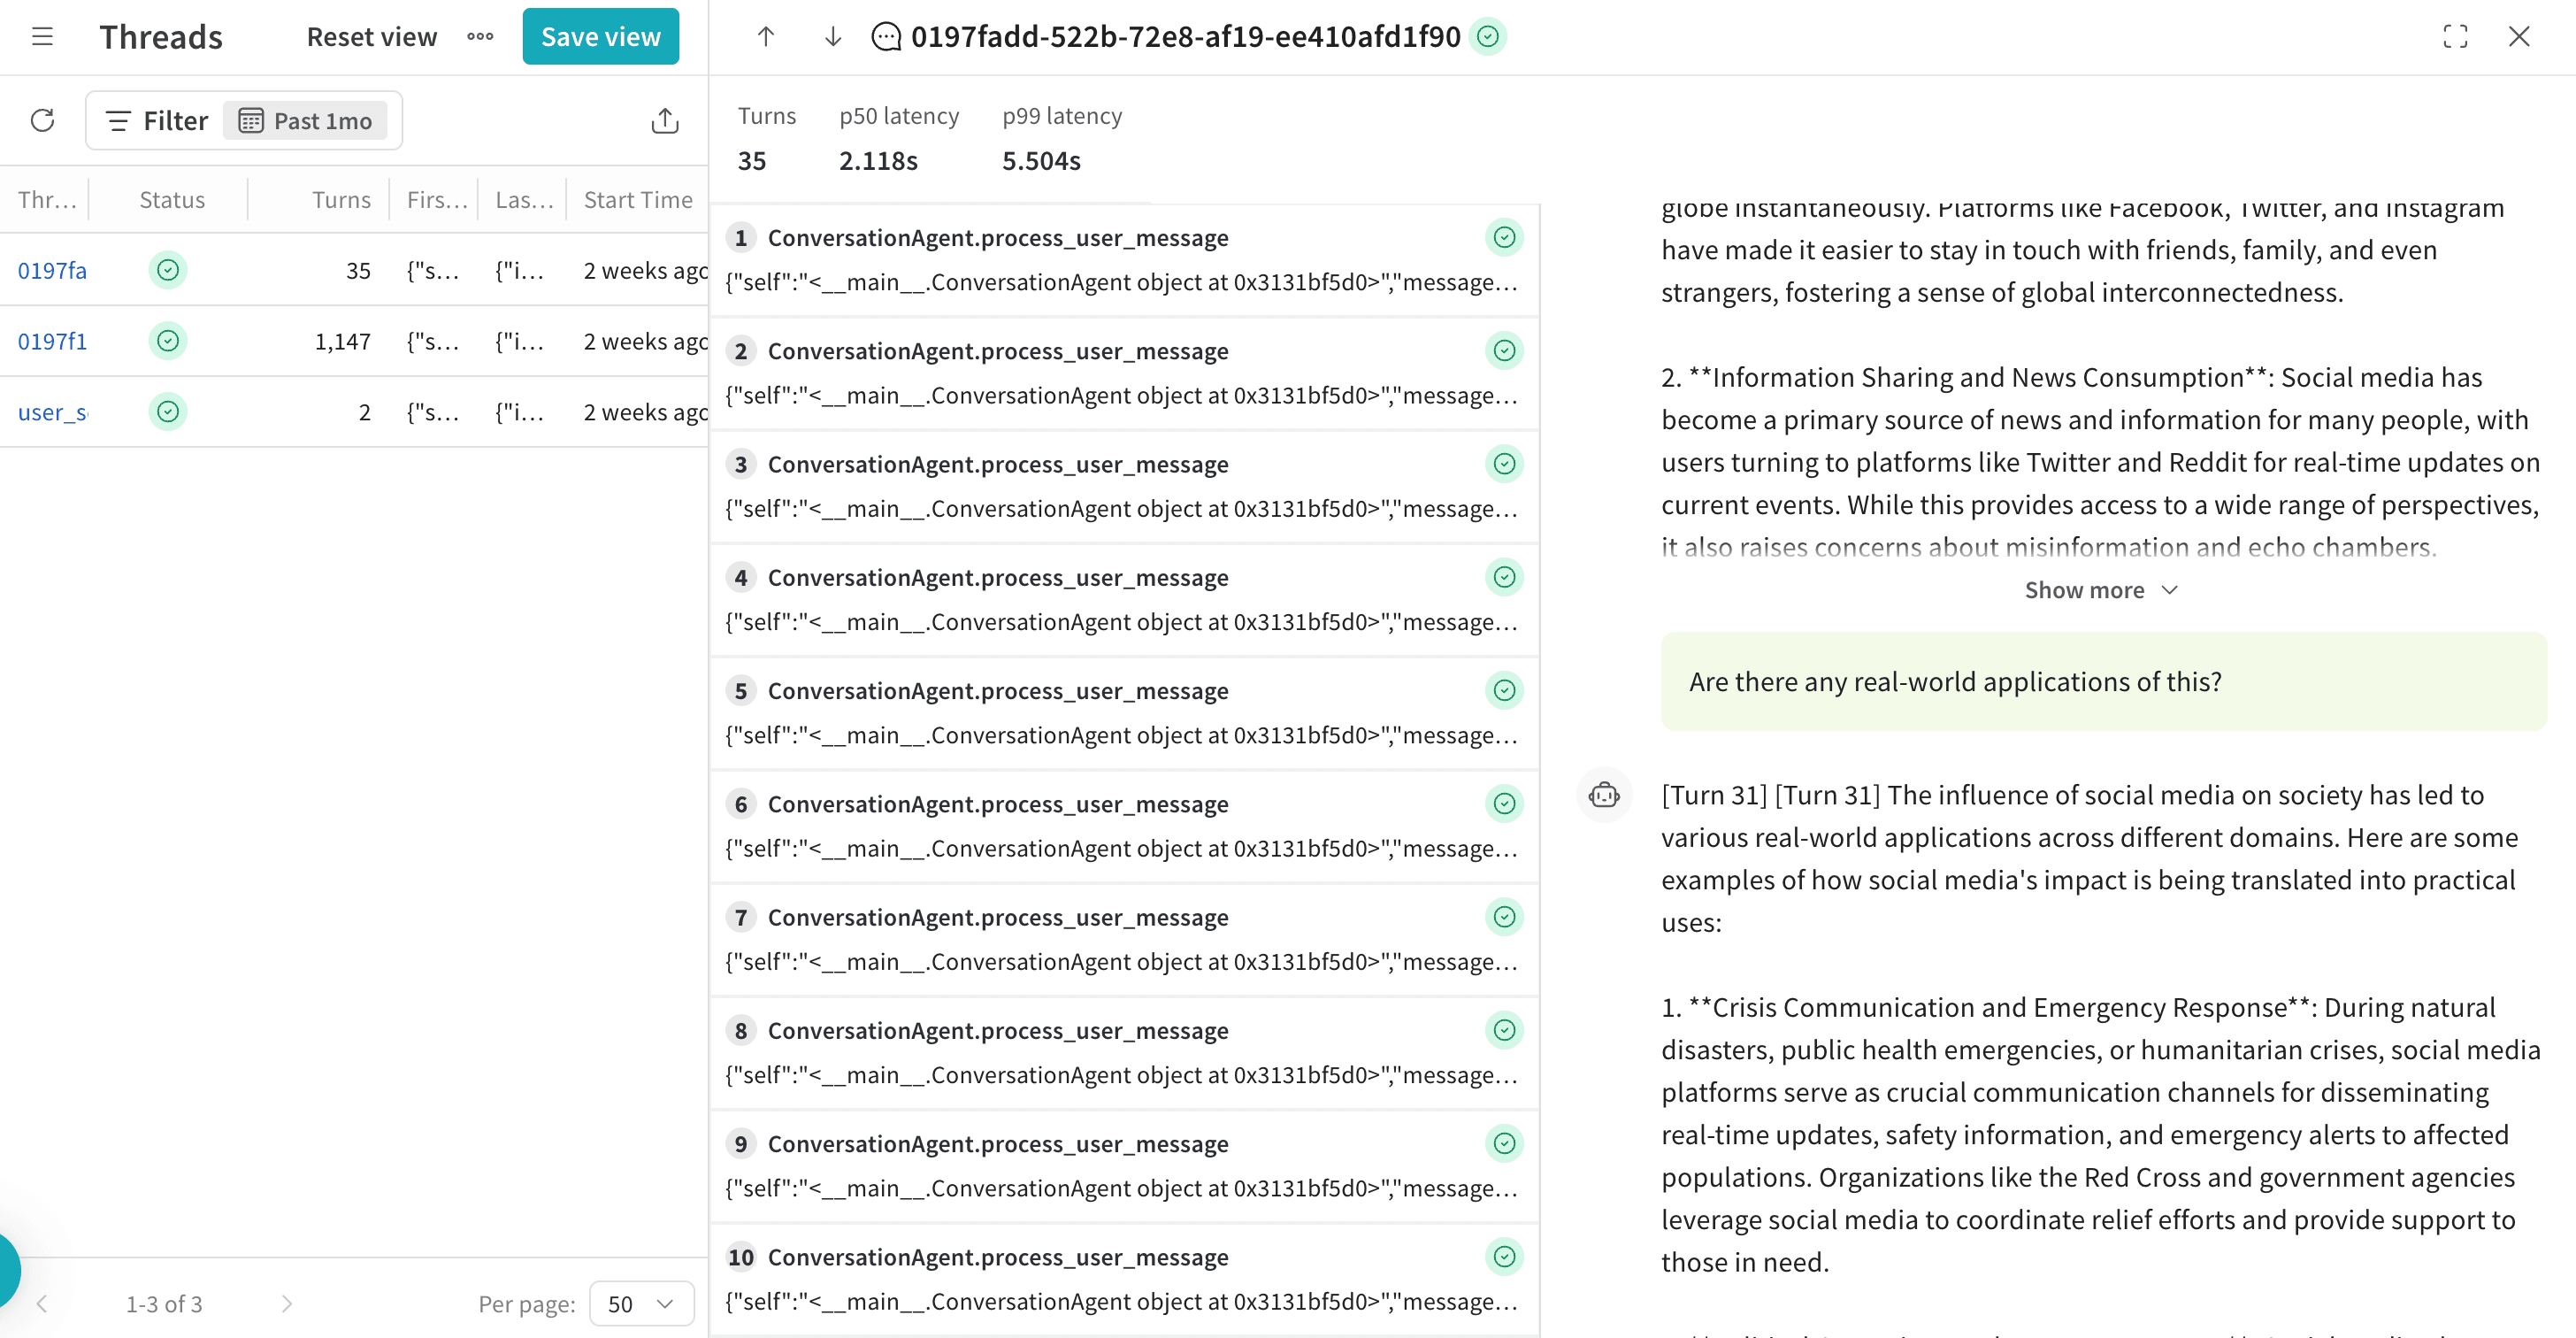
スレッドの詳細ドロワー
* 任意の行をクリックすると、その行の詳細ドロワーが開きます。
* スレッド内のすべてのターンが表示されます。
* ターンは開始順に一覧表示されます (所要時間や終了時刻ではなく、開始時刻に基づきます) 。
* Call レベルのメタデータ (レイテンシー、入力、出力) が含まれます。
* ログされている場合は、メッセージの内容や構造化データも表示されます。
* ターンの実行内容全体を確認するには、スレッドの詳細ドロワーからターンを開きます。そのターン中に発生したすべてのネストされた操作を掘り下げて確認できます。
* ターンに LLM Call から抽出されたメッセージが含まれている場合、それらはチャットペインに表示されます。これらのメッセージは通常、サポートされるインテグレーション (例: `openai.ChatCompletion.create`) による Call から取得されたもので、表示するには特定の条件を満たす必要があります。詳細については、[チャットビューの動作](#chat-view-behavior)を参照してください。
チャットビューの動作
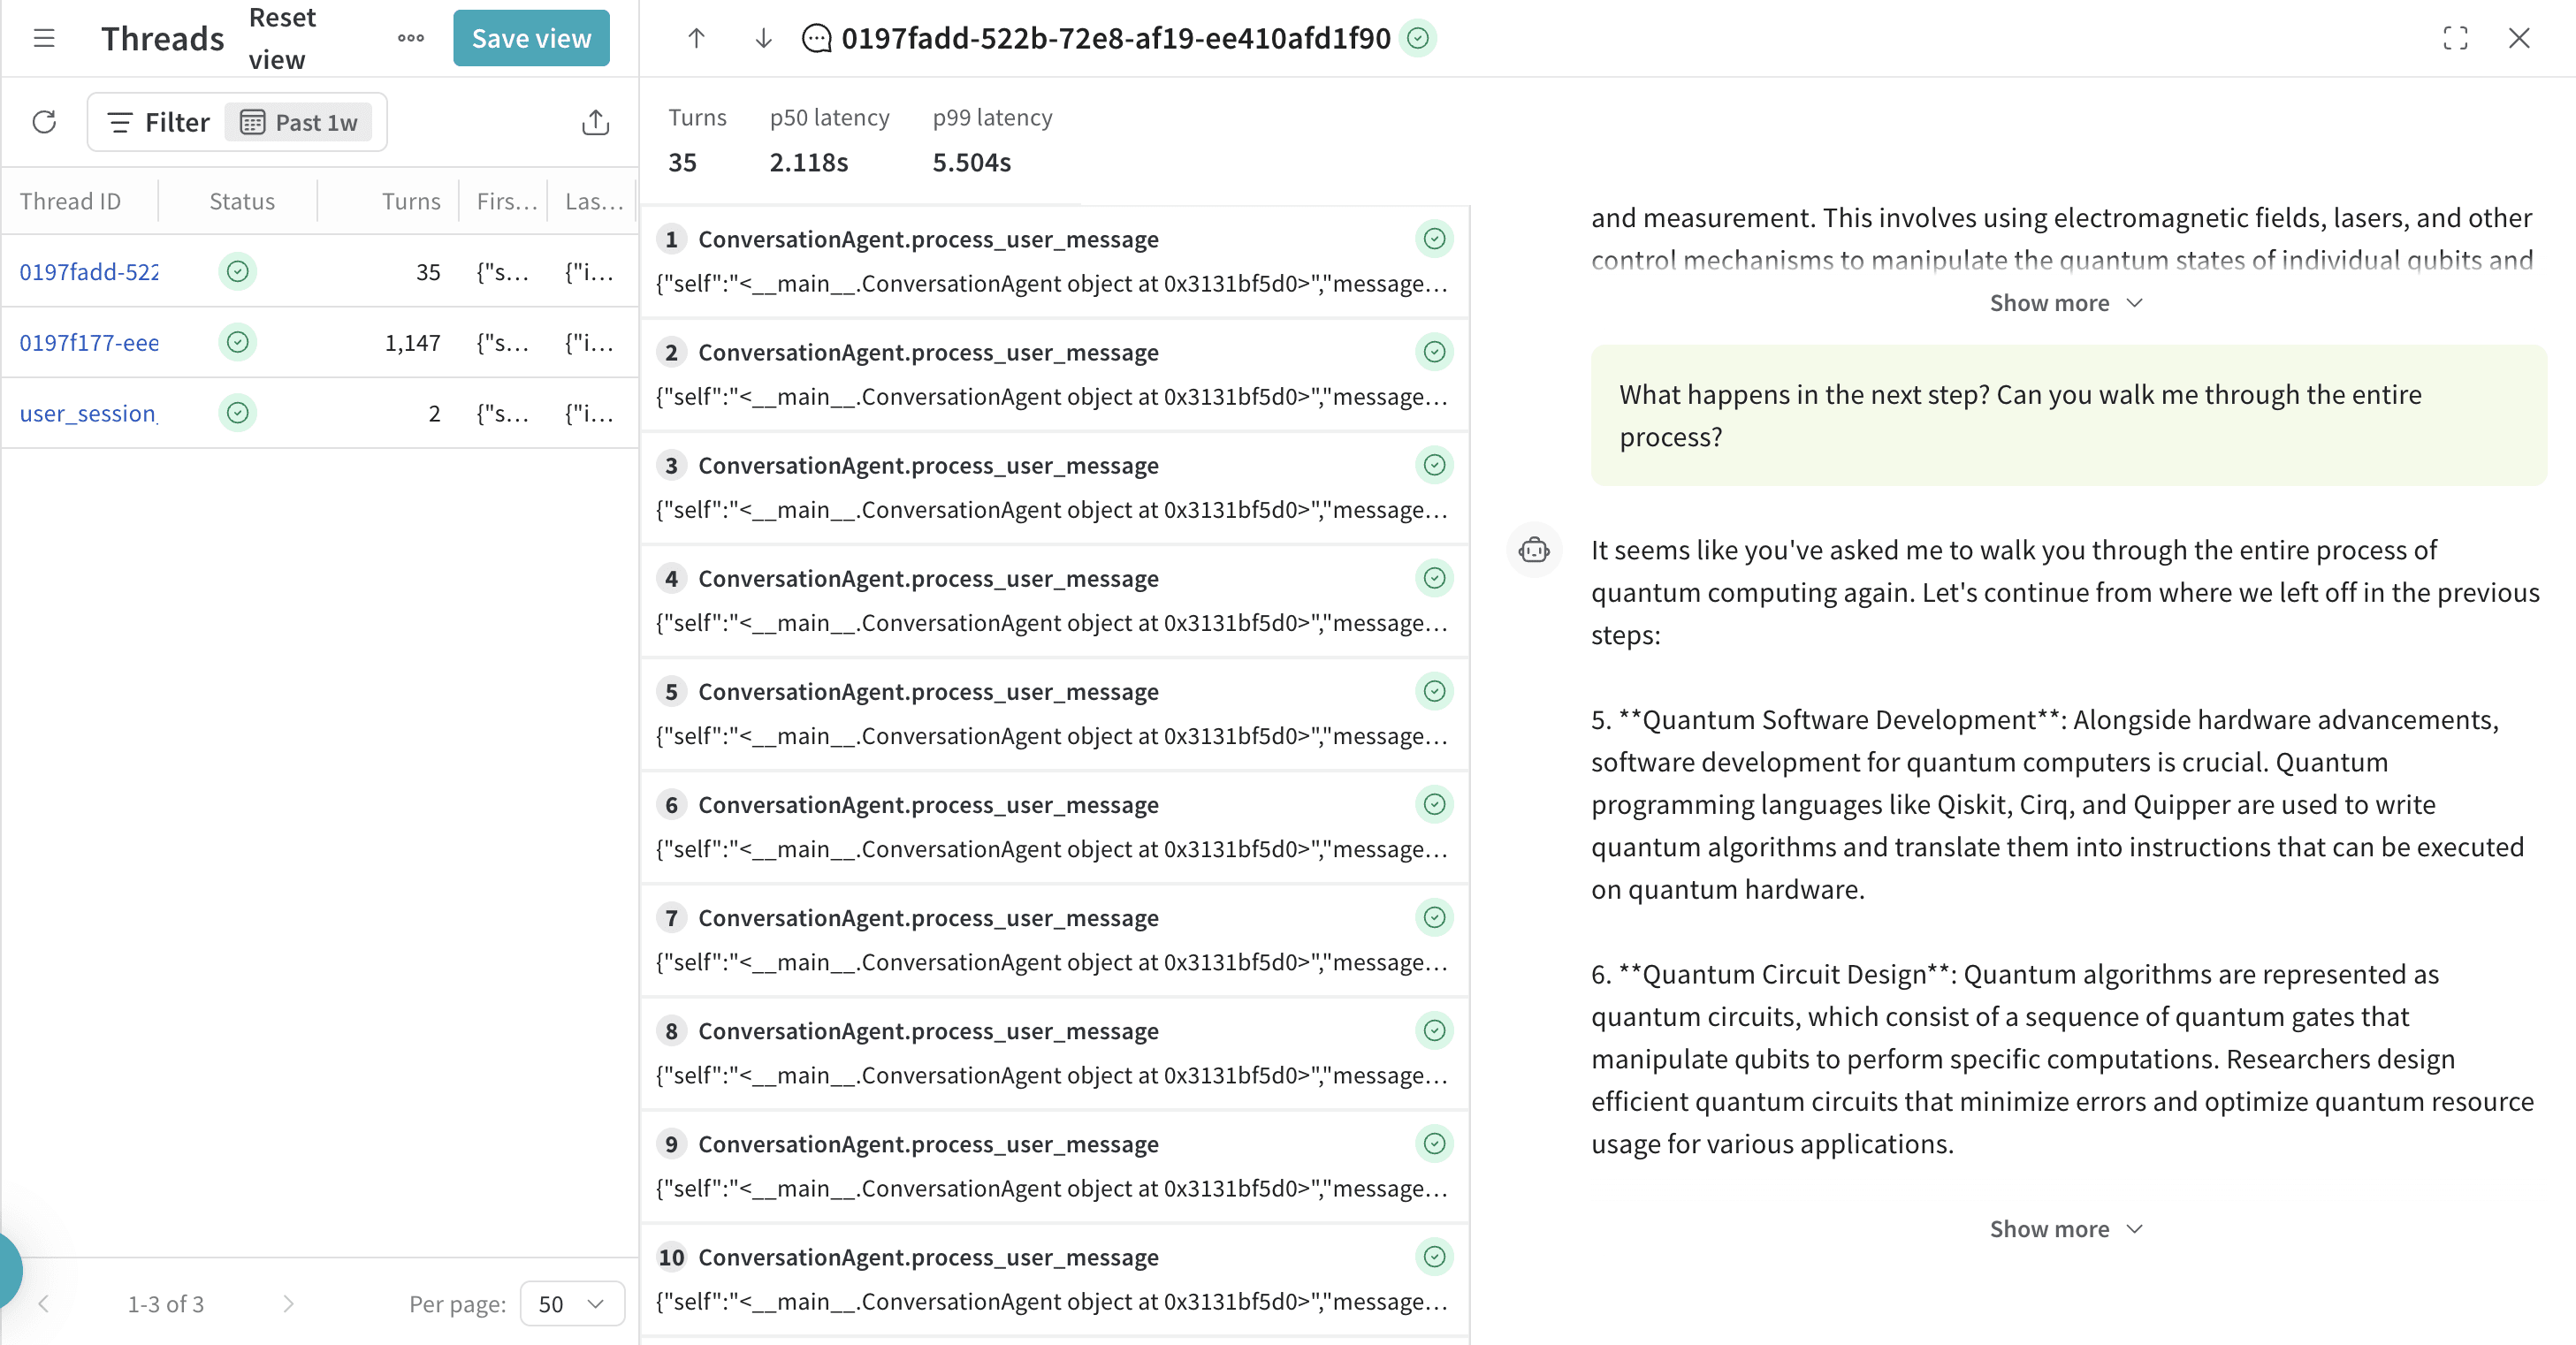
チャットペインには、各ターンで実行された LLM Call から抽出された構造化メッセージデータが表示されます。このビューでは、やり取りを会話形式でレンダリングして確認できます。
メッセージとして扱われるもの
Weave は、ターン内の Call のうち、LLM プロバイダとの直接的なやり取り (プロンプトを送信して応答を受け取るなど) を表す Call からメッセージを抽出します。メッセージとして表示されるのは、他の Call の内部にネストされていない Call のみです。これにより、中間ステップや集計された内部ロジックが重複して表示されるのを防ぎます。
通常、メッセージを出力するのは、自動的にパッチが適用されたサードパーティ SDK です。次に例を示します。
* `openai.ChatCompletion.create`
* `anthropic.Anthropic.completion`
メッセージがない場合の動作
ターンがメッセージを出力しない場合、チャットペインにはそのターンのメッセージセクションが空の状態で表示されます。この場合でも、チャットペインには同じスレッド内の他のターンのメッセージが表示されることがあります。
ターンとチャットの連動
* ターンをクリックすると、チャットペインがそのターンのメッセージ位置までスクロールします (ピン留め動作) 。
* チャットペインをスクロールすると、ターンリスト内の対応するターンがハイライト表示されます。
トレースビューとの間の移動
ターンをクリックすると、そのターンのトレース全体を開けます。
左上に戻るボタンが表示され、クリックするとスレッドの詳細ビューに戻れます。この遷移では、Weave は UI の状態 (スクロール位置など) を保持しません。
SDK の使用方法
以下のセクションでは、Weave SDK を使用してスレッドをプログラムから作成、管理する方法について説明します。各サンプルでは、アプリケーション内でターンとスレッドを整理するための異なる手法を紹介します。ほとんどのサンプルでは、スタブ関数内に独自の LLM Call またはシステムの動作を実装してください。
* セッションや会話をトラッキングするには、`weave.thread()` コンテキストマネージャーを使用します。
* 論理的な操作を `@weave.op` でデコレートすると、ターンまたはネストされた Call としてトラッキングできます。
* `thread_id` を渡すと、Weave はその ID を使用して、ブロック内のすべての操作を同じスレッドにグループ化します。`thread_id` を省略した場合は、Weave が一意の ID を自動生成します。
`weave.thread()` の戻り値は、`thread_id` プロパティを持つ `ThreadContext` オブジェクトです。この ID は、ログしたり、再利用したり、他のシステムに渡したりできます。
ネストされた `weave.thread()` コンテキストは、同じ `thread_id` を再利用しない限り、常に新しいスレッドを開始します。子コンテキストを終了しても、親コンテキストが中断されたり上書きされたりすることはありません。そのため、アプリケーションのロジックに応じて、フォークしたスレッド構造や階層的なスレッドのオーケストレーションを実現できます。
基本的なスレッドの作成
次のコードサンプルでは、`weave.thread()` を使用して 1 つ以上の操作を共通の `thread_id` でグループ化する方法を示します。アプリケーションでスレッドを使い始める最も簡単な方法です。
```python lines theme={"system"}
import weave
@weave.op
def say_hello(name: str) -> str:
return f"Hello, {name}!"
# 新しいスレッドコンテキストを開始する
with weave.thread() as thread_ctx:
print(f"Thread ID: {thread_ctx.thread_id}")
say_hello("Bill Nye the Science Guy")
```
エージェントループの手動実装
この例では、`@weave.op` デコレーターと `weave.thread()` によるコンテキスト管理を使用して、会話型エージェントを手動で定義する方法を示します。`process_user_message` を呼び出すたびに、スレッド内に新しいターンが作成されます。独自のエージェントループを構築していて、コンテキストやネストの扱いを完全に制御したい場合に、このパターンを使用できます。
短時間のやり取りには自動生成されたスレッド ID を使用します。セッションをまたいでスレッドコンテキストを保持するには、カスタムのセッション ID (`user_session_123` など) を渡します。
```python lines theme={"system"}
import weave
class ConversationAgent:
@weave.op
def process_user_message(self, message: str) -> str:
"""
TURN-LEVEL OPERATION: This represents one conversation turn.
Only this function will be counted in thread statistics.
"""
# ユーザーメッセージを保存
# ネストされた Call で AI の応答を生成
response = self._generate_response(message)
# アシスタントの応答を保存
return response
@weave.op
def _generate_response(self, message: str) -> str:
"""NESTED CALL: Implementation details, not counted in thread stats."""
context = self._retrieve_context(message) # ネストされた Call
intent = self._classify_intent(message) # ネストされた Call
response = self._call_llm(message, context) # LLM Call(ネスト)
return self._format_response(response) # 最後のネストされた Call
@weave.op
def _retrieve_context(self, message: str) -> str:
# ベクトル DB のルックアップ、ナレッジベースへのクエリなど
return "retrieved_context"
@weave.op
def _classify_intent(self, message: str) -> str:
# 意図分類ロジック
return "general_inquiry"
@weave.op
def _call_llm(self, message: str, context: str) -> str:
# OpenAI/Anthropic などの API 呼び出し
return "llm_response"
@weave.op
def _format_response(self, response: str) -> str:
# 応答の整形ロジック
return f"Formatted: {response}"
# 使用例: スレッドコンテキストは自動的に確立されます
agent = ConversationAgent()
# スレッドコンテキストを確立します。process_user_message の呼び出しごとに 1 つのターンになります
with weave.thread() as thread_ctx: # thread_id を自動生成
print(f"Thread ID: {thread_ctx.thread_id}")
# process_user_message を呼び出すたびに、1 つのターンと複数のネストされた Call が作成されます
agent.process_user_message("Hello, help with setup") # ターン 1
agent.process_user_message("What languages do you recommend?") # ターン 2
agent.process_user_message("Explain Python vs JavaScript") # ターン 3
# 結果: 3 ターン、合計約 15~20 件の Call(ネストを含む)からなるスレッド
# 別の方法: 明示的な thread_id を指定してセッションをトラッキングする
session_id = "user_session_123"
with weave.thread(session_id) as thread_ctx:
print(f"Session Thread ID: {thread_ctx.thread_id}") # "user_session_123"
agent.process_user_message("Continue our previous conversation") # このセッションのターン 1
agent.process_user_message("Can you summarize what we discussed?") # このセッションのターン 2
```
Call の深さが不均一な手動エージェント
この例では、スレッドコンテキストの適用方法によって、Call スタック内の異なる深さでターンを定義できることを示します。このサンプルでは 2 つのプロバイダー (OpenAI と Anthropic) を使用しており、ターン境界に到達するまでの Call の深さはプロバイダーごとに異なります。
すべてのターンは同じ `thread_id` を共有しますが、ターン境界がスタックのどの階層に現れるかは、プロバイダーのロジックによって異なります。これは、同じスレッドにグループ化したまま、バックエンドごとに Call のトレース方法を変えたい場合に便利です。
```python lines theme={"system"}
import weave
import random
import asyncio
class OpenAIProvider:
"""OpenAI branch: 2 levels deep call chain to turn boundary"""
@weave.op
def route_to_openai(self, user_input: str, thread_id: str) -> str:
"""Level 1: Route and prepare OpenAI request"""
# 入力の検証、ルーティングロジック、基本的な前処理
print(f" L1: Routing to OpenAI for: {user_input}")
# ここがターンの境界です。スレッドコンテキストでラップします
with weave.thread(thread_id):
# レベル 2 を直接呼び出します。これにより Call チェーンに深さが生まれます
return self.execute_openai_call(user_input)
@weave.op
def execute_openai_call(self, user_input: str) -> str:
"""Level 2: TURN BOUNDARY - Execute OpenAI API call"""
print(f" L2: Executing OpenAI API call")
response = f"OpenAI GPT-4 response: {user_input}"
return response
class AnthropicProvider:
"""Anthropic branch: 3 levels deep call chain to turn boundary"""
@weave.op
def route_to_anthropic(self, user_input: str, thread_id: str) -> str:
"""Level 1: Route and prepare Anthropic request"""
# 入力の検証、ルーティングロジック、プロバイダーの選択
print(f" L1: Routing to Anthropic for: {user_input}")
# レベル 2 を呼び出します。これにより Call チェーンに深さが生まれます
return self.authenticate_anthropic(user_input, thread_id)
@weave.op
def authenticate_anthropic(self, user_input: str, thread_id: str) -> str:
"""Level 2: Handle Anthropic authentication and setup"""
print(f" L2: Authenticating with Anthropic")
# 認証、レート制限、セッション管理
auth_token = "anthropic_key_xyz_authenticated"
# ここがターンの境界です。レベル 3 でスレッドコンテキストによりラップします
with weave.thread(thread_id):
# レベル 3 を呼び出します。Call チェーンのネストがさらに深くなります
return self.execute_anthropic_call(user_input, auth_token)
@weave.op
def execute_anthropic_call(self, user_input: str, auth_token: str) -> str:
"""Level 3: TURN BOUNDARY - Execute Anthropic API call"""
print(f" L3: Executing Anthropic API call with auth")
response = f"Anthropic Claude response (auth: {auth_token[:15]}...): {user_input}"
return response
class MultiProviderAgent:
"""Main agent that routes between providers with different call chain depths"""
def __init__(self):
self.openai_provider = OpenAIProvider()
self.anthropic_provider = AnthropicProvider()
def handle_conversation_turn(self, user_input: str, thread_id: str) -> str:
"""
Route to different providers with imbalanced call chain depths.
Thread context is applied at different nesting levels in each chain.
"""
# デモ用にプロバイダーをランダムに選択します
use_openai = random.choice([True, False])
if use_openai:
print(f"Choosing OpenAI (2-level call chain)")
# OpenAI: レベル 1 → レベル 2 (ターンの境界)
response = self.openai_provider.route_to_openai(user_input, thread_id)
return f"[OpenAI Branch] {response}"
else:
print(f"Choosing Anthropic (3-level call chain)")
# Anthropic: レベル 1 → レベル 2 → レベル 3 (ターンの境界)
response = self.anthropic_provider.route_to_anthropic(user_input, thread_id)
return f"[Anthropic Branch] {response}"
async def main():
agent = MultiProviderAgent()
conversation_id = "nested_depth_conversation_999"
# Call チェーンの深さが異なるマルチターン会話
conversation_turns = [
"What's deep learning?",
"Explain neural network backpropagation",
"How do attention mechanisms work?",
"What's the transformer architecture?",
"Compare CNNs vs RNNs"
]
print(f"Starting conversation: {conversation_id}")
for i, user_input in enumerate(conversation_turns, 1):
print(f"\\n--- Turn {i} ---")
print(f"User: {user_input}")
# Call チェーンの深さが異なっても同じ thread_id を使用します
response = agent.handle_conversation_turn(user_input, conversation_id)
print(f"Agent: {response}")
if __name__ == "__main__":
asyncio.run(main())
# 期待される結果: 5 つのターンを含む単一のスレッド
# - OpenAI のターン: Call チェーンのレベル 2 でスレッドコンテキストを適用
# コールスタック: route_to_openai() → execute_openai_call() ← ここでスレッドコンテキストを適用
# - Anthropic のターン: Call チェーンのレベル 3 でスレッドコンテキストを適用
# コールスタック: route_to_anthropic() → authenticate_anthropic() → execute_anthropic_call() ← ここでスレッドコンテキストを適用
# - すべてのターンが同じ thread_id を共有: "nested_depth_conversation_999"
# - ターンの境界はコールスタックの異なる深さで設定されます
# - Call チェーン内の補助的な操作は、ターンではなくネストされた Call として追跡されます
```
以前のセッションを再開する
以前に開始したセッションを再開し、同じスレッドに引き続き Call を追加する必要が生じることがあります。一方で、既存のセッションを再開できず、新しいスレッドを開始しなければならない場合もあります。
スレッドの再開を任意で行えるように実装する場合は、`thread_id` パラメーターを `None` のままにしないでください。`None` のままにすると、スレッドのグループ化が無効になります。常に有効なスレッド ID を指定してください。新しいスレッドを作成する場合は、`generate_id()` などの関数を使用して一意の ID を生成します。
`thread_id` が指定されていない場合、Weave の内部実装ではランダムな UUID v7 が自動生成されます。独自の `generate_id()` 関数でこの動作を再現することも、任意の一意な string 値を使用することもできます。
```python lines theme={"system"}
import weave
import uuidv7
import argparse
def generate_id():
"""Generate a unique thread ID using UUID v7."""
return str(uuidv7.uuidv7())
@weave.op
def load_history(session_id):
"""Load conversation history for the given session."""
# ここに実装を記述します
return []
# セッション再開用のコマンドライン引数を解析します
parser = argparse.ArgumentParser()
parser.add_argument("--session-id", help="Existing session ID to resume")
args = parser.parse_args()
# スレッド ID を決定します(既存のセッションを再開するか、新しいセッションを作成します)
if args.session_id:
thread_id = args.session_id
print(f"Resuming session: {thread_id}")
else:
thread_id = generate_id()
print(f"Starting new session: {thread_id}")
# Call をトラッキングするためのスレッドコンテキストを確立します
with weave.thread(thread_id) as thread_ctx:
# 会話履歴を読み込むか、初期化します
history = load_history(thread_id)
print(f"Active thread ID: {thread_ctx.thread_id}")
# ここにアプリケーションのロジックを記述します。
```
ネストされたスレッド
この例では、連携する複数のスレッドを使用して複雑なアプリケーションを構成する方法を示します。
各レイヤーはそれぞれ独自のスレッドコンテキストで実行されるため、関心事を明確に分離できます。親となるアプリケーションスレッドは、共有の `ThreadContext` を使用してスレッド ID を設定し、これらのレイヤーを連携させます。システムの各部分を個別に分析または監視しながら、それらを共通のセッションに関連付けたい場合は、このパターンを使用してください。
```python lines theme={"system"}
import weave
from contextlib import contextmanager
from typing import Dict
# ネストされたスレッドを連携させるためのグローバルなスレッドコンテキスト
class ThreadContext:
def __init__(self):
self.app_thread_id = None
self.infra_thread_id = None
self.logic_thread_id = None
def setup_for_request(self, request_id: str):
self.app_thread_id = f"app_{request_id}"
self.infra_thread_id = f"{self.app_thread_id}_infra"
self.logic_thread_id = f"{self.app_thread_id}_logic"
# グローバルインスタンス
thread_ctx = ThreadContext()
class InfrastructureLayer:
"""Handles all infrastructure operations in a dedicated thread"""
@weave.op
def authenticate_user(self, user_id: str) -> Dict:
# 認証ロジック...
return {"user_id": user_id, "authenticated": True}
@weave.op
def call_payment_gateway(self, amount: float) -> Dict:
# 決済処理...
return {"status": "approved", "amount": amount}
@weave.op
def update_inventory(self, product_id: str, quantity: int) -> Dict:
# インベントリ管理...
return {"product_id": product_id, "updated": True}
def execute_operations(self, user_id: str, order_data: Dict) -> Dict:
"""Execute all infrastructure operations in dedicated thread context"""
with weave.thread(thread_ctx.infra_thread_id):
auth_result = self.authenticate_user(user_id)
payment_result = self.call_payment_gateway(order_data["amount"])
inventory_result = self.update_inventory(order_data["product_id"], order_data["quantity"])
return {
"auth": auth_result,
"payment": payment_result,
"inventory": inventory_result
}
class BusinessLogicLayer:
"""Handles business logic in a dedicated thread"""
@weave.op
def validate_order(self, order_data: Dict) -> Dict:
# 検証ロジック...
return {"valid": True}
@weave.op
def calculate_pricing(self, order_data: Dict) -> Dict:
# 価格計算...
return {"total": order_data["amount"], "tax": order_data["amount"] * 0.08}
@weave.op
def apply_business_rules(self, order_data: Dict) -> Dict:
# ビジネスルール...
return {"rules_applied": ["standard_processing"], "priority": "normal"}
def execute_logic(self, order_data: Dict) -> Dict:
"""Execute all business logic in dedicated thread context"""
with weave.thread(thread_ctx.logic_thread_id):
validation = self.validate_order(order_data)
pricing = self.calculate_pricing(order_data)
rules = self.apply_business_rules(order_data)
return {"validation": validation, "pricing": pricing, "rules": rules}
class OrderProcessingApp:
"""Main application orchestrator"""
def __init__(self):
self.infra = InfrastructureLayer()
self.business = BusinessLogicLayer()
@weave.op
def process_order(self, user_id: str, order_data: Dict) -> Dict:
"""Main order processing - becomes a turn in the app thread"""
# ネストされた操作をそれぞれ専用のスレッドで実行
infra_results = self.infra.execute_operations(user_id, order_data)
logic_results = self.business.execute_logic(order_data)
# 最終的なオーケストレーション
return {
"order_id": f"order_12345",
"status": "completed",
"infra_results": infra_results,
"logic_results": logic_results
}
# グローバルなスレッドコンテキストで連携させる使用例
def handle_order_request(request_id: str, user_id: str, order_data: Dict):
# このリクエスト用のスレッドコンテキストを設定
thread_ctx.setup_for_request(request_id)
# app スレッドのコンテキストで実行
with weave.thread(thread_ctx.app_thread_id):
app = OrderProcessingApp()
result = app.process_order(user_id, order_data)
return result
# 使用例
order_result = handle_order_request(
request_id="req_789",
user_id="user_001",
order_data={"product_id": "laptop", "quantity": 1, "amount": 1299.99}
)
# 想定されるスレッド構造:
#
# App Thread: app_req_789
# └── Turn: process_order() ← メインのオーケストレーション
#
# Infra Thread: app_req_789_infra
# ├── Turn: authenticate_user() ← インフラストラクチャー操作 1
# ├── Turn: call_payment_gateway() ← インフラストラクチャー操作 2
# └── Turn: update_inventory() ← インフラストラクチャー操作 3
#
# Logic Thread: app_req_789_logic
# ├── Turn: validate_order() ← ビジネスロジック操作 1
# ├── Turn: calculate_pricing() ← ビジネスロジック操作 2
# └── Turn: apply_business_rules() ← ビジネスロジック操作 3
#
# 利点:
# - スレッドごとに関心事を明確に分離できる
# - スレッド ID を引数でバケツリレーする必要がない
# - app/infra/logic の各レイヤーを個別にモニタリングできる
# - スレッドコンテキストを通じてグローバルに連携できる
```
API 仕様
以下のセクションでは、スレッドのクエリエンドポイント、そのリクエストと応答のスキーマ、およびスレッドデータをプログラムから取得する際に使用できる一般的なクエリパターンについて説明します。
エンドポイント
エンドポイント: `POST /threads/query`
リクエストスキーマ
```python lines theme={"system"}
class ThreadsQueryReq:
project_id: str
limit: Optional[int] = None
offset: Optional[int] = None
sort_by: Optional[list[SortBy]] = None # サポートされるフィールド: thread_id、turn_count、start_time、last_updated
sortable_datetime_after: Optional[datetime] = None # グラニュール最適化を利用してスレッドをフィルターします
sortable_datetime_before: Optional[datetime] = None # グラニュール最適化を利用してスレッドをフィルターします
```
応答スキーマ
```python lines theme={"system"}
class ThreadSchema:
thread_id: str # スレッドの一意の ID
turn_count: int # このスレッド内のターン Call の数
start_time: datetime # このスレッド内のターン Call のうち最も早い開始時刻
last_updated: datetime # このスレッド内のターン Call のうち最も遅い終了時刻
class ThreadsQueryRes:
threads: List[ThreadSchema]
```
最近アクティブなスレッドをクエリする
この例では、更新日時が新しい順に 50 件のスレッドを取得します。`my-project` は実際の project ID に置き換えてください。
```python lines theme={"system"}
# 最近アクティブだったスレッドを取得
response = client.threads_query(ThreadsQueryReq(
project_id="my-project",
sort_by=[SortBy(field="last_updated", direction="desc")],
limit=50
))
for thread in response.threads:
print(f"Thread {thread.thread_id}: {thread.turn_count} turns, last active {thread.last_updated}")
```
アクティビティレベル別にスレッドをクエリする
この例では、最もアクティブなスレッド上位 20 件をターン数順に並べて取得します。
```python lines theme={"system"}
# 最もアクティブな(ターン数が最も多い)スレッドを取得
response = client.threads_query(ThreadsQueryReq(
project_id="my-project",
sort_by=[SortBy(field="turn_count", direction="desc")],
limit=20
))
```
最近のスレッドのみをクエリする
この例では、過去 24 時間以内に開始されたスレッドを返します。時間ウィンドウを変更するには、`timedelta` の `days` の値を調整してください。
```python lines theme={"system"}
from datetime import datetime, timedelta
# 過去 24 時間以内に開始されたスレッドを取得
yesterday = datetime.now() - timedelta(days=1)
response = client.threads_query(ThreadsQueryReq(
project_id="my-project",
sortable_datetime_after=yesterday,
sort_by=[SortBy(field="start_time", direction="desc")]
))
```