> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Evaluation Playground を使用してモデル性能を比較する
> カスタムデータセットと LLM ジャッジモデルを使い、Weave の Evaluation Playground でコードを書かずにモデル性能を比較・評価します。
Evaluation Playground では、既存のモデルにアクセスし、評価用データセットと LLM ジャッジモデルを使ってモデル性能を比較できます。コードを設定することなく、モデルの実験と比較を始められます。また、プレイグラウンドで作成したモデル、Scorer、データセットを保存し、後で開発やデプロイメントに使用できます。
たとえば、Evaluation Playground を開き、以前に保存したモデルを 2 つ追加して、新しい、または以前に保存した質問応答形式の評価用データセットに基づいてモデル性能を評価できます。その後、画面上で新しいモデルを追加してシステムプロンプトを設定し、3 つのモデルすべてで新たな評価を実行して、それぞれのモデル性能を比較できます。
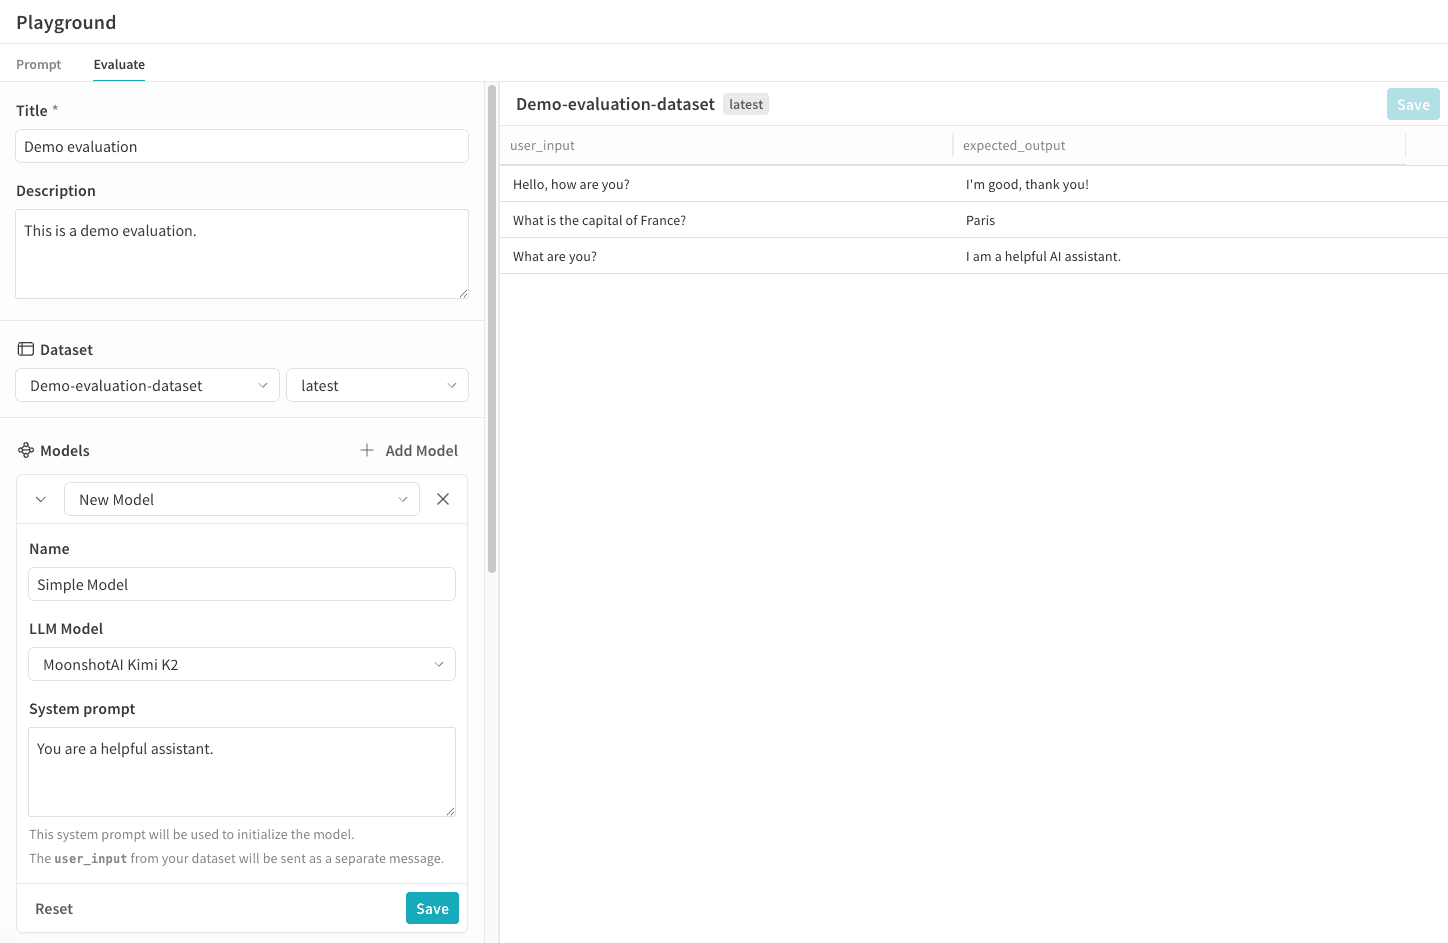
Playground で評価を設定する
以下のセクションでは、Evaluation Playground を開いて評価の出発点を選び、データセット、モデル、Scorer を設定する方法について説明します。
Evaluation Playground で評価を設定するには、次の手順に従います。
1. [Weights & Biases UI](https://forge.coreweave.com/wandb/wandb/quickstart_playground/weave/playground) を開き、評価を実行するプロジェクトを開きます。Traces ページが表示されます。
2. Traces ページで、左側のメニューにある **Playground** アイコンをクリックし、Playground ページの **Evaluate** タブを選択します。Evaluate ページでは、次のいずれかを選択できます。
* **Load a demo example**: MoonshotAI Kimi K2 モデルを期待される出力に照らして評価し、LLM ジャッジモデル でその正確性を判定する、定義済みの設定を読み込みます。この設定を使って、インターフェースを試してみることができます。
* **Start from scratch**: 空の設定を読み込みます。ここから一から構築できます。
3. **Start from scratch** を選択した場合は、**Title** フィールドと **Description** フィールドに、評価の内容がわかるタイトルと説明を入力します。
次のセクションの手順に従って、データセット、モデル、Scorer を設定してください。
データセットを追加する
[Datasets](/ja/products/wandb/weave/guides/core-types/datasets) は、ユーザー入力の例とモデルからの期待される応答の整理されたコレクションです。評価中、プレイグラウンドは各テスト入力をモデルにフィードし、出力を収集した後、正しさなどの選択したメトリクスに基づいて出力をスコアリングします。UI でデータセットを作成したり、project にすでに保存されている既存のデータセットを追加したり、新しいデータセットをアップロードしたりできます。
次の形式でデータセットをアップロードできます。
* `.csv`
* `.tsv`
* `.json`
* `.jsonl`
データセットのフォーマット方法および Weave への保存方法の詳細については、Datasets のドキュメントを参照してください。
**Dataset** セクションでデータセットを追加するには:
1. ドロップダウンメニューをクリックし、次のいずれかを選択します。
* 新しいデータセットを UI で作成するには、**Start from scratch** を選択します。
* ローカルマシンからデータセットをアップロードするには、**Upload a file** を選択します。
* project にすでに保存されている既存のデータセットを選択します。
2. オプション: 後で使用するためにデータセットを project に保存するには、**Save** をクリックします。
オプションを選択すると、データセットが UI の右側のペインに表示され、クリックして各フィールドを必要に応じて編集できます。また、**Add row** をクリックしてデータセットに新しい行を追加することもできます。
UI で編集できるのは新しいデータセットのみです。
また、データセットの列名を `user_input` および `expected_output` に設定することが重要です。これにより、Scorer がデータにアクセスできるようになります。
モデルを追加する
Weave のコンテキストでは、[モデル](/ja/products/wandb/weave/guides/core-types/models) は AI モデル (GPT など) と、評価中にモデルがどのように動作するかを定義する環境 (この場合はシステムプロンプト) の組み合わせです。project 内の既存のモデルを選択したり、新しく作成して評価したりできます。また、同じデータセットと Scorer を使用して同時に評価するために、複数のモデルを一度に追加することも可能です。**プレイグラウンド機能を使用して作成したモデルのみを使用できます。**
Evaluation Playground の **Models** セクションでモデルを追加するには:
1. **Add Model** をクリックし、**New Model** または既存のモデルをドロップダウンメニューから選択します。
2. **New Model** を選択した場合、次のフィールドを設定します:
* **Name**: 新しいモデルに説明的な名前を付けます。
* **LLM Model**: 新しいモデルの基盤となるファウンデーションモデル (OpenAI の GPT-4 など) を選択します。すでにアクセスを設定済みのファウンデーションモデルの一覧から選択するか、**Add AI provider** を選択してモデルへのアクセスを追加できます。プロバイダーを追加すると、そのプロバイダーのアクセス認証情報の入力を求められます。Weave を使用してモデルにアクセスするために必要な API キー、エンドポイント、その他の設定情報の確認方法については、プロバイダーのドキュメントを参照してください。
* **System Prompt**: モデルの動作方法に関する指示を指定します。例: `You are a helpful assistant specializing in Python programming.` データセットの `user_input` は後続のメッセージで送信されるため、システムプロンプトに含める必要はありません。
既存のモデルを選択した場合、モデルの名前の横に既存のモデルのバージョンを選択できる新しいフィールドが表示され、その他のフィールドは設定不要です。評価の前後に既存のモデルを変更するには、[Prompt Playground](/ja/products/wandb/weave/guides/tools/playground) を使用してください。
3. オプション: **Save** をクリックして、モデルを後で使用できるように project に保存します。
4. オプション: 複数のモデルを同時に評価するには、再度 **Add Model** をクリックして他のモデルを追加します。
スコアラーを追加する
[Scorer](/ja/products/wandb/weave/guides/evaluation/scorers) は LLM ジャッジモデルを使用して、AI モデル出力の品質を測定および評価します。project 内の既存の Scorer を選択するか、新しいものを作成してモデルを評価できます。
Evaluation Playground で Scorer を追加するには:
1. **Add Scorer** をクリックし、次のフィールドを設定します:
* **Name**: Scorer に説明的な名を追加します。
* **Type**: スコアの出力方法を選択します。boolean または number のいずれかです。Boolean Scorer は、モデルの出力が設定した判断パラメーターを満たしたかどうかに応じて binary の `True` または `False` を返します。Number Scorer は `0` から `1` の間のスコアを出力し、モデルの出力が判断パラメーターをどの程度満たしたかの一般的な評価を提供します。
* **LLM-as-a-judge-model**: Scorer の judge として使用する ファウンデーションモデル を選択します。**Models** セクションの LLM Model フィールドと同様に、すでにアクセスを設定した ファウンデーションモデル から選択するか、新しい ファウンデーションモデル へのアクセスを設定できます。
* **Scoring Prompt**: 出力のスコアリングのための LLM ジャッジモデル パラメーターを提供します。たとえば、ハルシネーションをチェックする場合、以下のようなスコアリング プロンプトを入力します:
```text theme={"system"}
Given the following context and answer, determine if the answer contains any information not supported by the context.
User input: {user_input}
Expected output: {expected_output}
Model Output: {output}
Is the model output correct?
```
データセットと応答のフィールドをスコアリング プロンプト内の変数として使用できます。例: `{user_input}`、`{expected_output}`、`{output}`。利用可能な変数のリストを表示するには、UI の **Insert variable** をクリックします。
2. オプション: **Save** をクリックして、Scorer を後で使用できるように project に保存します。
評価の実行
データセット、モデル、Scorerが設定されたら、評価を実行して結果を生成する準備ができました。
* Evaluation Playgroundで評価を実行するには、**Run eval**をクリックします。
Weaveは追加した各モデルに対して個別の評価を実行し、データセットを使用して行われた各リクエストのメトリクスを収集します。Weaveはこれらの評価を**Evals**セクションに保存し、後で確認できるようにします。
Review evaluation results
評価が完了したら、各モデルがデータセットとScorerに対してどのようにパフォーマンスを発揮したかを比較するために結果を確認できます。
評価が完了すると、プレイグラウンドはモデルへの各リクエストで収集されたメトリクスを表示するreportを開きます。
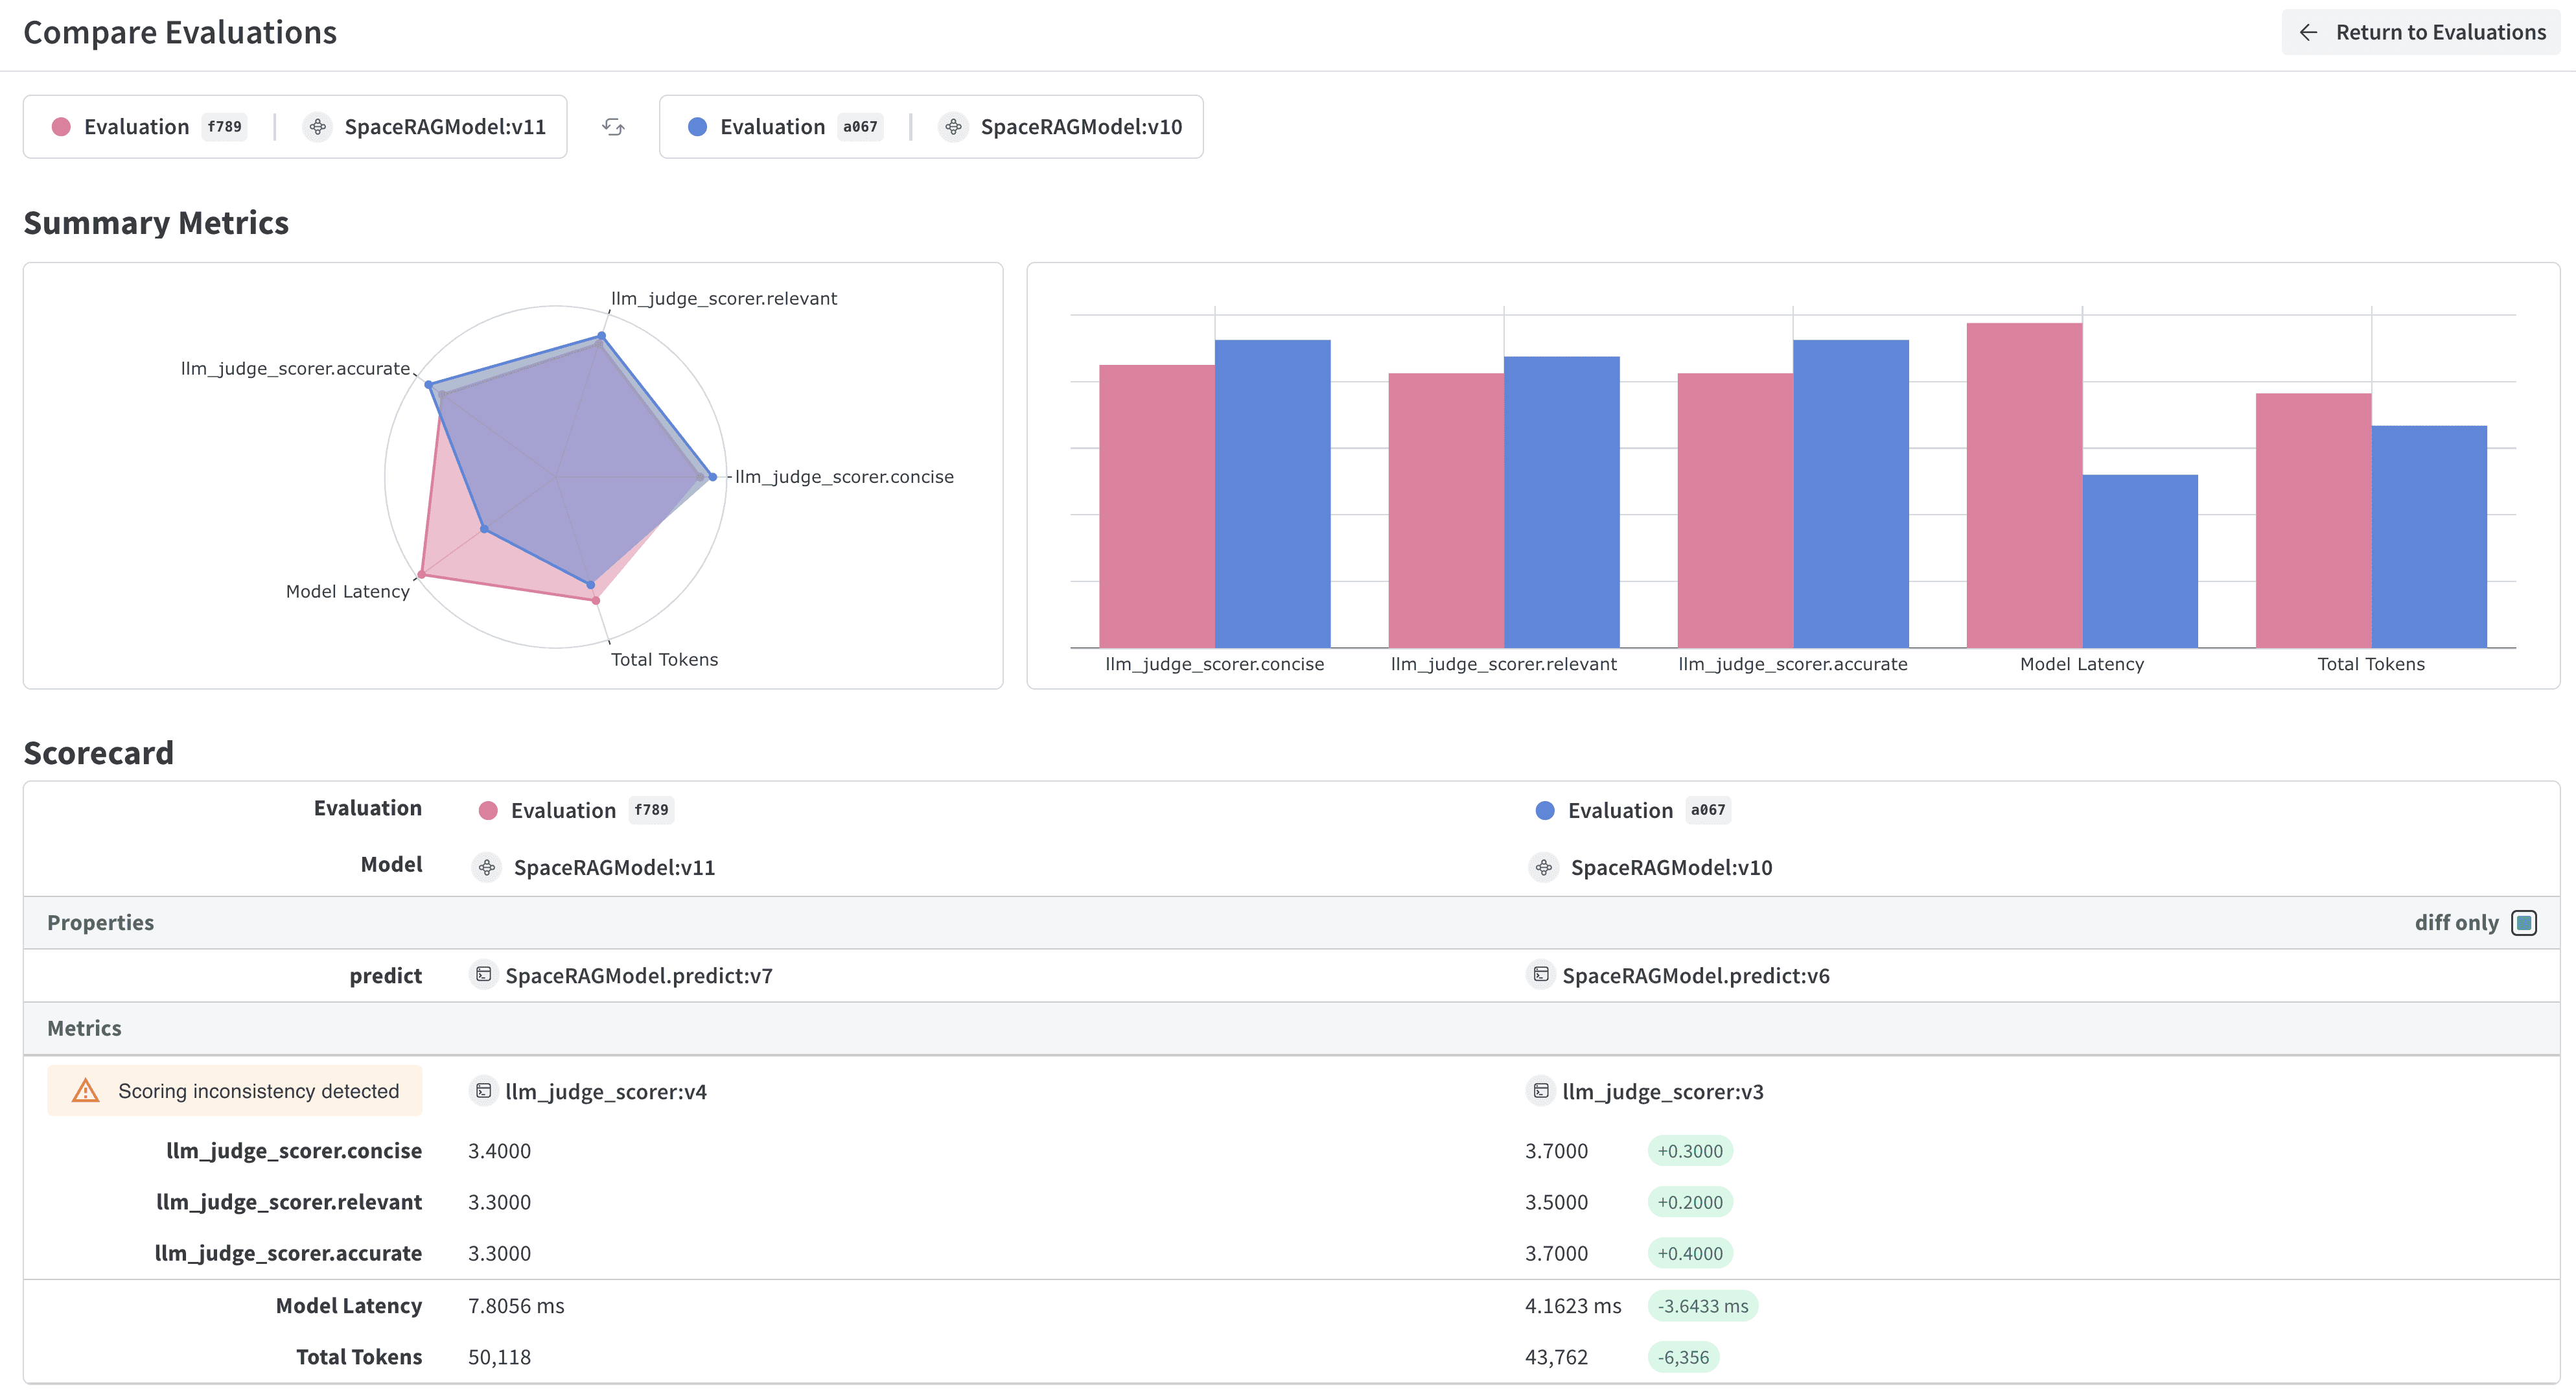 **Dataset results** タブには、入力、期待される出力、モデルの実際の出力、レイテンシー、トークン使用量、およびスコアリング結果が表示されます。**Row** 列のIdsをクリックすると、特定のリクエストセットのメトリクスの詳細ビューを開くことができます。また、タブのすぐ下にある表示形式ボタンを使用して、reportのセルの表示形式を変更することもできます。
**Summary** タブは、各モデルがどのようにパフォーマンスを発揮したかの概要を視覚的なデータ表現とともに提供します。
評価を開いて比較する方法の詳細については、[Evaluations](/ja/products/wandb/weave/guides/core-types/evaluations) を参照してください。