> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# LiteLLM
> LiteLLM 経由の LLM Call を自動的にトラッキングしてログします
 `weave.init()` を呼び出すと、Weave は LiteLLM 経由の LLM Call を自動的にトラッキングしてログします。このガイドでは、Weave と LiteLLM を組み合わせてトレースを取得する方法、Call をバージョン管理された Op でラップする方法、`Model` で実験を整理する方法、関数呼び出しの動作をトラッキングする方法について説明します。LLM アプリケーションを構築していて、LiteLLM がサポートする複数のモデルプロバイダー全体で可観測性を確保したい場合にご活用ください。
トレース
LLM アプリケーションのトレースは、開発中も本番環境でも、一元化されたデータベースに保存することが重要です。保存したトレースはデバッグに使用できるほか、アプリケーションの改善に役立つデータセットとしても活用できます。
> **注:** LiteLLM を使用する場合は、`from litellm import completion` ではなく `import litellm` でライブラリをインポートし、`litellm.completion()` で completion 関数を呼び出してください。これにより、すべての関数とパラメーターが正しく参照されます。
Weave は LiteLLM のトレースを自動的に取得します。ライブラリはこれまでどおり使用できます。まず `weave.init()` を呼び出してください。
```python lines {4} theme={"system"}
import litellm
import weave
weave.init("weave_litellm_integration")
openai_response = litellm.completion(
model="gpt-3.5-turbo",
messages=[{"role": "user", "content": "Translate 'Hello, how are you?' to French"}],
max_tokens=1024
)
print(openai_response.choices[0].message.content)
claude_response = litellm.completion(
model="claude-3-5-sonnet-20240620",
messages=[{"role": "user", "content": "Translate 'Hello, how are you?' to French"}],
max_tokens=1024
)
print(claude_response.choices[0].message.content)
```
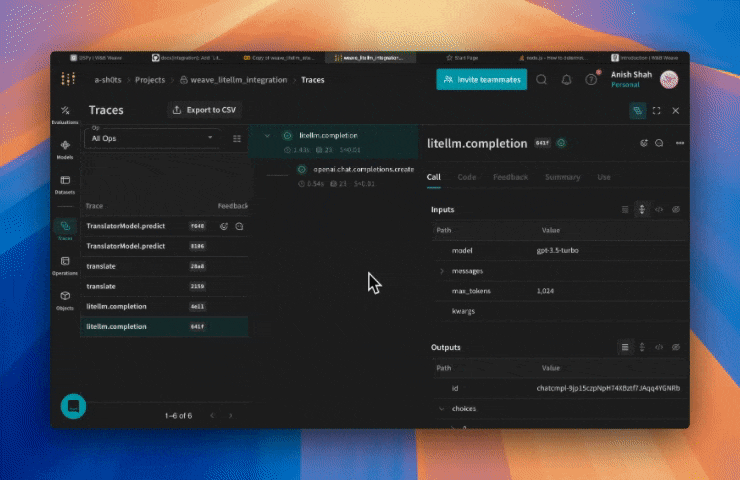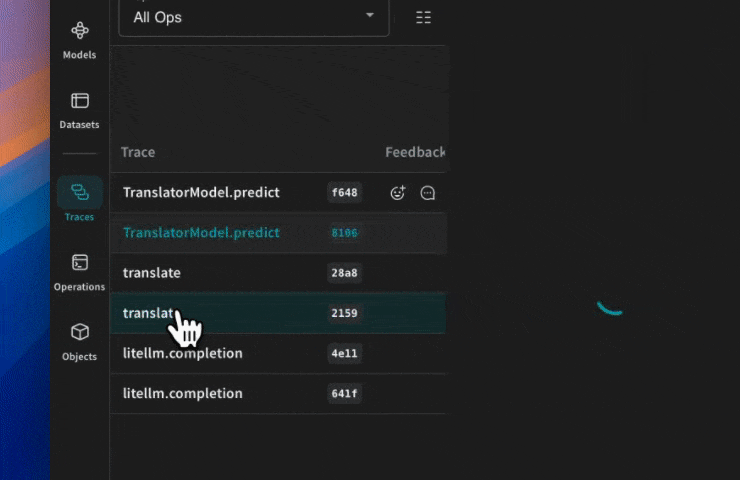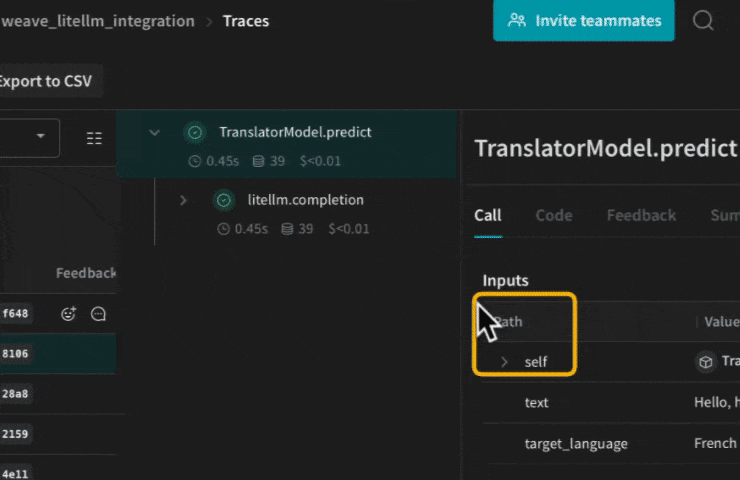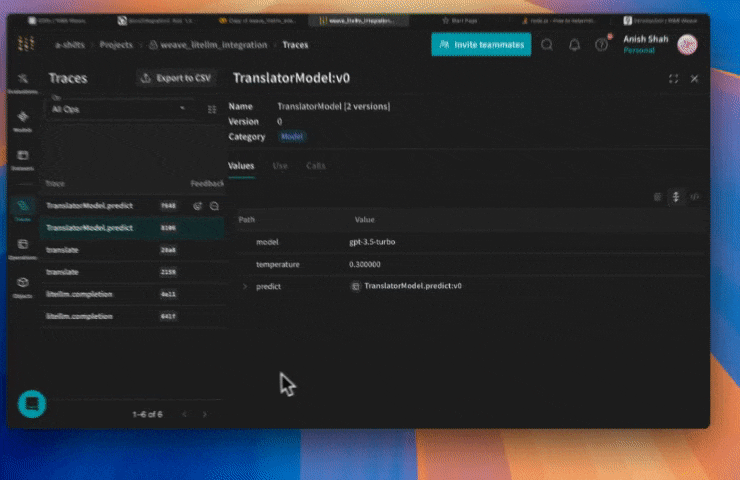
これで、Weave は LiteLLM を介して行われるすべての LLM Call をトラッキングし、ログするようになりました。トレースは Weave の Web インターフェースで確認できます。基本的なトレースの設定が完了したので、次のセクションでは、LiteLLM の Call を独自の Weave Op でラップし、アプリケーションロジックをより細かい粒度で、バージョン管理しながらトラッキングする方法を説明します。
独自の Op でラップする
Weave Op は、実験中にコードを自動的にバージョン管理することで結果を再現可能にし、さらに入力と出力を取得します。LiteLLM の completion 関数を呼び出す関数を作成して `@weave.op()` でデコレートすると、Weave が入力と出力を自動的にトラッキングします。以下に例を示します。
```python lines {4,6} theme={"system"}
import litellm
import weave
weave.init("weave_litellm_integration")
@weave.op()
def translate(text: str, target_language: str, model: str) -> str:
response = litellm.completion(
model=model,
messages=[{"role": "user", "content": f"Translate '{text}' to {target_language}"}],
max_tokens=1024
)
return response.choices[0].message.content
print(translate("Hello, how are you?", "French", "gpt-3.5-turbo"))
print(translate("Hello, how are you?", "Spanish", "claude-3-5-sonnet-20240620"))
```
実験を効率化するために `Model` を作成する
多くの要素が同時に変化する状況では、実験を整理するのは困難です。`Model` クラスを使用すると、システムプロンプトや使用しているモデルなど、アプリの実験に関する詳細を取得して整理できます。これにより、アプリのさまざまな反復処理を整理して比較しやすくなります。
Model は、コードのバージョン管理や入力と出力の取得に加えて、アプリケーションの動作を制御する構造化されたパラメーターも取得します。これにより、どのパラメーターが最も効果的かを見つけやすくなります。また、Weave モデルは `serve` や評価と組み合わせて使用することもできます。
次の例では、さまざまなモデルと temperature を試すことができます。
```python lines {4,6,10} theme={"system"}
import litellm
import weave
weave.init('weave_litellm_integration')
class TranslatorModel(weave.Model):
model: str
temperature: float
@weave.op()
def predict(self, text: str, target_language: str):
response = litellm.completion(
model=self.model,
messages=[
{"role": "system", "content": f"You are a translator. Translate the given text to {target_language}."},
{"role": "user", "content": text}
],
max_tokens=1024,
temperature=self.temperature
)
return response.choices[0].message.content
# モデルごとにインスタンスを作成する
gpt_translator = TranslatorModel(model="gpt-3.5-turbo", temperature=0.3)
claude_translator = TranslatorModel(model="claude-3-5-sonnet-20240620", temperature=0.1)
# 異なるモデルを使用して翻訳する
english_text = "Hello, how are you today?"
print("GPT-3.5 Translation to French:")
print(gpt_translator.predict(english_text, "French"))
print("\nClaude-3.5 Sonnet Translation to Spanish:")
print(claude_translator.predict(english_text, "Spanish"))
```
関数呼び出し
LiteLLM は、対応するモデルでの関数呼び出しをサポートしています。Weave はこれらの関数の Call を自動的にトラッキングするため、関数、引数、応答を他のトレースとあわせて確認できます。
```python lines {4} theme={"system"}
import litellm
import weave
weave.init("weave_litellm_integration")
response = litellm.completion(
model="gpt-3.5-turbo",
messages=[{"role": "user", "content": "Translate 'Hello, how are you?' to French"}],
functions=[
{
"name": "translate",
"description": "Translate text to a specified language",
"parameters": {
"type": "object",
"properties": {
"text": {
"type": "string",
"description": "The text to translate",
},
"target_language": {
"type": "string",
"description": "The language to translate to",
}
},
"required": ["text", "target_language"],
},
},
],
)
print(response)
```
Weave は、プロンプトで使用する関数を自動的に取得し、バージョン管理します。
[ ](https://forge.coreweave.com/wandb/a-sh0ts/weave_litellm_integration/weave/calls)