> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# コードから評価データをログする
> Python および TypeScript のコードから評価データを柔軟かつ段階的にログする方法
このガイドでは、`EvaluationLogger` を使用して、既存の Python または TypeScript のコードから予測とスコアを記録する方法を説明します。この方法を使えば、完全なデータセットと Scorer 一式を事前に定義しなくても、Weave でモデル性能を評価できます。データセットや Scorer が事前に定義されていない場合や、ワークフローの実行中に評価データを段階的にログする必要がある場合に、この方法を使用してください。
標準の `Evaluation` オブジェクトでは、事前定義された `Dataset` と `Scorer` オブジェクトのリストが必要です。一方、`EvaluationLogger` では、個々の予測とそれに関連するスコアを、得られた時点で段階的にログできます。
**より構造化された評価を行いたい場合**
データセットと Scorer を事前に定義する、より規定の明確な評価フレームワークを使用したい場合は、[標準の評価フレームワーク](/ja/products/wandb/weave/guides/core-types/evaluations)を参照してください。
`EvaluationLogger` は柔軟性に優れ、標準のフレームワークは明確な構造とガイダンスを備えています。
基本的なワークフロー
以下の手順を実行すると、予測ごとのスコアと集計サマリーを含む完全な評価が Weave に記録され、Weights & Biases UI で確認できるようになります。
1. *ロガーを初期化する:* `EvaluationLogger` のインスタンスを作成します。必要に応じて、`model` と `dataset` に関するメタデータを指定できます。省略した場合、Weave はデフォルト値を使用します。
LLM Call (OpenAI など) のトークン使用量とコストを取得するには、LLM の invocation より前に `EvaluationLogger` を初期化してください。
先に LLM を呼び出してから予測をログした場合、Weave はトークンとコストのデータを取得しません。
2. *予測をログする:* システムの入力と出力のペアごとに `log_prediction()` を呼び出します。
3. *スコアをログする:* 返された `ScoreLogger` の `log_score()` を使用して、その予測のスコアをログします。1 つの予測に複数のスコアをログできます。
4. *予測を完了する:* 予測のスコアをログした後は、必ず `finish()` を呼び出して予測を確定してください。
5. *サマリーをログする:* すべての予測を処理した後、`log_summary()` を呼び出してスコアを集計します。必要に応じてカスタムメトリクスを追加することもできます。
予測に対して `finish()` を呼び出した後は、その予測にスコアをログできなくなります。
このワークフローを示す Python の例については、[基本的な例](#basic-example)を参照してください。出力とすべてのスコアが一度に揃っている場合、Python ユーザーは [`log_example()`](#simplified-logging-with-log_example) を使用して、ステップ 2 から 4 を 1 回の呼び出しにまとめることができます。
基本的な例
次の例では、`EvaluationLogger` を使用して、既存のコード内で予測とスコアをインラインでログする方法を示します。`[YOUR-TEAM]/[YOUR-PROJECT]` は、ご自身の W\&B の entity と project に置き換えてください。
`user_model` 関数を定義し、入力のリストに適用します。各例では、次の処理が行われます。
* `log_prediction` を使用して、入力と出力をログします。
* `log_score` を使用して、正確性スコア (`correctness_score`) をログします。
* `finish()` を呼び出すと、その予測のログが確定します。
最後に、`log_summary` で集計メトリクスを記録し、Weave でのスコアの自動集計をトリガーします。
```python lines theme={"system"}
import weave
from openai import OpenAI
from weave import EvaluationLogger
weave.init('[YOUR-TEAM]/[YOUR-PROJECT]')
# トークンを確実にトラッキングするため、モデルを呼び出す「前に」EvaluationLogger を初期化します
eval_logger = EvaluationLogger(
model="my_model",
dataset="my_dataset"
)
# 入力データの例(任意のデータ構造を使用できます)
eval_samples = [
{'inputs': {'a': 1, 'b': 2}, 'expected': 3},
{'inputs': {'a': 2, 'b': 3}, 'expected': 5},
{'inputs': {'a': 3, 'b': 4}, 'expected': 7},
]
# OpenAI を使用したモデルロジックの例
@weave.op
def user_model(a: int, b: int) -> int:
oai = OpenAI()
response = oai.chat.completions.create(
messages=[{"role": "user", "content": f"What is {a}+{b}?"}],
model="gpt-4o-mini"
)
# 応答を必要に応じて使用します(ここでは簡略化のため、単に a + b を返します)
return a + b
# 各サンプルに対して予測を行い、ログします
for sample in eval_samples:
inputs = sample["inputs"]
model_output = user_model(**inputs) # 入力をキーワード引数(kwargs)として渡します
# 予測の入力と出力をログします
prediction = eval_logger.log_prediction(
inputs=inputs,
output=model_output
)
# この予測のスコアを計算してログします
expected = sample["expected"]
correctness_score = model_output == expected
prediction.log_score(
scorer="correctness", # Scorer 名(シンプルな string)
score=correctness_score
)
# この予測のログを終了します
prediction.finish()
# 評価全体の最終サマリーをログします。
# 上記でログした 'correctness' スコアは Weave が自動的に集計します。
summary_stats = {"subjective_overall_score": 0.8}
eval_logger.log_summary(summary_stats)
print("Evaluation logging complete. View results in the Weave UI.")
```
TypeScript SDK には 2 つの API パターンがあります。
* **ファイア・アンド・フォーゲット API (ほとんどの場合に推奨) **: `logPrediction()` を `await` なしで使用すると、同期的かつノンブロッキングでログできます。
* **Awaitable API**: 次の処理に進む前に操作の完了を保証する必要がある場合は、`logPredictionAsync()` を `await` と組み合わせて使用します。
ファイア・アンド・フォーゲットは次のような場合に適しています。
* **高スループット**: 各ログ操作の完了を待たずに、複数の予測を並列で処理できます。
* **既存コードへの影響を最小限に抑える**: 既存の async/await のフローを再構成することなく、評価のログを追加できます。
* **シンプルさ**: ほとんどの評価シナリオで、定型コードが少なく、すっきりとした構文で記述できます。
`logSummary()` は結果を集計する前に、保留中のすべての操作が完了するのを自動的に待機します。そのため、ファイア・アンド・フォーゲットパターンは安全に使用できます。
次の例では、ファイア・アンド・フォーゲットパターンを使用してモデルの予測を評価します。評価ロガーをセットアップし、3 つのテストサンプルに対してモデルを実行した後、await を使用せずに予測をログします。
```typescript twoslash lines {36,50} theme={"system"}
// @noErrors
import weave, {EvaluationLogger} from 'weave';
import OpenAI from 'openai';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
// トークンを確実にトラッキングするため、モデルを呼び出す「前に」EvaluationLogger を初期化します
const evalLogger = new EvaluationLogger({
name: 'my-eval',
model: 'my_model',
dataset: 'my_dataset'
});
// 入力データの例
const evalSamples = [
{inputs: {a: 1, b: 2}, expected: 3},
{inputs: {a: 2, b: 3}, expected: 5},
{inputs: {a: 3, b: 4}, expected: 7},
];
// OpenAI を使用したモデルロジックの例
const userModel = weave.op(async function userModel(a: number, b: number): Promise {
const oai = new OpenAI();
const response = await oai.chat.completions.create({
messages: [{role: 'user', content: `What is ${a}+${b}?`}],
model: 'gpt-4o-mini'
});
return a + b;
});
// サンプルごとに予測を行い、ファイア・アンド・フォーゲットパターンでログします
for (const sample of evalSamples) {
const {inputs} = sample;
const modelOutput = await userModel(inputs.a, inputs.b);
// ファイア・アンド・フォーゲット: logPrediction に await は不要です
const prediction = evalLogger.logPrediction(inputs, modelOutput);
// この予測のスコアを計算してログします
const correctnessScore = modelOutput === sample.expected;
// ファイア・アンド・フォーゲット: logScore に await は不要です
prediction.logScore('correctness', correctnessScore);
// ファイア・アンド・フォーゲット: finish に await は不要です
prediction.finish();
}
// logSummary は、保留中のすべての操作が完了するまで内部で待機します
const summaryStats = {subjective_overall_score: 0.8};
await evalLogger.logSummary(summaryStats);
console.log('Evaluation logging complete. View results in the Weave UI.');
```
エラー処理を管理する場合や、処理間に順序上の依存関係がある場合など、各操作の完了を確認してから次に進む必要があるときは、awaitable API を使用します。
次の例では、`await` を付けずに `logPrediction()` を呼び出すのではなく、`await` を付けて `logPredictionAsync()` を使用することで、各操作が完了してから次の操作に進むようにしています。
```typescript twoslash lines theme={"system"}
// @noErrors
// logPrediction の代わりに logPredictionAsync を使用します
const prediction = await evalLogger.logPredictionAsync(inputs, modelOutput);
// 各操作を await で待機します
await prediction.logScore('correctness', correctnessScore);
await prediction.finish();
```
`log_example()` による簡易ログ
`log_example()` を使用すると、入力、出力、スコアを 1 回の呼び出しでログできます。この便利なメソッドは `log_prediction()`、`log_score()`、`finish()` を 1 つのステップにまとめたものです。バッチ評価やオフライン評価のように、ログする入力、モデル出力、スコアがすでに揃っている場合に便利です。
```python lines theme={"system"}
import weave
from weave import EvaluationLogger
weave.init('[YOUR-TEAM]/[YOUR-PROJECT]')
eval_logger = EvaluationLogger(
model="my_model",
dataset="my_dataset"
)
eval_samples = [
{'inputs': {'a': 1, 'b': 2}, 'expected': 3},
{'inputs': {'a': 2, 'b': 3}, 'expected': 5},
{'inputs': {'a': 3, 'b': 4}, 'expected': 7},
]
for sample in eval_samples:
inputs = sample['inputs']
output = inputs['a'] + inputs['b']
eval_logger.log_example(
inputs=inputs,
output=output,
scores={"correctness": output == sample['expected']}
)
eval_logger.log_summary({"avg_score": 1.0})
```
上記の `log_example()` の呼び出しは、次のコードと同等です。
```python lines theme={"system"}
prediction = eval_logger.log_prediction(inputs=inputs, output=output)
prediction.log_score(scorer="correctness", score=output == sample['expected'])
prediction.finish()
```
`log_example()` は Weave TypeScript SDK では使用できません。TypeScript をご利用の場合は、[基本的な例](#basic-example)で示している `logPrediction()` と `logScore()` のパターンを使用してください。
高度な使い方
`EvaluationLogger` は、基本的なワークフローにとどまらず、より複雑な評価シナリオに対応できる柔軟なパターンを提供します。以下のセクションでは、コンテキストマネージャーを使用したリソースの自動管理、エージェントのトレースと評価の行の関連付け、モデルの実行とログ処理の分離、リッチメディアデータの扱い方、複数のモデル評価の並列比較など、高度な手法について説明します。
コンテキストマネージャーを使用する
`EvaluationLogger` は、予測とスコアの両方でコンテキストマネージャー (`with` ステートメント) をサポートしています。これにより、コードがより簡潔になり、リソースのクリーンアップが自動化され、LLM ジャッジモデルの Call などのネストされた操作をより正確に追跡できます。
この場面で `with` ステートメントを使用すると、次のメリットがあります。
* コンテキストを抜けると `finish()` が自動的に呼び出されます。
* ネストされた LLM Call のトークンとコストをより正確にトラッキングできます。
* 予測コンテキスト内で、モデルの実行後に出力を設定できます。
```python lines {16,24,31,40} theme={"system"}
import openai
import weave
weave.init("nested-evaluation-example")
oai = openai.OpenAI()
# ロガーを初期化する
ev = weave.EvaluationLogger(
model="gpt-4o-mini",
dataset="joke_dataset"
)
user_prompt = "Tell me a joke"
# 予測にコンテキストマネージャーを使用する - finish() を呼び出す必要はありません
with ev.log_prediction(inputs={"user_prompt": user_prompt}) as prediction:
# コンテキスト内でモデルの Call を実行する
result = oai.chat.completions.create(
model="gpt-4o-mini",
messages=[{"role": "user", "content": user_prompt}],
)
# モデルの Call の後に出力を設定する
prediction.output = result.choices[0].message.content
# シンプルなスコアをログする
prediction.log_score("correctness", 1.0)
prediction.log_score("ambiguity", 0.3)
# LLM Call が必要なスコアにはネストされたコンテキストマネージャーを使用する
with prediction.log_score("llm_judge") as score:
judge_result = oai.chat.completions.create(
model="gpt-4o-mini",
messages=[
{"role": "system", "content": "Rate how funny the joke is from 1-5"},
{"role": "user", "content": prediction.output},
],
)
# 計算後にスコアの値を設定する
score.value = judge_result.choices[0].message.content
# 'with' ブロックを抜けると finish() が自動的に呼び出されます
ev.log_summary({"avg_score": 1.0})
```
このパターンでは、ネストされたすべての操作が追跡されて親の予測に関連付けられるため、Weights & Biases UI で正確なトークン使用量とコストのデータを確認できます。
TypeScript には、Python の `with` ステートメントのようなコンテキストマネージャーのパターンがありません。代わりに、ファイア・アンド・フォーゲットパターンを使用し、`finish()` を明示的に呼び出してください。
次の例では、予測をログし、スコアと LLM ジャッジモデルのスコアを追加した後、`finish()` で予測を確定します。
```typescript twoslash lines {43} theme={"system"}
// @noErrors
import weave from 'weave';
import OpenAI from 'openai';
import {EvaluationLogger} from 'weave/evaluationLogger';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
const oai = new OpenAI();
// ロガーを初期化する
const ev = new EvaluationLogger({
name: 'joke-eval',
model: 'gpt-4o-mini',
dataset: 'joke_dataset',
});
const userPrompt = 'Tell me a joke';
// モデル出力を取得する
const result = await oai.chat.completions.create({
model: 'gpt-4o-mini',
messages: [{role: 'user', content: userPrompt}],
});
const modelOutput = result.choices[0].message.content;
// 出力付きで予測をログする
const prediction = ev.logPrediction({user_prompt: userPrompt}, modelOutput);
// シンプルなスコアをログする
prediction.logScore('correctness', 1.0);
prediction.logScore('ambiguity', 0.3);
// LLM ジャッジモデルのスコアの場合は、Call を実行して結果をログする
const judgeResult = await oai.chat.completions.create({
model: 'gpt-4o-mini',
messages: [
{role: 'system', content: 'Rate how funny the joke is from 1-5'},
{role: 'user', content: modelOutput || ''},
],
});
prediction.logScore('llm_judge', judgeResult.choices[0].message.content);
// スコアリングが完了したら明示的に finish を呼び出す
prediction.finish();
await ev.logSummary({avg_score: 1.0});
```
TypeScript にはコンテキストマネージャーによる自動クリーンアップはありませんが、`logSummary()` は結果を集計する前に、終了していない予測をすべて自動的に終了します。`finish()` を明示的に呼び出したくない場合は、この動作に任せることができます。
エージェントのトレースを評価にリンクする
Python では、トレース対象の各エージェント呼び出しを、それぞれの `log_prediction()` コンテキスト内で実行してください。`EvaluationLogger` は、そのコンテキスト内で作成されたスパンに評価 run、サンプル、試行のメタデータを設定します。Weave はこのメタデータを使用して、トレースを評価結果にリンクします。
評価とエージェント スパンの自動リンクは Python でのみ利用できます。TypeScript の `EvaluationLogger` と `Evaluation.evaluate()` はいずれも、エージェント スパンをリンクするための実行中の評価スコープを作成しません。TypeScript でスパンをリンクするには、このセクションで説明する OTel 属性を直接設定する必要があります。また、これは両方の Call ID がすでに取得できている場合にのみ可能です。
次の例では [OpenAI Agents SDK](/ja/products/wandb/weave/guides/integrations/agents/openai-agents-sdk) を使用しています。Weave がトレースできる他のエージェント フレームワークでも、同じパターンを適用できます。`[YOUR-TEAM]/[YOUR-PROJECT]` は、ご自身の W\&B entity と project に置き換えてください。
```python lines {18-28} theme={"system"}
import weave
from agents import Agent, Runner
from weave import EvaluationLogger
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
agent = Agent(
name="Support agent",
instructions="Answer with only the city name.",
)
eval_logger = EvaluationLogger(
name="support-agent-eval",
model="support-agent",
dataset="support-prompts",
)
question = "What is the capital of France?"
with eval_logger.log_prediction(
inputs={"prompt": question},
example_id="capital-of-france",
) as prediction:
result = Runner.run_sync(agent, question)
output = str(result.final_output or "")
prediction.output = output
prediction.log_score(
scorer="contains_expected_answer",
score="paris" in output.lower(),
)
eval_logger.log_summary()
```
この機能は TypeScript では利用できません。
予測コンテキストの開始前または終了後にエージェントを実行した場合、Weave はトレースを記録しますが、評価結果にはリンクしません。
前述のコード例のように、エージェントが `log_prediction()` コンテキスト内で実行され、Weave インテグレーションによってトレースされる場合は、Weave がトレースを評価結果に自動的にリンクします。それ以外の場合は、リンク用の 2 つの ID をエージェント スパンに自分で設定する必要があります。設定方法は、スパンが作成される場所によって異なります。
* **同一プロセスで独自のインストルメンテーションを使用する場合:** 各スパンに属性を直接設定します。
* **別のサービスでスパンが作成される場合:** 両方の ID をそのサービスに送信し、そのサービスが作成するスパンに設定します。
自分でインストルメントしたスパンをリンクする
`log_prediction()` コンテキスト内で作成されたスパンには、`EvaluationLogger` がすべての属性を自動的に設定します。ただし、独自の OpenTelemetry (OTel) インストルメンテーションでスパンを送信する場合は、リンクする各スパンに属性を直接設定する必要があります。評価用に設定できる属性は次のとおりです。
| 属性 | タイプ | 説明 |
| - | - | - |
| `weave.eval.run_id` | string | (必須) 評価 run (`Evaluation.evaluate`) の Call ID。評価レベルの **スパンを表示** の結果にスパンを含めるために必要です。 |
| `weave.eval.predict_and_score_call_id` | string | (必須) 特定の結果と試行に対応する `Evaluation.predict_and_score` 操作の Call ID。`weave.eval.run_id` と併せて設定すると、スパンがその結果にリンクされます。 |
| `weave.eval.kind` | string | (オプション) 評価のカテゴリ。Weave では、エージェント評価には `agent`、標準評価には `standard` を使用します。 |
| `weave.eval.row_digest` | string | (オプション) 評価対象のデータセット行を識別する安定したダイジェスト。指定しない場合、`EvaluationLogger` が予測の入力からこの値を導出します。 |
| `weave.eval.example_id` | string | (オプション) 評価対象のサンプルを識別する、呼び出し元が指定する ID。 |
| `weave.eval.trial_index` | integer | (オプション) データセット行に対する 0 始まりの試行番号。 |
| `weave.eval.evaluation_name` | string | (オプション) 人が読める形式の評価名。 |
| `weave.eval.project_id` | string | (オプション) Weave SDK が設定する project コンテキスト。この属性によってスパンがルーティングまたはリンクされることはありません。送信先の project は OTel リソース側で設定してください。 |
スパンは、`/agents/otel/v1/traces` エンドポイント経由で評価と同じ Weave プロジェクトに送信してください。OTel のスパン属性は親スパンから子スパンに伝播しないため、リンクするすべてのスパンに属性を設定する必要があります。
エンドポイントの詳細については、以下を参照してください。
* 既存の OTel パイプラインからスパンを送信する方法については、[Agents ビューに OpenTelemetry スパンを送信する](/ja/products/wandb/weave/guides/tracking/trace-agents-otel)を参照してください。
* エンドポイントの仕様については、[GenAI トレースをエクスポートする](/ja/products/wandb/weave/reference/service-api/agents/export-genai-trace)を参照してください。
評価および結果へのリンクを確立するのは、`weave.eval.run_id` と `weave.eval.predict_and_score_call_id` だけです。行ダイジェスト、サンプル ID、試行インデックス、種類、評価名はコンテキストを付加し、フィルタリングに役立ちますが、これらだけではリンクは作成されません。リンク用の 2 つの属性には、OTel のトレース ID やスパン ID ではなく、Weave の Call ID を使用してください。
どちらの ID も [評価結果クエリ API](/ja/products/wandb/weave/reference/service-api/eval-results/eval-results-query) から取得できます。応答内の各評価には `evaluation_call_id` が、各試行には `predict_and_score_call_id` が含まれています。
以下のサンプルでは、`span` がエージェント操作の OTel スパンであることを前提としています。角括弧で囲まれた各値は、そのスパンが属する 評価 run と結果のメタデータに置き換えてください。
TypeScript のサンプルは、予測スコープに依存せず OTel 属性を直接設定するため、正しく動作します。ただし、両方の Call ID がすでに取得できている場合にのみ使用してください。
```python lines theme={"system"}
span.set_attributes(
{
"weave.eval.run_id": "[EVALUATION-RUN-CALL-ID]",
"weave.eval.predict_and_score_call_id": "[PREDICT-AND-SCORE-CALL-ID]",
"weave.eval.kind": "agent",
"weave.eval.row_digest": "[ROW-DIGEST]",
"weave.eval.example_id": "[EXAMPLE-ID]",
"weave.eval.trial_index": 0,
"weave.eval.evaluation_name": "[EVALUATION-NAME]",
}
)
```
```typescript lines theme={"system"}
span.setAttributes({
'weave.eval.run_id': '[EVALUATION-RUN-CALL-ID]',
'weave.eval.predict_and_score_call_id': '[PREDICT-AND-SCORE-CALL-ID]',
'weave.eval.kind': 'agent',
'weave.eval.row_digest': '[ROW-DIGEST]',
'weave.eval.example_id': '[EXAMPLE-ID]',
'weave.eval.trial_index': 0,
'weave.eval.evaluation_name': '[EVALUATION-NAME]',
});
```
別のサービスで実行されるエージェントをリンクする
エージェントが別のサービスとして実行される場合、評価プロセスとエージェントはメモリを共有しません。そのため、Weave はリンク用の属性を自動的に設定できず、エージェントのスパンオブジェクトに直接アクセスすることもできません。代わりに、評価プロセスで両方の Call ID を取得してサービスに送信し、サービス側で作成されるスパンに設定します。この分散型の `EvaluationLogger` パターンは Python でのみ利用できます。
`log_prediction()` コンテキストに入ると、コンテキストの本体が実行される前に `Evaluation.predict_and_score` Call が作成されます。このコンテキストは、両方の Call ID を公開する `ScoreLogger` (以下の例では `prediction` にバインド) を返します。サービスの出力とスコアを同じ評価結果にログできるよう、サービスから応答が返るまでコンテキストを開いたままにしてください。
評価プロセスで、`[AGENT-SERVICE-URL]` をエージェントを実行するエンドポイントに、`[YOUR-TEAM]/[YOUR-PROJECT]` もそれぞれ適切な値に置き換えます。
```python lines {16-37} theme={"system"}
import requests
import weave
from weave import EvaluationLogger
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
eval_logger = EvaluationLogger(
name="support-agent-eval",
model="support-agent",
dataset="support-prompts",
)
question = "What is the capital of France?"
example_id = "capital-of-france"
trial_index = 0
with eval_logger.log_prediction(
inputs={"prompt": question},
example_id=example_id,
trial_index=trial_index,
) as prediction:
eval_context = {
"weave.eval.run_id": prediction.evaluate_call.id,
"weave.eval.predict_and_score_call_id": (
prediction.predict_and_score_call.id
),
"weave.eval.kind": "agent",
"weave.eval.example_id": example_id,
"weave.eval.trial_index": trial_index,
"weave.eval.evaluation_name": "support-agent-eval",
}
response = requests.post(
"[AGENT-SERVICE-URL]",
json={"prompt": question, "eval_context": eval_context},
timeout=60,
)
response.raise_for_status()
prediction.output = response.json()["output"]
eval_logger.log_summary()
```
エージェントサービス側では、受け取った属性を、結果に関連付けたいすべてのエージェントスパンにコピーします。次の関数は、生の OTel スパンを使った受信側の例です。評価と同じ `[YOUR-TEAM]/[YOUR-PROJECT]` にスパンをエクスポートするよう、サービスを設定してください。
```python lines {16,22} theme={"system"}
from typing import Any
import weave
from agents import Agent, Runner
from opentelemetry import trace
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
tracer = trace.get_tracer(__name__)
agent = Agent(
name="Support agent",
instructions="Answer with only the city name.",
)
def run_agent(request_body: dict[str, Any]) -> dict[str, str]:
eval_context = request_body["eval_context"]
with tracer.start_as_current_span(
"invoke_agent Support agent",
attributes={
"gen_ai.operation.name": "invoke_agent",
"gen_ai.agent.name": "Support agent",
**eval_context,
},
):
result = Runner.run_sync(agent, request_body["prompt"])
return {"output": str(result.final_output or "")}
```
この例では、ラッパースパンが評価結果にリンクされます。エージェントフレームワークが追加のスパンを作成する場合は、それらのスパンにも `eval_context` をコピーしてください。OTel では、スパン属性はラッパーから継承されません。
この機能は TypeScript では利用できません。
評価にリンクされたエージェント スパンを表示する
Weights & Biases UI でリンクされたスパンを確認するには、次の手順を実行します。
1. [Forge](https://forge.coreweave.com/wandb) にアクセスします。
2. Weave のサイドバーメニューで **Evals** をクリックします。
3. 対象の評価 run を選択します。
4. 評価の詳細パネルが開いたら、**Evaluation** タブで **スパンを表示** をクリックします。**Agents** ページが開き、その評価で絞り込まれた状態の **Spans** タブが表示されます。
既存のデータセットにリンクする
`log_prediction` に生のデータセットを `inputs` として渡すと、Weave は 評価 run のたびにデータを再インポートします。その結果、重複したデータが保存されるため、データセットが大きい場合や多くの評価で同じデータセットを再利用する場合には、ストレージ容量を無駄に消費する可能性があります。
この重複を避けるには、評価を実行する前にデータセットを Weave にパブリッシュし、パブリッシュしたデータセットの行を `inputs` として渡します。Weave は、パブリッシュ済みの行への参照を、データを再インポートすることなく内部参照によって解決します。この手法を使うと、標準の評価フレームワークと同じようにリンクされた状態を実現でき、Weights & Biases UI 上で各予測が特定のデータセット行に紐づけられます。
次の例では、データセットをパブリッシュして `EvaluationLogger` でリンクし、通常のデータセットと同じように取得して反復処理します。
```python lines theme={"system"}
import weave
from weave import EvaluationLogger
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
# データセットをパブリッシュする(一度だけ実行すれば十分です)
dataset = weave.Dataset(
name="my_eval_dataset",
rows=[
{"question": "What is the capital of France?", "expected": "Paris"},
{"question": "What U.S. state is Seattle in?", "expected": "Washington"},
{"question": "In which country is Mount Fuji?", "expected": "Japan"},
],
)
weave.publish(dataset)
# パブリッシュしたデータセットを取得する
dataset = weave.ref("my_eval_dataset").get()
```
```typescript twoslash lines theme={"system"}
// @noErrors
import weave, {EvaluationLogger, Dataset} from 'weave';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
// データセットをパブリッシュする(一度だけ実行すれば十分です)
const dataset = new Dataset({
name: 'my_eval_dataset',
rows: [
{"question": "What is the capital of France?", "expected": "Paris"},
{"question": "What U.S. state is Seattle in?", "expected": "Washington"},
{"question": "In which country is Mount Fuji?", "expected": "Japan"},
],
});
const datasetRef = await dataset.save();
// パブリッシュしたデータセットを取得する
const published = await datasetRef.get();
```
ログする前に出力を取得する
先にモデル出力を計算しておき、その後で予測とスコアを個別にログすることもできます。この方法では評価ロジックとログのロジックが分離されるため、予測の生成とスコアリングをシステム内の別々の部分が担当する場合に、コードのテストや保守がしやすくなります。
```python lines theme={"system"}
# トークンを確実にトラッキングするため、モデルを呼び出す前に EvaluationLogger を初期化します
ev = EvaluationLogger(
model="example_model",
dataset="example_dataset"
)
# トークンをトラッキングするため、モデル出力の生成 (OpenAI の Call など) はロガーの初期化後に行う必要があります
outputs = [your_output_generator(**inputs) for inputs in your_dataset]
predictions = [ev.log_prediction(inputs, output) for inputs, output in zip(your_dataset, outputs)]
for prediction, output in zip(predictions, outputs):
prediction.log_score(scorer="greater_than_5_scorer", score=output > 5)
prediction.log_score(scorer="greater_than_7_scorer", score=output > 7)
prediction.finish()
ev.log_summary()
```
ファイア・アンド・フォーゲットパターンは、複数の予測を並列に処理する場合に特に効果を発揮します。
次の例では、`EvaluationLogger` のインスタンスを複数同時に作成し、評価を並列にバッチ処理します。
```typescript twoslash lines theme={"system"}
// @noErrors
// トークンを確実にトラッキングするため、モデルを呼び出す前に EvaluationLogger を初期化します
const ev = new EvaluationLogger({
name: 'parallel-eval',
model: 'example_model',
dataset: 'example_dataset'
});
// トークンをトラッキングするため、モデル出力の生成 (OpenAI の Call など) はロガーの初期化後に行う必要があります
const outputs = await Promise.all(
yourDataset.map(inputs => yourOutputGenerator(inputs))
);
// ファイア・アンド・フォーゲット: await せずにすべての予測を処理します
const predictions = yourDataset.map((inputs, i) =>
ev.logPrediction(inputs, outputs[i])
);
predictions.forEach((prediction, i) => {
const output = outputs[i];
// ファイア・アンド・フォーゲット: await は不要です
prediction.logScore('greater_than_5_scorer', output > 5);
prediction.logScore('greater_than_7_scorer', output > 7);
prediction.finish();
});
// logSummary は保留中のすべての操作が完了するまで待機します
await ev.logSummary();
```
ファイア・アンド・フォーゲットパターンを使用すると、コンピュートリソースの許す限り多くの評価を並列に処理できます。
入力、出力、スコアには、画像、動画、オーディオ、構造化された表などのリッチメディアを含めることができます。リッチメディアをログすると、Weights & Biases UI でスコアと並べて実際のコンテンツを確認できるため、マルチモーダルモデルの定性分析に役立ちます。`log_prediction` メソッドまたは `log_score` メソッドに、dict またはメディアオブジェクトを渡してください。
```python lines theme={"system"}
import io
import wave
import struct
from PIL import Image
import random
from typing import Any
import weave
def generate_random_audio_wave_read(duration=2, sample_rate=44100):
n_samples = duration * sample_rate
amplitude = 32767 # 16 ビットの最大振幅
buffer = io.BytesIO()
# 波形データをバッファに書き込む
with wave.open(buffer, 'wb') as wf:
wf.setnchannels(1)
wf.setsampwidth(2) # 16 ビット
wf.setframerate(sample_rate)
for _ in range(n_samples):
sample = random.randint(-amplitude, amplitude)
wf.writeframes(struct.pack(' dict[str, Any]:
return {
"result": random.randint(0, 10),
"image": image,
"audio": audio,
}
ev = EvaluationLogger(model="example_model", dataset="example_dataset")
for inputs in rich_media_dataset:
output = your_output_generator(**inputs)
prediction = ev.log_prediction(inputs, output)
prediction.log_score(scorer="greater_than_5_scorer", score=output["result"] > 5)
prediction.log_score(scorer="greater_than_7_scorer", score=output["result"] > 7)
ev.log_summary()
```
TypeScript SDK では、`weaveImage` 関数と `weaveAudio` 関数を使用して画像とオーディオをログできます。次の例では、画像ファイルとオーディオファイルを読み込んでモデルで処理し、その結果をスコアとともにログします。
```typescript twoslash lines theme={"system"}
// @noErrors
import weave, {EvaluationLogger} from 'weave';
import * as fs from 'fs';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
// ファイルから画像とオーディオを読み込む
const richMediaDataset = [
{
image: weave.weaveImage({data: fs.readFileSync('sample1.png')}),
audio: weave.weaveAudio({data: fs.readFileSync('sample1.wav')}),
},
{
image: weave.weaveImage({data: fs.readFileSync('sample2.png')}),
audio: weave.weaveAudio({data: fs.readFileSync('sample2.wav')}),
},
];
// メディアを処理して結果を返すモデル
const yourOutputGenerator = weave.op(
async (inputs: {image: any; audio: any}) => {
const result = Math.floor(Math.random() * 10);
return {
result,
image: inputs.image,
audio: inputs.audio,
};
},
{name: 'yourOutputGenerator'}
);
const ev = new EvaluationLogger({
name: 'rich-media-eval',
model: 'example_model',
dataset: 'example_dataset',
});
for (const inputs of richMediaDataset) {
const output = await yourOutputGenerator(inputs);
// 入力と出力の両方にリッチメディアを含む予測をログする
const prediction = ev.logPrediction(inputs, output);
prediction.logScore('greater_than_5_scorer', output.result > 5);
prediction.logScore('greater_than_7_scorer', output.result > 7);
prediction.finish();
}
await ev.logSummary();
```
複数の評価をログして比較する
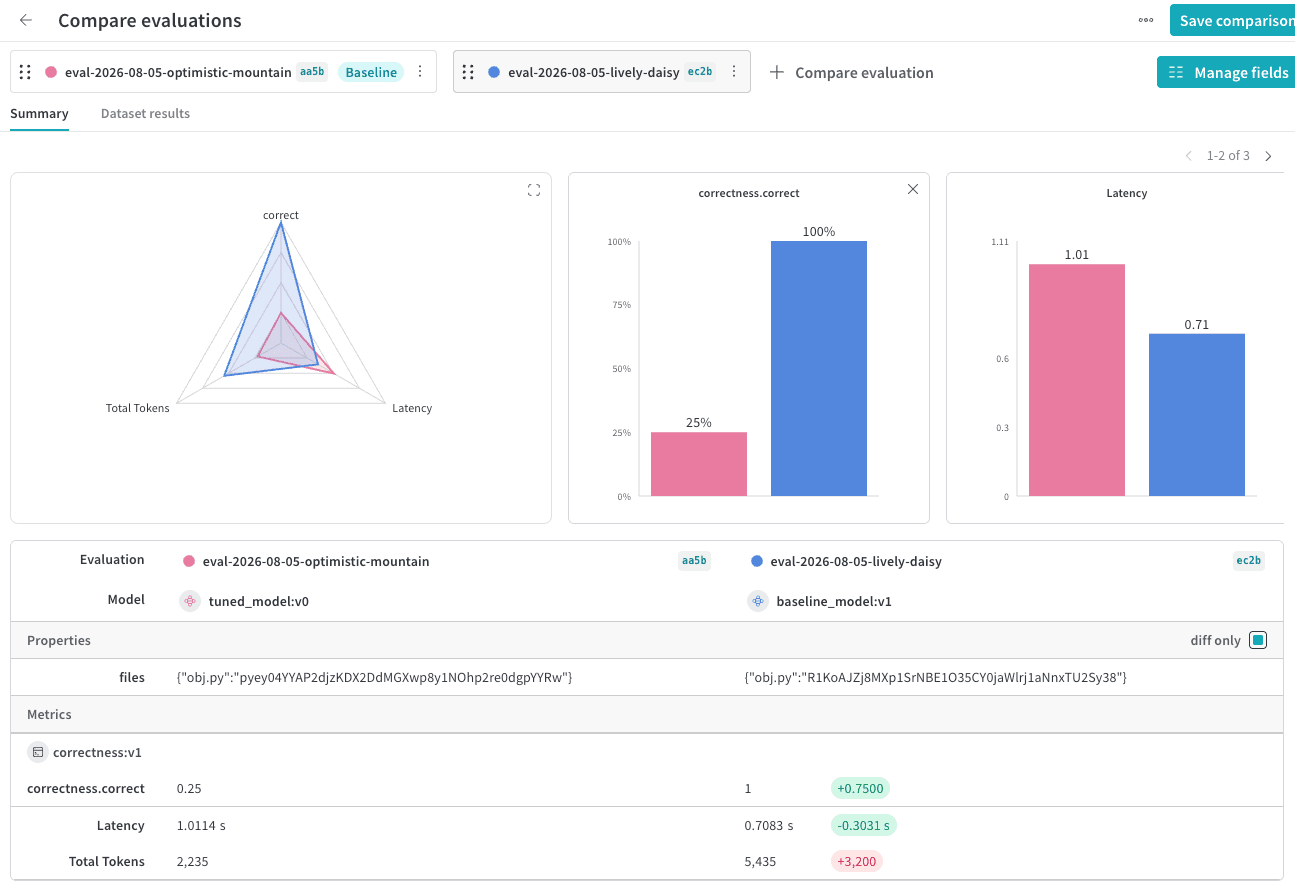
`EvaluationLogger` を使用すると、複数の評価をログし、Weights & Biases UI で並べて比較できます。同じデータセットに対する複数のモデルの性能を比較評価したい場合に便利です。
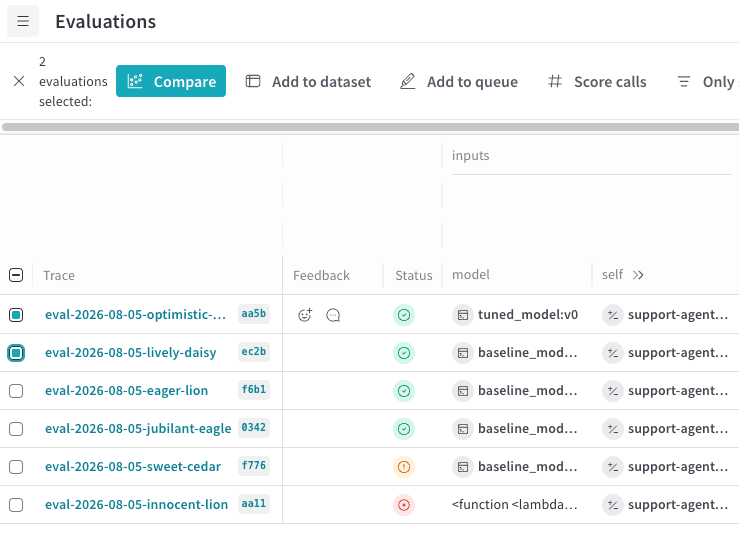
1. 次のコードサンプルを実行します。
2. Weights & Biases UI で **Evals** タブを開きます。
3. 比較する評価を選択します。
4. **Compare** をクリックします。Compare ビューでは、次の操作を行えます。
* 評価を追加または削除する。
* メトリクスの表示と非表示を切り替える。
* 特定のサンプルをページ送りで確認し、データセット内の同じ入力に対して各モデルがどのような結果を出したかを確認する。
比較の詳細については、[Comparisons](/ja/products/wandb/weave/guides/tools/comparison) を参照してください。
```python lines theme={"system"}
import weave
models = [
"model1",
"model2",
{"name": "model3", "metadata": {"coolness": 9001}}
]
for model in models:
# トークンを取得するには、モデルの Call より前に EvalLogger を初期化する必要があります
ev = EvaluationLogger(
name="comparison-eval",
model=model,
dataset="example_dataset",
scorers=["greater_than_3_scorer", "greater_than_5_scorer", "greater_than_7_scorer"],
eval_attributes={"experiment_id": "exp_123"}
)
for inputs in your_dataset:
output = your_output_generator(**inputs)
prediction = ev.log_prediction(inputs=inputs, output=output)
prediction.log_score(scorer="greater_than_3_scorer", score=output > 3)
prediction.log_score(scorer="greater_than_5_scorer", score=output > 5)
prediction.log_score(scorer="greater_than_7_scorer", score=output > 7)
prediction.finish()
ev.log_summary()
```
```typescript twoslash lines theme={"system"}
// @noErrors
import weave from 'weave';
import {EvaluationLogger} from 'weave/evaluationLogger';
import {WeaveObject} from 'weave/weaveObject';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
const models = [
'model1',
'model2',
new WeaveObject({name: 'model3', metadata: {coolness: 9001}})
];
for (const model of models) {
// トークンを取得するには、モデルの Call より前に EvalLogger を初期化する必要があります
const ev = new EvaluationLogger({
name: 'comparison-eval',
model: model,
dataset: 'example_dataset',
description: 'Model comparison evaluation',
scorers: ['greater_than_3_scorer', 'greater_than_5_scorer', 'greater_than_7_scorer'],
attributes: {experiment_id: 'exp_123'}
});
for (const inputs of yourDataset) {
const output = await yourOutputGenerator(inputs);
// ファイア・アンド・フォーゲットパターンで簡潔かつ効率的にログします
const prediction = ev.logPrediction(inputs, output);
prediction.logScore('greater_than_3_scorer', output > 3);
prediction.logScore('greater_than_5_scorer', output > 5);
prediction.logScore('greater_than_7_scorer', output > 7);
prediction.finish();
}
await ev.logSummary();
}
```
使用上のヒント
以下のヒントを参考にすると、`EvaluationLogger` を最大限に活用できます。
* 各予測が完了したら、すぐに `finish()` を呼び出してください。
* 個々の予測に紐づかないメトリクス (例: 全体のレイテンシー) を取得するには、`log_summary` を使用します。
* リッチメディアのログ記録は、定性的な分析に役立ちます。
* **自動終了の動作**: 処理を明確にするため、各予測で明示的に `finish()` を呼び出してください。`logSummary()` は、未終了の予測をすべて自動的に終了します。ただし、`finish()` を呼び出した後は、その予測にスコアを追加でログすることはできません。
* **設定オプション**: `name`、`description`、`dataset`、`model`、`scorers`、`attributes` などの設定オプションを使用すると、Weights & Biases UI で評価を整理したり、フィルターしたりできます。
## Related topics
- [表をログする](/ja/products/wandb/track/log/log-tables.md)