> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# コード生成
> W&B Weave を使用してコード生成パイプラインを構築・評価し、プロンプト、出力、品質メトリクスをトレースします。
これはインタラクティブなノートブックです。ローカルで実行するか、以下のリンクを使用してください。
* [Google Colab で開く](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/codegen.ipynb)
* [GitHub でソースを表示](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/codegen.ipynb)
適切な構造、ドキュメント、テストを備えた高品質なコードを生成するのは難しいタスクです。このガイドは、LLM を活用したコード生成ワークフローを構築し、その品質を体系的に測定したい開発者を対象としています。このノートブックでは、Python 関数を生成し、HumanEval テストスイートで評価するコード生成パイプラインの作成方法を紹介します。このパイプラインでは、評価の比較とトラッキングに Weave を、構造化出力を用いたコード生成に OpenAI の GPT モデルを使用します。
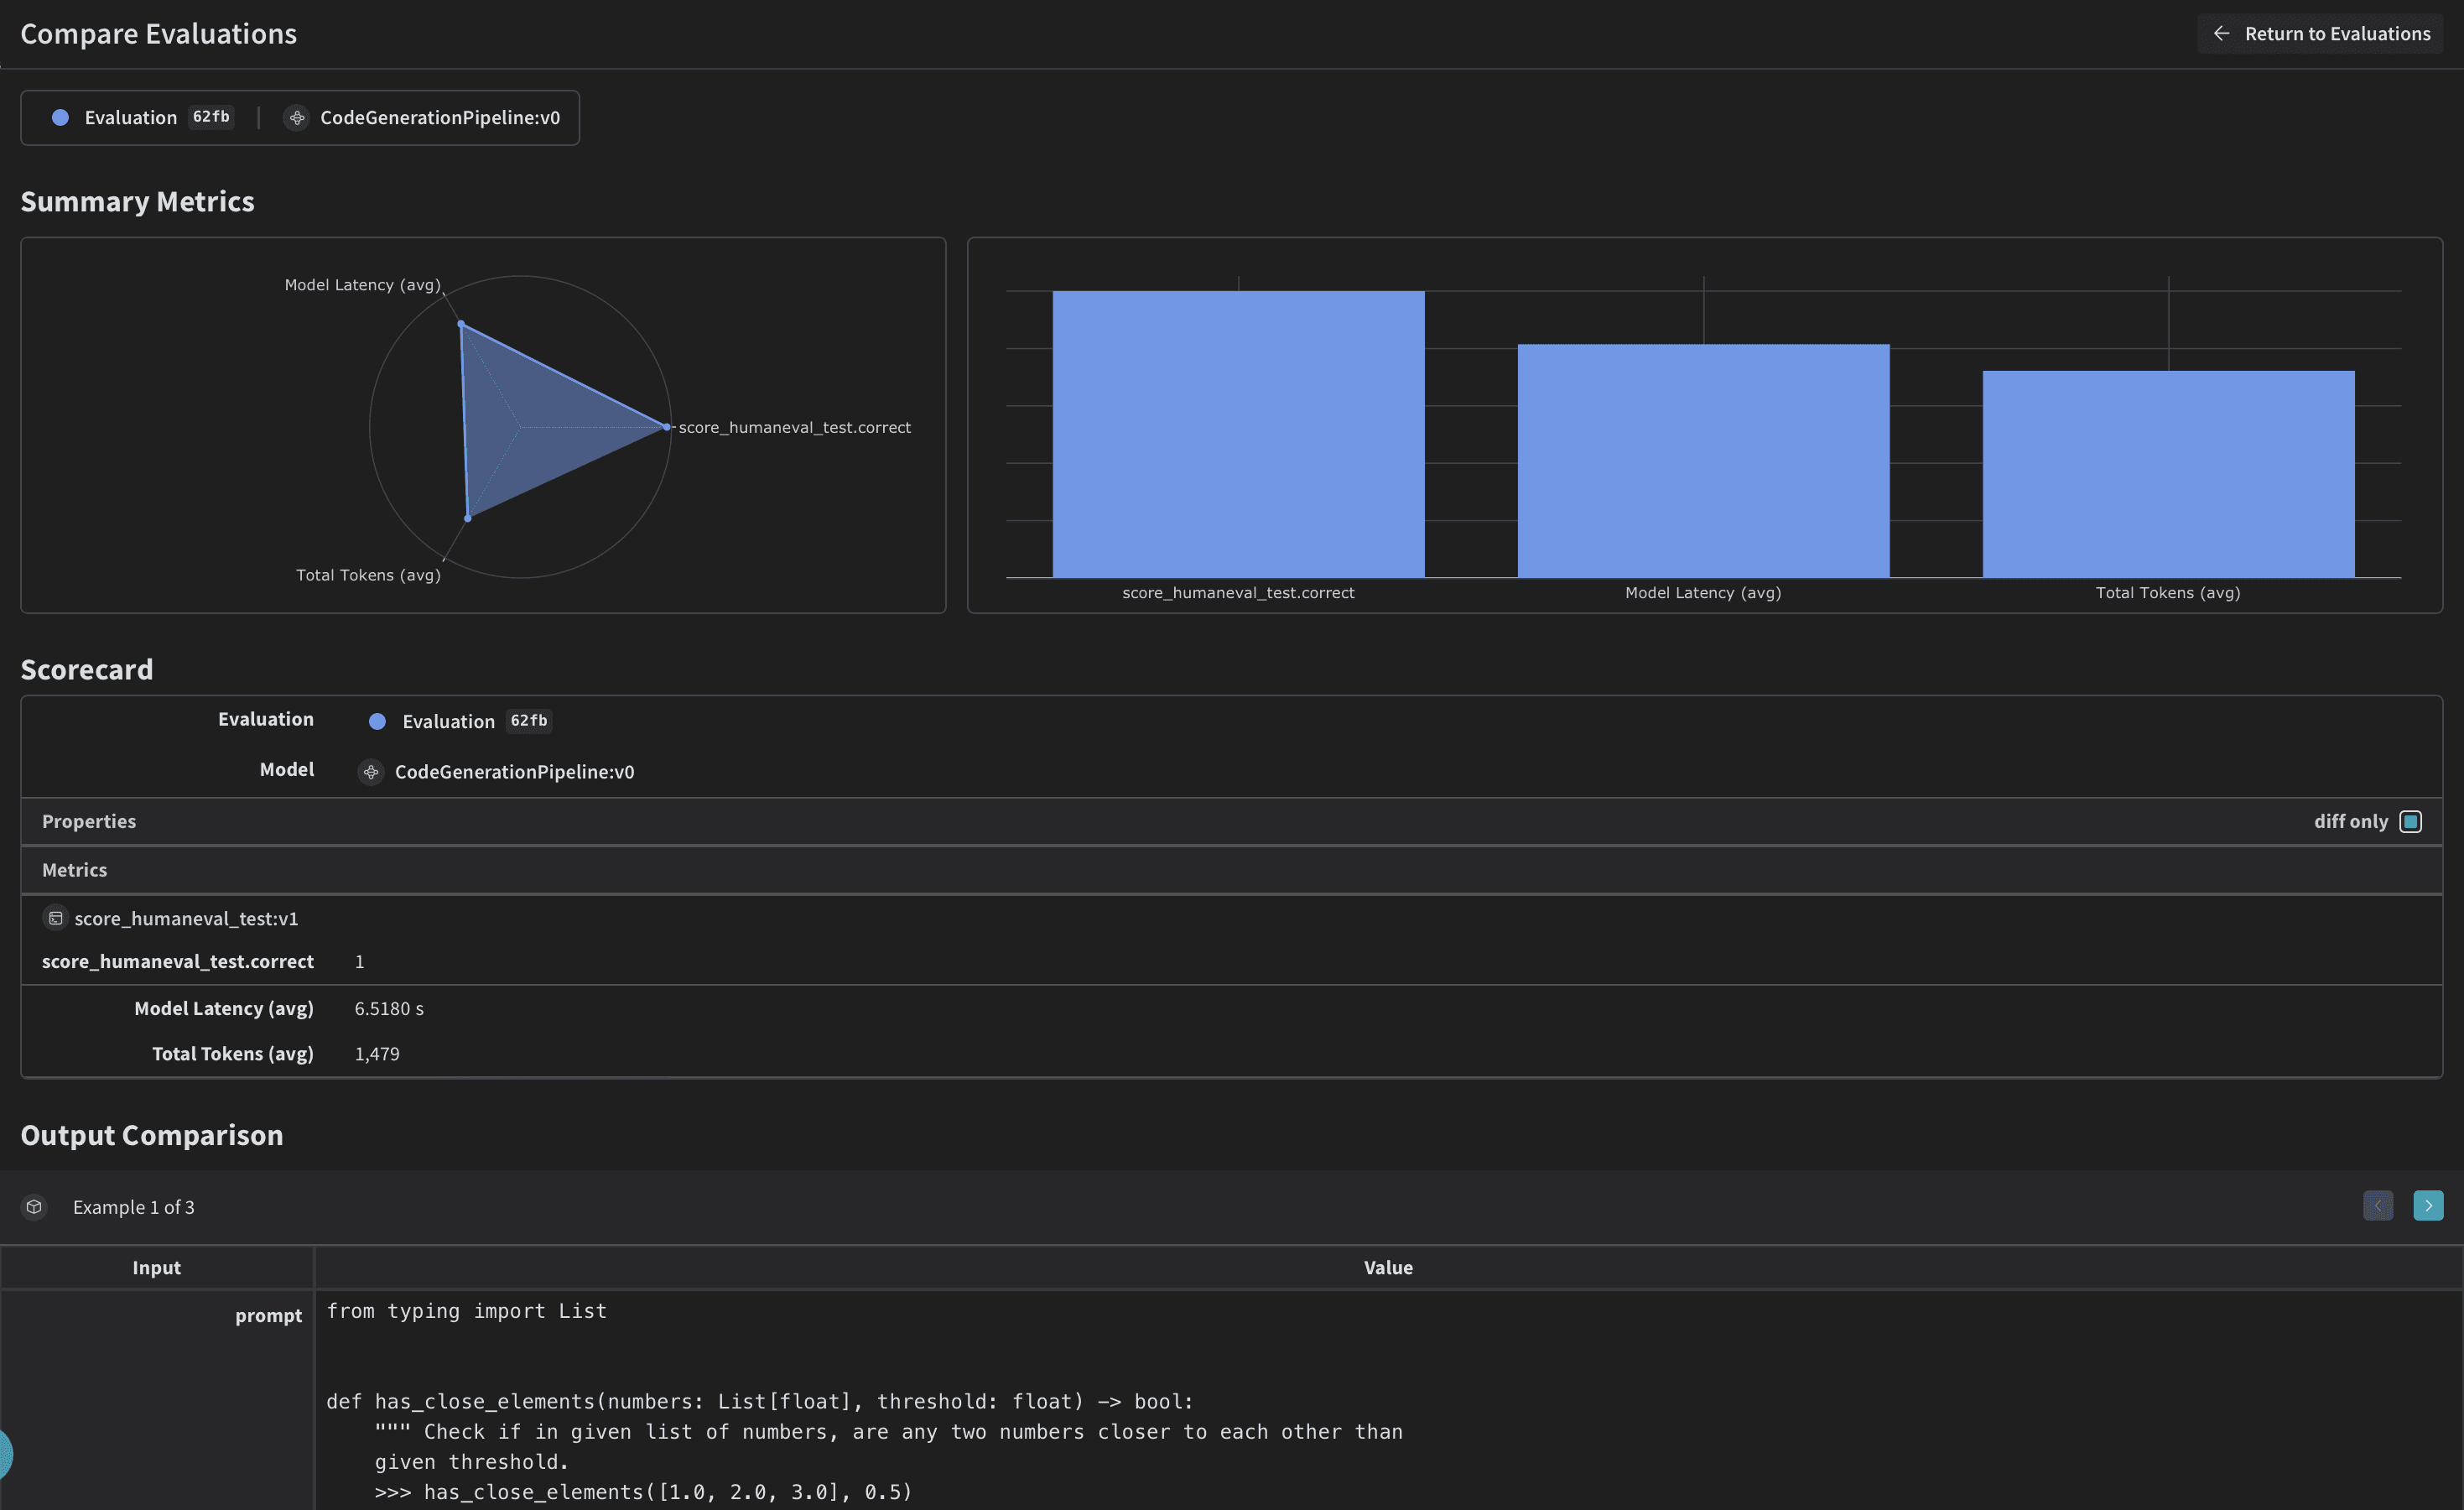
Weave を使用する理由
このチュートリアルでは、Weave を使用してコード生成パイプラインを実装し、評価します。このチュートリアルで学ぶ内容は次のとおりです。
* **LLM パイプラインをトラッキングする**: コード生成プロセスの入力、出力、中間ステップをログします。
* **LLM の出力を評価する**: デバッグツールと可視化機能を使用して、生成されたコードの評価を作成し、比較します。
環境を設定する
環境を設定し、必要なライブラリをインポートします。これらの依存関係には、パイプライン全体で使用するフォーマット用ツール、データセットローダー、OpenAI クライアント、Weave クライアントが含まれます。
```python lines theme={"system"}
!pip install -qU autopep8 autoflake weave isort openai set-env-colab-kaggle-dotenv datasets
python
%%capture
# openai のバグに対する一時的な回避策:
# TypeError: Client.__init__() got an unexpected keyword argument 'proxies'
# 詳細: https://community.openai.com/t/error-with-openai-1-56-0-client-init-got-an-unexpected-keyword-argument-proxies/1040332/15
!pip install "httpx<0.28"
python
import ast
import os
import re
import subprocess
import tempfile
import traceback
import autopep8
import isort
from autoflake import fix_code
from datasets import load_dataset
from openai import OpenAI
from pydantic import BaseModel
from set_env import set_env
import weave
from weave import Dataset, Evaluation
set_env("WANDB_API_KEY")
set_env("OPENAI_API_KEY")
python
WEAVE_PROJECT = "codegen-cookbook-example"
weave.init(WEAVE_PROJECT)
python
client = OpenAI()
python
human_eval = load_dataset("openai_humaneval")
selected_examples = human_eval["test"][:3]
```
Weave は OpenAI API の呼び出しを、入力、出力、メタデータを含めて自動的にトラッキングします。OpenAI とのやり取りをログするためのコードを別途追加する必要はありません。Weave がバックグラウンドで処理します。
構造化出力と Pydantic モデル
このコード生成パイプラインでは、OpenAI の [構造化出力モード](https://platform.openai.com/docs/guides/structured-outputs) と Pydantic モデルを使用して、一貫性があり適切な形式の応答を言語モデルから生成します。このアプローチには、次のような利点があります。
* **型安全性**: 期待される出力を Pydantic モデルとして定義することで、生成されるコード、プログラムランナー、ユニットテストに厳密な構造を適用できます。
* **パースの容易さ**: 構造化出力モードでは、モデルの応答が事前定義された Pydantic モデルに直接パースされるため、複雑な後処理がほとんど不要になります。
* **信頼性の向上**: 期待する形式を厳密に指定することで、言語モデルが予期しない出力や不正な形式の出力を返す可能性を抑えられます。
次の例では、Pydantic モデルを定義し、OpenAI の構造化出力で使用します。
```python lines theme={"system"}
class GeneratedCode(BaseModel):
function_signature: str
function_args_with_docstring_within_triple_quotes: str
code_logic: str
class FormattedGeneratedCode(BaseModel):
full_code: str
```
一貫性のある整ったコードを出力するために、Weave のオペレーションを使用して `CodeFormatter` クラスを実装します。このフォーマッターは、生成されたコード、プログラムランナー、ユニットテストにリンティングとスタイルのルールを適用します。
```python lines theme={"system"}
class CodeFormatter(BaseModel):
@weave.op()
def lint_code(self, code: str) -> str:
# エスケープされた改行を実際の改行に置換
code = code.replace("\\n", "\n")
# 未使用のインポートと変数を削除
code = fix_code(
code, remove_all_unused_imports=True, remove_unused_variables=True
)
# インポートを並べ替え
code = isort.code(code)
# PEP 8 に準拠したフォーマットを適用
code = autopep8.fix_code(code, options={"aggressive": 2})
return code
@weave.op()
def add_imports(self, code: str) -> str:
tree = ast.parse(code)
from_imports = {}
global_names = set()
for node in ast.walk(tree):
if isinstance(node, ast.Name) and node.id not in dir(__builtins__):
global_names.add(node.id)
# 実際に使用されている typing のインポートのみを追加
typing_imports = global_names.intersection(
{"List", "Dict", "Tuple", "Set", "Optional", "Union"}
)
if typing_imports:
from_imports["typing"] = typing_imports
# 関数内で定義されている名前を除外
function_def = next(
node for node in tree.body if isinstance(node, ast.FunctionDef)
)
local_names = {arg.arg for arg in function_def.args.args}
local_names.update(
node.id
for node in ast.walk(function_def)
if isinstance(node, ast.Name) and isinstance(node.ctx, ast.Store)
)
global_names -= local_names
global_names -= {"sorted"} # 組み込み関数を除外
# import 文を生成
import_statements = []
for module, names in from_imports.items():
names_str = ", ".join(sorted(names))
import_statements.append(f"from {module} import {names_str}")
return (
"\n".join(import_statements) + ("\n\n" if import_statements else "") + code
)
@weave.op()
def format_generated_code(
self, generated_code: GeneratedCode
) -> FormattedGeneratedCode:
# コードの各部分を結合
full_code = f"{generated_code.function_signature}\n{generated_code.function_args_with_docstring_within_triple_quotes}\n{generated_code.code_logic}"
# インデントを適切に整える
lines = full_code.split("\n")
indented_lines = []
for i, line in enumerate(lines):
if i == 0: # 関数シグネチャ
indented_lines.append(line)
elif i == 1: # 関数の引数(docstring)
indented_lines.append(" " + line)
else: # 関数本体
indented_lines.append(" " + line)
full_code = "\n".join(indented_lines)
# コードに lint を実行
full_code = self.lint_code(full_code)
# インポートを追加
cleaned_code = self.add_imports(full_code)
return FormattedGeneratedCode(full_code=cleaned_code)
```
この `CodeFormatter` クラスは、生成されたコードをクリーンアップして整形するための複数の Weave オペレーションを提供します。
* エスケープされた改行文字を実際の改行に置き換える
* 未使用のインポートと変数を削除する
* インポートを並べ替える
* PEP 8 に準拠した整形を適用する
* 不足しているインポートを追加する
`CodeGenerationPipeline` を定義する
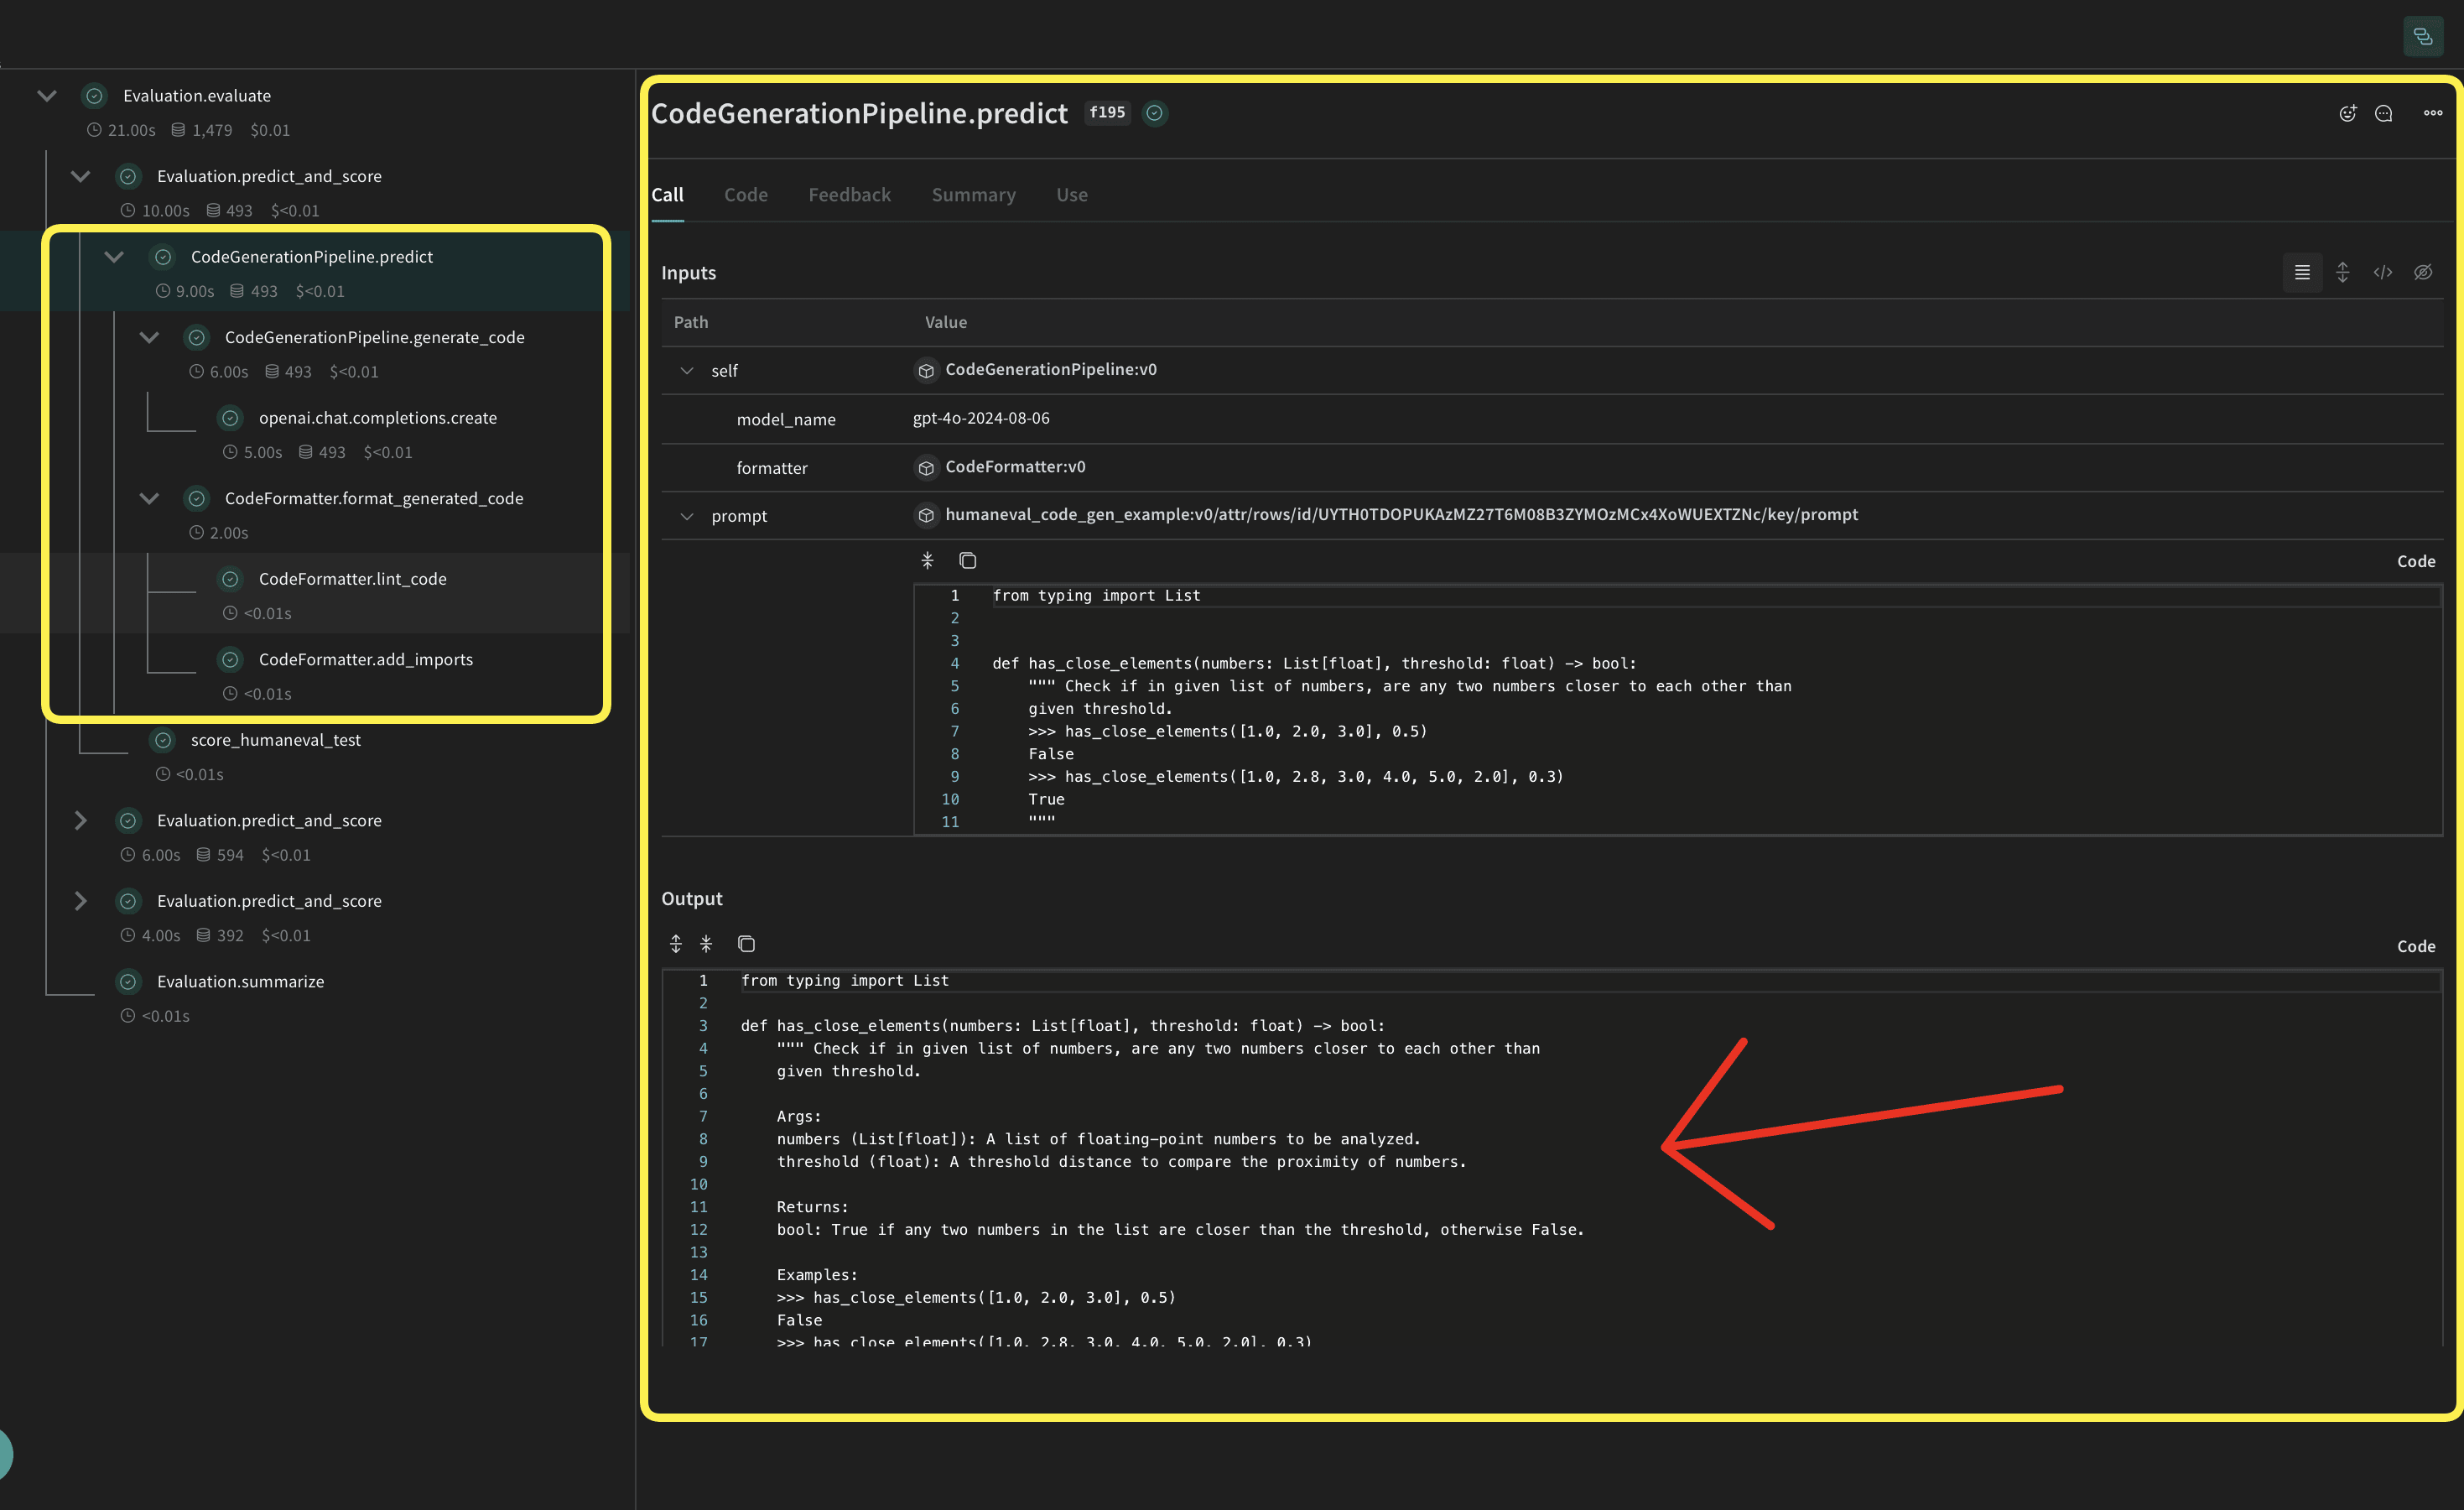 フォーマッターの準備ができたら、次はプロンプト、LLM Call、フォーマッターを結び付ける、コード生成の中核となるロジックを実装します。
この例では `weave.Model` を使用しているため、モデルに変更があると自動的にバージョン管理されます。`model_name` は属性として保持されるため、これを変えて実験し、Weave で差分を確認したり比較したりできます。関数の Call は `@weave.op` で追跡され、入力と出力がログされるため、エラーのトラッキングやデバッグに役立ちます。
```python lines theme={"system"}
class CodeGenerationPipeline(weave.Model):
model_name: str
formatter: CodeFormatter
def __init__(
self, model_name: str = "gpt-4o", formatter: CodeFormatter | None = None
):
if formatter is None:
formatter = CodeFormatter()
super().__init__(model_name=model_name, formatter=formatter)
self.model_name = model_name
self.formatter = formatter
@weave.op()
async def predict(self, prompt: str):
generated_code = self.generate_code(prompt)
formatted_generated_code = self.formatter.format_generated_code(generated_code)
return formatted_generated_code.full_code
@weave.op()
def generate_code(self, prompt: str) -> GeneratedCode:
completion = client.beta.chat.completions.parse(
model=self.model_name,
messages=[
{
"role": "system",
"content": "You are an expert Python code generator.",
},
{"role": "user", "content": prompt},
],
response_format=GeneratedCode,
)
message = completion.choices[0].message
if message.parsed:
return message.parsed
else:
raise ValueError(message.refusal)
```
この `CodeGenerationPipeline` クラスは、コード生成ロジックを Weave モデルとしてカプセル化しており、次のような利点があります。
* 自動的な実験管理: Weave は、モデルの run ごとに入力、出力、パラメーターを取得します。
* バージョン管理: モデルの属性やコードへの変更は自動的にバージョン管理されるため、コード生成パイプラインの変遷を履歴として残せます。
* 再現性: バージョン管理とトラッキングにより、コード生成パイプラインの過去の任意の結果や設定を再現できます。
* ハイパーパラメーター管理: モデルの属性 (`model_name` など) が定義され、異なる run 間で追跡されるため、実験を進めやすくなります。
* Weave エコシステムとのインテグレーション: `weave.Model` を使用すると、パイプラインを評価やサービング機能など、他の Weave ツールと連携できます。
評価メトリクスを実装する
生成されたコードの品質を評価するには、`weave.Scorer` のサブクラスを使って評価メトリクスを実装します。このサブクラスは、データセット内のすべての `model_output` に対して `score` を実行します。`model_output` は `weave.Model` の `predict` 関数の出力です。`prompt` は `human-eval` データセットから取得します。
```python lines theme={"system"}
CODE_TEMPLATE = """
{model_output}
{test}
if __name__ == "__main__":
check({entry_point})
"""
python
@weave.op()
async def score_humaneval_test(test: str, entry_point: str, output: str):
generated_code = output
# test 文字列からテストケースを抽出する
test_cases = re.findall(r"assert.*", test)
test_cases_str = "\n ".join(test_cases)
# ソースコード全体を生成する
full_code = CODE_TEMPLATE.format(
model_output=generated_code,
test=test,
test_cases=test_cases_str,
entry_point=entry_point,
)
# コードを保存するための一時ファイルを作成する
with tempfile.NamedTemporaryFile(delete=False, suffix=".py") as tmp_file:
# 生成されたコードを一時ファイルに書き込む
tmp_file.write(full_code.encode())
tmp_file_path = tmp_file.name
try:
# 一時 Python ファイルをタイムアウト付きのサブプロセスとして実行する
result = subprocess.run(
["python", tmp_file_path],
capture_output=True,
text=True,
timeout=10, # タイムアウトは 10 秒
)
print(result)
if result.returncode == 0:
return {"correct": True}
else:
return {"correct": False, "error": result.stderr, "output": result.stdout}
except subprocess.TimeoutExpired:
return {"correct": False, "error": "TimeoutExpired"}
except Exception as e:
return {"correct": False, "error": traceback.format_exc()}
finally:
# 実行後に一時ファイルを必ず削除する
os.remove(tmp_file_path)
```
これらの評価関数は生成されたコードを実行し、データセットで提供されたテストにそのコードが合格したかどうかを示す真偽値を返します。
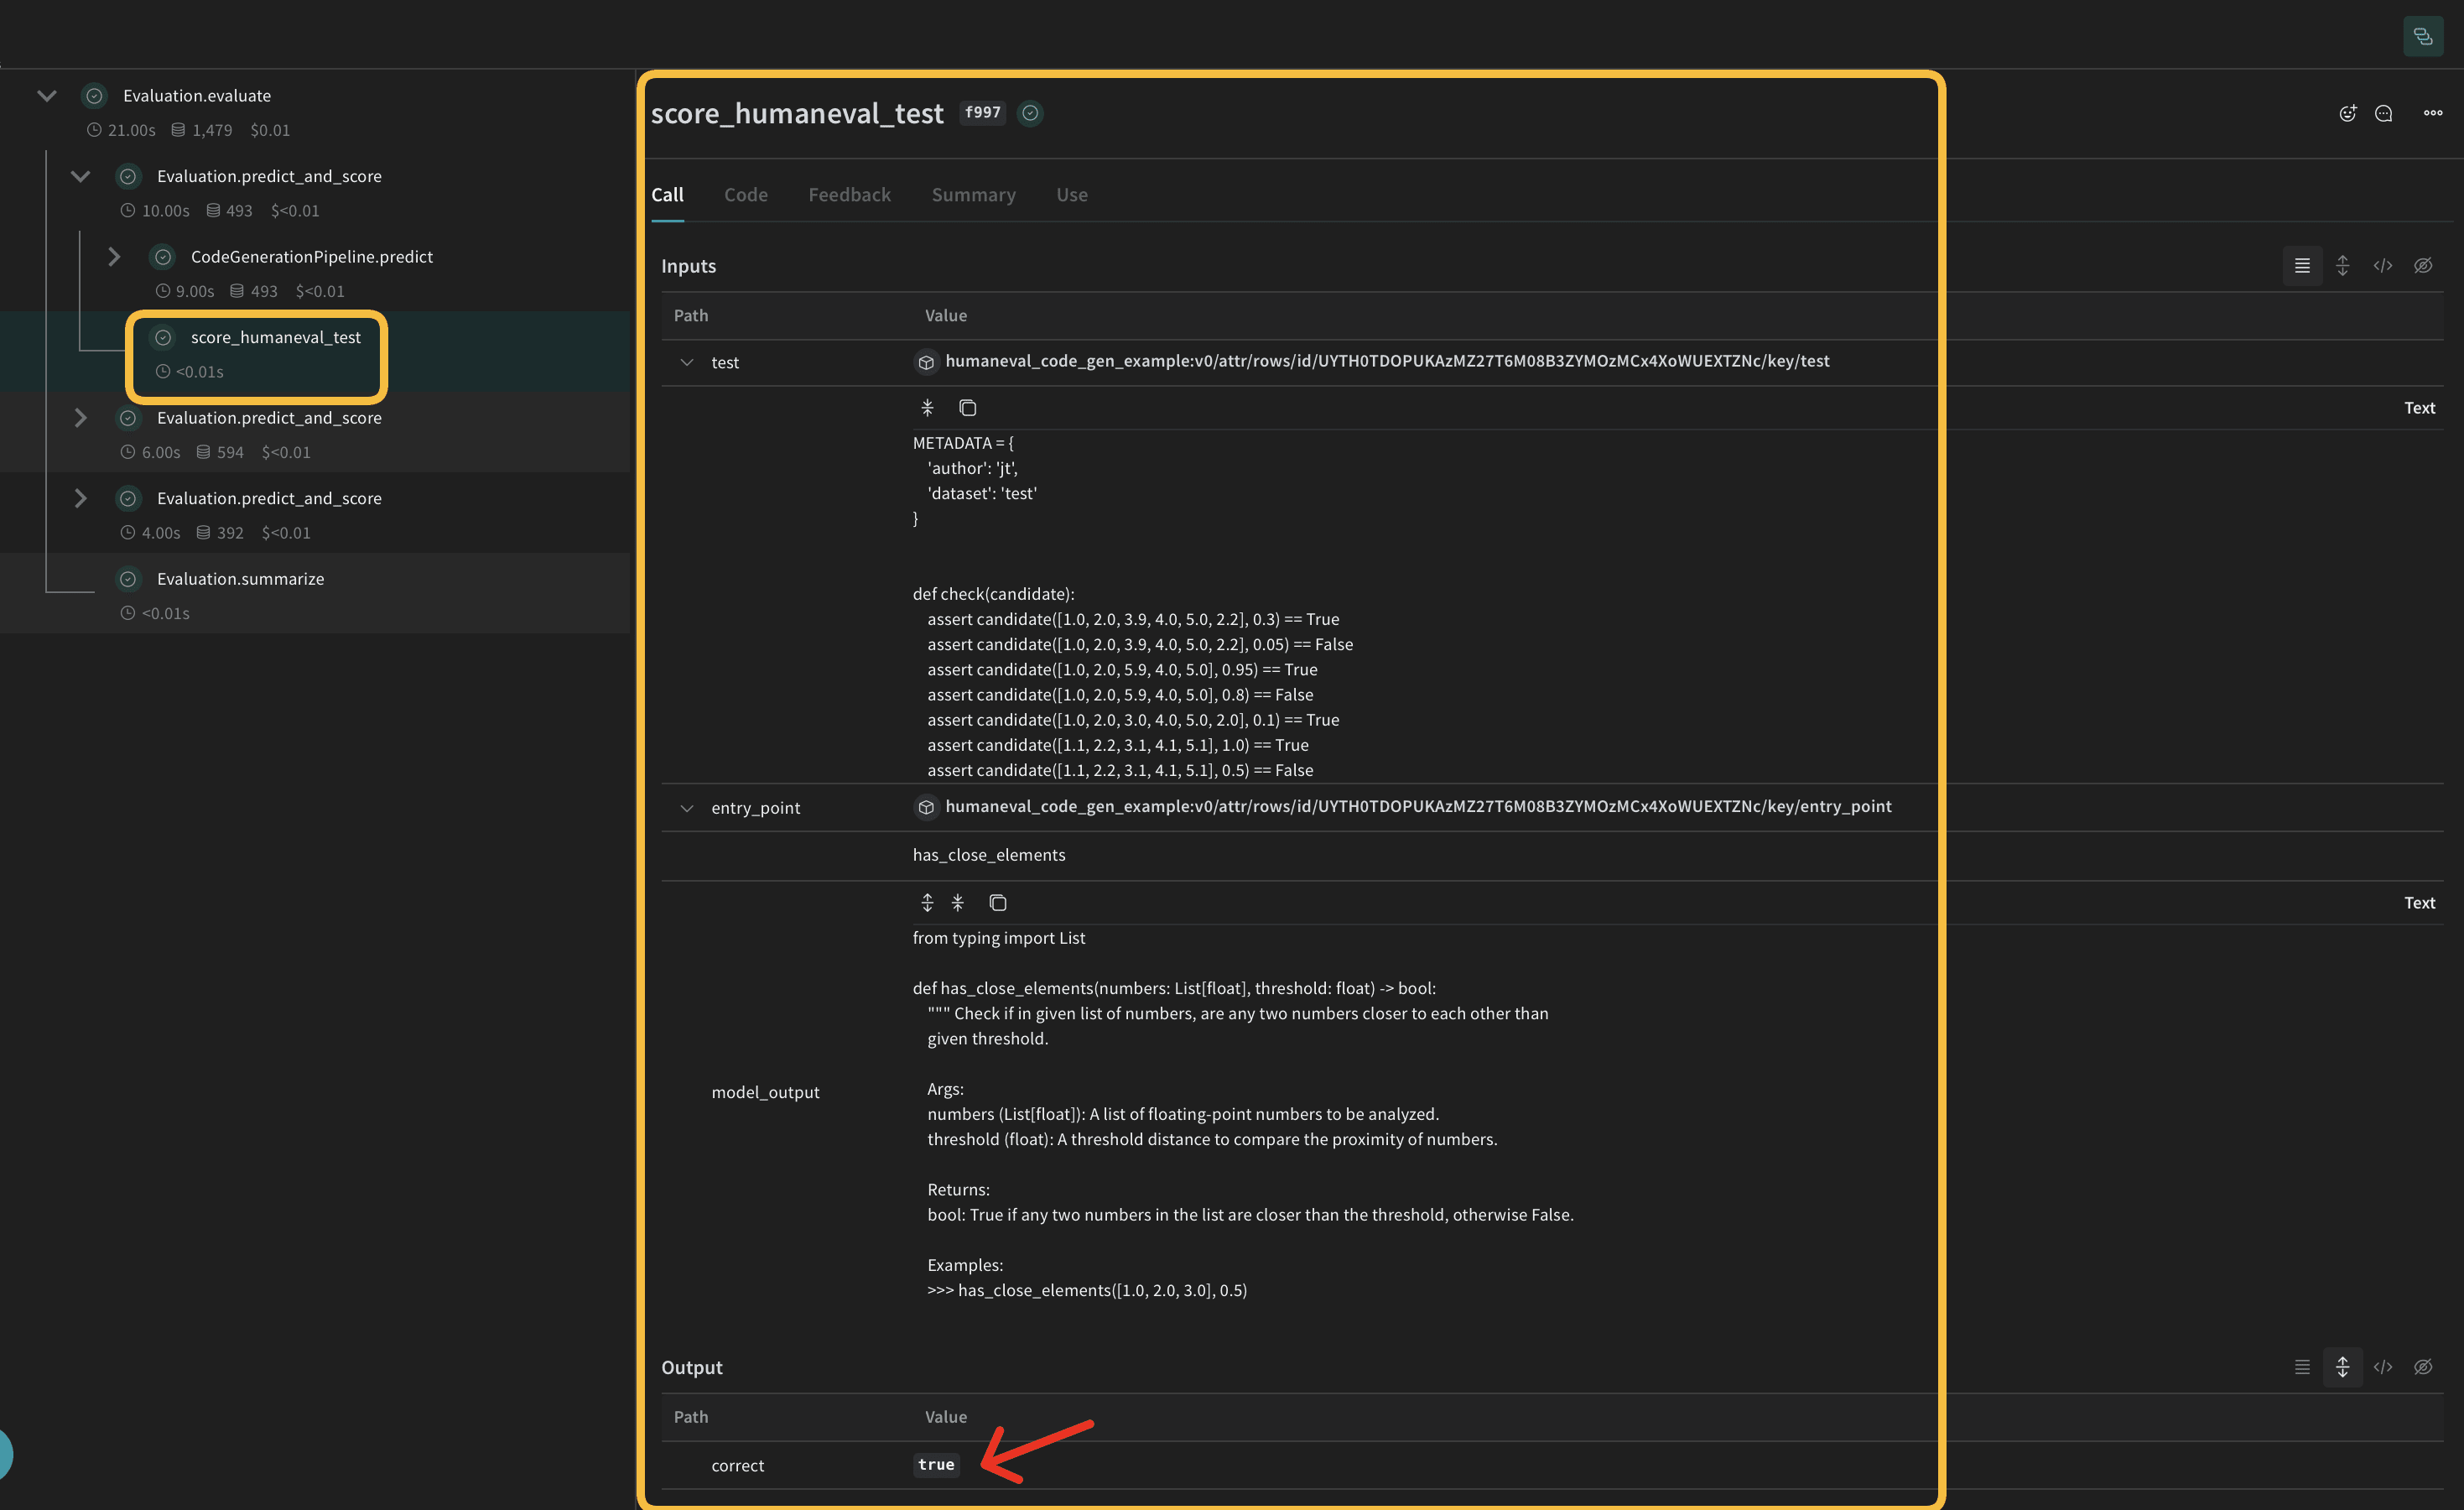
Weave Dataset を作成して評価を実行する
パイプラインと Scorer を定義したら、最後のステップとして評価用データセットを用意し、エンドツーエンドで評価を実行します。パイプラインを評価するには、次のように Weave Dataset を作成して評価を実行します。
```python lines theme={"system"}
formatted_selected_examples = [
{
"task_id": task_id,
"prompt": prompt,
"canonical_solution": solution,
"test": test,
"entry_point": entry_point,
}
for task_id, prompt, solution, test, entry_point in zip(
selected_examples["task_id"],
selected_examples["prompt"],
selected_examples["canonical_solution"],
selected_examples["test"],
selected_examples["entry_point"],
)
]
python
prompt_dataset = Dataset(
name="humaneval_code_gen_example",
rows=[
{
"prompt": example["prompt"],
"test": example["test"],
"entry_point": example["entry_point"],
}
for example in formatted_selected_examples
],
)
weave.publish(prompt_dataset)
python
EVAL_RUN = True
python
for model_name in ["gpt-4o-2024-08-06"]:
pipeline = CodeGenerationPipeline(model_name=model_name)
if not EVAL_RUN:
dataset = prompt_dataset.rows[2]
result = await pipeline.predict(dataset["prompt"])
score_result = await score_humaneval_test(
dataset["test"], dataset["entry_point"], result["generated_code"].full_code
)
else:
evaluation = Evaluation(
name="minimal_code_gen_evaluation",
dataset=prompt_dataset,
scorers=[score_humaneval_test],
)
results = await evaluation.evaluate(pipeline)
```
このコードは、サンプルプロンプトを含むデータセットを作成し、HumanEval のテスト用 Scorer を定義したうえで、コード生成パイプラインの評価を実行します。評価が完了すると、Weights & Biases UI で結果を確認したり、run 間で比較したりできます。
まとめ
この例では、Weave と OpenAI の言語モデルを使用してコード生成パイプラインを実装する方法を紹介しました。ここでは、次の方法を学びました。
* コード生成プロセスの各ステップに対応する Weave のオペレーションを作成する。
* パイプラインを Weave モデルでラップし、トラッキングと評価を効率化する。
* Weave のオペレーションを使用して、カスタムの評価メトリクスを実装する。
* データセットを作成し、パイプラインの評価を実行する。
Weave はコード生成プロセス全体を通じて入力、出力、中間ステップをトラッキングするため、LLM アプリケーションのデバッグ、最適化、評価を容易に行えます。
Weave とその機能の詳細については、[Weave のドキュメント](/ja/products/wandb/weave)を参照してください。この例を拡張すれば、より大規模なデータセットを扱ったり、より高度な評価メトリクスを実装したり、他の LLM ワークフローと統合したりすることもできます。