> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Weave でオーディオを扱う
> W&B Weave のオーディオのログ機能とトレース機能を使用して、LLM アプリケーション内のオーディオデータをトラッキングし、評価します。
これはインタラクティブなノートブックです。ローカルで実行するか、以下のリンクを使用してください。
* [Google Colab で開く](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/audio_with_weave.ipynb)
* [GitHub でソースを表示](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/audio_with_weave.ipynb)
このノートブックでは、Weave を使用して、OpenAI のオーディオ API で生成したオーディオをログし、トレースする方法を紹介します。これにより、プロンプト、オーディオ出力、トランスクリプトを、LLM アプリケーションの他のデータとあわせて確認できます。このノートブックは、OpenAI のオーディオモデルを使ってすでに開発を行っており、オーディオのトレースに可観測性を取り入れたい開発者を対象としています。
ノートブックではまず、OpenAI のチャット補完 API と GPT 4o Audio Preview を使用してテキストプロンプトに対するオーディオ応答を生成し、それらを Weave でトラッキングします。
 高度なユースケースでは、OpenAI Realtime API を使用してオーディオをリアルタイムでストリーミングし、Weave がライブ会話の双方をどのように取得するかを確認します。以下のサムネイルをクリックすると、[動画デモ](https://www.youtube.com/watch?v=lnnd73xDElw)を視聴できます。
[](https://www.youtube.com/watch?v=lnnd73xDElw "Weave Realtime オーディオデモ")
セットアップ
このセクションでは、Python パッケージのインストール、API の認証情報の読み込み、およびチャット補完の例で使用するライブラリのインポートを行います。
まず、OpenAI (`openai`) と Weave (`weave`) の依存関係に加えて、APIキー管理用の依存関係 `set-env` をインストールします。
```python lines theme={"system"}
%%capture
!pip install openai
!pip install weave
!pip install set-env-colab-kaggle-dotenv -q # 環境変数用
python
%%capture
# openai のバグに対する一時的な回避策:
# TypeError: Client.__init__() got an unexpected keyword argument 'proxies'
# 参照: https://community.openai.com/t/error-with-openai-1-56-0-client-init-got-an-unexpected-keyword-argument-proxies/1040332/15
!pip install "httpx<0.28"
```
次に、OpenAI と Weave に必要な APIキーを読み込みます。この例では `set_env` を使用します。`set_env` は Google Colab のシークレットキーマネージャーに対応しており、Colab 固有の `google.colab.userdata` の代わりに使用できます。詳しくは、[`set-env-colab-kaggle-dotenv` の使用方法](https://pypi.org/project/set-env-colab-kaggle-dotenv/)を参照してください。
```python lines theme={"system"}
# 環境変数を設定します。
from set_env import set_env
_ = set_env("OPENAI_API_KEY")
_ = set_env("WANDB_API_KEY")
```
最後に、必要なライブラリをインポートします。
```python lines theme={"system"}
import base64
import os
import time
import wave
import numpy as np
from IPython.display import display
from openai import OpenAI
import weave
```
オーディオのストリーミングと保存の例
依存関係のインストールと認証情報の読み込みが完了したら、オーディオモダリティを有効にして OpenAI の completions エンドポイントへの Call を設定できます。まず、OpenAI クライアントを作成して Weave プロジェクトを初期化します。これにより、以降の Call が Weave によって Workspace にログされます。
```python lines theme={"system"}
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
weave.init("openai-audio-chat")
```
次に、OpenAI の completions リクエストを定義し、Weave デコレーター (op) を追加します。`@weave.op()` デコレーターを付けると、Weave は関数の入力、出力、オーディオファイルをトレースに取得します。
次のコードでは、関数 `prompt_endpoint_and_log_trace` を定義します。この関数の主な処理は次の 3 つのステップです。
1. テキストとオーディオの入出力をサポートする `gpt-4o-audio-preview` モデルを使用して、completion オブジェクトを作成します。
* さまざまなアクセントでゆっくり 13 まで数えるよう、モデルにプロンプトを与えます。
* completion を `stream` に設定します。
2. ストリーミングされたデータをチャンク単位で受け取るため、新しい出力ファイルを開きます。
3. オーディオファイルを開いた状態のファイルハンドラを返し、Weave がオーディオデータをトレースにログできるようにします。
```python lines theme={"system"}
SAMPLE_RATE = 22050
@weave.op()
def prompt_endpoint_and_log_trace(system_prompt=None, user_prompt=None):
if not system_prompt:
system_prompt = "You're the fastest counter in the world"
if not user_prompt:
user_prompt = "Count to 13 super super slow, enunciate each number with a dramatic flair, changing up accents as you go along. British, French, German, Spanish, etc."
# オーディオモダリティを有効にして OpenAI API にリクエストする
completion = client.chat.completions.create(
model="gpt-4o-audio-preview",
modalities=["text", "audio"],
audio={"voice": "fable", "format": "pcm16"},
stream=True,
messages=[
{"role": "system", "content": system_prompt},
{"role": "user", "content": user_prompt},
],
)
# 書き込みモードで wave ファイルを開く
with wave.open("./output.wav", "wb") as wav_file:
wav_file.setnchannels(1) # モノラル
wav_file.setsampwidth(2) # 16 ビット
wav_file.setframerate(SAMPLE_RATE) # サンプリング率(必要に応じて調整)
# API からストリーミングされるチャンクを順次書き込む
for chunk in completion:
if (
hasattr(chunk, "choices")
and chunk.choices is not None
and len(chunk.choices) > 0
and hasattr(chunk.choices[0].delta, "audio")
and chunk.choices[0].delta.audio.get("data") is not None
):
# base64 エンコードされたオーディオデータをデコードする
audio_data = base64.b64decode(chunk.choices[0].delta.audio.get("data"))
# 現在のチャンクを wave ファイルに書き込む
wav_file.writeframes(audio_data)
# ファイルを Weave op に返す
return wave.open("output.wav", "rb")
```
テスト
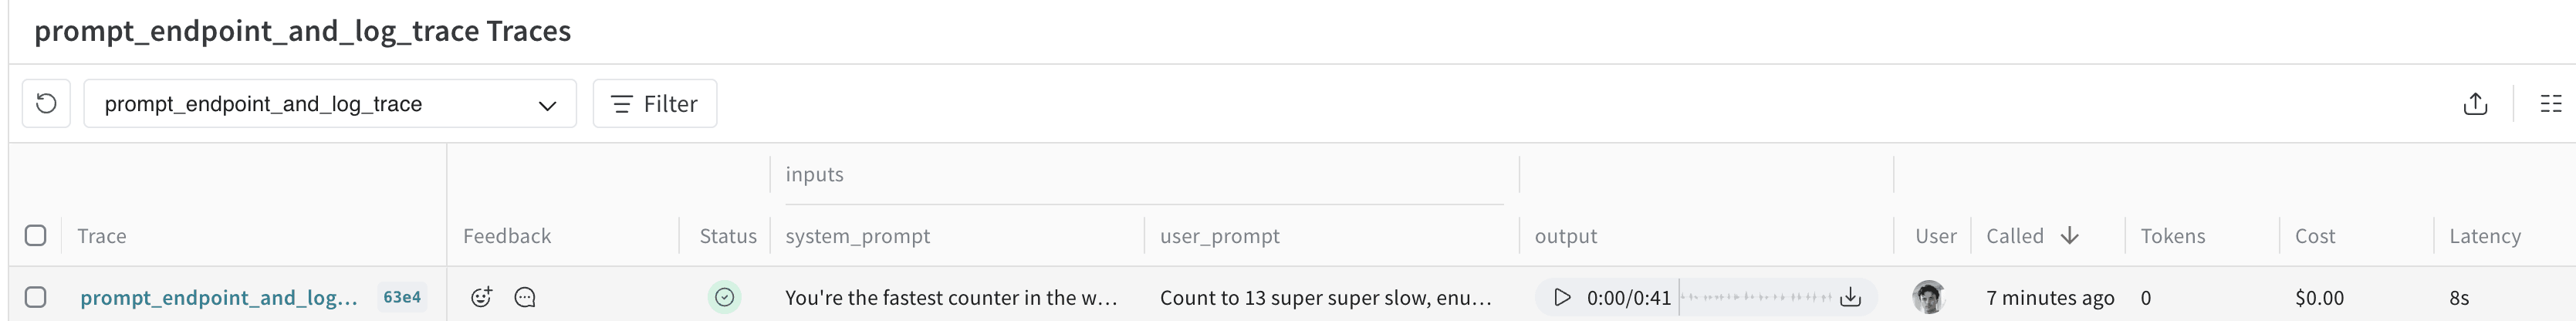
関数を定義したら、次のセルを実行して関数をエンドツーエンドで呼び出し、オーディオが生成されてログされることを確認します。Weave は、システム プロンプトとユーザー プロンプトを出力オーディオとともにトレースに保存します。
セルを実行したら、セルの出力に表示されたトレースのリンクをクリックしてトレースを表示します。これで、Weave でトレースされた チャット補完 のオーディオ Call が完成しました。
```python lines theme={"system"}
from IPython.display import Audio
# 関数を呼び出してオーディオストリームを書き出します
prompt_endpoint_and_log_trace(
system_prompt="You're the fastest counter in the world",
user_prompt="Count to 13 super super slow, enunciate each number with a dramatic flair, changing up accents as you go along. British, French, German, Spanish, etc.",
)
# 更新されたオーディオストリームを表示します
display(Audio("output.wav", rate=SAMPLE_RATE, autoplay=True))
```
高度な使い方: Weave で Realtime API を使用する
このクックブックの残りの部分では、より高度な例として、OpenAI の Realtime API と Weave を組み合わせて、ライブの双方向オーディオ会話をトレースする方法を紹介します。
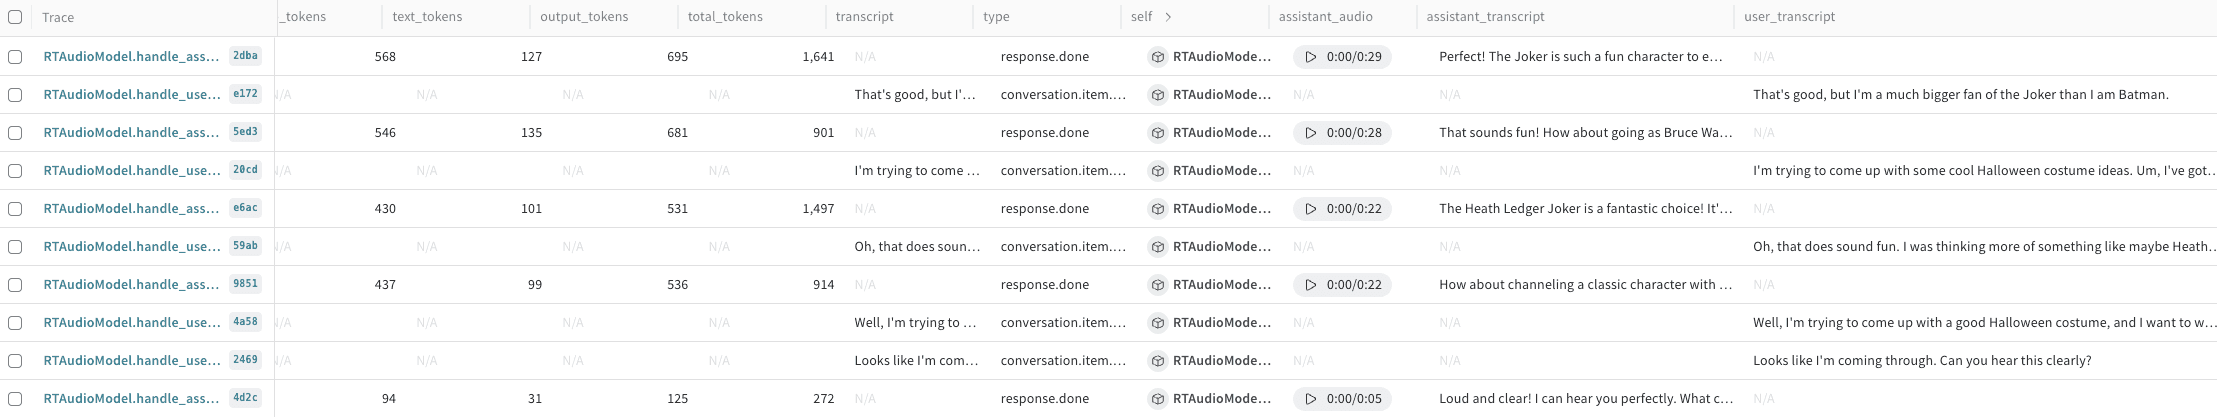 OpenAI の Realtime API は、リアルタイムのオーディオおよびテキストアシスタントを構築するための会話型 API です。
Realtime の例を実行する前に、次の要件を確認してください。
* [マイクの設定](#microphone-configuration) のセルを確認してください。
* Google Colab の実行環境には制限があるため、この例はホストマシン上で Jupyter ノートブックとして実行する必要があります。ブラウザーでは実行できません。
* macOS では、PyAudio を動作させるために [Brew](https://formulae.brew.sh/formula/portaudio) で `portaudio` をインストールする必要があります。
* `enable_audio_playback` トグルを有効にすると、アシスタントが出力したオーディオが再生されます。エコー検出の実装は複雑なため、この設定を有効にする場合はヘッドホンが必須です。
必要なパッケージのセットアップ
Realtime の例では、オーディオ入出力と WebSocket 通信用の追加パッケージが必要です。これらをインストールしてから、環境変数を再読み込みしてください。
```python lines theme={"system"}
%%capture
!pip install numpy==2.0
!pip install weave
!pip install pyaudio # Mac では、事前に `brew install portaudio` で portaudio をインストールしておく必要がある場合があります
!pip install websocket-client
!pip install set-env-colab-kaggle-dotenv -q # 環境変数用
!pip install resampy
python
import io
import json
import os
import threading
from typing import Optional
import pyaudio
import resampy
import websocket
from set_env import set_env
import weave
python
# 環境変数を設定します。
# 使用方法については https://pypi.org/project/set-env-colab-kaggle-dotenv/ を参照してください。
_ = set_env("OPENAI_API_KEY")
_ = set_env("WANDB_API_KEY")
```
マイクの設定
Realtime の例ではマイクで録音し、スピーカーからオーディオを再生するため、使用するデバイスを PyAudio に指定する必要があります。
次のセルを実行して、利用可能なすべてのオーディオデバイスを検索します。次に、表示されたデバイスをもとに `INPUT_DEVICE_INDEX` と `OUTPUT_DEVICE_INDEX` を設定します。入力デバイスには 1 つ以上の入力チャンネルが、出力デバイスには 1 つ以上の出力チャンネルがあります。
```python lines theme={"system"}
# 次のセルで設定できるように、pyaudio からデバイス一覧を取得します
p = pyaudio.PyAudio()
devices_data = {i: p.get_device_info_by_index(i) for i in range(p.get_device_count())}
for i, device in devices_data.items():
print(
f"Found device @{i}: {device['name']} with sample rate: {device['defaultSampleRate']} and input channels: {device['maxInputChannels']} and output channels: {device['maxOutputChannels']}"
)
python
INPUT_DEVICE_INDEX = 3 # @param # 上記のデバイス一覧から選択します。入力チャンネル数が 1 以上のデバイスを選んでください。
OUTPUT_DEVICE_INDEX = 12 # @param # 上記のデバイス一覧から選択します。出力チャンネル数が 1 以上のデバイスを選んでください。
enable_audio_playback = True # @param {type:"boolean"} # アシスタントのオーディオ再生をオンにします。ヘッドホンが必要です。
# オーディオの録音およびストリーミング用のパラメーター
INPUT_DEVICE_CHANNELS = devices_data[INPUT_DEVICE_INDEX][
"maxInputChannels"
] # 上記のデバイス一覧から取得
SAMPLE_RATE = int(
devices_data[INPUT_DEVICE_INDEX]["defaultSampleRate"]
) # 上記のデバイス一覧から取得
CHUNK = int(SAMPLE_RATE / 10) # フレームあたりのサンプル数
SAMPLE_WIDTH = p.get_sample_size(pyaudio.paInt16) # このフォーマットでのフレームあたりのサンプル数
CHUNK_DURATION = 0.3 # OAI API に送信する 1 チャンクあたりのオーディオの長さ(秒)
OAI_SAMPLE_RATE = (
24000 # OAI のサンプリング率は 24kHz です。アシスタントのオーディオの再生や保存に必要です
)
OUTPUT_DEVICE_CHANNELS = 1 # モノラル出力にする場合は 1 に設定します
```
OpenAI Realtime API スキーマの実装
以降のセクションでは、メッセージスキーマ、オーディオライター、Weave でインストルメントされたモデル、レコーダーの順に、Realtime クライアントを段階的に構築していきます。
OpenAI Python SDK は、現時点では Realtime API をサポートしていません。そのため、このサンプルでは可読性を高める目的で、OpenAI Realtime API のスキーマ全体を Pydantic で実装しています。公式サポートが提供された時点で、この実装は非推奨となる可能性があります。
OpenAI Realtime API 用の Pydantic スキーマ
```python lines theme={"system"}
from enum import Enum
from typing import Any, Literal, Union
from pydantic import BaseModel, Field, ValidationError
class BaseEvent(BaseModel):
type: Union["ClientEventTypes", "ServerEventTypes"]
event_id: Optional[str] = None # すべてのイベントに event_id をオプションのフィールドとして追加します
# def model_dump_json(self, *args, **kwargs):
# # None 以外のフィールドのみを含めます
# return super().model_dump_json(*args, exclude_none=True, **kwargs)
class ChatMessage(BaseModel):
role: Literal["user", "assistant"]
content: str
timestamp: float
""" CLIENT EVENTS """
class ClientEventTypes(str, Enum):
SESSION_UPDATE = "session.update"
CONVERSATION_ITEM_CREATE = "conversation.item.create"
CONVERSATION_ITEM_TRUNCATE = "conversation.item.truncate"
CONVERSATION_ITEM_DELETE = "conversation.item.delete"
RESPONSE_CREATE = "response.create"
RESPONSE_CANCEL = "response.cancel"
INPUT_AUDIO_BUFFER_APPEND = "input_audio_buffer.append"
INPUT_AUDIO_BUFFER_COMMIT = "input_audio_buffer.commit"
INPUT_AUDIO_BUFFER_CLEAR = "input_audio_buffer.clear"
ERROR = "error"
#### セッションの更新
class TurnDetection(BaseModel):
type: Literal["server_vad"]
threshold: float = Field(..., ge=0.0, le=1.0)
prefix_padding_ms: int
silence_duration_ms: int
class InputAudioTranscription(BaseModel):
model: Optional[str] = None
class ToolParameterProperty(BaseModel):
type: str
class ToolParameter(BaseModel):
type: str
properties: dict[str, ToolParameterProperty]
required: list[str]
class Tool(BaseModel):
type: Literal["function", "code_interpreter", "file_search"]
name: Optional[str] = None
description: Optional[str] = None
parameters: Optional[ToolParameter] = None
class Session(BaseModel):
modalities: Optional[list[str]] = None
instructions: Optional[str] = None
voice: Optional[str] = None
input_audio_format: Optional[str] = None
output_audio_format: Optional[str] = None
input_audio_transcription: Optional[InputAudioTranscription] = None
turn_detection: Optional[TurnDetection] = None
tools: Optional[list[Tool]] = None
tool_choice: Optional[str] = None
temperature: Optional[float] = None
max_output_tokens: Optional[int] = None
class SessionUpdate(BaseEvent):
type: Literal[ClientEventTypes.SESSION_UPDATE] = ClientEventTypes.SESSION_UPDATE
session: Session
#### オーディオバッファ
class InputAudioBufferAppend(BaseEvent):
type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_APPEND] = (
ClientEventTypes.INPUT_AUDIO_BUFFER_APPEND
)
audio: str
class InputAudioBufferCommit(BaseEvent):
type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_COMMIT] = (
ClientEventTypes.INPUT_AUDIO_BUFFER_COMMIT
)
class InputAudioBufferClear(BaseEvent):
type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_CLEAR] = (
ClientEventTypes.INPUT_AUDIO_BUFFER_CLEAR
)
#### メッセージ
class MessageContent(BaseModel):
type: Literal["input_audio"]
audio: str
class ConversationItemContent(BaseModel):
type: Literal["input_text", "input_audio", "text", "audio"]
text: Optional[str] = None
audio: Optional[str] = None
transcript: Optional[str] = None
class FunctionCallContent(BaseModel):
call_id: str
name: str
arguments: str
class FunctionCallOutputContent(BaseModel):
output: str
class ConversationItem(BaseModel):
id: Optional[str] = None
type: Literal["message", "function_call", "function_call_output"]
status: Optional[Literal["completed", "in_progress", "incomplete"]] = None
role: Literal["user", "assistant", "system"]
content: list[
Union[ConversationItemContent, FunctionCallContent, FunctionCallOutputContent]
]
call_id: Optional[str] = None
name: Optional[str] = None
arguments: Optional[str] = None
output: Optional[str] = None
class ConversationItemCreate(BaseEvent):
type: Literal[ClientEventTypes.CONVERSATION_ITEM_CREATE] = (
ClientEventTypes.CONVERSATION_ITEM_CREATE
)
item: ConversationItem
class ConversationItemTruncate(BaseEvent):
type: Literal[ClientEventTypes.CONVERSATION_ITEM_TRUNCATE] = (
ClientEventTypes.CONVERSATION_ITEM_TRUNCATE
)
item_id: str
content_index: int
audio_end_ms: int
class ConversationItemDelete(BaseEvent):
type: Literal[ClientEventTypes.CONVERSATION_ITEM_DELETE] = (
ClientEventTypes.CONVERSATION_ITEM_DELETE
)
item_id: str
#### 応答
class ResponseCreate(BaseEvent):
type: Literal[ClientEventTypes.RESPONSE_CREATE] = ClientEventTypes.RESPONSE_CREATE
class ResponseCancel(BaseEvent):
type: Literal[ClientEventTypes.RESPONSE_CANCEL] = ClientEventTypes.RESPONSE_CANCEL
# すべてのイベントタイプが含まれるように Event の Union を更新します
ClientEvent = Union[
SessionUpdate,
InputAudioBufferAppend,
InputAudioBufferCommit,
InputAudioBufferClear,
ConversationItemCreate,
ConversationItemTruncate,
ConversationItemDelete,
ResponseCreate,
ResponseCancel,
]
""" SERVER EVENTS """
class ServerEventTypes(str, Enum):
ERROR = "error"
RESPONSE_AUDIO_TRANSCRIPT_DONE = "response.audio_transcript.done"
RESPONSE_AUDIO_TRANSCRIPT_DELTA = "response.audio_transcript.delta"
RESPONSE_AUDIO_DELTA = "response.audio.delta"
SESSION_CREATED = "session.created"
SESSION_UPDATED = "session.updated"
CONVERSATION_CREATED = "conversation.created"
INPUT_AUDIO_BUFFER_COMMITTED = "input_audio_buffer.committed"
INPUT_AUDIO_BUFFER_CLEARED = "input_audio_buffer.cleared"
INPUT_AUDIO_BUFFER_SPEECH_STARTED = "input_audio_buffer.speech_started"
INPUT_AUDIO_BUFFER_SPEECH_STOPPED = "input_audio_buffer.speech_stopped"
CONVERSATION_ITEM_CREATED = "conversation.item.created"
CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED = (
"conversation.item.input_audio_transcription.completed"
)
CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED = (
"conversation.item.input_audio_transcription.failed"
)
CONVERSATION_ITEM_TRUNCATED = "conversation.item.truncated"
CONVERSATION_ITEM_DELETED = "conversation.item.deleted"
RESPONSE_CREATED = "response.created"
RESPONSE_DONE = "response.done"
RESPONSE_OUTPUT_ITEM_ADDED = "response.output_item.added"
RESPONSE_OUTPUT_ITEM_DONE = "response.output_item.done"
RESPONSE_CONTENT_PART_ADDED = "response.content_part.added"
RESPONSE_CONTENT_PART_DONE = "response.content_part.done"
RESPONSE_TEXT_DELTA = "response.text.delta"
RESPONSE_TEXT_DONE = "response.text.done"
RESPONSE_AUDIO_DONE = "response.audio.done"
RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA = "response.function_call_arguments.delta"
RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE = "response.function_call_arguments.done"
RATE_LIMITS_UPDATED = "rate_limits.updated"
#### エラー
class ErrorDetails(BaseModel):
type: Optional[str] = None
code: Optional[str] = None
message: Optional[str] = None
param: Optional[str] = None
class ErrorEvent(BaseEvent):
type: Literal[ServerEventTypes.ERROR] = ServerEventTypes.ERROR
error: ErrorDetails
#### セッション
class SessionCreated(BaseEvent):
type: Literal[ServerEventTypes.SESSION_CREATED] = ServerEventTypes.SESSION_CREATED
session: Session
class SessionUpdated(BaseEvent):
type: Literal[ServerEventTypes.SESSION_UPDATED] = ServerEventTypes.SESSION_UPDATED
session: Session
#### 会話
class Conversation(BaseModel):
id: str
object: Literal["realtime.conversation"]
class ConversationCreated(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_CREATED] = (
ServerEventTypes.CONVERSATION_CREATED
)
conversation: Conversation
class ConversationItemCreated(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_ITEM_CREATED] = (
ServerEventTypes.CONVERSATION_ITEM_CREATED
)
previous_item_id: Optional[str] = None
item: ConversationItem
class ConversationItemInputAudioTranscriptionCompleted(BaseEvent):
type: Literal[
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
] = ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
item_id: str
content_index: int
transcript: str
class ConversationItemInputAudioTranscriptionFailed(BaseEvent):
type: Literal[
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED
] = ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED
item_id: str
content_index: int
error: dict[str, Any]
class ConversationItemTruncated(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_ITEM_TRUNCATED] = (
ServerEventTypes.CONVERSATION_ITEM_TRUNCATED
)
item_id: str
content_index: int
audio_end_ms: int
class ConversationItemDeleted(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_ITEM_DELETED] = (
ServerEventTypes.CONVERSATION_ITEM_DELETED
)
item_id: str
#### 応答
class ResponseUsage(BaseModel):
total_tokens: int
input_tokens: int
output_tokens: int
input_token_details: Optional[dict[str, int]] = None
output_token_details: Optional[dict[str, int]] = None
class ResponseOutput(BaseModel):
id: str
object: Literal["realtime.item"]
type: str
status: str
role: str
content: list[dict[str, Any]]
class ResponseContentPart(BaseModel):
type: str
text: Optional[str] = None
class ResponseOutputItemContent(BaseModel):
type: str
text: Optional[str] = None
class ResponseStatusDetails(BaseModel):
type: str
reason: str
class ResponseOutputItem(BaseModel):
id: str
object: Literal["realtime.item"]
type: str
status: str
role: str
content: list[ResponseOutputItemContent]
class Response(BaseModel):
id: str
object: Literal["realtime.response"]
status: str
status_details: Optional[ResponseStatusDetails] = None
output: list[ResponseOutput]
usage: Optional[ResponseUsage]
class ResponseCreated(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_CREATED] = ServerEventTypes.RESPONSE_CREATED
response: Response
class ResponseDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_DONE] = ServerEventTypes.RESPONSE_DONE
response: Response
class ResponseOutputItemAdded(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED] = (
ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED
)
response_id: str
output_index: int
item: ResponseOutputItem
class ResponseOutputItemDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE] = (
ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE
)
response_id: str
output_index: int
item: ResponseOutputItem
class ResponseContentPartAdded(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_CONTENT_PART_ADDED] = (
ServerEventTypes.RESPONSE_CONTENT_PART_ADDED
)
response_id: str
item_id: str
output_index: int
content_index: int
part: ResponseContentPart
class ResponseContentPartDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_CONTENT_PART_DONE] = (
ServerEventTypes.RESPONSE_CONTENT_PART_DONE
)
response_id: str
item_id: str
output_index: int
content_index: int
part: ResponseContentPart
#### 応答テキスト
class ResponseTextDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_TEXT_DELTA] = (
ServerEventTypes.RESPONSE_TEXT_DELTA
)
response_id: str
item_id: str
output_index: int
content_index: int
delta: str
class ResponseTextDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_TEXT_DONE] = (
ServerEventTypes.RESPONSE_TEXT_DONE
)
response_id: str
item_id: str
output_index: int
content_index: int
text: str
#### 応答オーディオ
class ResponseAudioTranscriptDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE] = (
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE
)
transcript: str
class ResponseAudioTranscriptDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA] = (
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA
)
delta: str
class ResponseAudioDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_DELTA] = (
ServerEventTypes.RESPONSE_AUDIO_DELTA
)
response_id: str
item_id: str
delta: str
class ResponseAudioDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_DONE] = (
ServerEventTypes.RESPONSE_AUDIO_DONE
)
response_id: str
item_id: str
output_index: int
content_index: int
class InputAudioBufferCommitted(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED
)
previous_item_id: Optional[str] = None
item_id: Optional[str] = None
event_id: Optional[str] = None
class InputAudioBufferCleared(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED
)
class InputAudioBufferSpeechStarted(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED
)
audio_start_ms: int
item_id: str
class InputAudioBufferSpeechStopped(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED
)
audio_end_ms: int
item_id: str
#### 関数の Call
class ResponseFunctionCallArgumentsDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA] = (
ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA
)
response_id: str
item_id: str
output_index: int
call_id: str
delta: str
class ResponseFunctionCallArgumentsDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE] = (
ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE
)
response_id: str
item_id: str
output_index: int
call_id: str
arguments: str
#### レート制限
class RateLimit(BaseModel):
name: str
limit: int
remaining: int
reset_seconds: float
class RateLimitsUpdated(BaseEvent):
type: Literal[ServerEventTypes.RATE_LIMITS_UPDATED] = (
ServerEventTypes.RATE_LIMITS_UPDATED
)
rate_limits: list[RateLimit]
ServerEvent = Union[
ErrorEvent,
ConversationCreated,
ResponseAudioTranscriptDone,
ResponseAudioTranscriptDelta,
ResponseAudioDelta,
ResponseCreated,
ResponseDone,
ResponseOutputItemAdded,
ResponseOutputItemDone,
ResponseContentPartAdded,
ResponseContentPartDone,
ResponseTextDelta,
ResponseTextDone,
ResponseAudioDone,
ConversationItemInputAudioTranscriptionCompleted,
SessionCreated,
SessionUpdated,
InputAudioBufferCleared,
InputAudioBufferSpeechStarted,
InputAudioBufferSpeechStopped,
ConversationItemCreated,
ConversationItemInputAudioTranscriptionFailed,
ConversationItemTruncated,
ConversationItemDeleted,
RateLimitsUpdated,
]
EVENT_TYPE_TO_MODEL = {
ServerEventTypes.ERROR: ErrorEvent,
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE: ResponseAudioTranscriptDone,
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA: ResponseAudioTranscriptDelta,
ServerEventTypes.RESPONSE_AUDIO_DELTA: ResponseAudioDelta,
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED: ConversationItemInputAudioTranscriptionCompleted,
ServerEventTypes.SESSION_CREATED: SessionCreated,
ServerEventTypes.SESSION_UPDATED: SessionUpdated,
ServerEventTypes.CONVERSATION_CREATED: ConversationCreated,
ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED: InputAudioBufferCommitted,
ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED: InputAudioBufferCleared,
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED: InputAudioBufferSpeechStarted,
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED: InputAudioBufferSpeechStopped,
ServerEventTypes.CONVERSATION_ITEM_CREATED: ConversationItemCreated,
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED: ConversationItemInputAudioTranscriptionFailed,
ServerEventTypes.CONVERSATION_ITEM_TRUNCATED: ConversationItemTruncated,
ServerEventTypes.CONVERSATION_ITEM_DELETED: ConversationItemDeleted,
ServerEventTypes.RESPONSE_CREATED: ResponseCreated,
ServerEventTypes.RESPONSE_DONE: ResponseDone,
ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED: ResponseOutputItemAdded,
ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE: ResponseOutputItemDone,
ServerEventTypes.RESPONSE_CONTENT_PART_ADDED: ResponseContentPartAdded,
ServerEventTypes.RESPONSE_CONTENT_PART_DONE: ResponseContentPartDone,
ServerEventTypes.RESPONSE_TEXT_DELTA: ResponseTextDelta,
ServerEventTypes.RESPONSE_TEXT_DONE: ResponseTextDone,
ServerEventTypes.RESPONSE_AUDIO_DONE: ResponseAudioDone,
ServerEventTypes.RATE_LIMITS_UPDATED: RateLimitsUpdated,
}
def parse_server_event(event_data: dict) -> ServerEvent:
event_type = event_data.get("type")
if not event_type:
raise ValueError("Event data is missing 'type' field")
model_class = EVENT_TYPE_TO_MODEL.get(event_type)
if not model_class:
raise ValueError(f"Unknown event type: {event_type}")
try:
return model_class(**event_data)
except ValidationError as e:
raise ValueError(f"Failed to parse event of type {event_type}: {str(e)}") from e
```
オーディオストリームライター (ディスクへの書き込みとインメモリ)
次のヘルパークラスは、ストリーミングされたオーディオのチャンクを WAV ファイル (またはインメモリバッファ) にバッファリングします。これにより、後でオーディオを Weave に渡してログできるようになります。
```python lines theme={"system"}
class StreamingWavWriter:
"""Writes audio integer or byte array chunks to a WAV file."""
wav_file = None
buffer = None
in_memory = False
def __init__(
self,
filename=None,
channels=INPUT_DEVICE_CHANNELS,
sample_width=SAMPLE_WIDTH,
framerate=SAMPLE_RATE,
):
self.in_memory = filename is None
if self.in_memory:
self.buffer = io.BytesIO()
self.wav_file = wave.open(self.buffer, "wb")
else:
self.wav_file = wave.open(filename, "wb")
self.wav_file.setnchannels(channels)
self.wav_file.setsampwidth(sample_width)
self.wav_file.setframerate(framerate)
def append_int16_chunk(self, int16_data):
if int16_data is not None:
self.wav_file.writeframes(
int16_data.tobytes()
if isinstance(int16_data, np.ndarray)
else int16_data
)
def close(self):
self.wav_file.close()
def get_wav_buffer(self):
assert self.in_memory, "Buffer only available if stream is in memory."
return self.buffer
```
リアルタイムオーディオモデル
リアルタイム (RT) オーディオモデルは、WebSocket を使用して OpenAI の Realtime API にイベントを送信します。このモデルは次のように動作します。
1. **init**: ローカルバッファ (入力オーディオ) とストリーム (アシスタントの再生ストリーム、ユーザーオーディオのディスク書き込みストリーム) を初期化し、Realtime API への接続を開きます。
2. **receive\_messages\_thread**: API からのメッセージ受信はスレッドで処理します。コードでは主に次の 4 つのイベントタイプを処理します。
* `RESPONSE_AUDIO_TRANSCRIPT_DONE`: アシスタントの応答が完了したことをサーバーが通知し、トランスクリプトを返します。
* `CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED`: ユーザーのオーディオの文字起こしが完了したことをサーバーが通知し、そのトランスクリプトを送信します。コードはトランスクリプトを Weave にログし、ユーザー向けに表示します。
* `RESPONSE_AUDIO_DELTA`: サーバーがアシスタントの応答オーディオの新しいチャンクを送信します。コードはこのチャンクを、応答 ID に対応する進行中の応答データに追加するとともに、再生用の出力ストリームにも追加します。
* `RESPONSE_DONE`: アシスタントの応答が完了したことをサーバーが通知します。コードは応答に関連付けられたすべてのオーディオチャンクとトランスクリプトを取得し、Weave にログします。
3. **send\_audio**: ハンドラがユーザーのオーディオチャンクをバッファに追加し、オーディオバッファが一定のサイズに達するとオーディオのチャンクを送信します。
```python lines theme={"system"}
class RTAudioModel(weave.Model):
"""Model class for realtime e2e audio OpenAI model interaction with Whisper user transcription for logging."""
realtime_model_name: str = "gpt-4o-realtime-preview-2024-10-01" # リアルタイム e2e オーディオ専用モデルとのやり取り
stop_event: Optional[threading.Event] = threading.Event() # モデル停止用のイベント
ws: Optional[websocket.WebSocket] = None # OpenAI との通信用 Websocket
user_wav_writer: Optional[StreamingWavWriter] = (
None # ユーザーの出力をファイルに書き込むストリーム
)
input_audio_buffer: Optional[np.ndarray] = None # ユーザーのオーディオチャンク用バッファ
assistant_outputs: dict[str, StreamingWavWriter] = (
None # Weave に送信するために集計したアシスタントの出力
)
playback_stream: Optional[pyaudio.Stream] = (
None # アシスタントの応答を再生するストリーム
)
def __init__(self):
super().__init__()
self.stop_event.clear()
self.user_wav_writer = StreamingWavWriter(
filename="user_audio.wav", framerate=SAMPLE_RATE
)
self.input_audio_buffer = np.array([], dtype=np.int16)
self.ws = websocket.WebSocket()
self.assistant_outputs = {}
# 有効な場合はアシスタントのオーディオ再生ストリームを開く
if enable_audio_playback:
self.playback_stream = pyaudio.PyAudio().open(
format=pyaudio.paInt16,
channels=OUTPUT_DEVICE_CHANNELS,
rate=OAI_SAMPLE_RATE,
output=True,
output_device_index=OUTPUT_DEVICE_INDEX,
)
# Websocket に接続
try:
self.ws.connect(
f"wss://api.openai.com/v1/realtime?model={self.realtime_model_name}",
header={
"Authorization": f"Bearer {os.environ.get('OPENAI_API_KEY')}",
"OpenAI-Beta": "realtime=v1",
},
)
# 設定メッセージを送信
config_event = SessionUpdate(
session=Session(
modalities=["text", "audio"], # 使用するモダリティ
input_audio_transcription=InputAudioTranscription(
model="whisper-1"
), # 文字起こしには whisper-1 を使用
turn_detection=TurnDetection(
type="server_vad",
threshold=0.3,
prefix_padding_ms=300,
silence_duration_ms=600,
), # サーバー VAD で無音を検出
)
)
self.ws.send(config_event.model_dump_json(exclude_none=True))
self.log_ws_message(config_event.model_dump_json(exclude_none=True), "Sent")
# リスナーを開始
websocket_thread = threading.Thread(target=self.receive_messages_thread)
websocket_thread.daemon = True
websocket_thread.start()
except Exception as e:
print(f"Error connecting to WebSocket: {e}")
##### Weave インテグレーションとメッセージハンドラ #####
def handle_assistant_response_audio_delta(self, data: ResponseAudioDelta):
if data.response_id not in self.assistant_outputs:
self.assistant_outputs[data.response_id] = StreamingWavWriter(
framerate=OAI_SAMPLE_RATE
)
data_bytes = base64.b64decode(data.delta)
self.assistant_outputs[data.response_id].append_int16_chunk(data_bytes)
if enable_audio_playback:
self.playback_stream.write(data_bytes)
return {"assistant_audio": data_bytes}
@weave.op()
def handle_assistant_response_done(self, data: ResponseDone):
wave_file_stream = self.assistant_outputs[data.response.id]
wave_file_stream.close()
wave_file_stream.buffer.seek(0)
weave_payload = {
"assistant_audio": wave.open(wave_file_stream.get_wav_buffer(), "rb"),
"assistant_transcript": data.response.output[0]
.content[0]
.get("transcript", "Transcript Unavailable."),
}
return weave_payload
@weave.op()
def handle_user_transcription_done(
self, data: ConversationItemInputAudioTranscriptionCompleted
):
return {"user_transcript": data.transcript}
##### メッセージの受信と送信 #####
def receive_messages_thread(self):
while not self.stop_event.is_set():
try:
data = json.loads(self.ws.recv())
self.log_ws_message(json.dumps(data, indent=2))
parsed_event = parse_server_event(data)
if parsed_event.type == ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE:
print("Assistant: ", parsed_event.transcript)
elif (
parsed_event.type
== ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
):
print("User: ", parsed_event.transcript)
self.handle_user_transcription_done(parsed_event)
elif parsed_event.type == ServerEventTypes.RESPONSE_AUDIO_DELTA:
self.handle_assistant_response_audio_delta(parsed_event)
elif parsed_event.type == ServerEventTypes.RESPONSE_DONE:
self.handle_assistant_response_done(parsed_event)
elif parsed_event.type == ServerEventTypes.ERROR:
print(
f"\nError from server: {parsed_event.error.model_dump_json(exclude_none=True)}"
)
except websocket.WebSocketConnectionClosedException:
print("\nWebSocket connection closed")
break
except json.JSONDecodeError:
continue
except Exception as e:
print(f"\nError in receive_messages: {e}")
break
def send_audio(self, audio_chunk):
if self.ws and self.ws.connected:
self.input_audio_buffer = np.append(
self.input_audio_buffer, np.frombuffer(audio_chunk, dtype=np.int16)
)
if len(self.input_audio_buffer) >= SAMPLE_RATE * CHUNK_DURATION:
try:
# オーディオを OAI のサンプリングレートにリサンプリング
resampled_audio = (
resampy.resample(
self.input_audio_buffer, SAMPLE_RATE, OAI_SAMPLE_RATE
)
if SAMPLE_RATE != OAI_SAMPLE_RATE
else self.input_audio_buffer
)
# オーディオチャンクを OAI API に送信
audio_event = InputAudioBufferAppend(
audio=base64.b64encode(
resampled_audio.astype(np.int16).tobytes()
).decode("utf-8") # オーディオ配列を b64 バイトに変換
)
self.ws.send(audio_event.model_dump_json(exclude_none=True))
self.log_ws_message(
audio_event.model_dump_json(exclude_none=True), "Sent"
)
finally:
self.user_wav_writer.append_int16_chunk(self.input_audio_buffer)
# オーディオバッファをクリア
self.input_audio_buffer = np.array([], dtype=np.int16)
else:
print("Error sending audio: websocket not initialized.")
##### 汎用ユーティリティ関数 #####
def log_ws_message(self, message, direction="Received"):
with open("websocket_log.txt", "a") as log_file:
log_file.write(
f"{time.strftime('%Y-%m-%d %H:%M:%S')} - {direction}: {message}\n"
)
def stop(self):
self.stop_event.set()
if self.ws:
self.ws.close()
self.user_wav_writer.close()
```
オーディオレコーダー
モデルを定義したら、次はマイク入力をモデルに渡す仕組みが必要です。この例では、RTAudio モデルの `send_audio` メソッドにハンドラを紐付けた PyAudio 入力ストリームを使用します。このコードはストリームをメインスレッドに返すため、プログラムの完了時にストリームを安全に終了できます。
```python lines theme={"system"}
# オーディオキャプチャ用ストリーム
def record_audio(realtime_model: RTAudioModel) -> pyaudio.Stream:
"""Setup a Pyaudio input stream and use the RTAudioModel as a callback for streaming data."""
def audio_callback(in_data, frame_count, time_info, status):
realtime_model.send_audio(in_data)
return (None, pyaudio.paContinue)
p = pyaudio.PyAudio()
stream = p.open(
format=pyaudio.paInt16,
channels=INPUT_DEVICE_CHANNELS,
rate=SAMPLE_RATE,
input=True,
input_device_index=INPUT_DEVICE_INDEX,
frames_per_buffer=CHUNK,
stream_callback=audio_callback,
)
stream.start_stream()
print("Recording started. Please begin speaking to your personal assistant...")
return stream
```
メインスレッド
この最後のセルでは、これまでのコンポーネントを組み合わせてリアルタイムアシスタントを実行します。メインスレッドでは、Weave を統合した Realtime Audio Model を起動します。次に、コードで録音を開始し、ユーザーがキーボード割り込みを行うまで待機します。セルを停止すると、ユーザーとアシスタントのトランスクリプトおよびオーディオを含む、会話全体の Weave トレースが得られます。
```python lines theme={"system"}
weave.init(project_name="realtime-oai-audio-testing")
realtime_model = RTAudioModel()
if realtime_model.ws and realtime_model.ws.connected:
recording_stream: pyaudio.Stream = record_audio(realtime_model)
try:
while not realtime_model.stop_event.is_set():
time.sleep(1)
except KeyboardInterrupt:
pass
except Exception as e:
print(f"Error in main loop: {e}")
import traceback
traceback.print_exc()
finally:
print("Exiting...")
realtime_model.stop()
if recording_stream and recording_stream.is_active():
recording_stream.stop_stream()
recording_stream.close()
else:
print(
"WebSocket connection failed. Please check your API key and internet connection."
)
```