> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# PyTorch Lightning
> 組み込みの WandbLogger を使用して、PyTorch Lightning で W&B による実験のトラッキングとモデルのチェックポイント保存を行います。
export const ColabLink = ({url}) =>
Try in Colab
;
PyTorch Lightning は、PyTorch コードを整理し、分散トレーニングや 16 ビット精度といった高度な機能を追加するための軽量なラッパーを提供します。W\&B は、ML 実験をログするための軽量なラッパーを提供します。この 2 つを自分で組み合わせる必要はありません。PyTorch Lightning ライブラリには、[`WandbLogger`](https://lightning.ai/docs/pytorch/stable/api/lightning.pytorch.loggers.wandb.html#module-lightning.pytorch.loggers.wandb) を通じて W\&B が直接組み込まれています。
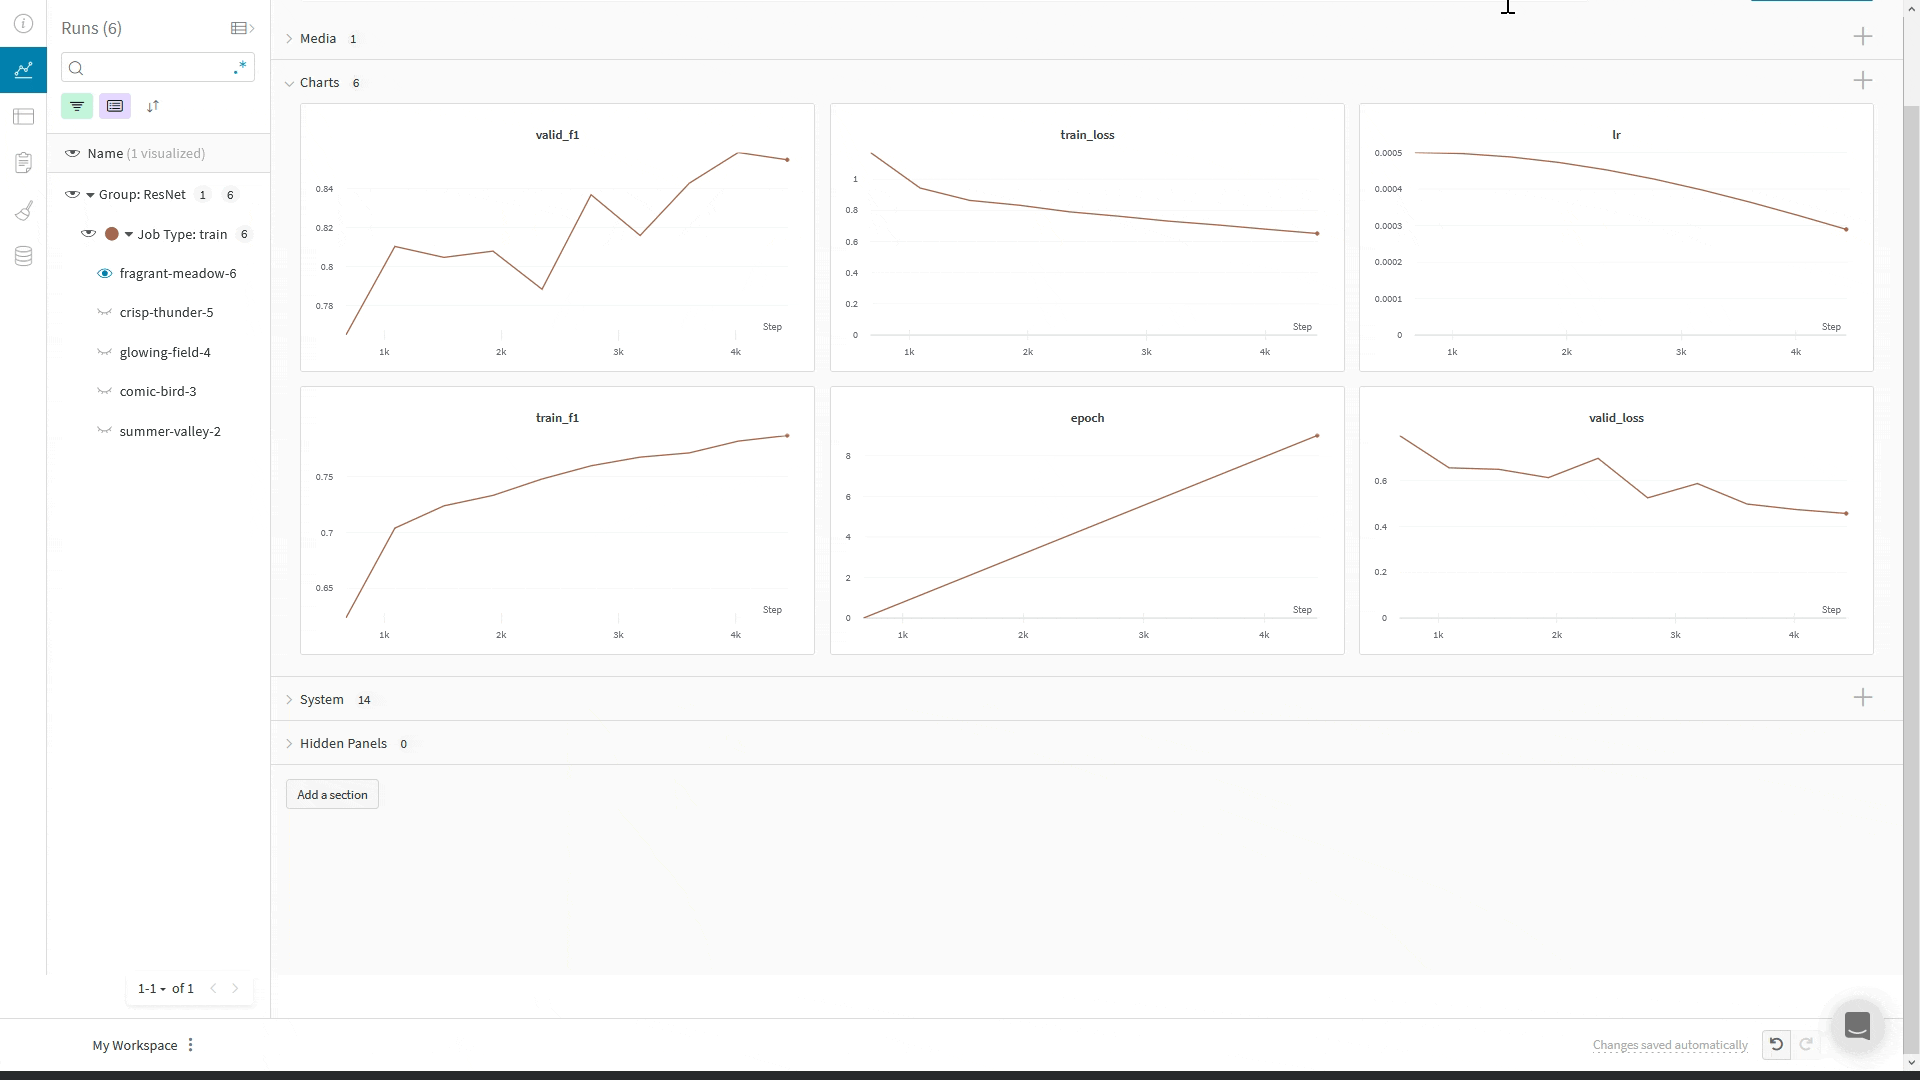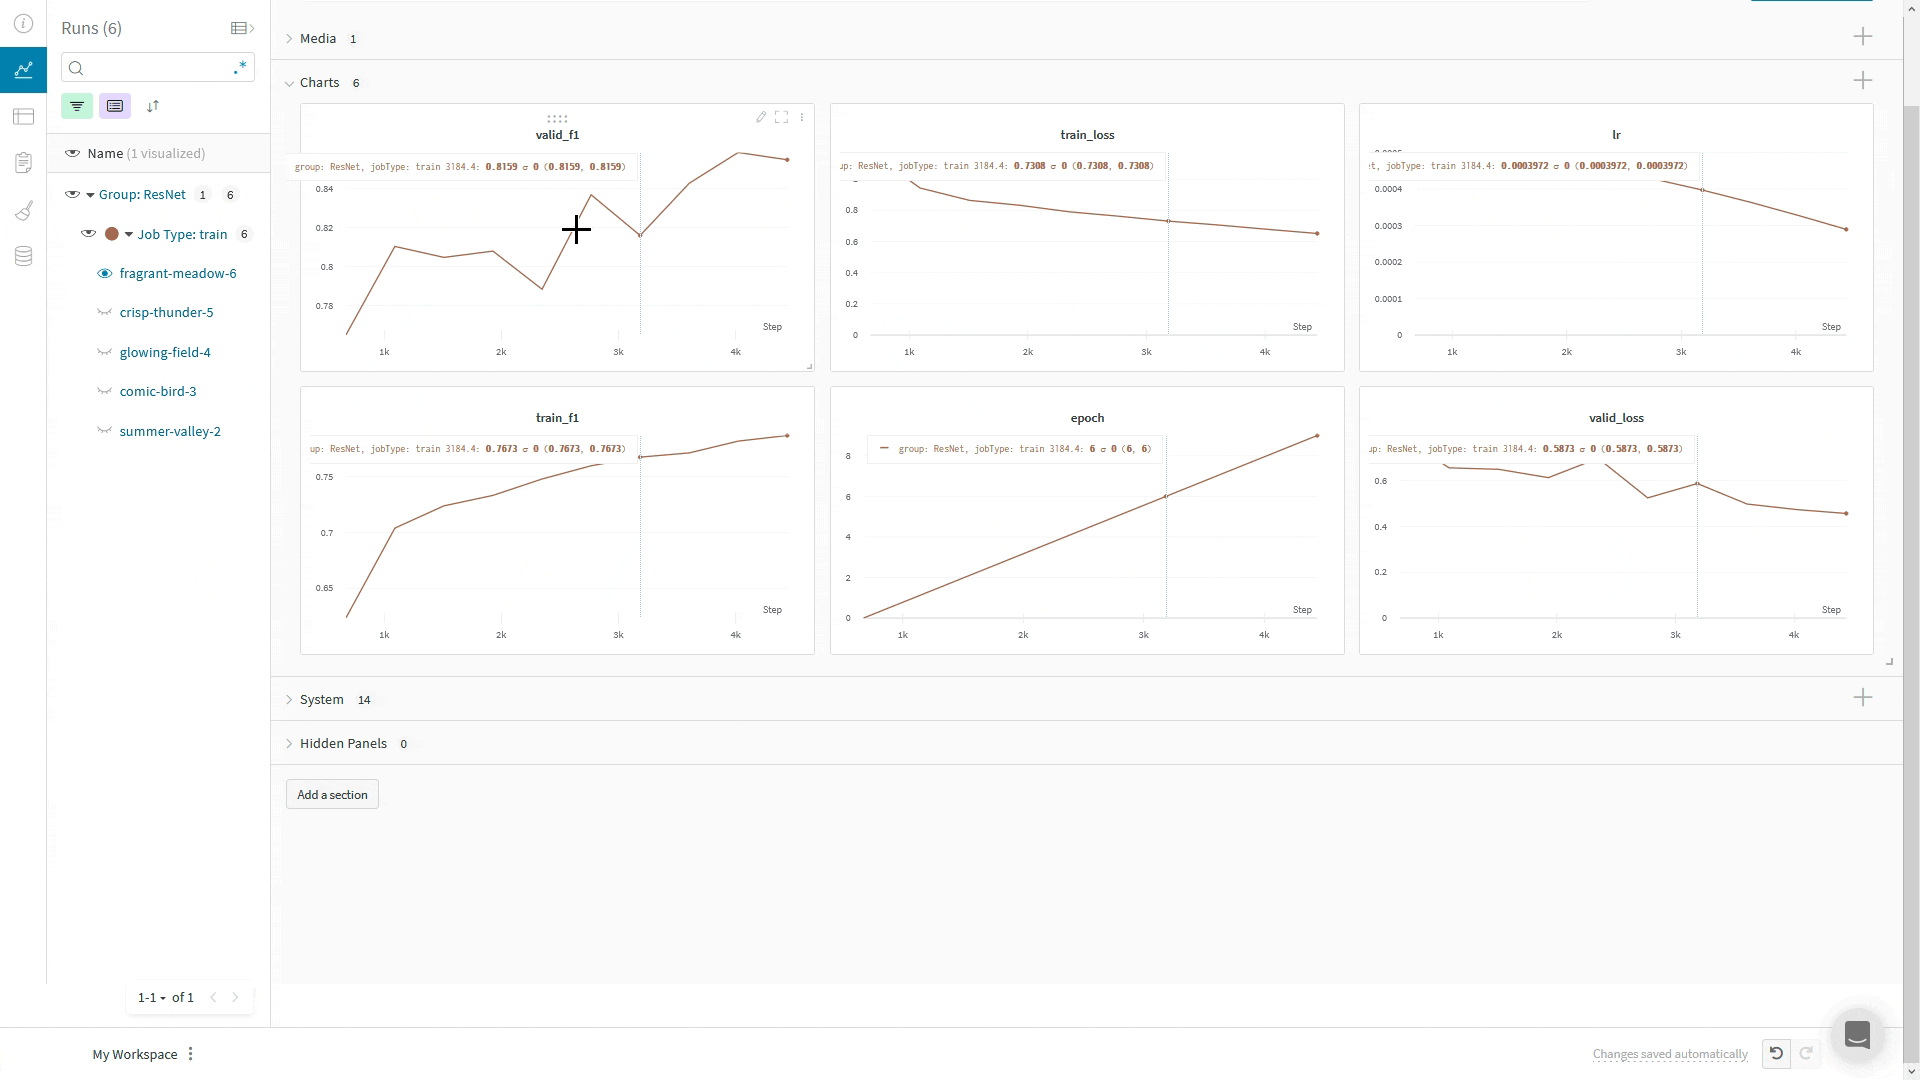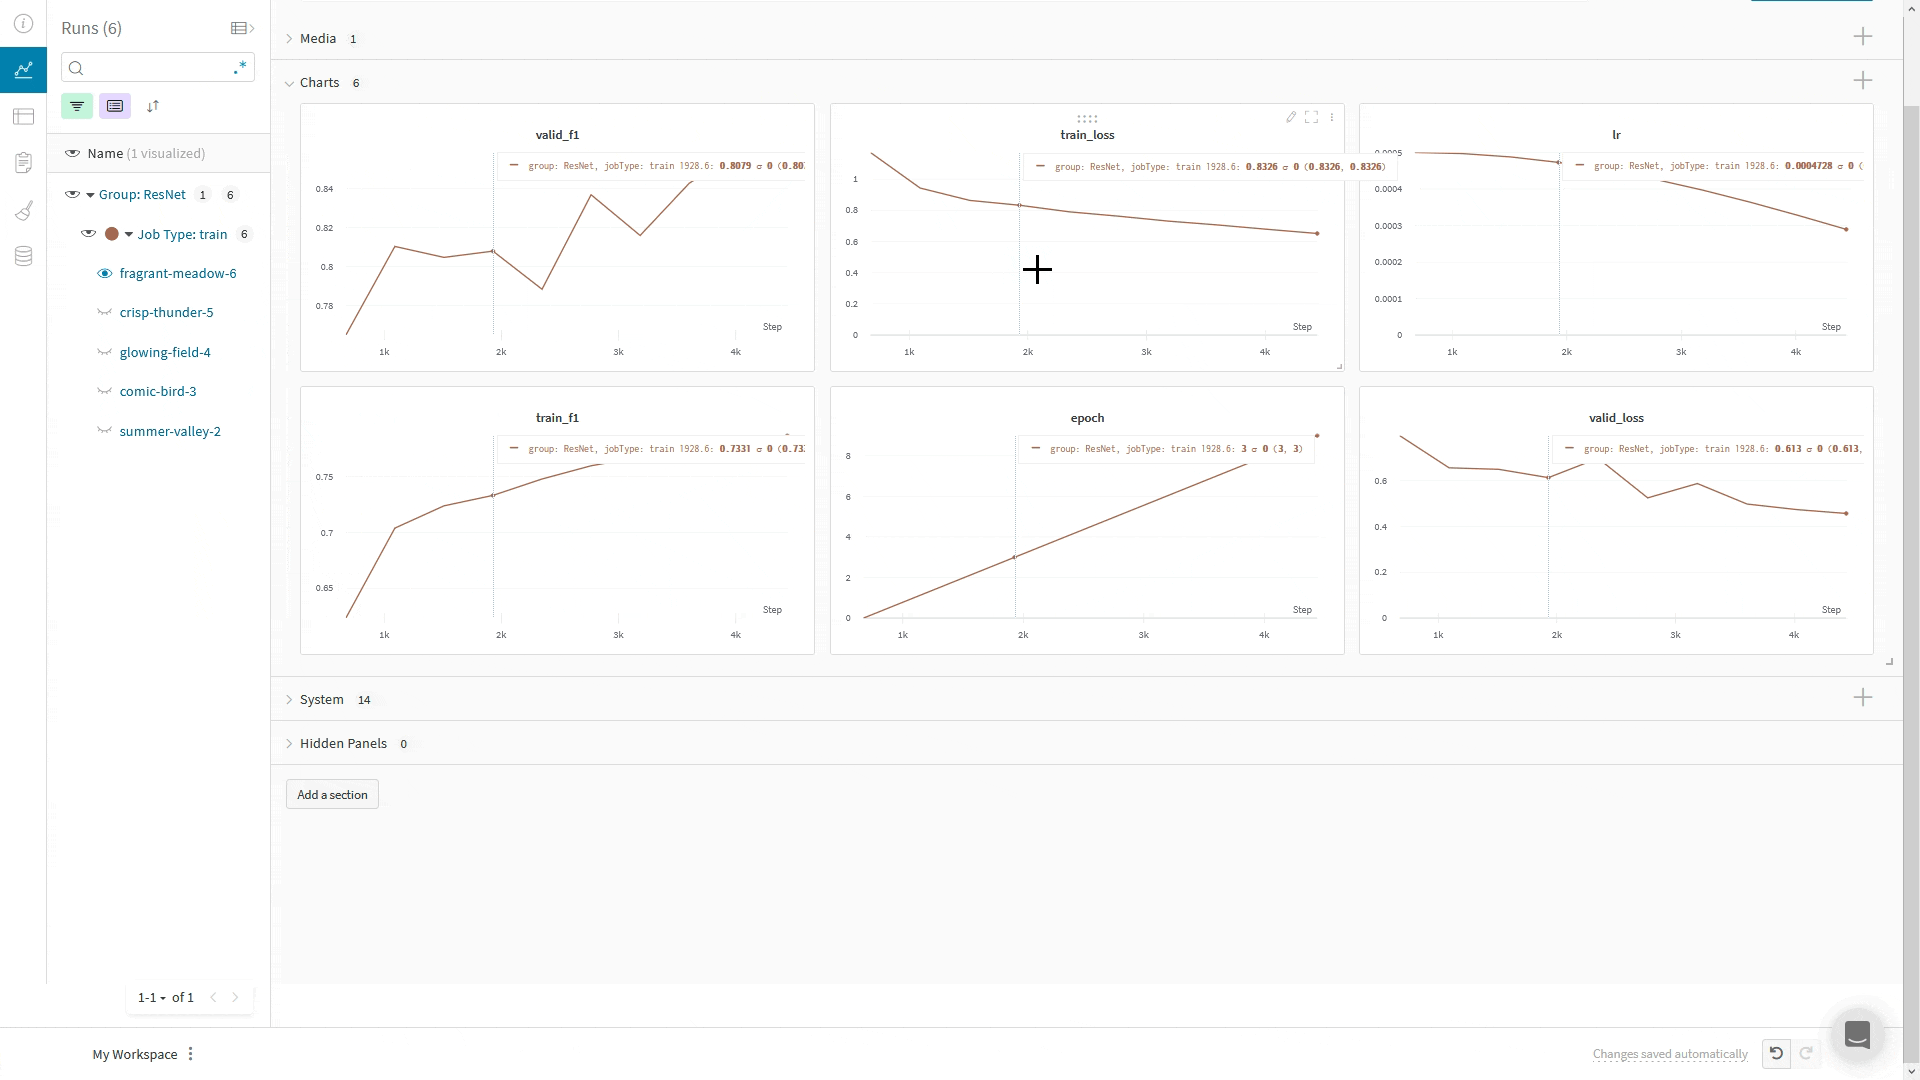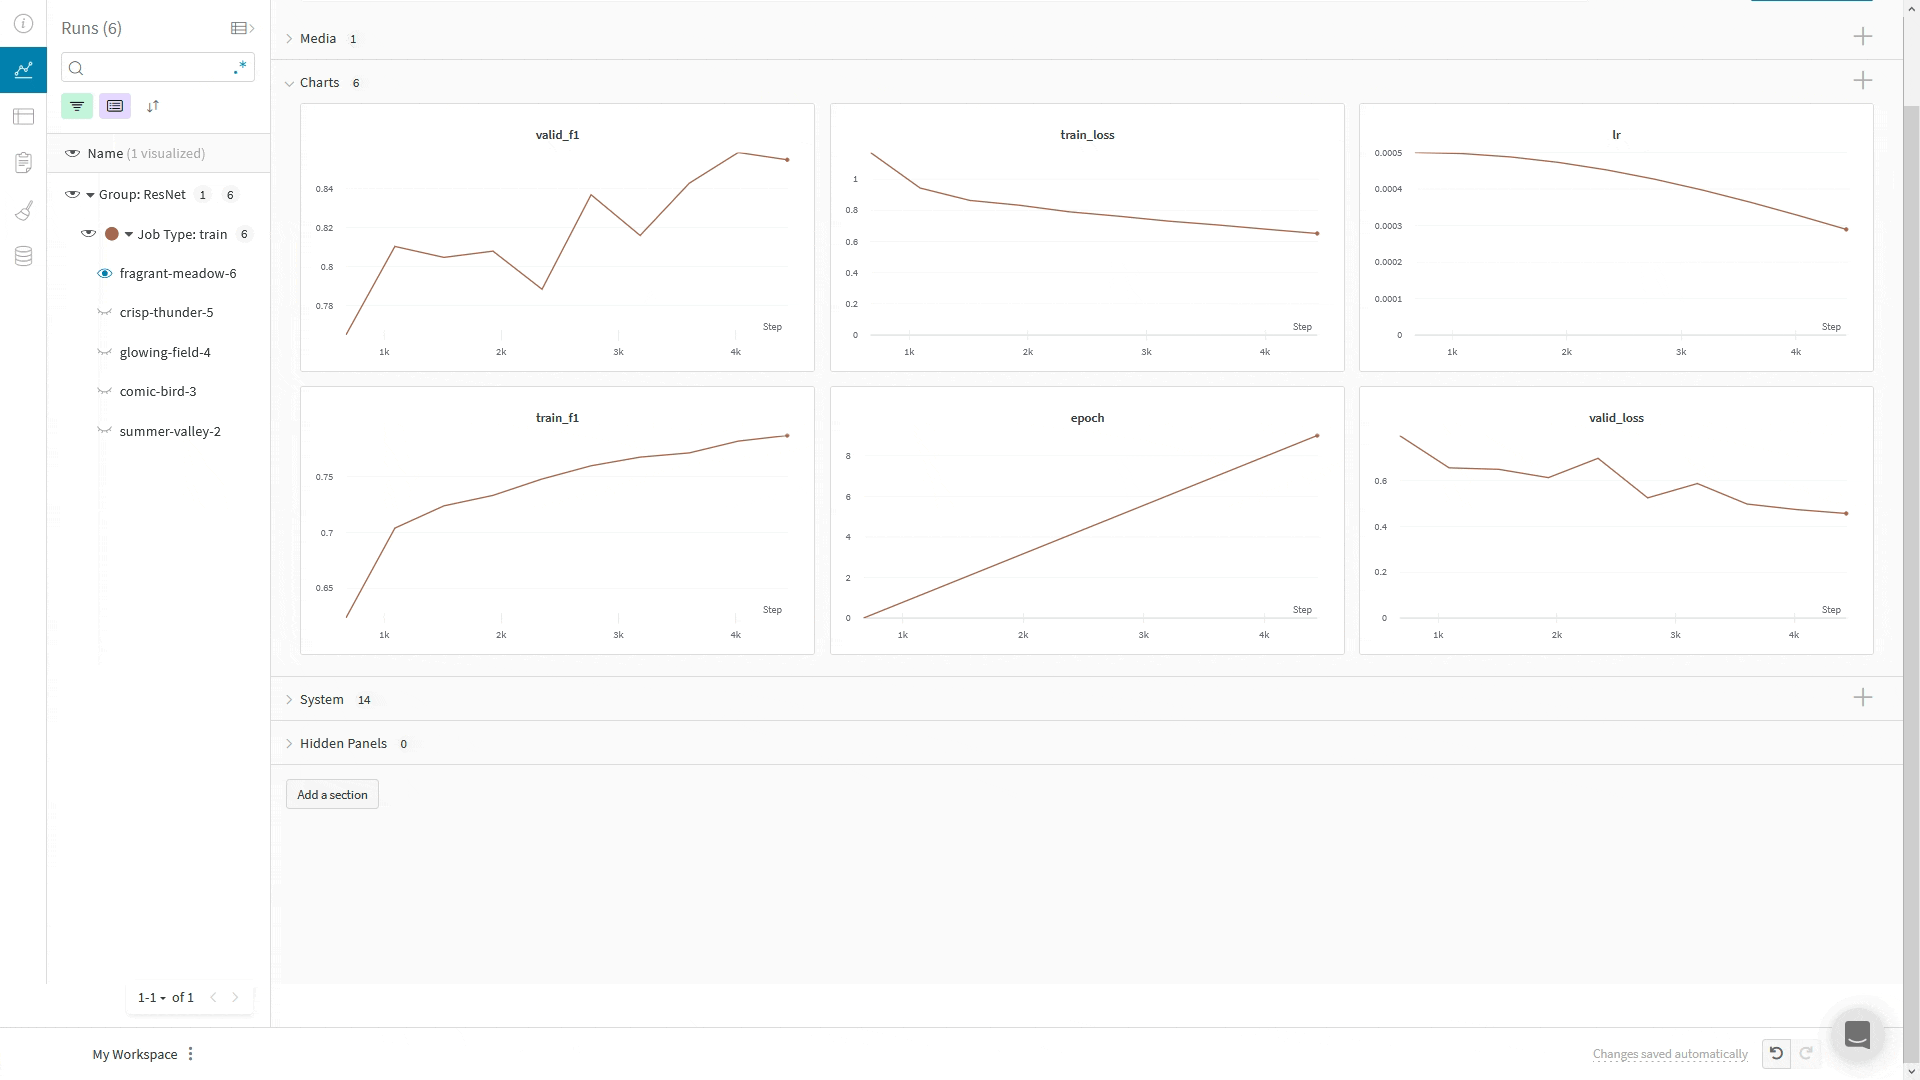
このページでは、`WandbLogger` を使用して、メトリクスの追跡、ハイパーパラメーターのログ、モデルチェックポイントのアーティファクトとしての保存、メディアのログ、および PyTorch Lightning と W\&B によるマルチ GPU トレーニングの実行を行う方法を説明します。
Lightning との統合
以下のセクションでは、W\&B での認証方法、`wandb` ライブラリのインストール方法、および Lightning の `Trainer` または `Fabric` インスタンスへの `WandbLogger` のアタッチ方法を説明します。
```python theme={"system"}
from lightning.pytorch.loggers import WandbLogger
from lightning.pytorch import Trainer
wandb_logger = WandbLogger(log_model="all")
trainer = Trainer(logger=wandb_logger)
```
**`wandb.log()` の使用について:** `WandbLogger` は Trainer の `global_step` を使用して W\&B にログします。コード内で直接 `wandb.log()` を追加で呼び出す場合は、`wandb.log()` で `step` 引数を使用しないでください。
代わりに、他のメトリクスと同様に Trainer の `global_step` をログしてください:
```python theme={"system"}
wandb.log({"accuracy":0.99, "trainer/global_step": step})
```
```python theme={"system"}
import lightning as L
from wandb.integration.lightning.fabric import WandbLogger
wandb_logger = WandbLogger(log_model="all")
fabric = L.Fabric(loggers=[wandb_logger])
fabric.launch()
fabric.log_dict({"important_metric": important_metric})
```
サインアップして API キーを作成する
API キーは、お使いのマシンを W\&B に対して認証するために使用します。API キーはユーザープロフィールから生成できます。
より簡単な方法として、[User Settings](https://forge.coreweave.com/settings) に移動して APIキーを作成することもできます。作成した APIキーはすぐにコピーし、パスワードマネージャーなどの安全な場所に保存してください。
ユーザープロフィールから API キーを生成するには、次の手順に従います。
1. 右上隅にあるユーザープロフィールのアイコンをクリックします。
2. **User Settings** を選択し、**API Keys** セクションまでスクロールします。
`wandb` ライブラリをインストールしてログインする
`wandb` ライブラリをローカルにインストールしてログインするには:
1. `WANDB_API_KEY` [環境変数](/ja/products/wandb/track/environment-variables) に APIキー を設定します。`<>` で囲まれた値を各自の値に置き換えてください:
```bash theme={"system"}
export WANDB_API_KEY=
```
2. `wandb` ライブラリをインストールしてログインします。
```shell theme={"system"}
pip install wandb
wandb login
```
```bash theme={"system"}
pip install wandb
```
```python theme={"system"}
import wandb
wandb.login()
```
```notebook theme={"system"}
!pip install wandb
import wandb
wandb.login()
```
PyTorch Lightning の `WandbLogger` を使用する
PyTorch Lightning には、メトリクス、モデルの重み、メディアをログする複数の `WandbLogger` クラスがあります。トレーニングのセットアップに合ったクラスを選択してください:
* [`PyTorch`](https://lightning.ai/docs/pytorch/stable/api/lightning.pytorch.loggers.wandb.html#module-lightning.pytorch.loggers.wandb)
* [`Fabric`](https://lightning.ai/docs/pytorch/stable/api/lightning.pytorch.loggers.wandb.html#module-lightning.pytorch.loggers.wandb)
Lightning と統合するには、`WandbLogger` をインスタンス化し、Lightning の `Trainer` または `Fabric` に渡してください。
```python theme={"system"}
trainer = Trainer(logger=wandb_logger)
```
```python theme={"system"}
fabric = L.Fabric(loggers=[wandb_logger])
fabric.launch()
fabric.log_dict({
"important_metric": important_metric
})
```
一般的なロガー引数
次の表は `WandbLogger` の一般的なパラメーターを一覧にしています。すべてのロガー引数の詳細については、PyTorch Lightning のドキュメントを確認してください。
* [`PyTorch`](https://lightning.ai/docs/pytorch/stable/api/lightning.pytorch.loggers.wandb.html#module-lightning.pytorch.loggers.wandb)
* [`Fabric`](https://lightning.ai/docs/pytorch/stable/api/lightning.pytorch.loggers.wandb.html#module-lightning.pytorch.loggers.wandb)
| パラメーター | 説明 |
| - | - |
| `project` | ログする W\&B project を定義します |
| `name` | W\&B run の名を付けます |
| `log_model` | `log_model="all"` の場合はすべてのモデルをログし、`log_model=True` の場合はトレーニングの最後にログします |
| `save_dir` | データが保存されるパス |
ハイパーパラメーターをログする
W\&B でハイパーパラメーターをログすると、run を比較したり結果を再現したりできます。使用するロガーに合ったメソッドを使用します:
```python theme={"system"}
class LitModule(LightningModule):
def __init__(self, *args, **kwarg):
self.save_hyperparameters()
```
```python theme={"system"}
wandb_logger.log_hyperparams(
{
"hyperparameter_1": hyperparameter_1,
"hyperparameter_2": hyperparameter_2,
}
)
```
追加の設定 パラメーターをログする
ハイパーパラメーターと一緒に追加の設定値をログするには、run 設定を直接更新します:
```python theme={"system"}
# 1つのパラメーターを追加
wandb_logger.experiment.config["key"] = value
# 複数のパラメーターを追加
wandb_logger.experiment.config.update({key1: val1, key2: val2})
# wandb モジュールを直接使用する
wandb.config["key"] = value
wandb.config.update()
```
勾配、パラメーターのヒストグラム、モデルトポロジをログする
学習中にモデルの勾配とパラメーターを監視するには、モデルオブジェクトを `wandb_logger.watch()` に渡します。詳細は PyTorch Lightning の `WandbLogger` のドキュメントを参照してください。
メトリクスをログする
`WandbLogger` を使用してメトリクスを W\&B にログするには、`LightningModule` 内の `training_step` や `validation_step` などのメソッドで `self.log('my_metric_name', metric_value)` を呼び出します。
次のコードスニペットは、メトリクスと `LightningModule` のハイパーパラメーターをログするように `LightningModule` を定義する方法を示しています。この例では、メトリクスの計算に [`torchmetrics`](https://github.com/Lightning-AI/torchmetrics) ライブラリーを使用しています。
```python theme={"system"}
import torch
from torch.nn import Linear, CrossEntropyLoss, functional as F
from torch.optim import Adam
from torchmetrics.functional import accuracy
from lightning.pytorch import LightningModule
class My_LitModule(LightningModule):
def __init__(self, n_classes=10, n_layer_1=128, n_layer_2=256, lr=1e-3):
"""method used to define the model parameters"""
super().__init__()
# mnist images are (1, 28, 28) (channels, width, height)
self.layer_1 = Linear(28 * 28, n_layer_1)
self.layer_2 = Linear(n_layer_1, n_layer_2)
self.layer_3 = Linear(n_layer_2, n_classes)
self.loss = CrossEntropyLoss()
self.lr = lr
# save hyper-parameters to self.hparams (auto-logged by W&B)
self.save_hyperparameters()
def forward(self, x):
"""method used for inference input -> output"""
# (b, 1, 28, 28) -> (b, 1*28*28)
batch_size, channels, width, height = x.size()
x = x.view(batch_size, -1)
# apply 3 x (linear + relu)
x = F.relu(self.layer_1(x))
x = F.relu(self.layer_2(x))
x = self.layer_3(x)
return x
def training_step(self, batch, batch_idx):
"""needs to return a loss from a single batch"""
_, loss, acc = self._get_preds_loss_accuracy(batch)
# Log loss and metric
self.log("train_loss", loss)
self.log("train_accuracy", acc)
return loss
def validation_step(self, batch, batch_idx):
"""used for logging metrics"""
preds, loss, acc = self._get_preds_loss_accuracy(batch)
# Log loss and metric
self.log("val_loss", loss)
self.log("val_accuracy", acc)
return preds
def configure_optimizers(self):
"""defines model optimizer"""
return Adam(self.parameters(), lr=self.lr)
def _get_preds_loss_accuracy(self, batch):
"""convenience function since train/valid/test steps are similar"""
x, y = batch
logits = self(x)
preds = torch.argmax(logits, dim=1)
loss = self.loss(logits, y)
acc = accuracy(preds, y)
return preds, loss, acc
```
```python theme={"system"}
import lightning as L
import torch
import torchvision as tv
from wandb.integration.lightning.fabric import WandbLogger
import wandb
fabric = L.Fabric(loggers=[wandb_logger])
fabric.launch()
model = tv.models.resnet18()
optimizer = torch.optim.SGD(model.parameters(), lr=lr)
model, optimizer = fabric.setup(model, optimizer)
train_dataloader = fabric.setup_dataloaders(
torch.utils.data.DataLoader(train_dataset, batch_size=batch_size)
)
model.train()
for epoch in range(num_epochs):
for batch in train_dataloader:
optimizer.zero_grad()
loss = model(batch)
loss.backward()
optimizer.step()
fabric.log_dict({"loss": loss})
```
メトリクスの最小値/最大値をログする
W\&B の [`define_metric`](/ja/products/wandb/ref/python/experiments/run#define_metric) 関数を使用すると、W\&B のサマリー メトリクス がそのメトリクスの最小値、最大値、平均値、または最適値を表示するかどうかを定義できます。`define_metric` を使用しない場合、ログされた最後の値がサマリー メトリクス に表示されます。詳細については、[ログ軸のカスタマイズガイド](/ja/products/wandb/track/log/customize-logging-axes) を参照してください。
W\&B のサマリー メトリクス で最大の検証精度をトラッキングするには、トレーニングの開始時に `wandb.define_metric()` を 1 回だけ呼び出します。
```python theme={"system"}
class My_LitModule(LightningModule):
...
def validation_step(self, batch, batch_idx):
if trainer.global_step == 0:
wandb.define_metric("val_accuracy", summary="max")
preds, loss, acc = self._get_preds_loss_accuracy(batch)
# 損失とメトリクスをログする
self.log("val_loss", loss)
self.log("val_accuracy", acc)
return preds
```
```python theme={"system"}
wandb.define_metric("val_accuracy", summary="max")
fabric = L.Fabric(loggers=[wandb_logger])
fabric.launch()
fabric.log_dict({"val_accuracy": val_accuracy})
```
モデルをチェックポイントする
W\&B アーティファクトとしてチェックポイントを保存すると、run、alias、またはバージョンで後から取得できるバージョン管理されたモデルファイルが得られます。
W\&B [アーティファクト](/ja/products/wandb/artifacts) としてモデル チェックポイントを保存するには、
Lightning [`ModelCheckpoint`](https://lightning.ai/docs/pytorch/stable/api/lightning.pytorch.callbacks.ModelCheckpoint.html) コールバックを使用し、`WandbLogger` の `log_model` 引数を設定します。
```python theme={"system"}
trainer = Trainer(logger=wandb_logger, callbacks=[checkpoint_callback])
```
```python theme={"system"}
fabric = L.Fabric(loggers=[wandb_logger], callbacks=[checkpoint_callback])
```
`latest` と `best` のエイリアスは自動的に設定され、W\&B アーティファクトからモデル チェックポイントを取得しやすくします。
```python theme={"system"}
# reference はアーティファクトパネルで取得できます
# はバージョン (たとえば、"v2") または alias ("latest" または "best") にできます
checkpoint_reference = "//:"
```
```python theme={"system"}
# チェックポイントをローカルにダウンロードする(まだキャッシュされていない場合)
wandb_logger.download_artifact(checkpoint_reference, artifact_type="model")
```
```python theme={"system"}
# チェックポイントをローカルにダウンロードする(まだキャッシュされていない場合)
run = wandb.init(project="MNIST")
artifact = run.use_artifact(checkpoint_reference, type="model")
artifact_dir = artifact.download()
```
```python theme={"system"}
# チェックポイントを読み込む
model = LitModule.load_from_checkpoint(Path(artifact_dir) / "model.ckpt")
```
```python theme={"system"}
# 生のチェックポイントをリクエストする
full_checkpoint = fabric.load(Path(artifact_dir) / "model.ckpt")
model.load_state_dict(full_checkpoint["model"])
optimizer.load_state_dict(full_checkpoint["optimizer"])
```
ログしたモデル チェックポイントは [W\&B Artifacts](/ja/products/wandb/artifacts) UI で表示でき、完全なモデル リネージが含まれます ([UI でのモデル チェックポイントの例](https://forge.coreweave.com/wandb/wandb/arttest/artifacts/model/iv3_trained/5334ab69740f9dda4fed/lineage?_gl=1*yyql5q*_ga*MTQxOTYyNzExOS4xNjg0NDYyNzk1*_ga_JH1SJHJQXJ*MTY5MjMwNzI2Mi4yNjkuMS4xNjkyMzA5NjM2LjM3LjAuMA..) を参照) 。
最適なモデル チェックポイントをブックマークし、チーム全体で一元管理するには、[W\&B Model Registry](/ja/products/wandb) にリンクします。
Registry では、タスクごとに最適なモデルを整理し、モデルのライフサイクルを管理し、ML lifecycle 全体でトラッキングと監査を行い、webhook またはジョブを使用して下流の action を [オートメーション](/ja/products/wandb/automations) できます。
画像、テキストなどをログする
`WandbLogger` には、メディアをログするための `log_image`、`log_text`、`log_table` メソッドがあります。
`wandb.log()` または `trainer.logger.experiment.log()` を直接呼び出して、オーディオ、Molecules、ポイントクラウド、3D オブジェクトなどの他のメディアタイプをログすることもできます。
```python theme={"system"}
# テンソル、NumPy 配列、または PIL 画像を使用
wandb_logger.log_image(key="samples", images=[img1, img2])
# キャプションを追加
wandb_logger.log_image(key="samples", images=[img1, img2], caption=["tree", "person"])
# ファイルパスを使用
wandb_logger.log_image(key="samples", images=["img_1.jpg", "img_2.jpg"])
# トレーナーで .log を使用
trainer.logger.experiment.log(
{"samples": [wandb.Image(img, caption=caption) for (img, caption) in my_images]},
step=current_trainer_global_step,
)
```
```python theme={"system"}
# データはリストのリストである必要があります
columns = ["input", "label", "prediction"]
my_data = [["cheese", "english", "english"], ["fromage", "french", "spanish"]]
# 列とデータを使用
wandb_logger.log_text(key="my_samples", columns=columns, data=my_data)
# pandas データフレームを使用
wandb_logger.log_text(key="my_samples", dataframe=my_dataframe)
```
```python theme={"system"}
# テキストキャプション、画像、オーディオを含む W&B 表をログする
columns = ["caption", "image", "sound"]
# データはリストのリストである必要があります
my_data = [
["cheese", wandb.Image(img_1), wandb.Audio(snd_1)],
["wine", wandb.Image(img_2), wandb.Audio(snd_2)],
]
# 表をログする
wandb_logger.log_table(key="my_samples", columns=columns, data=my_data)
```
Lightning の コールバック システムを使用して、`WandbLogger` を介して W\&B にログするタイミングを制御します。次の例では、検証画像と予測のサンプルをログします:
```python theme={"system"}
import torch
import wandb
import lightning.pytorch as pl
from lightning.pytorch.loggers import WandbLogger
# or
# from wandb.integration.lightning.fabric import WandbLogger
class LogPredictionSamplesCallback(Callback):
def on_validation_batch_end(
self, trainer, pl_module, outputs, batch, batch_idx, dataloader_idx
):
"""Called when the validation batch ends."""
# `outputs` は `LightningModule.validation_step` から来ます
# この場合、モデルの予測に対応します
# 最初のバッチから20個のサンプル画像予測をログする
if batch_idx == 0:
n = 20
x, y = batch
images = [img for img in x[:n]]
captions = [
f"Ground Truth: {y_i} - Prediction: {y_pred}"
for y_i, y_pred in zip(y[:n], outputs[:n])
]
# オプション 1: `WandbLogger.log_image` で画像をログする
wandb_logger.log_image(key="sample_images", images=images, caption=captions)
# オプション 2: 画像と予測を W&B 表 としてログする
columns = ["image", "ground truth", "prediction"]
data = [
[wandb.Image(x_i), y_i, y_pred] or x_i,
y_i,
y_pred in list(zip(x[:n], y[:n], outputs[:n])),
]
wandb_logger.log_table(key="sample_table", columns=columns, data=data)
trainer = pl.Trainer(callbacks=[LogPredictionSamplesCallback()])
```
Lightning と W\&B で複数の GPU を使用する
分散トレーニングを実行する場合、rank間で `wandb.run` をどのように参照するかによって、トレーニングが進行するかデッドロックするかが変わります。このセクションでは、その要件を説明し、推奨されるパターンを示します。
PyTorch Lightning は DDP インターフェイスを通じてマルチ GPU をサポートしています。ただし、PyTorch Lightning の設計上、GPU のインスタンス化の方法には注意が必要です。
Lightning では、トレーニングループ内の各 GPU (またはrank) をまったく同じ方法、同じ初期条件でインスタンス化する必要があります。しかし、`wandb.run` オブジェクトにアクセスできるのはrank 0 のプロセスのみで、rankが 0 以外のプロセスでは `wandb.run = None` となります。そのため、rankが 0 以外のプロセスが失敗する可能性があります。この場合、rank 0 のプロセスがすでにクラッシュしたrank 0 以外のプロセスの参加を待ち続け、デッドロックに陥ることがあります。
こうした理由から、トレーニングコードの構成方法には注意してください。推奨されるアプローチは、コードを `wandb.run` オブジェクトに依存しない形にすることです。
```python theme={"system"}
class MNISTClassifier(pl.LightningModule):
def __init__(self):
super(MNISTClassifier, self).__init__()
self.model = nn.Sequential(
nn.Flatten(),
nn.Linear(28 * 28, 128),
nn.ReLU(),
nn.Linear(128, 10),
)
self.loss = nn.CrossEntropyLoss()
def forward(self, x):
return self.model(x)
def training_step(self, batch, batch_idx):
x, y = batch
y_hat = self.forward(x)
loss = self.loss(y_hat, y)
self.log("train/loss", loss)
return {"train_loss": loss}
def validation_step(self, batch, batch_idx):
x, y = batch
y_hat = self.forward(x)
loss = self.loss(y_hat, y)
self.log("val/loss", loss)
return {"val_loss": loss}
def configure_optimizers(self):
return torch.optim.Adam(self.parameters(), lr=0.001)
def main():
# すべての乱数シードを同じ値に設定します。
# これは分散トレーニングでは重要です。
# 各ランクはそれぞれ独自の初期重みを持ちます。
# これらが一致しないと勾配も一致せず、
# 学習が収束しなくなる可能性があります。
pl.seed_everything(1)
train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True, num_workers=4)
val_loader = DataLoader(val_dataset, batch_size=64, shuffle=False, num_workers=4)
model = MNISTClassifier()
wandb_logger = WandbLogger(project="")
callbacks = [
ModelCheckpoint(
dirpath="checkpoints",
every_n_train_steps=100,
),
]
trainer = pl.Trainer(
max_epochs=3, gpus=2, logger=wandb_logger, strategy="ddp", callbacks=callbacks
)
trainer.fit(model, train_loader, val_loader)
```
サンプル
エンドツーエンドのウォークスルーについては、[Colab ノートブック付きのビデオチュートリアル](https://wandb.me/lit-colab) に沿って進めることができます。
よくある質問
W\&B は Lightning とどのように連携しますか?
この連携の中核となるのは [Lightning の `loggers` API](https://lightning.ai/docs/pytorch/stable/extensions/logging.html) です。この API により、ログ記録コードの大部分をフレームワークに依存しない形で記述できます。`Logger` インスタンスは [Lightning の `Trainer`](https://lightning.ai/docs/pytorch/stable/common/trainer.html) に渡され、この API の充実した[フックとコールバックの仕組み](https://lightning.ai/docs/pytorch/stable/extensions/callbacks.html)に基づいて呼び出されます。これにより、研究用のコードをエンジニアリングやログ記録のコードから明確に分離できます。
追加のコードなしで、インテグレーションは何をログしますか?
W\&B はモデル チェックポイントを保存します。そこでは、それらを表示したり、将来の run で使用するためにダウンロードしたりできます。W\&B はまた、GPU 使用量やネットワーク I/O などの [システムメトリクス](/ja/products/wandb/ref/python/experiments/system-metrics) を取得します。ハードウェアや OS 情報などの環境情報を取得します。[コード 状態](/ja/products/wandb/app/features/panels/code) を取得します。これには、Git commit と diff patch、ノートブックの内容、セッション履歴 が含まれます。また、標準出力にプリントされたものもすべて取得します。
`wandb.run` をトレーニングのセットアップで使用する必要がある場合はどうすればよいですか?
アクセスする必要がある変数のスコープを自分で拡張する必要があります。つまり、すべてのプロセスで初期条件が同じであることを確認してください。
```python theme={"system"}
if os.environ.get("LOCAL_RANK", None) is None:
os.environ["WANDB_DIR"] = wandb.run.dir
```
それらが該当する場合、`os.environ["WANDB_DIR"]` を使用してモデル チェックポイント のディレクトリを設定できます。これにより、ゼロ以外の rank のプロセスが `wandb.run.dir` にアクセスできます。