> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# ポイント集約
> W&B の折れ線グラフにおける 2 つのポイント集約モード(フルフィデリティのバケットサンプリングとランダムサンプリング)について説明します。
折れ線グラフでポイント集約の方式を使用すると、データ可視化の精度とパフォーマンスを向上できます。このページでは、利用可能な 2 つの集約モードとそれぞれの設定方法を説明します。Workspace に応じて、詳細さとレンダリング速度のバランスを適切に選択できるようになります。ポイント集約モードには、[フルフィデリティ](#full-fidelity)と[ランダムサンプリング](#random-sampling)の 2 種類があります。W\&B はデフォルトでフルフィデリティモードを使用します。
フルフィデリティ
フルフィデリティはデフォルトの集約方法で、データ内の極値を保持します。このセクションでは、フルフィデリティの仕組みと主な利点、および単一のチャートまたは Workspace 全体でフルフィデリティを有効にする方法について説明します。
フルフィデリティモードを使用すると、W\&B は x 軸を動的なバケットに分割します。線ごとのポイント数は、チャートのサイズと run の数に応じて調整されます。W\&B は各バケット内の最小値と最大値を計算し (オプションの陰影表示に使用) 、各バケットの最後の値 (平均値ではありません) を使用してプライマリの線を描画します。
ポイント集約のフルフィデリティモードには、主に 3 つの利点があります。
* 極値とスパイクの保持: データ内の極値やスパイクが失われません。
* 最小値と最大値のポイントのレンダリング方法の設定: W\&B アプリで、極値 (最小値/最大値) を陰影領域として表示するかどうかをインタラクティブに選択できます。
* データの忠実度を損なわないデータ探索: 特定のデータポイントにズームインすると、W\&B は x 軸のバケットサイズを再計算します。そのため、精度を損なうことなくデータを探索できます。また、W\&B は計算済みの集約をキャッシュして読み込み時間を短縮するため、大規模なデータセットを閲覧する際に便利です。
フルフィデリティの折れ線グラフのレンダリング方法は 2 つあります。
* **Band** (デフォルト) : 各バケット内の最小値と最大値を陰影付きの帯として表示し、線で全体的な傾向を示します。
* **Line**: ポイントを直接結ぶため、スパイクや落ち込みを見つけやすくなります。
フルフィデリティを有効にする
W\&B はデフォルトでフルフィデリティモードを使用します。手動で設定するには、次の手順に従います。
1. Workspace にアクセスします。
2. 画面右上の **Add panels** ボタンの左隣にある歯車アイコンを選択します。
3. 表示される UI スライダーで **Line plots** を選択します。
4. **Point aggregation** セクションで **Full fidelity** を選択します。
5. **Full fidelity display** ドロップダウンで **Band** または **Line** を選択します。
6. **Smoothing** のアルゴリズムと各種設定を行います。
7. **Aggregation** を **Mean**、**Min**、**Max** のいずれかに設定します。
8. **Apply** をクリックします。
1. Workspace にアクセスします。
2. 左側のタブにある **Workspace** アイコンを選択します。
3. 設定するラインプロットパネルにカーソルを合わせ、歯車アイコンをクリックします。
4. 表示されるモーダルで、**Point aggregation method** を **Full fidelity** に設定します。
5. **Full fidelity display** ドロップダウンで **Band** または **Line** を選択します。
6. **Smoothing** のアルゴリズムと各種設定を行います。
7. **Apply** をクリックします。
陰影表示は各バケット内のばらつきを可視化するもので、ポイントが線の周りにどの程度散らばっているかを確認できます。フルフィデリティ の折れ線グラフでは、陰影部分に次の内容を表示できます。
* **Min/Max**: 各 x 軸ポイントについて、最小値と最大値の間の領域を陰影で表示します。陰影部分には、各バケット内の最小値から最大値までのすべてのポイントが含まれます。
```math theme={"system"}
\text{Min/Max Range} = [\min(x_1, x_2, \ldots, x_n),\ \max(x_1, x_2, \ldots, x_n)]
```
ここで、$x_1, x_2, \ldots, x_n$ は特定のバケット内の値です。
* **Standard deviation**: 各 x 軸ポイントについて、標準偏差を使用して値のばらつきを計算し、その領域を陰影で表示します。
```math theme={"system"}
SD = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \overline{x})^2}
```
* **Standard error**: 各 x 軸ポイントについて、値をサンプルサイズの平方根で割り、サンプリング誤差の度合いを計算します。
```math theme={"system"}
SE = \frac{SD}{\sqrt{n}}
```
* **None**: 陰影表示なし (デフォルト)。
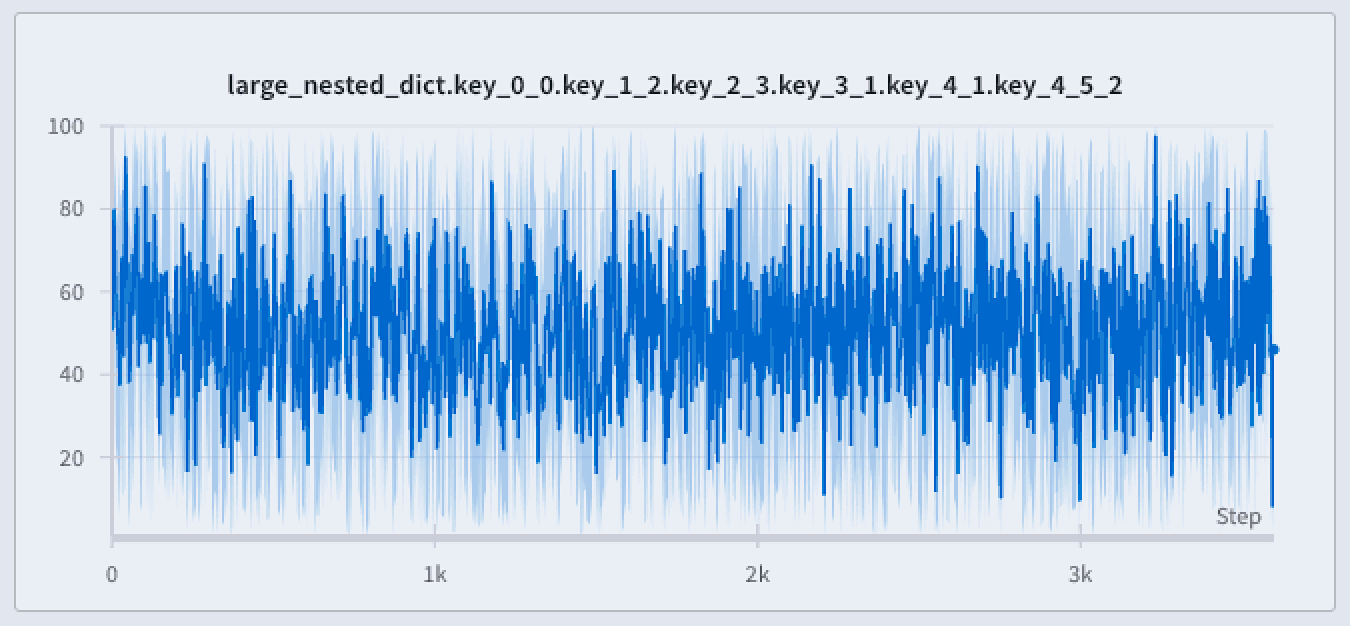
次の画像は青い折れ線グラフの例です。水色の陰影部分は、各バケットの最小値と最大値の範囲を表しています。
 陰影表示を設定するには、次の手順を実行します。
1. Workspace にアクセスします。
2. 折れ線グラフにカーソルを合わせ、歯車アイコンをクリックします。
3. **Data** タブで、必要に応じて **Point aggregation** を **フルフィデリティ** に設定し、スムージングアルゴリズムを設定します。
4. **Grouping** タブで、**Group runs** をオンにします。必要に応じて、**Group by** に run の属性を設定します。
5. **Agg** を **Mean** (デフォルト)、**Min**、**Max** のいずれかに設定します。
6. **Range** を **Min/Max**、**Std Dev**、**Std Err**、**None** のいずれかに設定します。
7. **Apply** をクリックします。
データの忠実度を損なわずにデータを探索する
極値やスパイクなどの重要なポイントを見落とすことなく、データセットの特定の領域を分析できます。折れ線グラフをズームインすると、W\&B は各バケット内の最小値、最大値、最後の値の計算に使用するバケットのサイズを調整します。
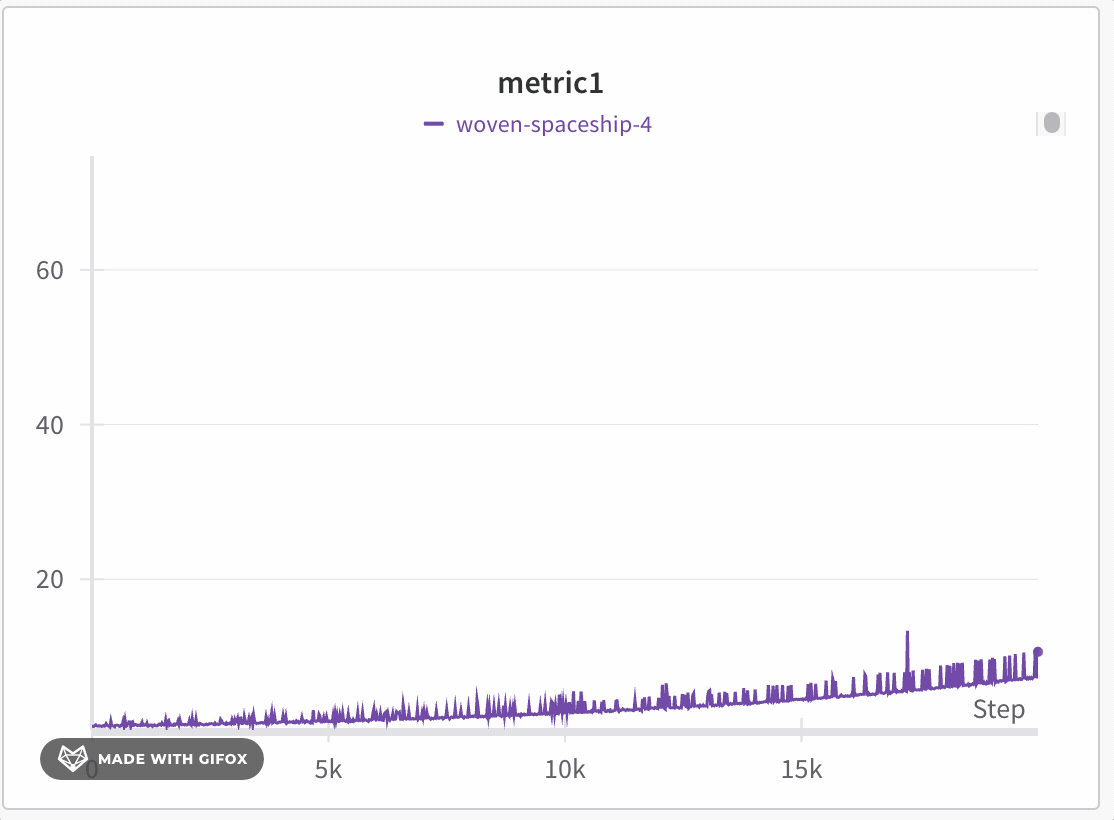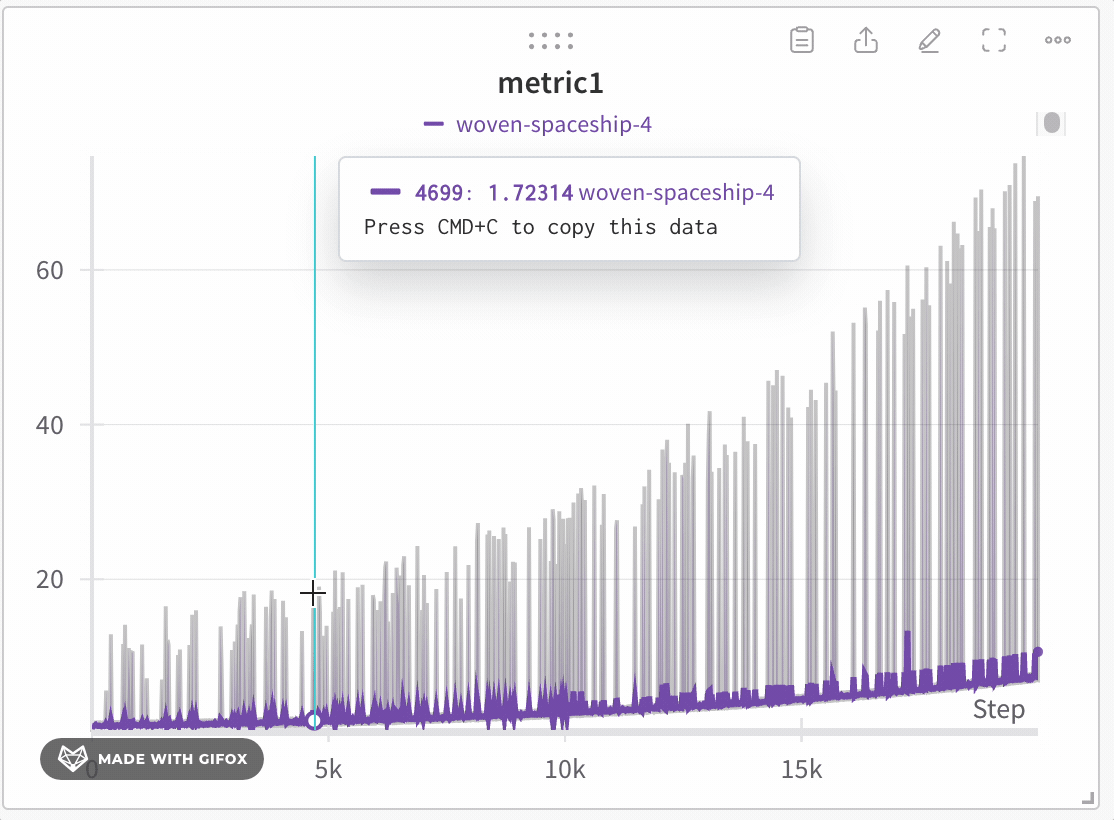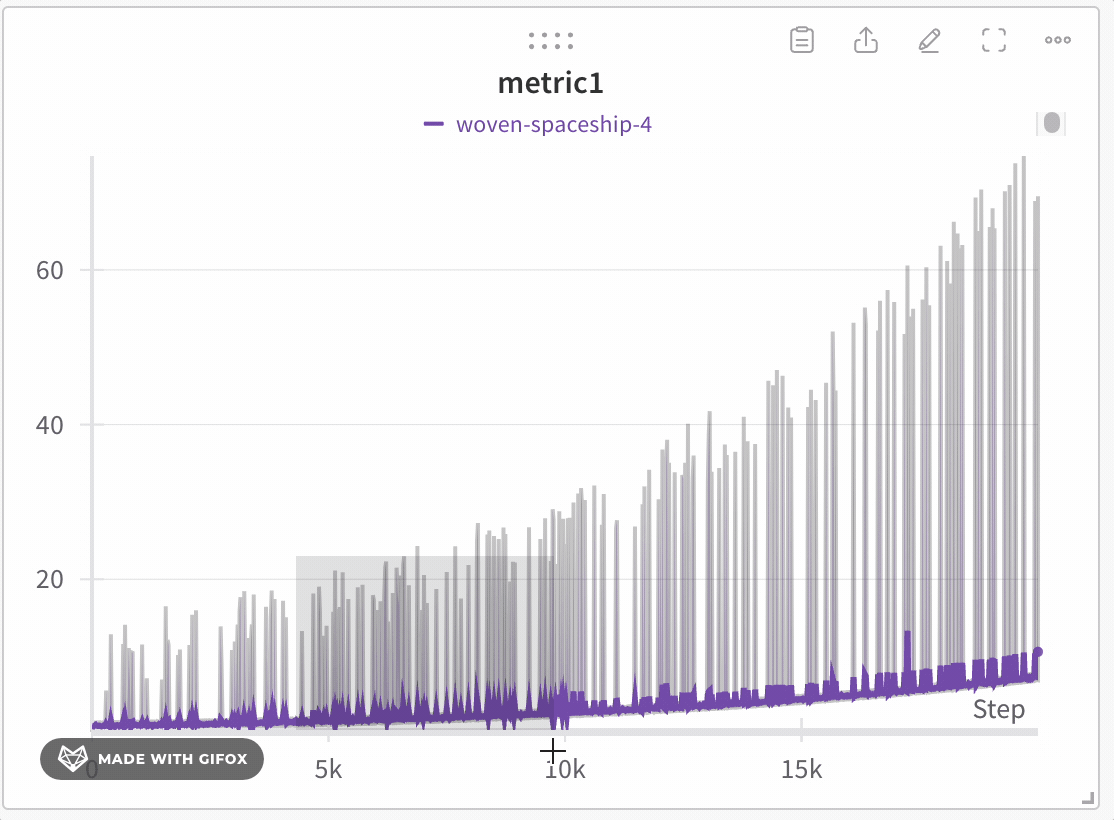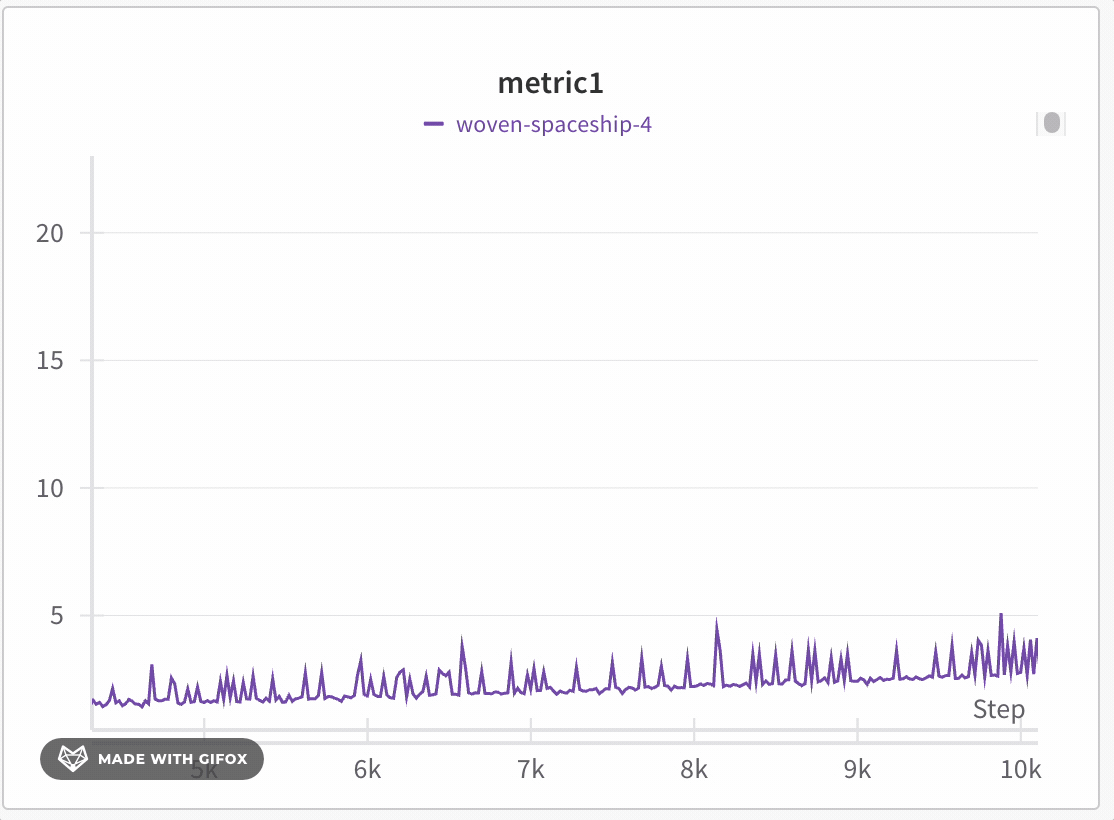 W\&B は動的ビニングを使用して X 軸をバケットに分割します。線 1 本あたりに表示されるポイント数は、チャートのサイズと run の数に応じて変わります。チャートのサイズが小さい場合や run が多い場合は、チャートの応答性を保ちつつより多くの線を表示できるよう、線 1 本あたりのポイント数が減ることがあります。W\&B は各バケットについて次の値を計算します。
* **最小値**: そのバケット内の最小の値 (陰影表示に使用されます) 。
* **最大値**: そのバケット内の最大の値 (陰影表示に使用されます) 。
* **線の値**: そのバケット内の最後の値で、線の描画に使用されます。
W\&B は、データ全体を忠実に表現し、どのプロットにも極値が含まれるようにバケット内の値をプロットします。線は各バケットの最後の値をもとに描画されます。十分にズームインすると、フルフィデリティモードでは追加の集約を行わずにすべてのデータポイントをレンダリングできます。正確なしきい値は、現在のチャートのサイズと run の数によって異なります。
折れ線グラフをズームインするには、次の手順に従います。
1. W\&B プロジェクトにアクセスします。
2. 左側のタブにある **Workspace** アイコンを選択します。
3. オプション: Workspace にラインプロットパネルを追加するか、既存のラインプロットパネルにアクセスします。
4. ズームインしたい領域をクリックしてドラッグし、選択します。
**折れ線グラフのグループ化と式**
折れ線グラフのグループ化を使用すると、W\&B は選択したモードに応じて次の処理を行います。
* **ウィンドウなしサンプリング (グループ化) **: 各 run のポイントを X 軸上で揃えます。複数のポイントが同じ x 値を持つ場合、W\&B はその平均を取ります。それ以外の場合は、個別のポイントとして表示されます。
* **ウィンドウ付きサンプリング (グループ化と式) **: X 軸を 250 個のバケット、または最も長い線のポイント数 (いずれか小さい方) に分割します。W\&B は各バケット内のポイントの平均を取ります。
* **フルフィデリティ (グループ化と式) **: ウィンドウなしサンプリングと似ていますが、パフォーマンスと詳細さのバランスを取るため、run ごとに最大 500 ポイントを取得します。
ランダムサンプリング
ランダムサンプリングは、データの忠実度よりもレンダリング速度を優先する、もう 1 つの集約方法です。チャートのパフォーマンスを向上させたい場合で、極値をすべて保持する必要がないときに使用してください。
ランダムサンプリングでは、ランダムに抽出した 1,500 個のポイントを使用して折れ線グラフをレンダリングします。サンプリングによって一部のポイントが除外されるため、外れ値やスパイクを見つけにくくなります。
ランダムサンプリングは非決定的にサンプリングを行います。そのため、データ内の外れ値やスパイクが除外されることがあり、データの精度が低下します。
ランダムサンプリングを有効にする
デフォルトでは、W\&B はフルフィデリティモードを使用します。ランダムサンプリングを有効にするには、次の手順に従います。
1. W\&B プロジェクトにアクセスします。
2. 左側のタブにある **Workspace** アイコンを選択します。
3. 画面右上の **Add panels** ボタンの左隣にある歯車アイコンを選択します。
4. 表示される UI スライダーで **Line plots** を選択します。
5. **Point aggregation** セクションで **Random sampling** を選択します。
1. W\&B プロジェクトにアクセスします。
2. 左側のタブにある **Workspace** アイコンを選択します。
3. ランダムサンプリングを有効にするラインプロットパネルを選択します。
4. 表示されるモーダルの **Point aggregation method** セクションで **Random sampling** を選択します。
サンプリングされていないデータにアクセスする
ランダムサンプリングによって必要なポイントが除外された場合でも、サンプリングされていない完全なメトリクス履歴にプログラムからアクセスできます。run 中にログされたメトリクスの完全な履歴は、[Public API](/ja/products/wandb/ref/python/public-api/runs) を使用して取得できます。次の例では、特定の run から損失の値を取得して処理する方法を示します。
```python theme={"system"}
# W&B API を初期化します
api = wandb.Api()
run = api.run("l2k2/examples-numpy-boston/i0wt6xua")
# 'Loss' メトリクスの履歴を取得します
history = run.scan_history(keys=["Loss"])
# 履歴から損失値を抽出します
losses = [row["Loss"] for row in history]
```
## Related topics
- [実験結果の表示](/ja/products/wandb/track/workspaces.md)