> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Tracer des threads
> Tracez et analysez les conversations sur plusieurs tours de conversation dans vos applications LLM à l’aide des threads.
Les *Threads* de W\&B Weave vous permettent de suivre et d’analyser les conversations sur plusieurs tours de conversation dans vos applications LLM. Les threads regroupent les appels associés sous un `thread_id` commun : vous pouvez ainsi visualiser des sessions complètes et suivre des métriques au niveau de la conversation sur l’ensemble des tours de conversation. Vous pouvez créer des threads par programmation et les visualiser dans l’interface utilisateur de Weights & Biases.
Pour commencer à utiliser les Threads, procédez comme suit :
1. Familiarisez-vous avec les notions de base des Threads.
* [Cas d’utilisation](#use-cases)
* [Définitions](#definitions)
* [L’expérience dans l’interface utilisateur](#ui-overview)
* [Spécification de l’API](#api-specification)
2. Essayez les exemples de code, qui illustrent des modèles d’utilisation courants et des cas d’utilisation concrets.
* [Exemples d’utilisation de base](#basic-thread-creation)
* [Exemples d’utilisation avancée](#manual-agent-loop-implementation)
Cas d’utilisation
Les threads sont utiles lorsque vous souhaitez organiser et analyser :
* Des conversations sur plusieurs tours de conversation
* Des flux de travail basés sur des sessions
* Toute séquence d’opérations liées
Les threads vous permettent de regrouper les appels par contexte, ce qui permet de mieux comprendre comment votre système réagit au fil de plusieurs étapes. Par exemple, vous pouvez suivre une session utilisateur unique, la chaîne de décisions d’un agent ou une requête complexe qui traverse les couches d’infrastructure et de logique métier.
En structurant votre application avec des threads et des tours de conversation, vous obtenez des métriques plus claires et une meilleure visibilité dans l’interface de Weights & Biases. Plutôt que de voir chaque op de bas niveau, vous pouvez vous concentrer sur les étapes de haut niveau essentielles.
Définitions
Thread
Un *Thread* est un regroupement logique d’Appels liés qui partagent un même contexte conversationnel. Un Thread :
* Possède un `thread_id` unique
* Contient un ou plusieurs *tours de conversation*
* Conserve le contexte d’un Appel à l’autre
* Représente des sessions utilisateur complètes ou des flux d’interaction
Tour de conversation
Un *tour de conversation* (Turn) est une opération de haut niveau au sein d’un Thread, affichée dans l’interface utilisateur sous forme de ligne distincte dans une vue de thread. Chaque tour de conversation :
* Représente une étape logique d’une conversation ou d’un flux de travail
* Est un enfant direct d’un contexte de thread et peut contenir des appels imbriqués de plus bas niveau (non pris en compte dans les statistiques au niveau du thread)
Appel
Un *Appel* désigne toute exécution d’une fonction décorée avec `@weave.op` dans votre application.
* Les *Appels de tour de conversation* sont des opérations de premier niveau qui lancent de nouveaux tours de conversation.
* Les *Appels imbriqués* sont des opérations de niveau inférieur au sein d’un tour de conversation.
Trace
Une *Trace* capture la pile d’appels complète d’une seule opération. Les threads regroupent les traces appartenant à une même conversation ou session logique. Autrement dit, un thread se compose de plusieurs tours de conversation, chacun représentant une étape de la conversation. Pour en savoir plus sur les Traces, consultez l’[aperçu du traçage](/fr/products/wandb/weave/guides/tracking/tracing).
Aperçu de l’interface
Dans la barre latérale du projet Weave, sélectionnez **Threads** pour accéder à la [vue en liste des Threads](#threads-list-view).
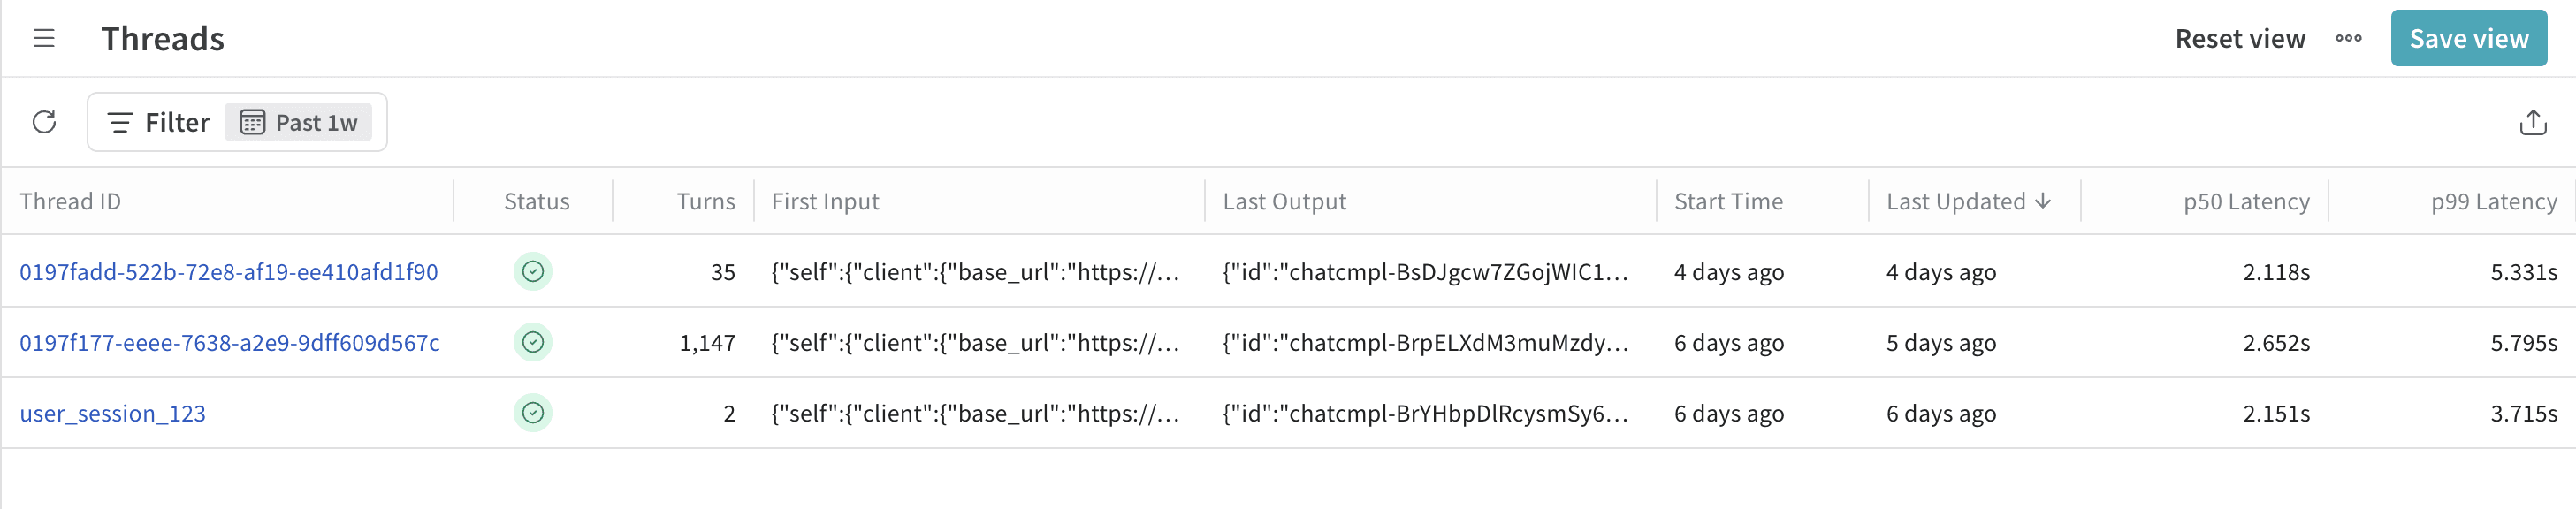
Vue en liste des Threads
* Affiche les threads récents de votre projet.
* Les colonnes indiquent notamment le nombre de tours de conversation, l’heure de début et la date de dernière mise à jour.
* Cliquez sur une ligne pour ouvrir son [volet latéral de détails](#threads-detail-drawer).
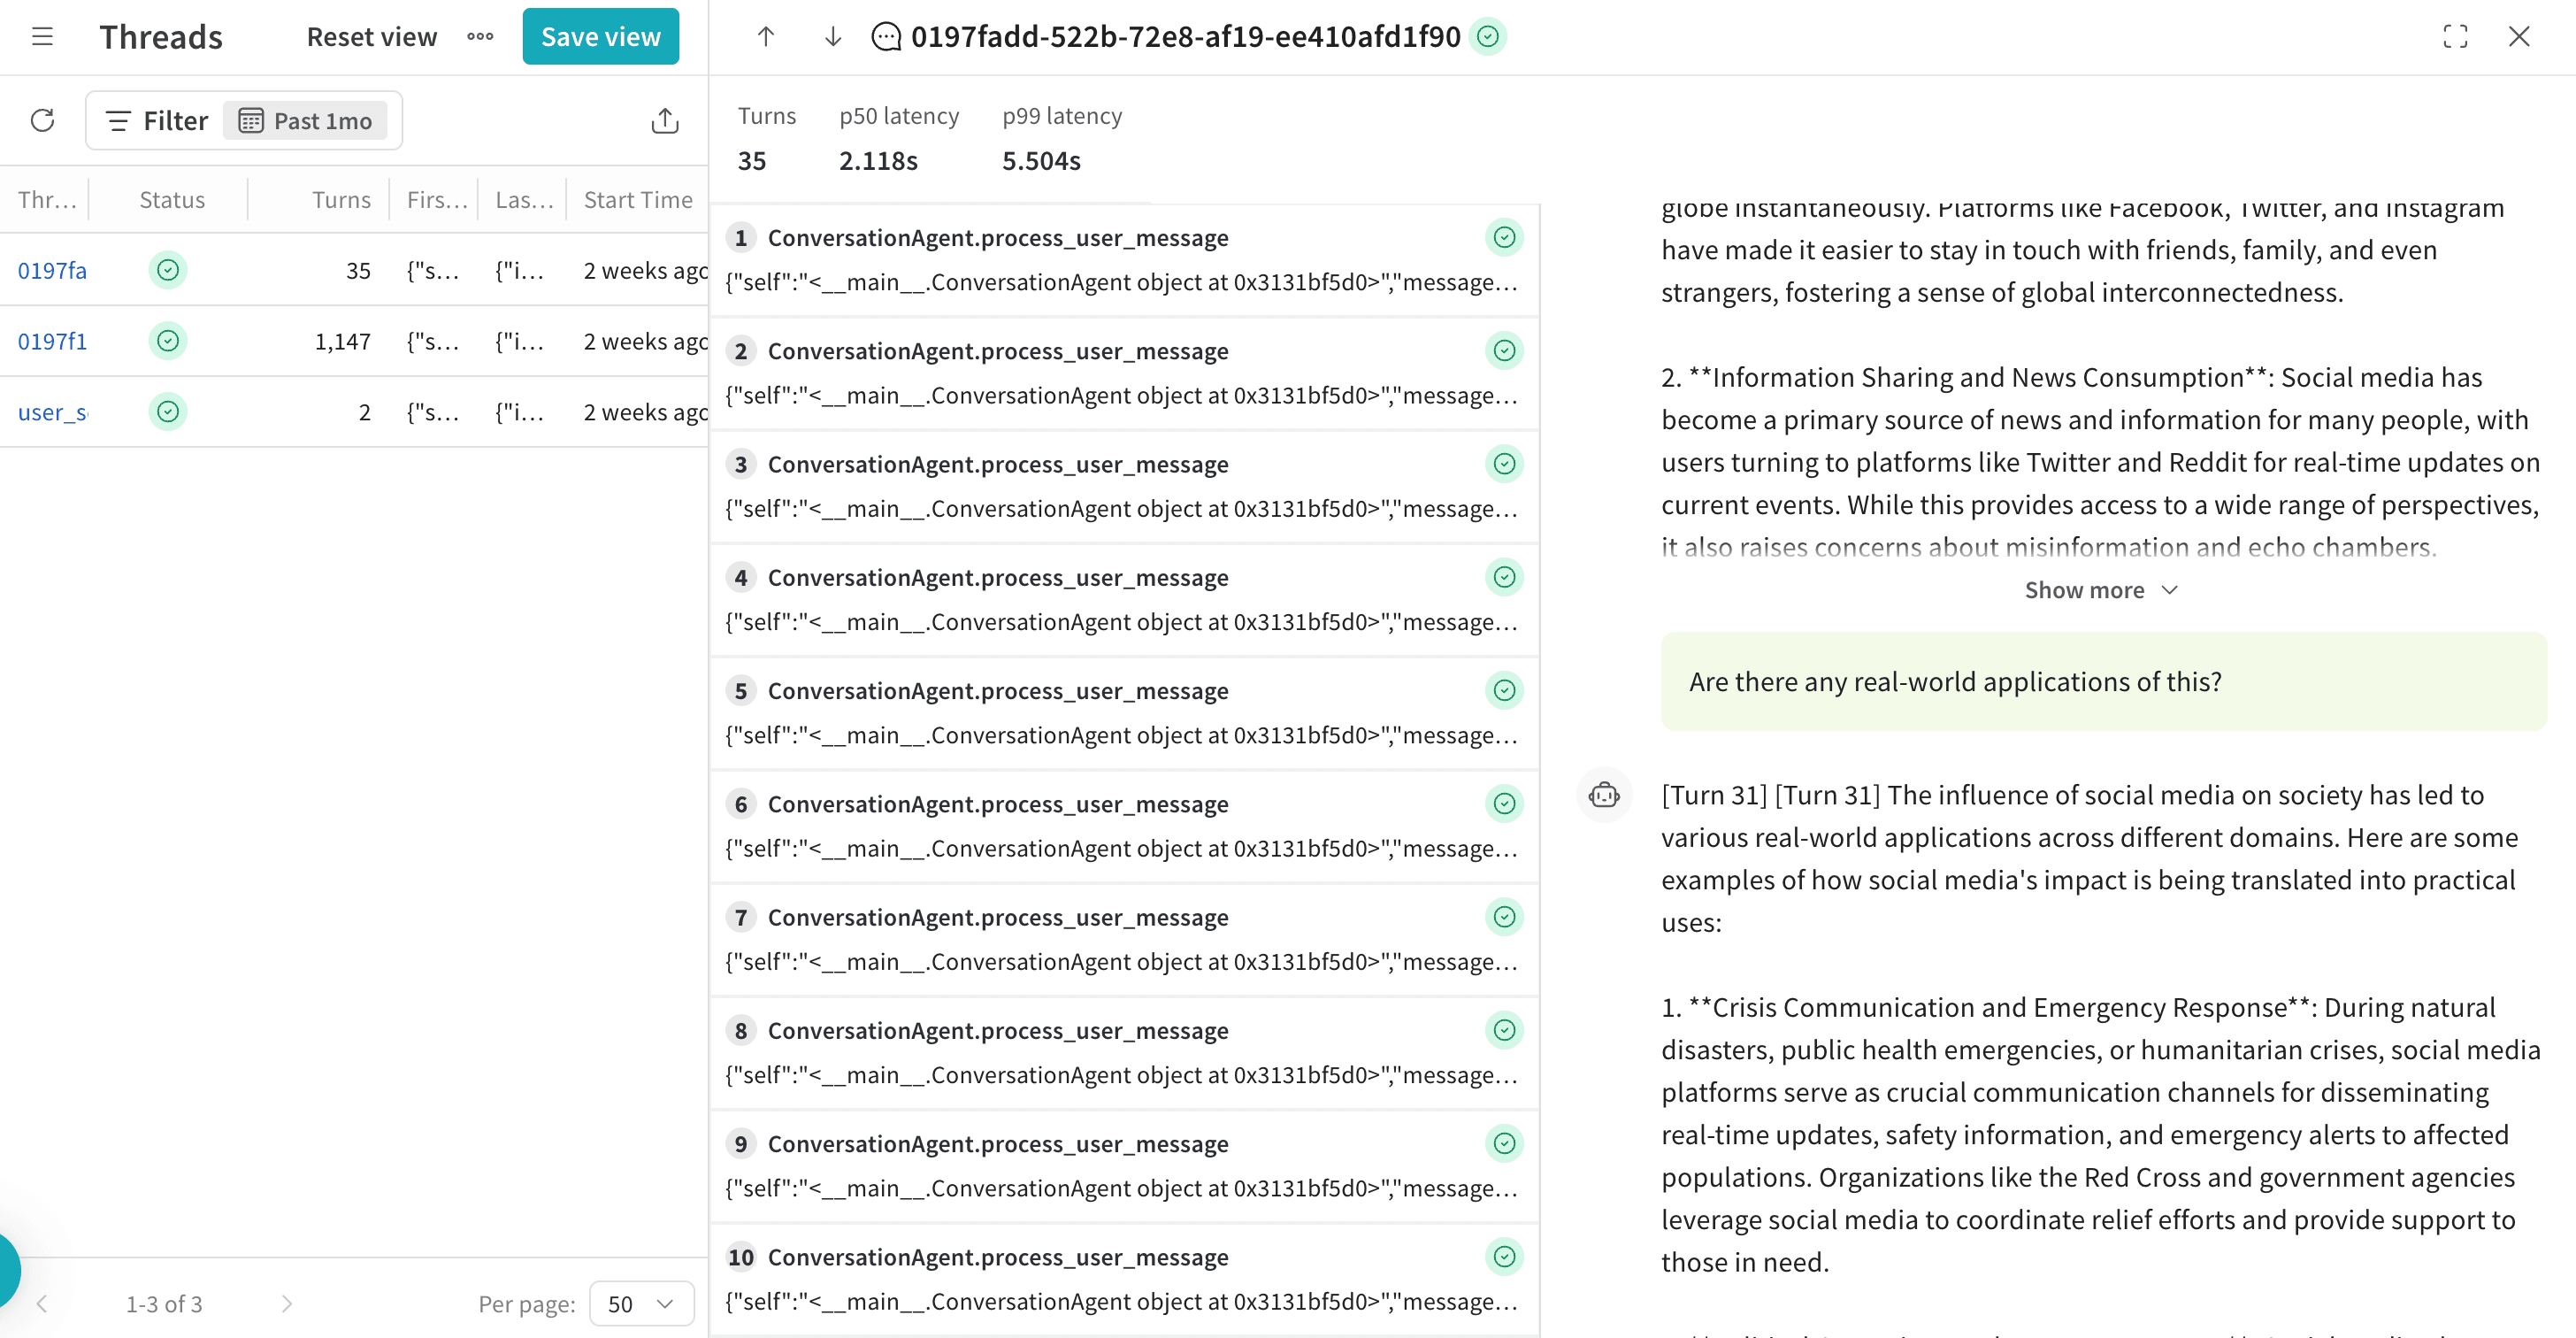
Volet latéral de détails des Threads
* Cliquez sur une ligne pour ouvrir son volet latéral de détails.
* Affiche tous les tours de conversation d'un thread.
* Les tours de conversation sont listés dans l'ordre de leur démarrage (selon leur heure de début, et non selon leur durée ou leur heure de fin).
* Inclut les métadonnées au niveau de l'appel (latence, entrées, sorties).
* Peut afficher le contenu des messages ou des données structurées, s'ils ont été journalisés.
* Pour afficher l'exécution complète d'un tour de conversation, ouvrez-le depuis le volet latéral de détails du thread. Vous pouvez ainsi explorer toutes les opérations imbriquées survenues pendant ce tour de conversation.
* Si un tour de conversation comprend des messages extraits d'appels LLM, ceux-ci apparaissent dans le panneau de chat. Ces messages proviennent généralement d'appels effectués par des intégrations prises en charge (par exemple, `openai.ChatCompletion.create`) et doivent remplir certains critères pour s'afficher. Pour plus d'informations, voir [Comportement de la vue chat](#chat-view-behavior).
Comportement de la vue chat
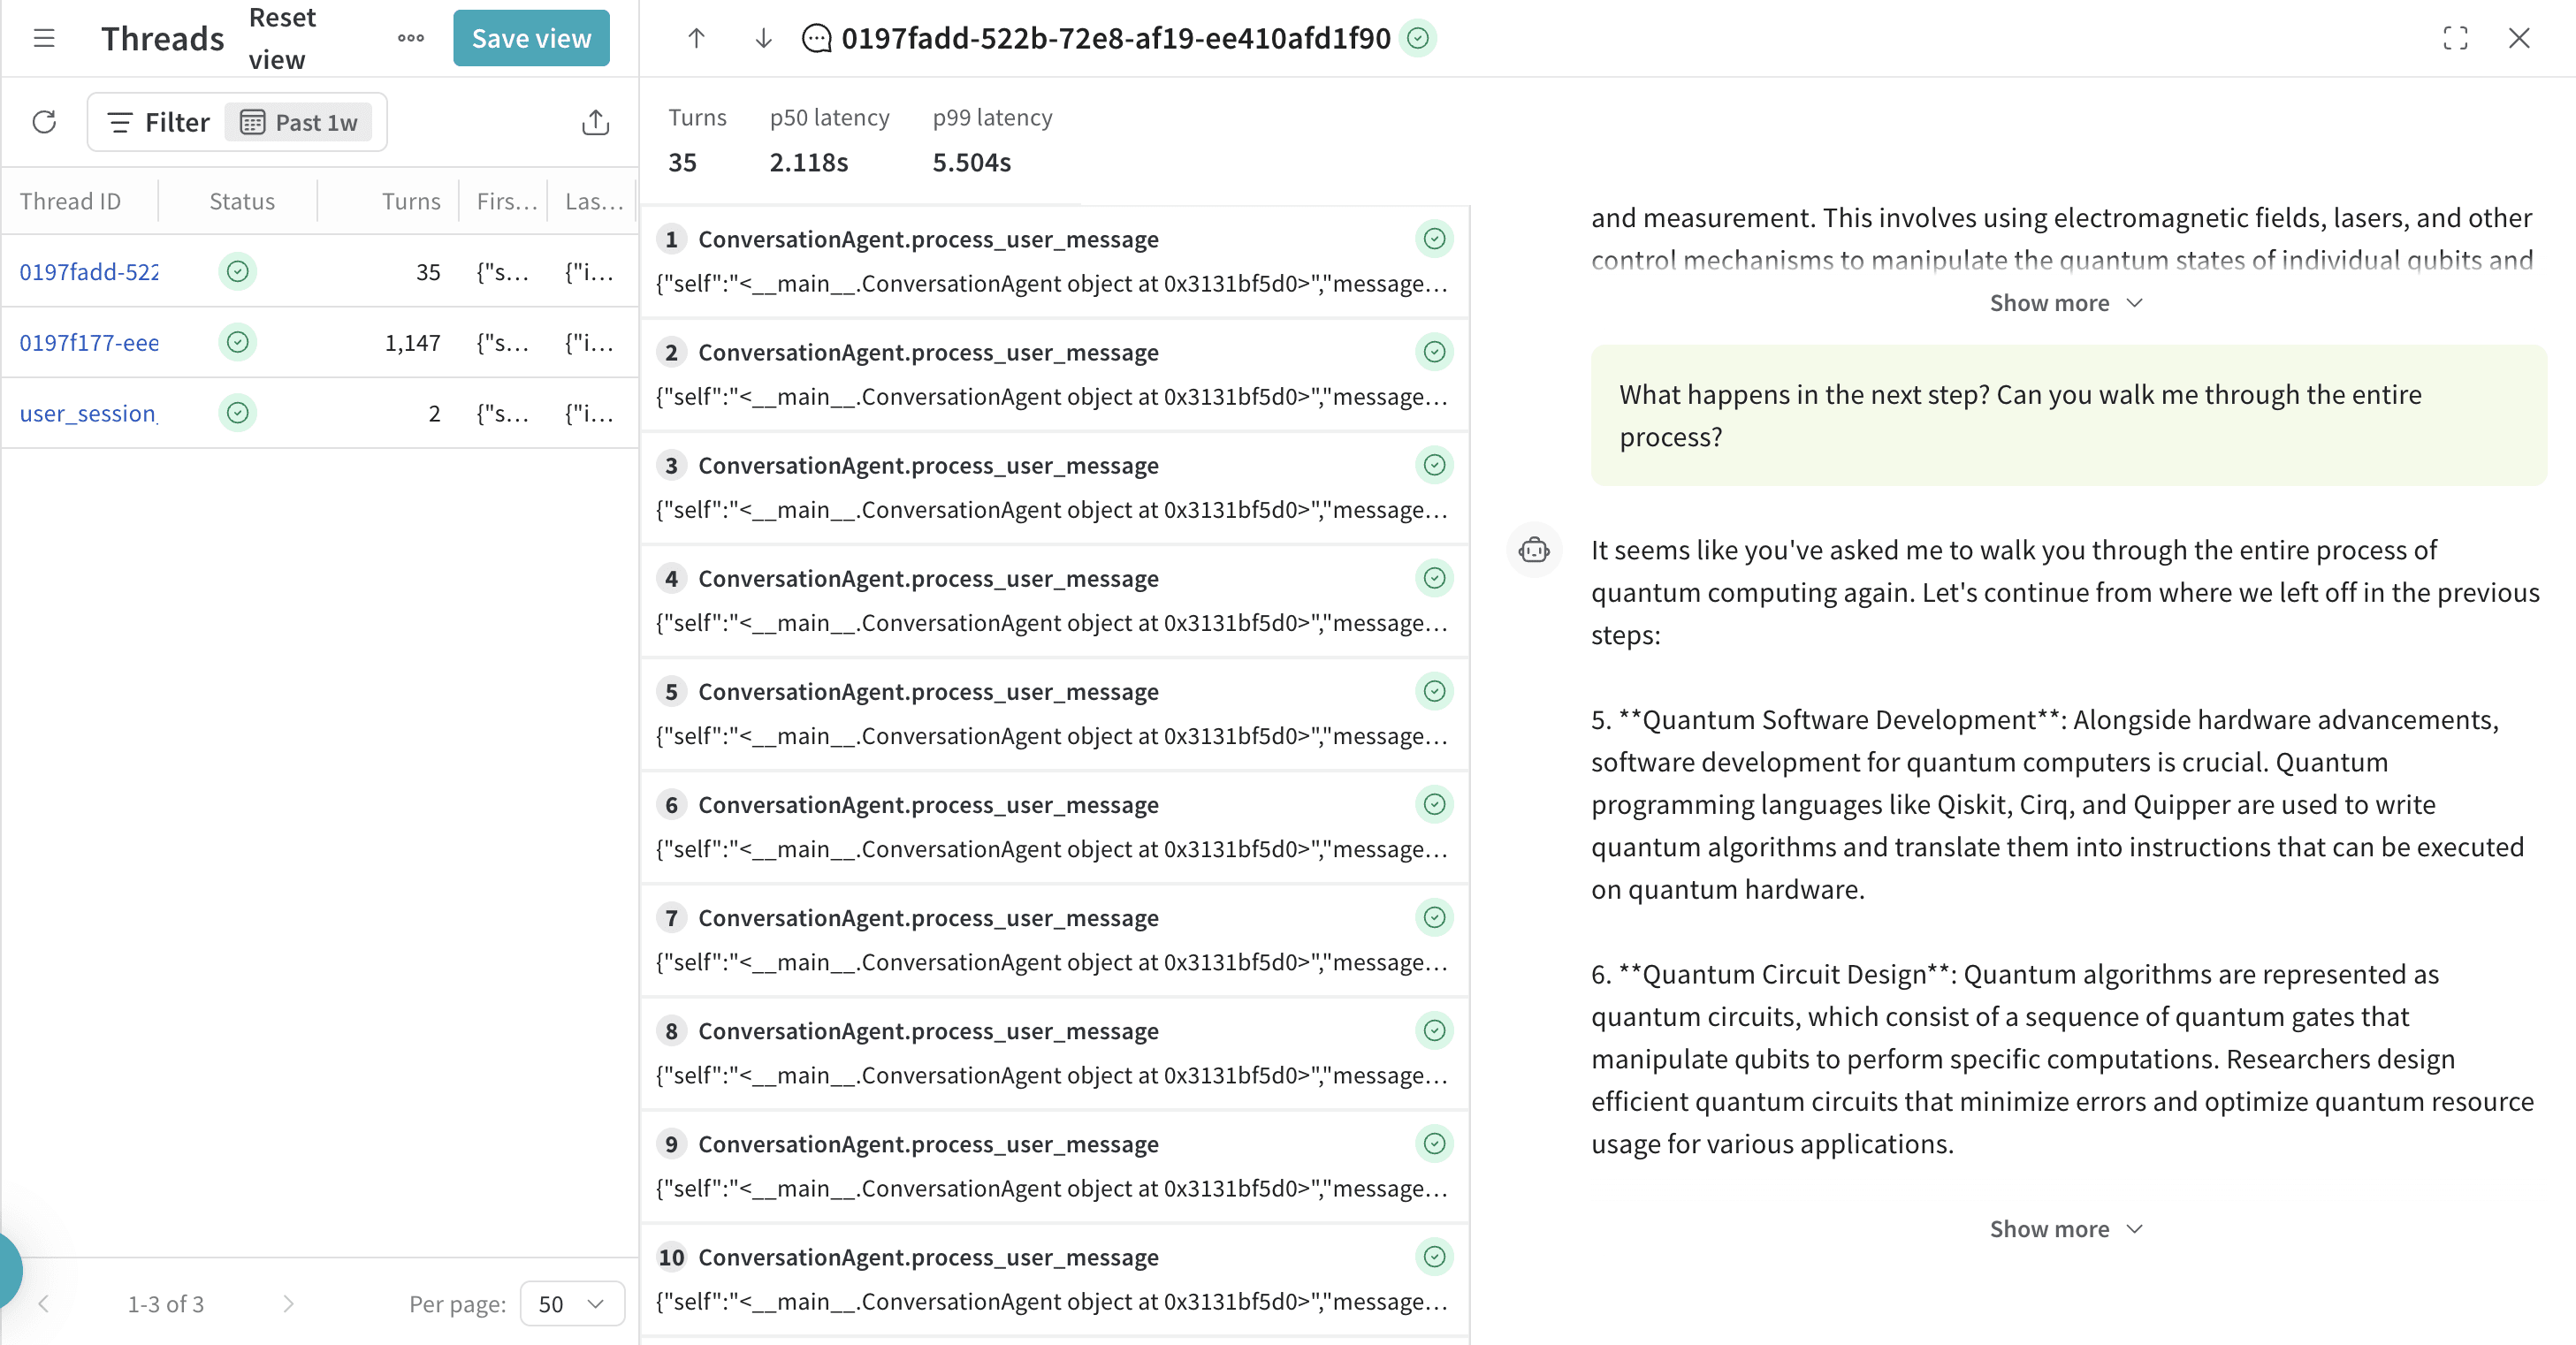
Le panneau de chat affiche les données de messages structurées extraites des appels LLM effectués à chaque tour de conversation. Cette vue offre un rendu de l’interaction sous forme de conversation.
Ce qui constitue un message
Weave extrait les messages des Appels d’un tour de conversation qui correspondent à des interactions directes avec des fournisseurs de LLM (par exemple, l’envoi d’un prompt et la réception d’une réponse). Seuls les Appels qui ne sont pas eux-mêmes imbriqués dans d’autres Appels apparaissent comme des messages. Cela évite de dupliquer les étapes intermédiaires ou la logique interne agrégée.
En règle générale, ce sont les SDK tiers auxquels un patch est appliqué automatiquement qui émettent des messages, par exemple :
* `openai.ChatCompletion.create`
* `anthropic.Anthropic.completion`
Que se passe-t-il en l’absence de messages ?
Si un tour de conversation n’émet aucun message, le panneau de chat affiche une section de messages vide pour ce tour de conversation. Le panneau de chat peut toutefois contenir des messages provenant d’autres tours de conversation du même thread.
Interactions entre les tours de conversation et le chat
* Un clic sur un tour de conversation fait défiler le panneau de chat jusqu’à l’emplacement du message correspondant (comportement d’épinglage).
* Le défilement du panneau de chat met en surbrillance le tour de conversation correspondant dans la liste des tours de conversation.
Naviguer vers la vue de trace et en revenir
Pour ouvrir la trace complète d’un tour de conversation, cliquez dessus.
Un bouton de retour situé dans le coin supérieur gauche permet de revenir à la vue détaillée du thread. Weave ne conserve pas l’état de l’interface (comme la position de défilement) lors de cette transition.
Utilisation du SDK
Les sections suivantes décrivent comment créer et gérer des threads par programmation à l’aide du SDK Weave. Chaque exemple illustre une stratégie différente pour organiser les tours de conversation et les threads dans votre application. Dans la plupart des exemples, vous devez fournir votre propre appel LLM ou le comportement de votre système dans les fonctions de substitution.
* Pour suivre une session ou une conversation, utilisez le gestionnaire de contexte `weave.thread()`.
* Décorez les opérations logiques avec `@weave.op` pour les suivre en tant que tours de conversation ou appels imbriqués.
* Si vous transmettez un `thread_id`, Weave l’utilise pour regrouper toutes les opérations de ce bloc dans le même thread. Si vous omettez le `thread_id`, Weave génère automatiquement un identifiant unique à votre place.
La valeur de retour de `weave.thread()` est un objet `ThreadContext` doté d’une propriété `thread_id`, que vous pouvez journaliser, réutiliser ou transmettre à d’autres systèmes.
Les contextes `weave.thread()` imbriqués démarrent toujours un nouveau thread, sauf si vous réutilisez le même `thread_id`. La fermeture d’un contexte enfant n’interrompt ni n’écrase le contexte parent. Vous pouvez ainsi créer des structures de threads ramifiées ou orchestrer des threads sur plusieurs niveaux, selon la logique de votre application.
Création de base d’un thread
L’exemple de code suivant montre comment utiliser `weave.thread()` pour regrouper une ou plusieurs opérations sous un `thread_id` commun. C’est un moyen simple de commencer à utiliser les Threads dans votre application.
```python lines theme={"system"}
import weave
@weave.op
def say_hello(name: str) -> str:
return f"Hello, {name}!"
# Démarrer un nouveau contexte de thread
with weave.thread() as thread_ctx:
print(f"Thread ID: {thread_ctx.thread_id}")
say_hello("Bill Nye the Science Guy")
```
Implémentation manuelle d’une boucle d’agent
Cet exemple montre comment définir manuellement un agent conversationnel à l’aide des décorateurs `@weave.op` et du gestionnaire de contexte `weave.thread()`. Chaque appel à `process_user_message` crée un nouveau tour de conversation dans le thread. Utilisez ce modèle si vous créez votre propre boucle d’agent et souhaitez garder un contrôle complet sur la gestion du contexte et de l’imbrication.
Utilisez l’ID de thread généré automatiquement pour les interactions de courte durée, ou transmettez un ID de session personnalisé (par exemple `user_session_123`) pour conserver le contexte de thread d’une session à l’autre.
```python lines theme={"system"}
import weave
class ConversationAgent:
@weave.op
def process_user_message(self, message: str) -> str:
"""
TURN-LEVEL OPERATION: This represents one conversation turn.
Only this function will be counted in thread statistics.
"""
# Stocker le message de l’utilisateur
# Générer la réponse de l’IA au moyen d’appels imbriqués
response = self._generate_response(message)
# Stocker la réponse de l’assistant
return response
@weave.op
def _generate_response(self, message: str) -> str:
"""NESTED CALL: Implementation details, not counted in thread stats."""
context = self._retrieve_context(message) # Autre appel imbriqué
intent = self._classify_intent(message) # Autre appel imbriqué
response = self._call_llm(message, context) # Appel LLM (imbriqué)
return self._format_response(response) # Dernier appel imbriqué
@weave.op
def _retrieve_context(self, message: str) -> str:
# Recherche dans une base de données vectorielle, requête sur une base de connaissances, etc.
return "retrieved_context"
@weave.op
def _classify_intent(self, message: str) -> str:
# Logique de classification de l’intention
return "general_inquiry"
@weave.op
def _call_llm(self, message: str, context: str) -> str:
# Appel d’API OpenAI, Anthropic, etc.
return "llm_response"
@weave.op
def _format_response(self, response: str) -> str:
# Logique de mise en forme de la réponse
return f"Formatted: {response}"
# Utilisation : contexte de thread établi automatiquement
agent = ConversationAgent()
# Établir le contexte de thread : chaque appel à process_user_message devient un tour de conversation
with weave.thread() as thread_ctx: # Génère automatiquement thread_id
print(f"Thread ID: {thread_ctx.thread_id}")
# Chaque appel à process_user_message crée 1 tour de conversation + plusieurs appels imbriqués
agent.process_user_message("Hello, help with setup") # Tour 1
agent.process_user_message("What languages do you recommend?") # Tour 2
agent.process_user_message("Explain Python vs JavaScript") # Tour 3
# Résultat : un thread de 3 tours de conversation, soit environ 15 à 20 appels au total (appels imbriqués compris)
# Variante : utiliser un thread_id explicite pour le suivi de session
session_id = "user_session_123"
with weave.thread(session_id) as thread_ctx:
print(f"Session Thread ID: {thread_ctx.thread_id}") # "user_session_123"
agent.process_user_message("Continue our previous conversation") # Tour 1 de cette session
agent.process_user_message("Can you summarize what we discussed?") # Tour 2 de cette session
```
Agent manuel avec une profondeur d’appels déséquilibrée
Cet exemple montre que les tours de conversation peuvent être définis à différentes profondeurs de la pile d’appels, selon la manière dont le contexte de thread est appliqué. Il utilise deux fournisseurs (OpenAI et Anthropic), chacun avec une profondeur d’appels différente avant d’atteindre la limite du tour de conversation.
Tous les tours de conversation partagent le même `thread_id`, mais la limite du tour de conversation se situe à des niveaux différents de la pile selon la logique propre à chaque fournisseur. Cette approche est utile lorsque les appels doivent être tracés différemment d’un backend à l’autre, tout en restant regroupés dans le même thread.
```python lines theme={"system"}
import weave
import random
import asyncio
class OpenAIProvider:
"""OpenAI branch: 2 levels deep call chain to turn boundary"""
@weave.op
def route_to_openai(self, user_input: str, thread_id: str) -> str:
"""Level 1: Route and prepare OpenAI request"""
# Validation des entrées, logique d’acheminement, prétraitement de base
print(f" L1: Routing to OpenAI for: {user_input}")
# Limite du tour de conversation : encapsuler avec le contexte de thread
with weave.thread(thread_id):
# Appeler directement le niveau 2, ce qui crée la profondeur de la chaîne d’appels
return self.execute_openai_call(user_input)
@weave.op
def execute_openai_call(self, user_input: str) -> str:
"""Level 2: TURN BOUNDARY - Execute OpenAI API call"""
print(f" L2: Executing OpenAI API call")
response = f"OpenAI GPT-4 response: {user_input}"
return response
class AnthropicProvider:
"""Anthropic branch: 3 levels deep call chain to turn boundary"""
@weave.op
def route_to_anthropic(self, user_input: str, thread_id: str) -> str:
"""Level 1: Route and prepare Anthropic request"""
# Validation des entrées, logique d’acheminement, sélection du fournisseur
print(f" L1: Routing to Anthropic for: {user_input}")
# Appeler le niveau 2, ce qui crée la profondeur de la chaîne d’appels
return self.authenticate_anthropic(user_input, thread_id)
@weave.op
def authenticate_anthropic(self, user_input: str, thread_id: str) -> str:
"""Level 2: Handle Anthropic authentication and setup"""
print(f" L2: Authenticating with Anthropic")
# Authentification, limitation de débit, gestion de session
auth_token = "anthropic_key_xyz_authenticated"
# Limite du tour de conversation : encapsuler avec le contexte de thread au niveau 3
with weave.thread(thread_id):
# Appeler le niveau 3, ce qui imbrique davantage la chaîne d’appels
return self.execute_anthropic_call(user_input, auth_token)
@weave.op
def execute_anthropic_call(self, user_input: str, auth_token: str) -> str:
"""Level 3: TURN BOUNDARY - Execute Anthropic API call"""
print(f" L3: Executing Anthropic API call with auth")
response = f"Anthropic Claude response (auth: {auth_token[:15]}...): {user_input}"
return response
class MultiProviderAgent:
"""Main agent that routes between providers with different call chain depths"""
def __init__(self):
self.openai_provider = OpenAIProvider()
self.anthropic_provider = AnthropicProvider()
def handle_conversation_turn(self, user_input: str, thread_id: str) -> str:
"""
Route to different providers with imbalanced call chain depths.
Thread context is applied at different nesting levels in each chain.
"""
# Choisir un fournisseur au hasard pour la démonstration
use_openai = random.choice([True, False])
if use_openai:
print(f"Choosing OpenAI (2-level call chain)")
# OpenAI : niveau 1 → niveau 2 (limite du tour de conversation)
response = self.openai_provider.route_to_openai(user_input, thread_id)
return f"[OpenAI Branch] {response}"
else:
print(f"Choosing Anthropic (3-level call chain)")
# Anthropic : niveau 1 → niveau 2 → niveau 3 (limite du tour de conversation)
response = self.anthropic_provider.route_to_anthropic(user_input, thread_id)
return f"[Anthropic Branch] {response}"
async def main():
agent = MultiProviderAgent()
conversation_id = "nested_depth_conversation_999"
# Conversation sur plusieurs tours avec des profondeurs de chaîne d’appels différentes
conversation_turns = [
"What's deep learning?",
"Explain neural network backpropagation",
"How do attention mechanisms work?",
"What's the transformer architecture?",
"Compare CNNs vs RNNs"
]
print(f"Starting conversation: {conversation_id}")
for i, user_input in enumerate(conversation_turns, 1):
print(f"\\n--- Turn {i} ---")
print(f"User: {user_input}")
# Le même thread_id est utilisé à différentes profondeurs de chaîne d’appels
response = agent.handle_conversation_turn(user_input, conversation_id)
print(f"Agent: {response}")
if __name__ == "__main__":
asyncio.run(main())
# Résultat attendu : un seul thread avec 5 tours de conversation
# - Tours OpenAI : contexte de thread au niveau 2 de la chaîne d’appels
# Pile d’appels : route_to_openai() → execute_openai_call() ← contexte de thread ici
# - Tours Anthropic : contexte de thread au niveau 3 de la chaîne d’appels
# Pile d’appels : route_to_anthropic() → authenticate_anthropic() → execute_anthropic_call() ← contexte de thread ici
# - Tous les tours partagent le thread_id : "nested_depth_conversation_999"
# - Limites des tours marquées à différentes profondeurs de la pile d’appels
# - Les opérations intermédiaires de la chaîne d’appels sont suivies comme des appels imbriqués, et non comme des tours
```
Reprendre une session précédente
Il arrive que vous deviez reprendre une session déjà commencée et continuer à ajouter des appels au même thread. Dans d’autres cas, il vous sera impossible de reprendre une session existante et vous devrez démarrer un nouveau thread.
Lorsque vous implémentez une reprise facultative de thread, ne laissez jamais le paramètre `thread_id` à `None`, car cela désactive le regroupement par thread. Fournissez toujours un ID de thread valide. Pour créer un nouveau thread, générez un identifiant unique à l’aide d’une fonction telle que `generate_id()`.
Lorsqu’aucun `thread_id` n’est spécifié, l’implémentation interne de Weave génère automatiquement un UUID v7 aléatoire. Vous pouvez reproduire ce comportement dans votre propre fonction `generate_id()` ou utiliser n’importe quelle chaîne unique de votre choix.
```python lines theme={"system"}
import weave
import uuidv7
import argparse
def generate_id():
"""Generate a unique thread ID using UUID v7."""
return str(uuidv7.uuidv7())
@weave.op
def load_history(session_id):
"""Load conversation history for the given session."""
# Votre implémentation ici
return []
# Analyser les arguments de la ligne de commande pour reprendre une session
parser = argparse.ArgumentParser()
parser.add_argument("--session-id", help="Existing session ID to resume")
args = parser.parse_args()
# Déterminer l’ID du thread : reprendre la session existante ou en créer une nouvelle
if args.session_id:
thread_id = args.session_id
print(f"Resuming session: {thread_id}")
else:
thread_id = generate_id()
print(f"Starting new session: {thread_id}")
# Établir le contexte de thread pour le suivi des appels
with weave.thread(thread_id) as thread_ctx:
# Charger ou initialiser l’historique de la conversation
history = load_history(thread_id)
print(f"Active thread ID: {thread_ctx.thread_id}")
# Votre logique applicative ici.
```
Threads imbriqués
Cet exemple montre comment structurer des applications complexes à l’aide de plusieurs threads coordonnés.
Chaque couche s’exécute dans son propre contexte de thread, ce qui permet une séparation nette des responsabilités. Le thread de l’application parente coordonne ces couches en définissant les ID de thread au moyen d’un `ThreadContext` partagé. Utilisez ce modèle lorsque vous souhaitez analyser ou surveiller séparément différentes parties du système, tout en les rattachant à une session commune.
```python lines theme={"system"}
import weave
from contextlib import contextmanager
from typing import Dict
# Contexte de thread global pour coordonner les threads imbriqués
class ThreadContext:
def __init__(self):
self.app_thread_id = None
self.infra_thread_id = None
self.logic_thread_id = None
def setup_for_request(self, request_id: str):
self.app_thread_id = f"app_{request_id}"
self.infra_thread_id = f"{self.app_thread_id}_infra"
self.logic_thread_id = f"{self.app_thread_id}_logic"
# Instance globale
thread_ctx = ThreadContext()
class InfrastructureLayer:
"""Handles all infrastructure operations in a dedicated thread"""
@weave.op
def authenticate_user(self, user_id: str) -> Dict:
# Logique d’authentification...
return {"user_id": user_id, "authenticated": True}
@weave.op
def call_payment_gateway(self, amount: float) -> Dict:
# Traitement du paiement...
return {"status": "approved", "amount": amount}
@weave.op
def update_inventory(self, product_id: str, quantity: int) -> Dict:
# Gestion des stocks...
return {"product_id": product_id, "updated": True}
def execute_operations(self, user_id: str, order_data: Dict) -> Dict:
"""Execute all infrastructure operations in dedicated thread context"""
with weave.thread(thread_ctx.infra_thread_id):
auth_result = self.authenticate_user(user_id)
payment_result = self.call_payment_gateway(order_data["amount"])
inventory_result = self.update_inventory(order_data["product_id"], order_data["quantity"])
return {
"auth": auth_result,
"payment": payment_result,
"inventory": inventory_result
}
class BusinessLogicLayer:
"""Handles business logic in a dedicated thread"""
@weave.op
def validate_order(self, order_data: Dict) -> Dict:
# Logique de validation...
return {"valid": True}
@weave.op
def calculate_pricing(self, order_data: Dict) -> Dict:
# Calculs de tarification...
return {"total": order_data["amount"], "tax": order_data["amount"] * 0.08}
@weave.op
def apply_business_rules(self, order_data: Dict) -> Dict:
# Règles métier...
return {"rules_applied": ["standard_processing"], "priority": "normal"}
def execute_logic(self, order_data: Dict) -> Dict:
"""Execute all business logic in dedicated thread context"""
with weave.thread(thread_ctx.logic_thread_id):
validation = self.validate_order(order_data)
pricing = self.calculate_pricing(order_data)
rules = self.apply_business_rules(order_data)
return {"validation": validation, "pricing": pricing, "rules": rules}
class OrderProcessingApp:
"""Main application orchestrator"""
def __init__(self):
self.infra = InfrastructureLayer()
self.business = BusinessLogicLayer()
@weave.op
def process_order(self, user_id: str, order_data: Dict) -> Dict:
"""Main order processing - becomes a turn in the app thread"""
# Exécuter les opérations imbriquées dans leurs threads dédiés
infra_results = self.infra.execute_operations(user_id, order_data)
logic_results = self.business.execute_logic(order_data)
# Orchestration finale
return {
"order_id": f"order_12345",
"status": "completed",
"infra_results": infra_results,
"logic_results": logic_results
}
# Utilisation avec coordination via un contexte de thread global
def handle_order_request(request_id: str, user_id: str, order_data: Dict):
# Configurer le contexte de thread pour cette requête
thread_ctx.setup_for_request(request_id)
# Exécuter dans le contexte de thread de l’application
with weave.thread(thread_ctx.app_thread_id):
app = OrderProcessingApp()
result = app.process_order(user_id, order_data)
return result
# Exemple d’utilisation
order_result = handle_order_request(
request_id="req_789",
user_id="user_001",
order_data={"product_id": "laptop", "quantity": 1, "amount": 1299.99}
)
# Structure de threads attendue :
#
# App Thread: app_req_789
# └── Turn: process_order() ← Orchestration principale
#
# Infra Thread: app_req_789_infra
# ├── Turn: authenticate_user() ← Opération d’infrastructure 1
# ├── Turn: call_payment_gateway() ← Opération d’infrastructure 2
# └── Turn: update_inventory() ← Opération d’infrastructure 3
#
# Logic Thread: app_req_789_logic
# ├── Turn: validate_order() ← Opération de logique métier 1
# ├── Turn: calculate_pricing() ← Opération de logique métier 2
# └── Turn: apply_business_rules() ← Opération de logique métier 3
#
# Avantages :
# - Séparation claire des responsabilités entre les threads
# - Aucune propagation des ID de thread de fonction en fonction via les paramètres
# - Surveillance indépendante des couches app/infra/logique
# - Coordination globale via le contexte de thread
```
Spécification de l’API
Les sections suivantes décrivent le point de terminaison de requête des Threads, ses schémas de requête et de réponse, ainsi que les modèles de requête courants que vous pouvez utiliser pour récupérer les données des threads par programmation.
Point de terminaison
Point de terminaison : `POST /threads/query`
Schéma de la requête
```python lines theme={"system"}
class ThreadsQueryReq:
project_id: str
limit: Optional[int] = None
offset: Optional[int] = None
sort_by: Optional[list[SortBy]] = None # Champs pris en charge : thread_id, turn_count, start_time, last_updated
sortable_datetime_after: Optional[datetime] = None # Filtre les threads via l'optimisation par granules
sortable_datetime_before: Optional[datetime] = None # Filtre les threads via l'optimisation par granules
```
Schéma de réponse
```python lines theme={"system"}
class ThreadSchema:
thread_id: str # Identifiant unique du thread
turn_count: int # Nombre d’appels de tour de conversation dans ce thread
start_time: datetime # Heure de début la plus ancienne parmi les appels de tour de conversation de ce thread
last_updated: datetime # Heure de fin la plus récente parmi les appels de tour de conversation de ce thread
class ThreadsQueryRes:
threads: List[ThreadSchema]
```
Interroger les threads actifs récents
Cet exemple récupère les 50 derniers threads mis à jour. Remplacez `my-project` par l’ID de votre projet.
```python lines theme={"system"}
# Obtenir les threads actifs le plus récemment
response = client.threads_query(ThreadsQueryReq(
project_id="my-project",
sort_by=[SortBy(field="last_updated", direction="desc")],
limit=50
))
for thread in response.threads:
print(f"Thread {thread.thread_id}: {thread.turn_count} turns, last active {thread.last_updated}")
```
Interroger les threads par niveau d’activité
Cet exemple récupère les 20 threads les plus actifs, triés par nombre de tours de conversation.
```python lines theme={"system"}
# Obtenir les threads les plus actifs (ceux qui comptent le plus de tours de conversation)
response = client.threads_query(ThreadsQueryReq(
project_id="my-project",
sort_by=[SortBy(field="turn_count", direction="desc")],
limit=20
))
```
Interroger uniquement les threads récents
Cet exemple renvoie les threads démarrés au cours des dernières 24 heures. Vous pouvez modifier la fenêtre temporelle en ajustant la valeur de `days` dans `timedelta`.
```python lines theme={"system"}
from datetime import datetime, timedelta
# Obtenir les threads démarrés au cours des dernières 24 heures
yesterday = datetime.now() - timedelta(days=1)
response = client.threads_query(ThreadsQueryReq(
project_id="my-project",
sortable_datetime_after=yesterday,
sort_by=[SortBy(field="start_time", direction="desc")]
))
```