> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Comparer les performances des modèles avec le playground d’évaluation
> Comparez et évaluez les performances des modèles sans code grâce au playground d’évaluation de Weave, avec des datasets personnalisés et des juges LLM.
Le playground d’évaluation vous permet d’accéder à des modèles existants et de comparer leurs performances à l’aide de datasets d’évaluation et de juges LLM chargés de la notation. Vous pouvez commencer à expérimenter et à comparer vos modèles sans écrire la moindre ligne de code. Vous pouvez également enregistrer les modèles, les évaluateurs et les datasets créés dans le playground afin de les faire évoluer et de les déployer par la suite.
Par exemple, vous pouvez ouvrir le playground d’évaluation, ajouter deux modèles que vous avez déjà enregistrés, puis évaluer leurs performances sur un dataset d’évaluation de type questions-réponses, nouveau ou existant. Vous pouvez ensuite ajouter un troisième modèle dans l’interface, lui associer des prompts système et lancer une nouvelle évaluation sur les trois modèles pour comparer leurs performances.
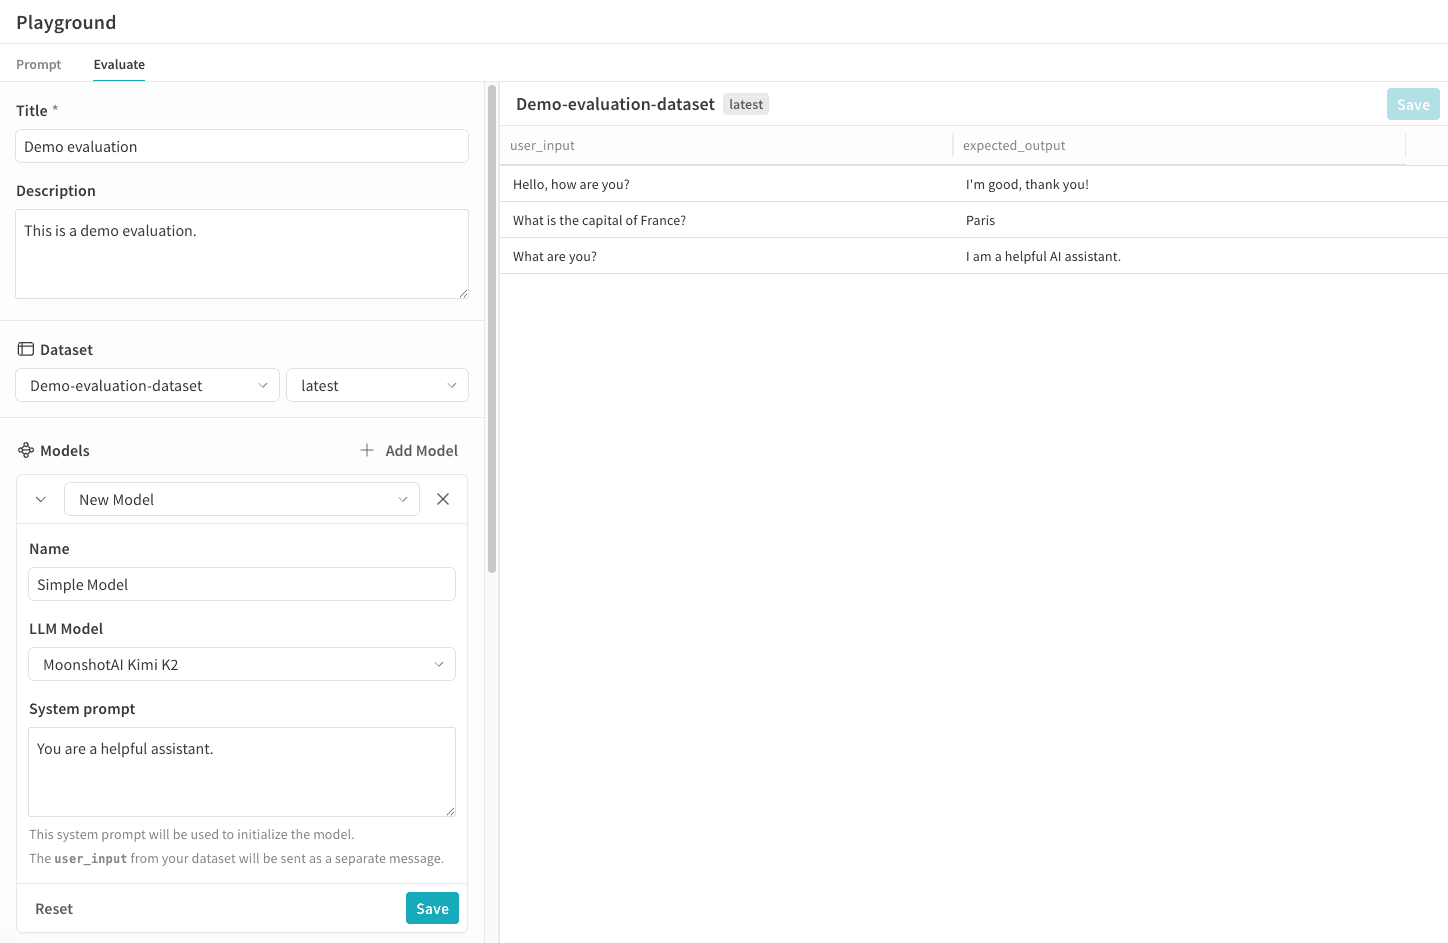
Configurer une évaluation dans le playground
Les sections suivantes expliquent comment ouvrir le playground d’évaluation, choisir un point de départ pour votre évaluation et configurer le dataset, les modèles et les évaluateurs.
Pour configurer une évaluation dans le playground d’évaluation :
1. Ouvrez [l’interface utilisateur de Weights & Biases](https://forge.coreweave.com/wandb/wandb/quickstart_playground/weave/playground), puis ouvrez le projet dans lequel vous souhaitez effectuer l’évaluation. La page Traces s’affiche.
2. Depuis la page Traces, cliquez sur l’icône **Playground** dans le menu de gauche, puis sélectionnez l’onglet **Evaluate** sur la page Playground. Sur la page Evaluate, vous avez deux possibilités :
* **Load a demo example** : charge une configuration prédéfinie qui évalue le modèle MoonshotAI Kimi K2 par rapport à la sortie attendue et utilise un juge LLM pour déterminer l’exactitude de ses réponses. Vous pouvez utiliser cette configuration pour vous familiariser avec l’interface.
* **Start from scratch** : charge une configuration vierge que vous pouvez compléter.
3. Si vous avez sélectionné **Start from scratch**, saisissez un titre et une description explicites pour votre évaluation dans les champs **Title** et **Description**.
Suivez les instructions des sections suivantes pour configurer vos datasets, modèles et évaluateurs.
Ajouter un dataset
Les [Datasets](/fr/products/wandb/weave/guides/core-types/datasets) sont des collections organisées d’exemples d’entrées utilisateur et des réponses que vous attendez des modèles. Pendant l’évaluation, le playground transmet chaque entrée de test à votre modèle, recueille la sortie, puis la note selon une métrique que vous avez sélectionnée, comme l’exactitude. Vous pouvez créer un dataset dans l’interface utilisateur, ajouter un dataset déjà enregistré dans votre projet ou téléverser un nouveau dataset.
Vous pouvez téléverser des datasets aux formats suivants :
* `.csv`
* `.tsv`
* `.json`
* `.jsonl`
Pour plus d’informations sur la mise en forme des datasets et leur enregistrement dans Weave, consultez la documentation Datasets.
Pour ajouter un dataset dans la section **Dataset** :
1. Cliquez sur le menu déroulant, puis sélectionnez l’une des options suivantes :
* **Start from scratch** pour créer un nouveau dataset dans l’interface utilisateur.
* **Upload a file** pour téléverser un dataset depuis votre machine locale.
* Un dataset déjà enregistré dans votre projet.
2. Facultatif : cliquez sur **Save** pour enregistrer le dataset dans votre projet afin de le réutiliser ultérieurement.
Une fois l’option sélectionnée, le dataset s’affiche dans le volet droit de l’interface utilisateur, et vous pouvez modifier chaque champ en cliquant dessus. Vous pouvez également ajouter des lignes au dataset en cliquant sur **Add row**.
Seuls les nouveaux datasets peuvent être modifiés dans l’interface utilisateur.
Veillez également à nommer les colonnes de votre dataset `user_input` et `expected_output` afin que les évaluateurs puissent accéder aux données.
Ajouter un modèle
Dans le contexte de Weave, les [modèles](/fr/products/wandb/weave/guides/core-types/models) associent un modèle d’IA (tel que GPT) et l’environnement (ici, le prompt système) qui définit le comportement du modèle pendant l’évaluation. Vous pouvez sélectionner des modèles existants dans votre projet ou en créer de nouveaux à évaluer. Vous pouvez également ajouter plusieurs modèles à la fois pour les évaluer simultanément avec le même dataset et le même évaluateur. **Seuls les modèles créés avec la fonctionnalité playground peuvent être utilisés.**
Pour ajouter un modèle dans la section **Models** du playground d’évaluation :
1. Cliquez sur **Add Model**, puis sélectionnez **New Model** ou un modèle existant dans le menu déroulant.
2. Si vous avez sélectionné **New Model**, configurez les champs suivants :
* **Name** : attribuez un nom descriptif à votre nouveau modèle.
* **LLM Model** : sélectionnez le modèle de fondation sur lequel reposera votre nouveau modèle, par exemple GPT-4 d’OpenAI. Vous pouvez choisir parmi les modèles de fondation auxquels vous avez déjà configuré l’accès, ou ajouter l’accès à un modèle de fondation en sélectionnant **Add AI provider**, puis un modèle. Lorsque vous ajoutez un fournisseur, vous êtes invité à saisir vos identifiants d’authentification pour ce fournisseur. Consultez la documentation de votre fournisseur pour savoir où trouver votre clé API, vos points de terminaison et toute autre information de configuration nécessaire pour accéder au modèle avec Weave.
* **System Prompt** : indiquez au modèle comment il doit se comporter, par exemple `You are a helpful assistant specializing in Python programming.` Le `user_input` de votre dataset est envoyé dans un message ultérieur ; il est donc inutile de l’inclure dans le prompt système.
Si vous choisissez un modèle existant, un nouveau champ apparaît à côté du nom du modèle pour vous permettre d’en sélectionner une version ; aucun autre champ n’est à configurer. Pour modifier votre modèle existant avant ou après l’évaluation, utilisez le [Prompt Playground](/fr/products/wandb/weave/guides/tools/playground).
3. Facultatif : cliquez sur **Save** pour enregistrer le modèle dans votre projet afin de le réutiliser ultérieurement.
4. Facultatif : pour évaluer plusieurs modèles simultanément, cliquez à nouveau sur **Add Model** et ajoutez d’autres modèles selon vos besoins.
Ajouter des évaluateurs
Les [évaluateurs](/fr/products/wandb/weave/guides/evaluation/scorers) s’appuient sur des juges LLM pour mesurer et apprécier la qualité des sorties des modèles d’IA. Vous pouvez sélectionner des évaluateurs existants dans votre projet ou en créer de nouveaux pour évaluer vos modèles.
Pour ajouter un évaluateur dans le playground d’évaluation :
1. Cliquez sur **Add Scorer**, puis configurez les champs suivants :
* **Name** : attribuez un nom descriptif à votre évaluateur.
* **Type** : sélectionnez le format des scores renvoyés, booléen ou numérique. Les évaluateurs booléens renvoient une valeur binaire `True` ou `False` selon que la sortie du modèle satisfait ou non les critères d’évaluation que vous avez définis. Les évaluateurs numériques renvoient un score compris entre `0` et `1`, qui donne une note globale indiquant dans quelle mesure la sortie du modèle satisfait vos critères d’évaluation.
* **LLM-as-a-judge-model** : sélectionnez le modèle de fondation qui servira de juge à l’évaluateur. Comme pour le champ LLM Model de la section **Models**, vous pouvez choisir parmi les modèles de fondation auxquels vous avez déjà configuré l’accès, ou configurer l’accès à de nouveaux modèles de fondation.
* **Scoring Prompt** : fournissez au juge LLM les critères permettant d’évaluer la sortie. Par exemple, pour détecter les hallucinations, saisissez un prompt d’évaluation semblable à celui-ci :
```text theme={"system"}
Given the following context and answer, determine if the answer contains any information not supported by the context.
User input: {user_input}
Expected output: {expected_output}
Model Output: {output}
Is the model output correct?
```
Vous pouvez utiliser les champs de vos datasets et de vos réponses comme variables dans le prompt d’évaluation, par exemple `{user_input}`, `{expected_output}` et `{output}`. Pour afficher la liste des variables disponibles, cliquez sur **Insert variable** dans l’interface utilisateur.
2. Facultatif : cliquez sur **Save** pour enregistrer l’évaluateur dans votre projet afin de le réutiliser ultérieurement.
Exécuter l’évaluation
Une fois vos datasets, modèles et évaluateurs configurés, vous pouvez exécuter l’évaluation et générer des résultats.
* Pour exécuter l’évaluation dans le playground d’évaluation, cliquez sur **Run eval**.
Weave exécute une évaluation distincte pour chaque modèle ajouté et collecte des métriques pour chaque requête effectuée avec le dataset. Weave enregistre chacune de ces évaluations dans la section **Evals** pour que vous puissiez les consulter ultérieurement.
Examiner les résultats d’évaluation
Une fois l’évaluation terminée, vous pouvez examiner les résultats pour comparer les performances de chaque modèle sur votre dataset et avec vos évaluateurs.
À la fin de l’évaluation, le playground ouvre un rapport qui affiche les métriques collectées pour chaque requête envoyée à vos modèles.
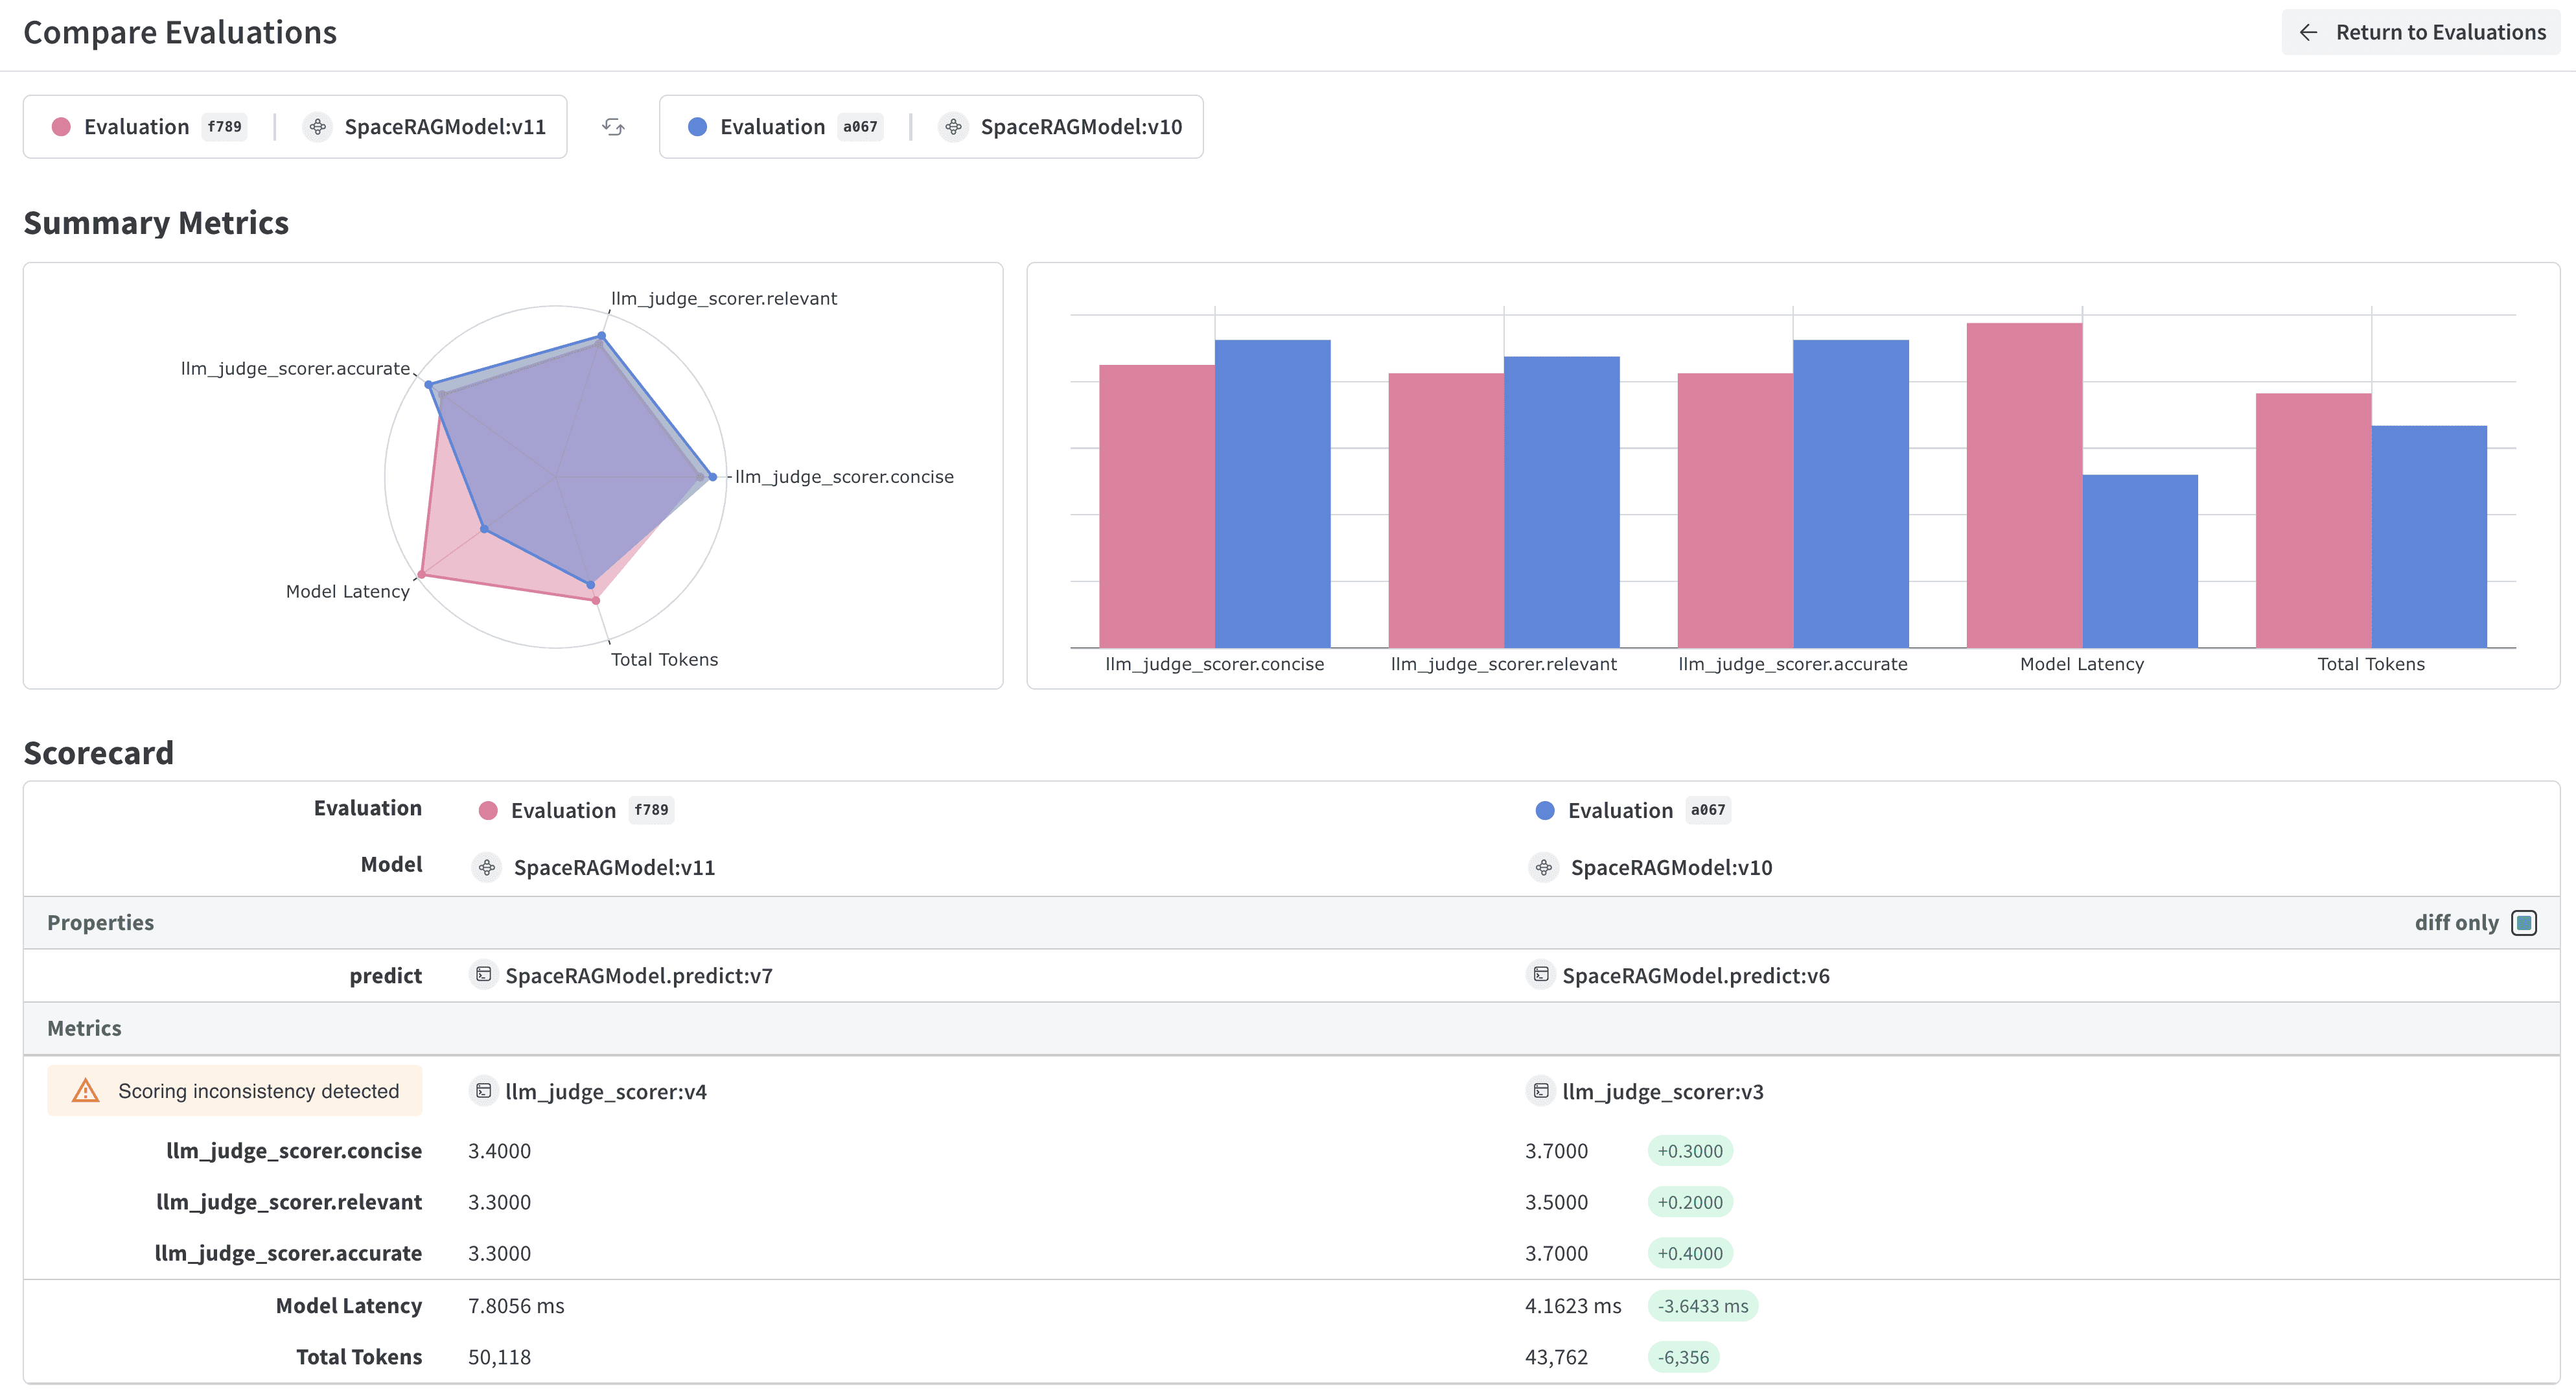 L’onglet **Dataset results** affiche l’entrée, la sortie attendue, la sortie réelle du modèle, la latence, l’utilisation des jetons et les résultats de notation. Cliquez sur les ID de la colonne **Row** pour ouvrir une vue détaillée des métriques d’un ensemble de requêtes donné. Les boutons de format d’affichage situés juste sous les onglets permettent également de modifier le format d’affichage des cellules du rapport.
L’onglet **Summary** offre un aperçu des performances de chaque modèle, accompagné de représentations visuelles des données.
Pour en savoir plus sur l’ouverture et la comparaison des évaluations, voir [Évaluations](/fr/products/wandb/weave/guides/core-types/evaluations).
## Related topics
- [Comparer des runs avec les tableaux d’évaluation](/fr/products/wandb/evaltables/compare-runs.md)