> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# LiteLLM
> Suivez et consignez automatiquement les appels LLM effectués via LiteLLM
 Weave suit et consigne automatiquement les appels LLM effectués via LiteLLM dès que vous appelez `weave.init()`. Ce guide explique comment utiliser Weave avec LiteLLM pour capturer les traces, encapsuler les appels dans des ops versionnés, organiser vos expériences avec un `Model` et suivre le comportement de l’appel de fonctions (function calling). Utilisez-le si vous développez des applications LLM et souhaitez bénéficier d’une observabilité sur l’ensemble des fournisseurs de modèles pris en charge par LiteLLM.
Traces
Il est important de stocker les traces des applications LLM dans une base de données centralisée, aussi bien pendant le développement qu'en production. Ces traces vous servent au débogage et constituent un jeu de données qui vous aide à améliorer votre application.
> **Remarque :** lorsque vous utilisez LiteLLM, veillez à importer la bibliothèque avec `import litellm` et à appeler la fonction de complétion avec `litellm.completion()`, plutôt que d’utiliser `from litellm import completion`. Vous garantissez ainsi que toutes les fonctions et tous les paramètres sont correctement référencés.
Weave capture automatiquement les traces de LiteLLM. Utilisez la bibliothèque comme d’habitude, en commençant par appeler `weave.init()` :
```python lines {4} theme={"system"}
import litellm
import weave
weave.init("weave_litellm_integration")
openai_response = litellm.completion(
model="gpt-3.5-turbo",
messages=[{"role": "user", "content": "Translate 'Hello, how are you?' to French"}],
max_tokens=1024
)
print(openai_response.choices[0].message.content)
claude_response = litellm.completion(
model="claude-3-5-sonnet-20240620",
messages=[{"role": "user", "content": "Translate 'Hello, how are you?' to French"}],
max_tokens=1024
)
print(claude_response.choices[0].message.content)
```
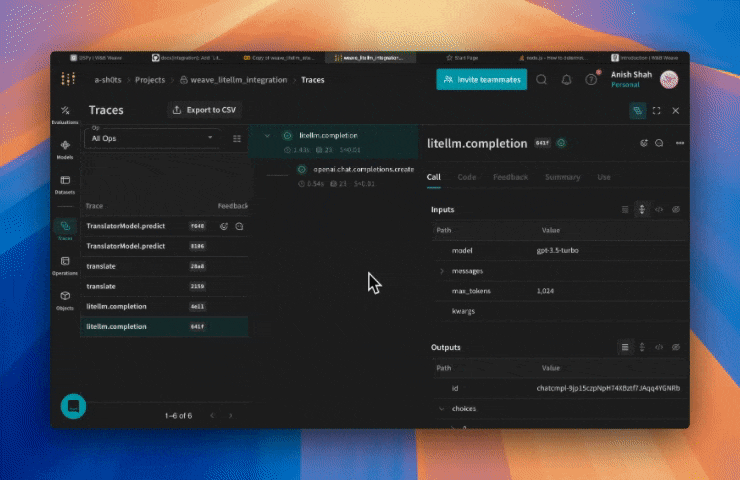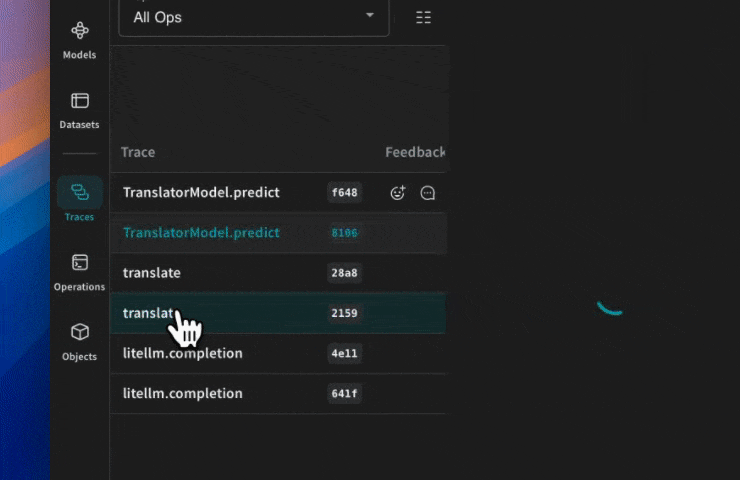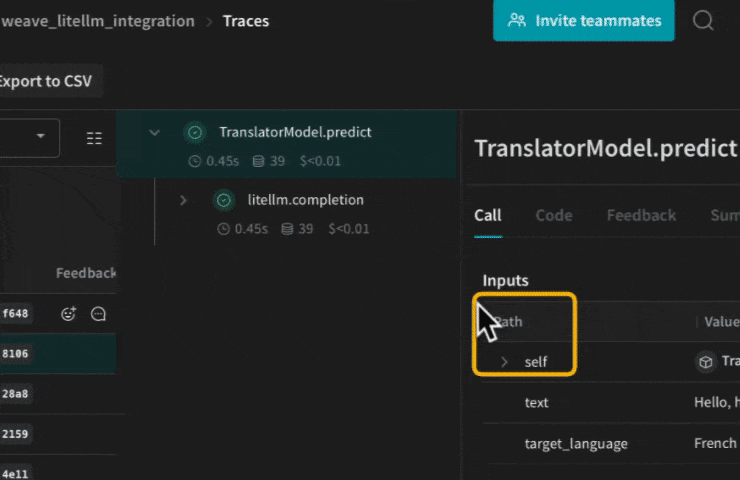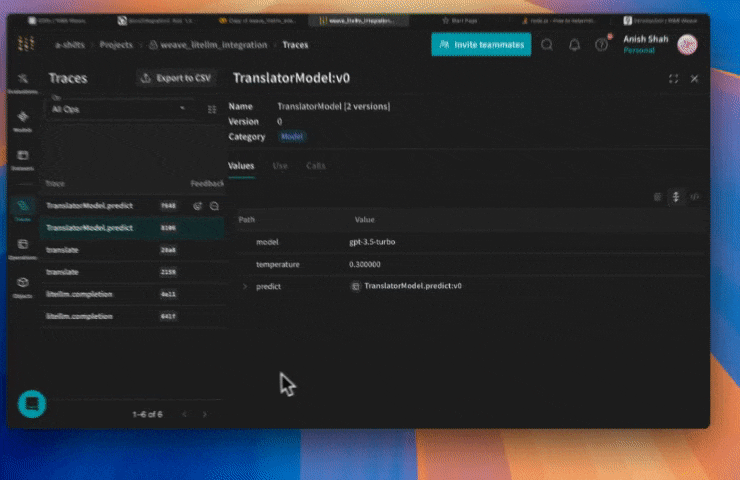
Weave suit et consigne désormais tous les appels LLM effectués via LiteLLM. Vous pouvez consulter les traces dans l’interface web de Weave. Une fois le traçage de base en place, la section suivante montre comment encapsuler les appels LiteLLM dans vos propres ops Weave afin d’obtenir un suivi plus fin et versionné de la logique de votre application.
Encapsuler avec vos propres ops
Les ops Weave rendent les résultats reproductibles en gérant automatiquement les versions du code au fil de vos expériences, et ils capturent leurs entrées et leurs sorties. Créez une fonction décorée avec `@weave.op()` qui appelle la fonction de complétion de LiteLLM : Weave suit alors les entrées et les sorties à votre place. Voici un exemple :
```python lines {4,6} theme={"system"}
import litellm
import weave
weave.init("weave_litellm_integration")
@weave.op()
def translate(text: str, target_language: str, model: str) -> str:
response = litellm.completion(
model=model,
messages=[{"role": "user", "content": f"Translate '{text}' to {target_language}"}],
max_tokens=1024
)
return response.choices[0].message.content
print(translate("Hello, how are you?", "French", "gpt-3.5-turbo"))
print(translate("Hello, how are you?", "Spanish", "claude-3-5-sonnet-20240620"))
```
Créer un `Model` pour faciliter l’expérimentation
Il est difficile d’organiser l’expérimentation lorsque de nombreux éléments évoluent en même temps. La classe `Model` vous permet de capturer et d’organiser les détails expérimentaux de votre application, comme votre prompt système ou le modèle que vous utilisez. Vous pouvez ainsi organiser et comparer les différentes itérations de votre application.
En plus de gérer les versions du code et de capturer les entrées et les sorties, les Models capturent des paramètres structurés qui contrôlent le comportement de votre application, ce qui vous aide à identifier les paramètres les plus efficaces. Vous pouvez également utiliser les Weave Models avec `serve` et les Évaluations.
Dans l’exemple suivant, vous pouvez expérimenter avec différents modèles et différentes températures :
```python lines {4,6,10} theme={"system"}
import litellm
import weave
weave.init('weave_litellm_integration')
class TranslatorModel(weave.Model):
model: str
temperature: float
@weave.op()
def predict(self, text: str, target_language: str):
response = litellm.completion(
model=self.model,
messages=[
{"role": "system", "content": f"You are a translator. Translate the given text to {target_language}."},
{"role": "user", "content": text}
],
max_tokens=1024,
temperature=self.temperature
)
return response.choices[0].message.content
# Créer des instances avec des modèles différents
gpt_translator = TranslatorModel(model="gpt-3.5-turbo", temperature=0.3)
claude_translator = TranslatorModel(model="claude-3-5-sonnet-20240620", temperature=0.1)
# Utiliser différents modèles pour traduire
english_text = "Hello, how are you today?"
print("GPT-3.5 Translation to French:")
print(gpt_translator.predict(english_text, "French"))
print("\nClaude-3.5 Sonnet Translation to Spanish:")
print(claude_translator.predict(english_text, "Spanish"))
```
Appel de fonctions
LiteLLM prend en charge l’appel de fonctions pour les modèles compatibles. Weave suit automatiquement ces appels de fonctions afin que vous puissiez examiner les fonctions, les arguments et les réponses parallèlement à vos autres traces.
```python lines {4} theme={"system"}
import litellm
import weave
weave.init("weave_litellm_integration")
response = litellm.completion(
model="gpt-3.5-turbo",
messages=[{"role": "user", "content": "Translate 'Hello, how are you?' to French"}],
functions=[
{
"name": "translate",
"description": "Translate text to a specified language",
"parameters": {
"type": "object",
"properties": {
"text": {
"type": "string",
"description": "The text to translate",
},
"target_language": {
"type": "string",
"description": "The language to translate to",
}
},
"required": ["text", "target_language"],
},
},
],
)
print(response)
```
Weave capture automatiquement les fonctions que vous utilisez dans le prompt et en gère les versions.
[ ](https://forge.coreweave.com/wandb/a-sh0ts/weave_litellm_integration/weave/calls)
## Related topics
- [Exemples de code et notebooks](/fr/products/wandb/examples.md)