> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Aperçu de la notation
> Évaluez les sorties d’IA et renvoyez des métriques d’évaluation avec les évaluateurs Weave
Dans Weave, les évaluateurs évaluent les sorties d’IA et renvoient des métriques d’évaluation. Ils reçoivent la sortie de l’IA, l’analysent et renvoient un dictionnaire de résultats. Si nécessaire, les évaluateurs peuvent s’appuyer sur vos données d’entrée comme référence et produire des informations supplémentaires, comme des explications ou le raisonnement ayant conduit à l’évaluation.
Ce guide s’adresse aux développeurs qui souhaitent mesurer la qualité des sorties de leur système d’IA. Il explique comment les évaluateurs s’intègrent aux évaluations Weave, comment créer vos propres évaluateurs, comment les appliquer à des appels individuels et comment analyser les scores obtenus.
Transmettez des évaluateurs à un objet `weave.Evaluation` lors de l’évaluation. Weave prend en charge deux types d’évaluateurs :
1. **Évaluateurs basés sur des fonctions :** fonctions Python décorées avec `@weave.op`.
2. **Évaluateurs basés sur des classes :** classes Python qui héritent de `weave.Scorer`, destinées aux évaluations plus complexes.
Les évaluateurs doivent renvoyer un dictionnaire et peuvent renvoyer plusieurs métriques, des métriques imbriquées ainsi que des valeurs non numériques, comme le texte produit par un LLM évaluateur pour expliquer son raisonnement.
Les évaluateurs sont des ops particuliers que vous transmettez à un objet `weave.Evaluation` lors de l’évaluation.
Créer vos propres évaluateurs
Les évaluateurs personnalisés vous permettent de définir des critères d’évaluation propres à votre cas d’usage, au-delà de ce que couvrent les évaluateurs intégrés. Les sections suivantes décrivent les deux façons de définir un évaluateur : sous forme de fonction, ou sous forme de classe pour une logique plus complexe.
**Évaluateurs prêts à l’emploi**
Ce guide explique comment créer des évaluateurs personnalisés, mais Weave propose également des [évaluateurs prédéfinis](/fr/products/wandb/weave/guides/evaluation/builtin_scorers) et des [évaluateurs SLM locaux](/fr/products/wandb/weave/guides/evaluation/weave_local_scorers) utilisables immédiatement, notamment :
* [Détection des hallucinations](/fr/products/wandb/weave/guides/evaluation/builtin_scorers#hallucinationfreescorer)
* [Qualité de la synthèse](/fr/products/wandb/weave/guides/evaluation/builtin_scorers#summarizationscorer)
* [Similarité des embeddings](/fr/products/wandb/weave/guides/evaluation/builtin_scorers#embeddingsimilarityscorer)
* [Détection de la toxicité (local)](/fr/products/wandb/weave/guides/evaluation/weave_local_scorers#weavetoxicityscorerv1)
* [Évaluation de la pertinence du contexte (local)](/fr/products/wandb/weave/guides/evaluation/weave_local_scorers#weavecontextrelevancescorerv1)
Évaluateurs basés sur des fonctions
Les évaluateurs basés sur des fonctions sont des fonctions décorées avec `@weave.op` qui renvoient un dictionnaire. Ils sont bien adaptés aux évaluations simples, comme celle-ci :
```python lines theme={"system"}
import weave
@weave.op
def evaluate_uppercase(text: str) -> dict:
return {"text_is_uppercase": text.isupper()}
my_eval = weave.Evaluation(
dataset=[{"text": "HELLO WORLD"}],
scorers=[evaluate_uppercase]
)
```
Lorsque vous exécutez l’évaluation, `evaluate_uppercase` vérifie si le texte est entièrement en majuscules.
Il s’agit de fonctions encapsulées avec `weave.op` qui acceptent un objet contenant `modelOutput` et, facultativement, `datasetRow`. Elles sont bien adaptées aux évaluations simples, comme dans l’exemple suivant :
```typescript lines theme={"system"}
import * as weave from 'weave'
const evaluateUppercase = weave.op(
({modelOutput}) => modelOutput.toUpperCase() === modelOutput,
{name: 'textIsUppercase'}
);
const myEval = new weave.Evaluation({
dataset: [{text: 'HELLO WORLD'}],
scorers: [evaluateUppercase],
})
```
Évaluateurs basés sur des classes
Pour des évaluations plus avancées, notamment lorsque vous devez suivre des métadonnées supplémentaires de l’évaluateur, tester différents prompts pour vos évaluateurs LLM ou effectuer plusieurs appels de fonctions, utilisez la classe `Scorer`.
**Exigences :**
1. Héritez de `weave.Scorer`.
2. Définissez une méthode `score` décorée avec `@weave.op`.
3. La méthode `score` doit renvoyer un dictionnaire.
Exemple :
```python lines {7} theme={"system"}
import weave
from openai import OpenAI
from weave import Scorer
llm_client = OpenAI()
class SummarizationScorer(Scorer):
model_id: str = "gpt-4o"
system_prompt: str = "Evaluate whether the summary is good."
@weave.op
def some_complicated_preprocessing(self, text: str) -> str:
processed_text = "Original text: \n" + text + "\n"
return processed_text
@weave.op
def call_llm(self, summary: str, processed_text: str) -> dict:
res = llm_client.chat.completions.create(
messages=[
{"role": "system", "content": self.system_prompt},
{"role": "user", "content": (
f"Analyze how good the summary is compared to the original text."
f"Summary: {summary}\n{processed_text}"
)}])
return {"summary_quality": res}
@weave.op
def score(self, output: str, text: str) -> dict:
"""Évalue la qualité de la synthèse.
Args:
output: La synthèse générée par un système d’IA
text: Le texte original à synthétiser
"""
processed_text = self.some_complicated_preprocessing(text)
eval_result = self.call_llm(summary=output, processed_text=processed_text)
return {"summary_quality": eval_result}
evaluation = weave.Evaluation(
dataset=[{"text": "The quick brown fox jumps over the lazy dog."}],
scorers=[summarization_scorer])
```
Cette classe évalue la qualité d’une synthèse en la comparant au texte original.
```plaintext theme={"system"}
This feature is not available in TypeScript yet.
```
Fonctionnement des évaluateurs
Cette section explique comment les évaluateurs reçoivent les données de votre évaluation, comment mapper les colonnes du jeu de données aux arguments des évaluateurs, comment faire référence aux variables d’un op dans les prompts d’évaluation, et comment Weave agrège les scores de chaque ligne en un résultat final.
Arguments nommés des évaluateurs
Les évaluateurs peuvent accéder à la fois à la sortie de votre système d’IA et aux données d’entrée de la ligne de jeu de données.
* **Entrée :** si vous souhaitez que votre évaluateur utilise des données de votre ligne de jeu de données, comme une colonne `label` ou `target`, mettez-les à sa disposition en ajoutant un argument nommé `label` ou `target` à la définition de votre évaluateur.
Par exemple, si vous souhaitez utiliser une colonne `label` de votre jeu de données, votre fonction d’évaluation (ou la méthode de classe `score`) aura une liste de paramètres de ce type :
```python lines theme={"system"}
@weave.op
def my_custom_scorer(output: str, label: int) -> dict:
...
```
Lorsqu’une `Evaluation` Weave s’exécute, elle transmet la sortie du système d’IA au paramètre `output`. L’`Evaluation` tente également de faire correspondre automatiquement les autres noms d’arguments de l’évaluateur aux colonnes de votre jeu de données. S’il n’est pas possible de personnaliser les arguments de votre évaluateur ou les colonnes de votre jeu de données, vous pouvez utiliser le mappage de colonnes. Voir la section suivante.
* **Sortie :** incluez un paramètre `output` dans la signature de votre fonction d’évaluation pour accéder à la sortie du système d’IA.
Mapper les noms de colonnes avec `column_map`
Il arrive que les noms d’arguments de la méthode `score` ne correspondent pas aux noms de colonnes de votre jeu de données. Vous pouvez résoudre ce problème à l’aide d’un `column_map`.
Si vous utilisez un évaluateur basé sur une classe, transmettez un dictionnaire à l’attribut `column_map` de `Scorer` lors de l’initialisation de votre classe d’évaluateur. Ce dictionnaire associe les noms d’arguments de votre méthode `score` aux noms de colonnes du jeu de données, sous la forme `{scorer_keyword_argument: dataset_column_name}`.
Exemple :
```python lines theme={"system"}
import weave
from weave import Scorer
# Un jeu de données d’articles de presse à résumer
dataset = [
{"news_article": "The news today was great...", "date": "2030-04-20", "source": "Bright Sky Network"},
...
]
# Classe d’évaluateur
class SummarizationScorer(Scorer):
@weave.op
def score(self, output, text) -> dict:
"""
output: résumé produit par un système de synthèse basé sur un LLM
text: le texte à résumer
"""
... # évaluer la qualité du résumé
# créer un évaluateur avec un mappage de colonne associant l’argument `text` à la colonne de données `news_article`
scorer = SummarizationScorer(column_map={"text" : "news_article"})
```
L’argument `text` de la méthode `score` reçoit désormais les données de la colonne `news_article` du jeu de données.
**Remarques :**
* Pour mapper vos colonnes, vous pouvez également créer une sous-classe de `Scorer` et surcharger la méthode `score` en mappant explicitement les colonnes.
```python lines theme={"system"}
import weave
from weave import Scorer
class MySummarizationScorer(SummarizationScorer):
@weave.op
def score(self, output: str, news_article: str) -> dict: # Indications de type ajoutées
# surcharger la méthode score et mapper les colonnes manuellement
return super().score(output=output, text=news_article)
```
Les évaluateurs peuvent accéder à la fois à la sortie de votre système d’IA et au contenu de la ligne de jeu de données.
Vous pouvez accéder aux colonnes pertinentes de la ligne de jeu de données en ajoutant un argument nommé `datasetRow` à la définition de votre évaluateur.
```typescript twoslash lines theme={"system"}
// @noErrors
const myScorer = weave.op(
({modelOutput, datasetRow}) => {
return modelOutput * 2 === datasetRow.expectedOutputTimesTwo;
},
{name: 'myScorer'}
);
```
Mapper les noms de colonnes avec `columnMapping`
En TypeScript, cette fonctionnalité est définie sur l’objet `Evaluation`, et non sur chaque évaluateur.
Il arrive que les clés de votre `datasetRow` ne correspondent pas exactement au schéma de nommage de l’évaluateur, tout en ayant un sens similaire. Vous pouvez alors mapper les colonnes à l’aide de l’option `columnMapping` de l’`Evaluation`.
Le mappage se fait toujours du point de vue de l’évaluateur, c’est-à-dire `{scorer_key: dataset_column_name}`.
Exemple :
```typescript twoslash lines theme={"system"}
// @noErrors
const myScorer = weave.op(
({modelOutput, datasetRow}) => {
return modelOutput * 2 === datasetRow.expectedOutputTimesTwo;
},
{name: 'myScorer'}
);
const myEval = new weave.Evaluation({
dataset: [{expected: 2}],
scorers: [myScorer],
columnMapping: {expectedOutputTimesTwo: 'expected'}
});
```
Accéder aux variables de vos ops dans les prompts d’évaluation
Dans les prompts d’évaluation des évaluateurs LLM-as-a-judge, vous pouvez faire référence aux variables de votre op. Weave extrait automatiquement ces valeurs lors de l’exécution de l’évaluateur.
Par exemple, pour une fonction comme celle-ci :
```python theme={"system"}
@weave.op
def summarize_article(article: str, max_length: int) -> str:
# Insérez ici votre logique de synthèse
return summary
```
Les variables suivantes sont disponibles :
| Variable | Description |
| - | - |
| `{article}` | La valeur de l’argument d’entrée `article` |
| `{max_length}` | La valeur de l’argument d’entrée `max_length` |
| `{inputs}` | Un dictionnaire JSON contenant tous les arguments d’entrée |
| `{output}` | Le résultat renvoyé par votre op |
Exemple de prompt d’évaluation :
```text theme={"system"}
Évaluez la qualité de cette synthèse.
Article original : {article}
Synthèse : {output}
Longueur maximale demandée : {max_length}
Notez la synthèse sur une échelle de 1 à 10 selon les critères suivants :
- Précision : reflète-t-elle fidèlement l’article ?
- Exhaustivité : couvre-t-elle les points clés ?
- Concision : est-elle suffisamment brève ?
Renvoyez un objet JSON contenant votre note et votre raisonnement.
```
Synthèse finale de l’évaluateur
Pendant l’évaluation, Weave calcule l’évaluateur pour chaque ligne de votre jeu de données. Pour obtenir un score final de l’évaluation, Weave exécute `auto_summarize` en fonction du type de retour de la sortie.
Vous pouvez redéfinir la méthode `summarize` de la classe `Scorer` pour fournir votre propre méthode de calcul des scores finaux. La fonction `summarize` attend :
* Un seul paramètre `score_rows` : une liste de dictionnaires, dans laquelle chaque dictionnaire contient les scores renvoyés par la méthode `score` pour une ligne de votre jeu de données.
* Elle renvoie un dictionnaire contenant les scores synthétisés.
**Quel intérêt ?**
Cette approche est utile lorsque vous devez évaluer toutes les lignes avant de déterminer la valeur finale du score pour le jeu de données.
```python lines theme={"system"}
class MyBinaryScorer(Scorer):
"""
Returns True if the full output matches the target, False if not
"""
@weave.op
def score(self, output, target):
return {"match": output == target}
def summarize(self, score_rows: list) -> dict:
full_match = all(row["match"] for row in score_rows)
return {"full_match": full_match}
```
> Dans cet exemple, la fonction `auto_summarize` par défaut renverrait le nombre et la proportion de valeurs True.
Pour plus d’informations, voir l’implémentation de [CorrectnessLLMJudge](/fr/products/wandb/weave/tutorial-rag#optional-defining-a-scorer-class).
Pendant l’évaluation, Weave calcule l’évaluateur pour chaque ligne de votre jeu de données. Pour obtenir un score final, Weave utilise une fonction interne `summarizeResults` qui agrège les résultats selon le type de sortie.
Weave ne prend pas en charge la synthèse personnalisée.
Appliquer des évaluateurs à un appel
En plus d’exécuter des évaluateurs dans le cadre d’une `weave.Evaluation`, vous pouvez les appliquer directement à un appel individuel. C’est utile lorsque vous souhaitez évaluer le trafic de production ou joindre des métriques d’évaluation à une invocation d’op précise.
Pour appliquer des évaluateurs à vos ops Weave, utilisez la méthode `.call()`, qui donne accès à la fois au résultat de l’opération et à ses informations de suivi. Vous pouvez ainsi associer les résultats des évaluateurs à des appels spécifiques dans la base de données de Weave.
Pour plus d’informations sur l’utilisation de la méthode `.call()`, consultez le guide [Appeler des ops](/fr/products/wandb/weave/guides/tracking/tracing#getting-a-handle-to-the-call-object-during-execution).
Voici un exemple de base :
```python lines theme={"system"}
# Obtenir à la fois le résultat et l'objet Call
result, call = generate_text.call("Say hello")
# Appliquer un évaluateur
score = await call.apply_scorer(MyScorer())
```
Vous pouvez également appliquer plusieurs évaluateurs au même appel :
```python lines theme={"system"}
# Appliquer plusieurs évaluateurs en parallèle
await asyncio.gather(
call.apply_scorer(quality_scorer),
call.apply_scorer(toxicity_scorer)
)
```
**Remarques :**
* Weave stocke automatiquement les résultats des évaluateurs dans sa base de données.
* Les évaluateurs s’exécutent de manière asynchrone une fois l’opération principale terminée.
* Vous pouvez consulter les résultats des évaluateurs dans l’interface utilisateur ou les interroger via l’API.
Pour plus de détails sur l’utilisation des évaluateurs comme garde-fous ou moniteurs, notamment les bonnes pratiques en production et des exemples complets, consultez le [guide Garde-fous et moniteurs](/fr/products/wandb/weave/guides/evaluation/monitors).
```plaintext theme={"system"}
This feature is not available in TypeScript yet.
```
Vous pouvez utiliser le paramètre `preprocess_model_input` pour modifier les exemples du jeu de données avant qu’ils ne soient transmis à votre modèle pendant l’évaluation.
La fonction `preprocess_model_input` se contente de transformer les entrées avant que Weave ne les transmette à la fonction de prédiction du modèle.
Les fonctions d’évaluateur reçoivent toujours les exemples d’origine du jeu de données, sans aucun prétraitement.
Pour en savoir plus sur son utilisation et consulter un exemple, voir [Utiliser `preprocess_model_input` pour formater les lignes du jeu de données avant l’évaluation](/fr/products/wandb/weave/guides/core-types/evaluations#using-preprocess_model_input-to-format-dataset-rows-before-evaluating).
Analyse des scores
Une fois vos évaluateurs exécutés, vous aurez souvent besoin d’examiner les scores qu’ils ont produits pour comprendre le comportement du modèle ou comparer des versions. Les sections suivantes expliquent comment analyser les scores d’un appel unique, d’appels multiples et de tous les appels évalués par un évaluateur spécifique, à la fois avec l’API et dans l’interface utilisateur de Weights & Biases.
Analyser les scores d’un appel unique
API d’appel unique
Pour récupérer un appel unique, utilisez la méthode `get_call`.
```python lines theme={"system"}
client = weave.init("my-project")
# Obtenir un appel unique
call = client.get_call("call-uuid-here")
# Obtenir le feedback de l’appel, qui contient les scores
feedback = list(call.feedback)
```
Interface d’un appel unique
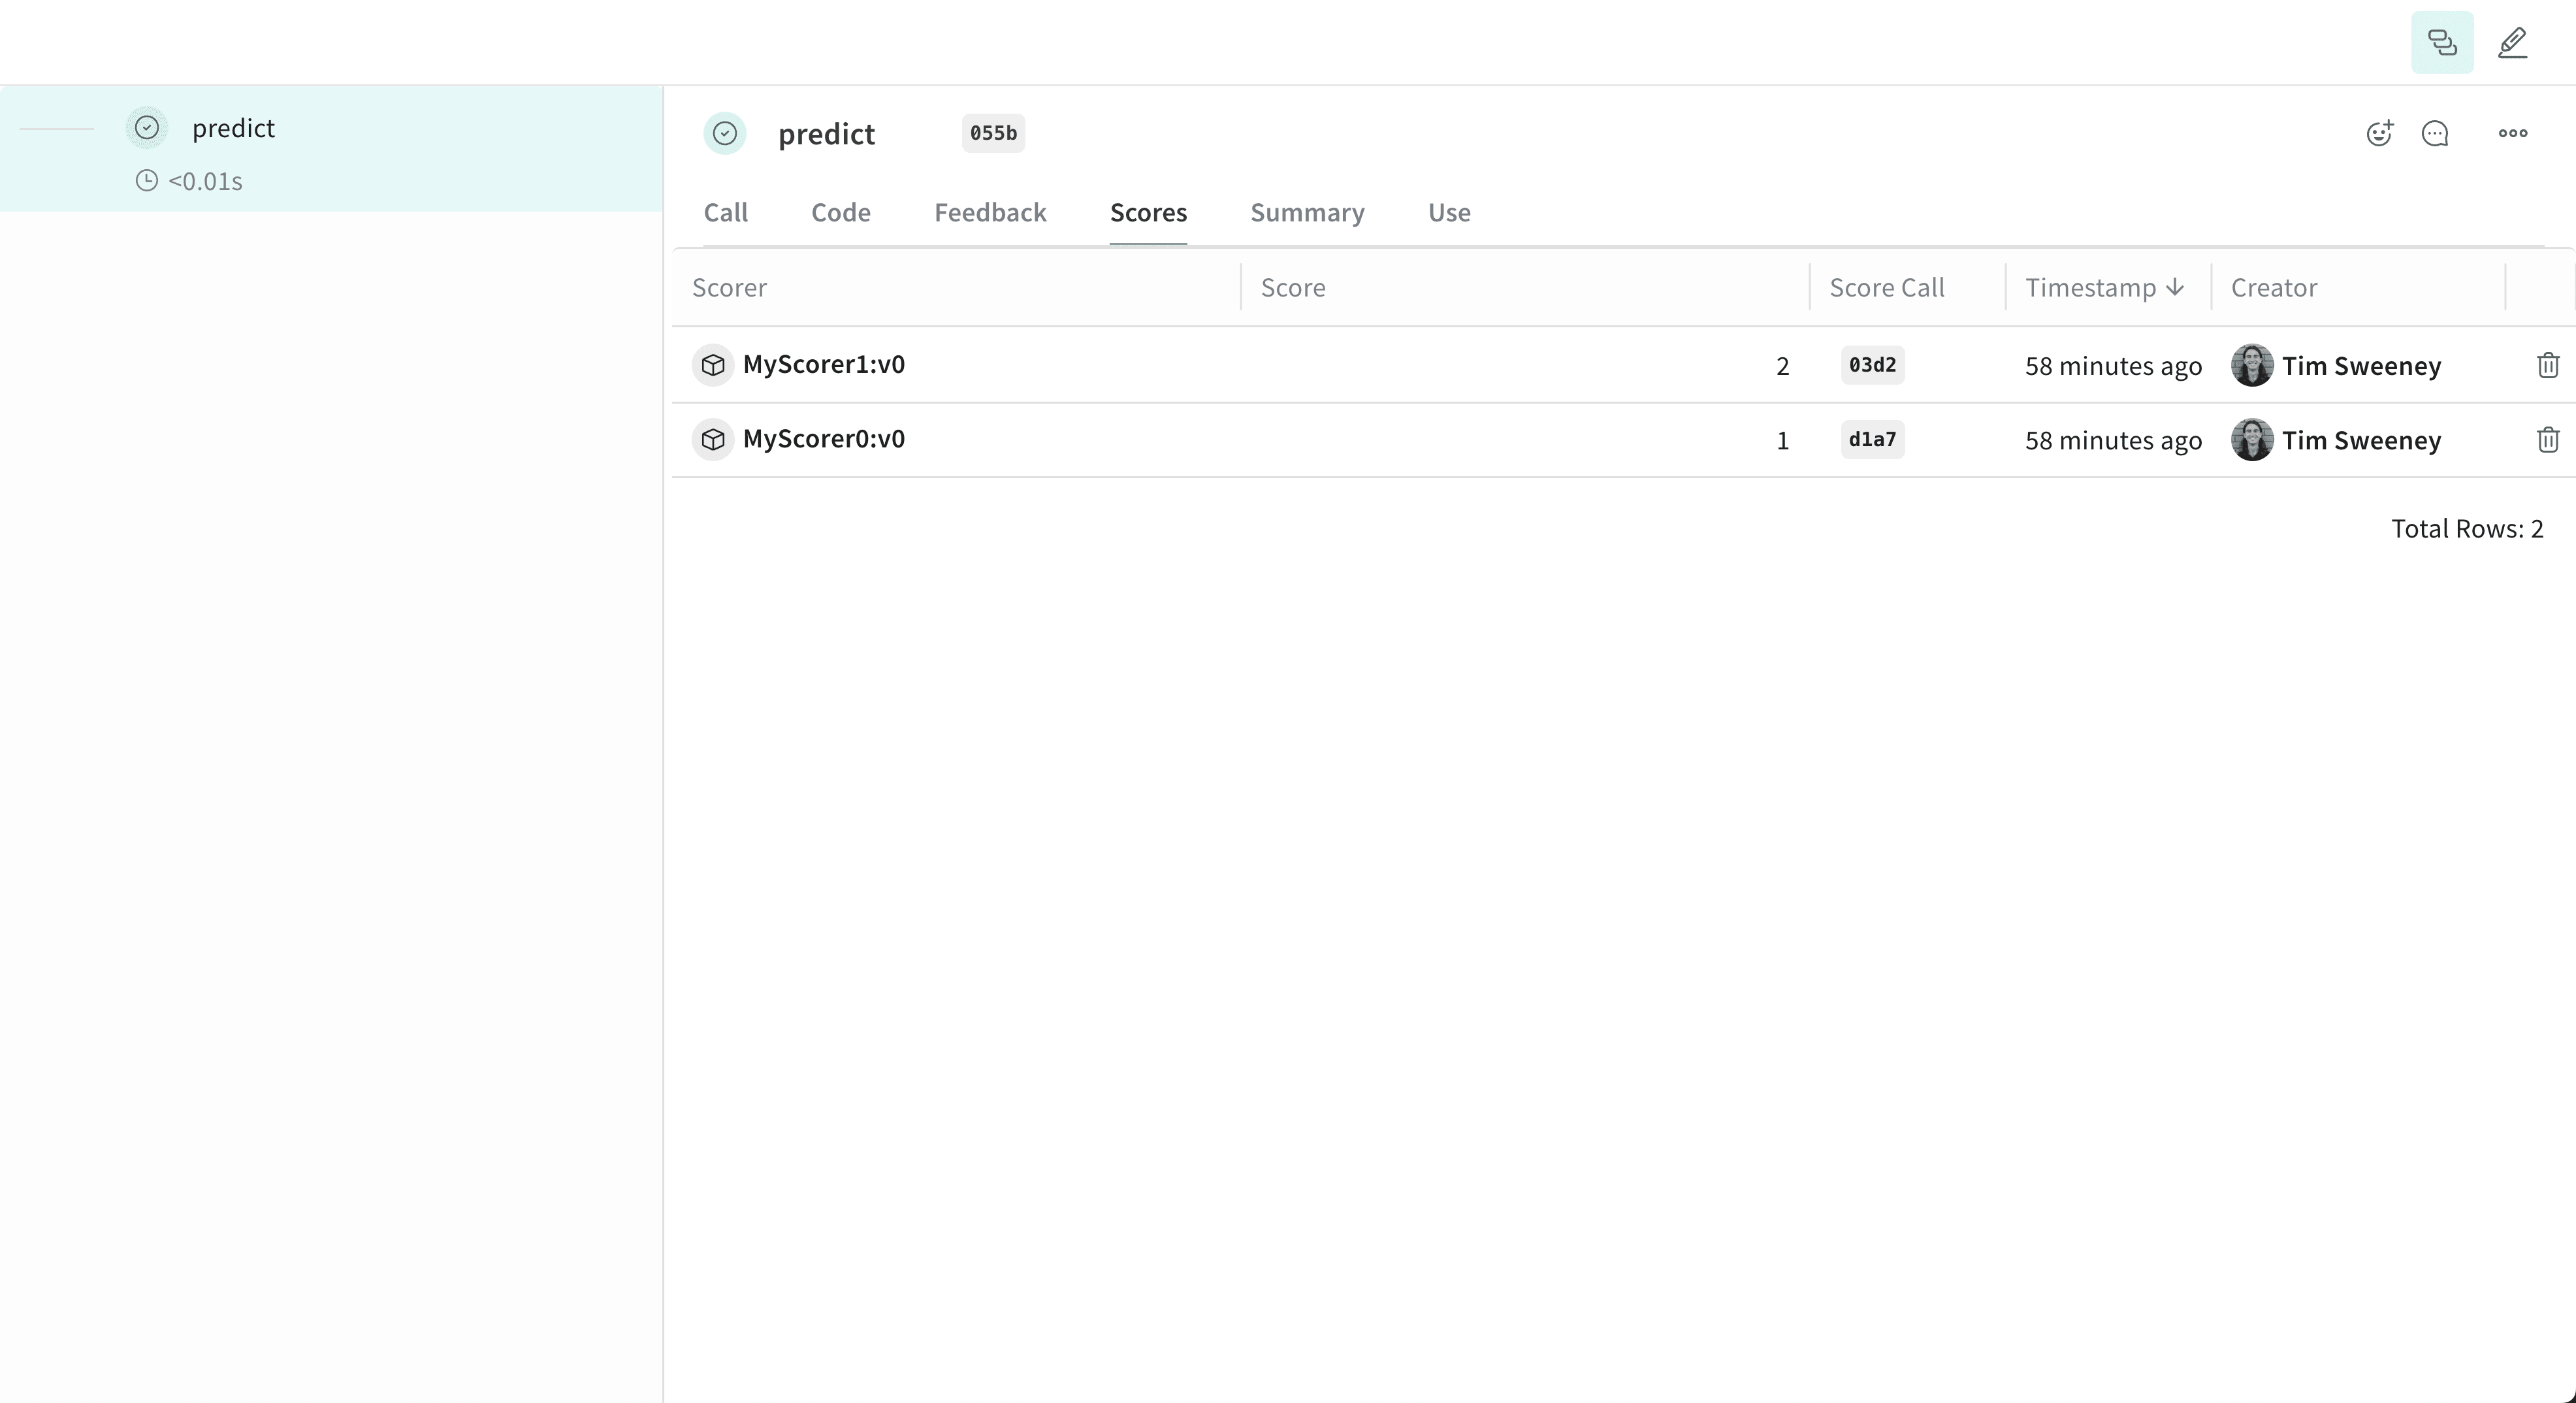 Le panneau des détails de l’appel affiche les scores d’un appel donné dans l’onglet **Scores**.
Analyser les scores d’appels multiples
API d’appels multiples
Pour récupérer plusieurs appels, utilisez la méthode `get_calls`.
```python lines theme={"system"}
client = weave.init("my-project")
# Obtenir plusieurs appels : utilisez les filtres de votre choix et incluez le feedback
calls = client.get_calls(..., include_feedback=True)
# Parcourir les appels et accéder au feedback, qui contient les scores
for call in calls:
feedback = list(call.feedback)
```
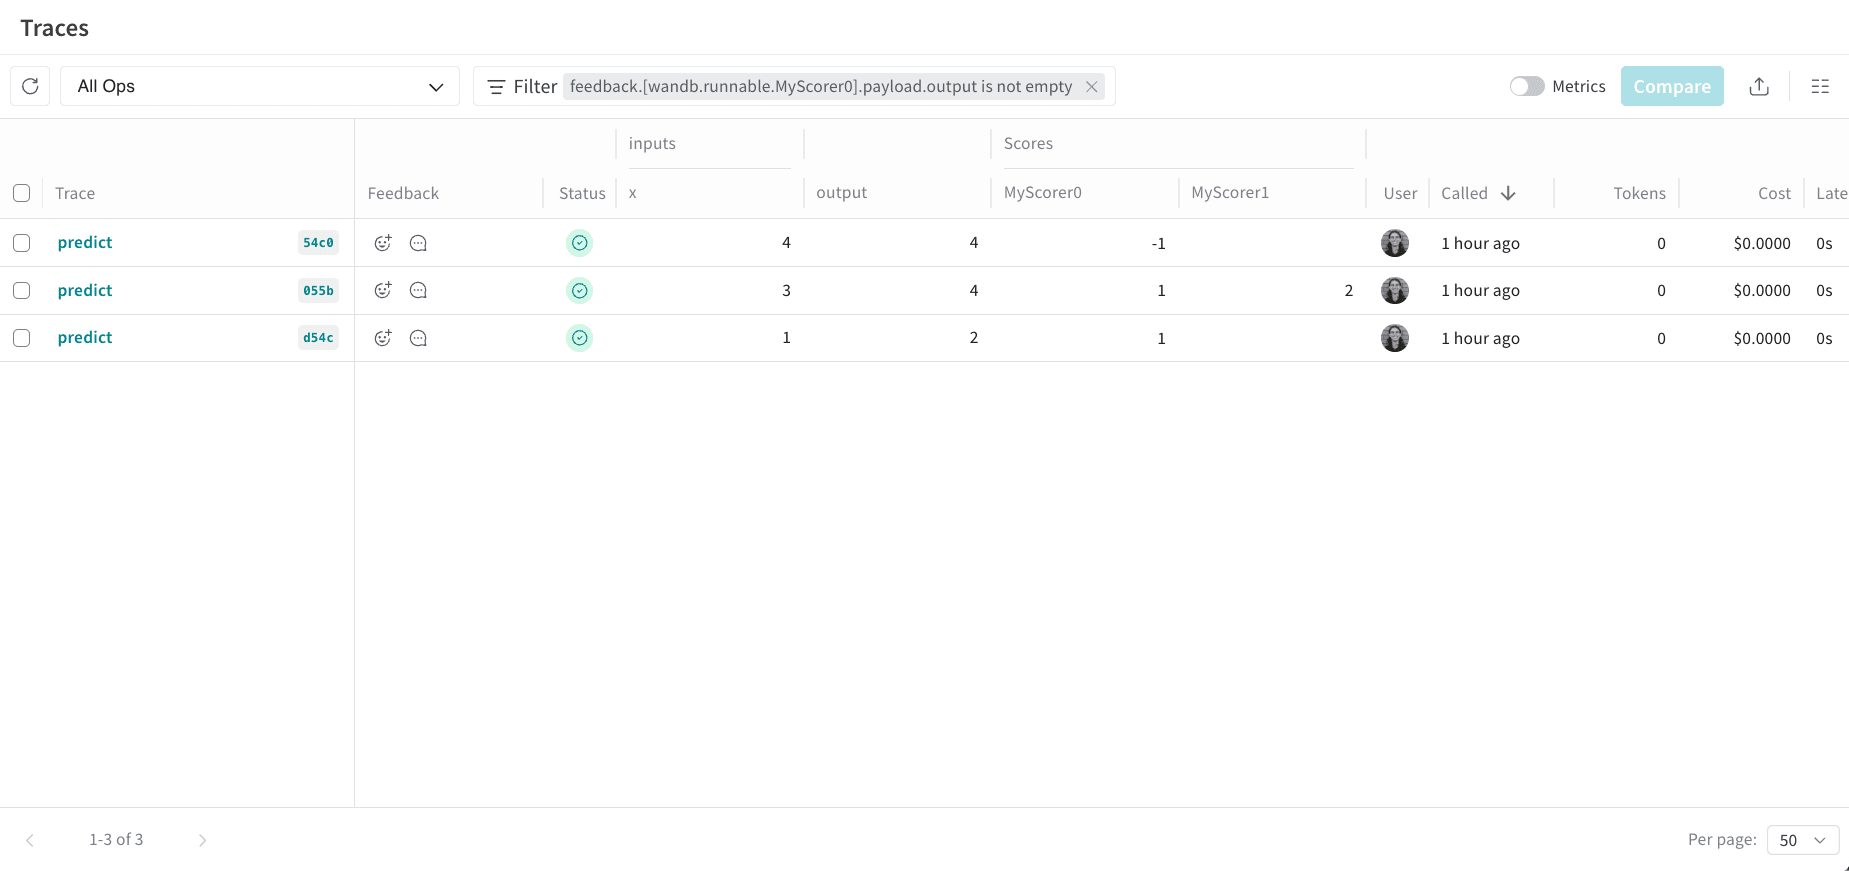
Interface pour plusieurs appels
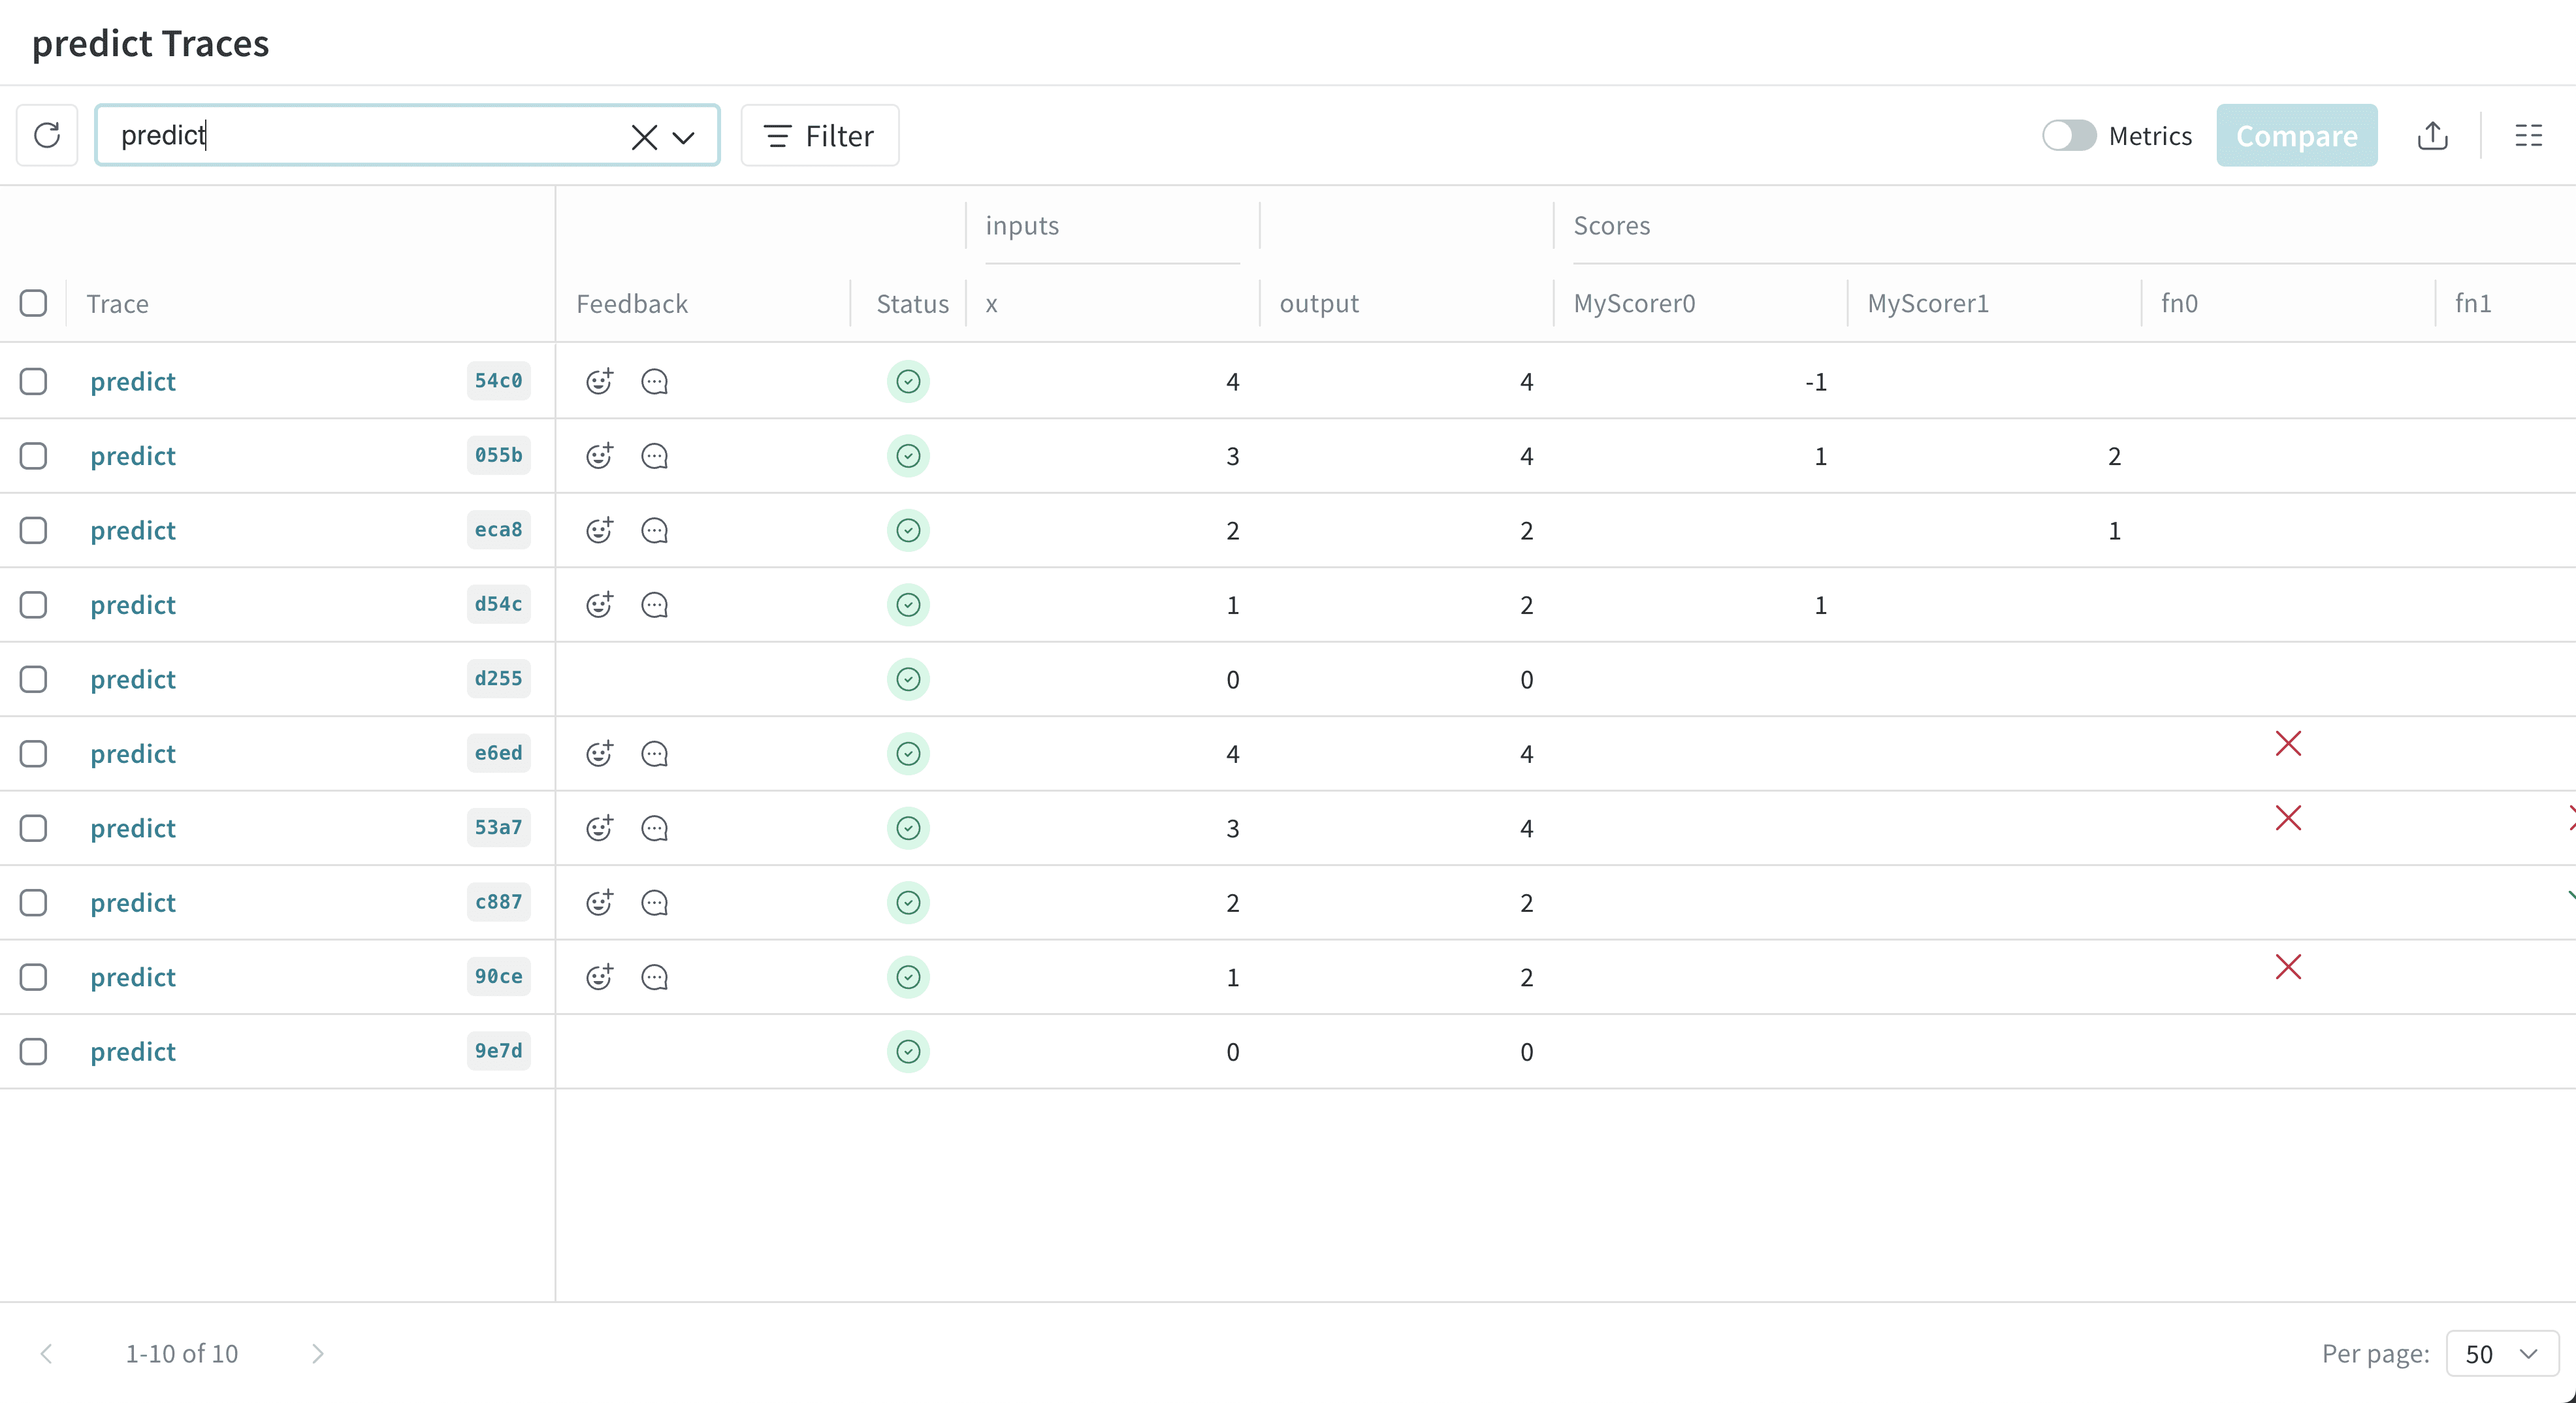 Le tableau des traces affiche les scores de plusieurs appels dans la colonne **Scores**.
Analyser tous les appels évalués par un évaluateur spécifique
API de tous les appels par évaluateur
Pour récupérer tous les appels évalués par un évaluateur spécifique, utilisez la méthode `get_calls`.
```python lines theme={"system"}
client = weave.init("my-project")
# Pour obtenir tous les appels évalués par n’importe quelle version d’un scorer, utilisez le nom du scorer (généralement le nom de sa classe)
calls = client.get_calls(scored_by=["MyScorer"], include_feedback=True)
# Pour obtenir tous les appels évalués par une version précise d’un scorer, utilisez la réf. complète
# Vous pouvez obtenir les réf. à partir de l’objet scorer ou via l’interface utilisateur.
calls = client.get_calls(scored_by=[myScorer.ref.uri()], include_feedback=True)
# Parcourez les appels et accédez au feedback, qui contient les scores
for call in calls:
feedback = list(call.feedback)
```
Tous les appels par évaluateur dans l’interface utilisateur
Enfin, pour voir tous les appels évalués par un évaluateur, accédez à l’onglet **Évaluateurs** dans l’interface utilisateur, puis sélectionnez l’onglet **Programmatic évaluateur**. Cliquez sur votre évaluateur pour ouvrir sa page de détails.
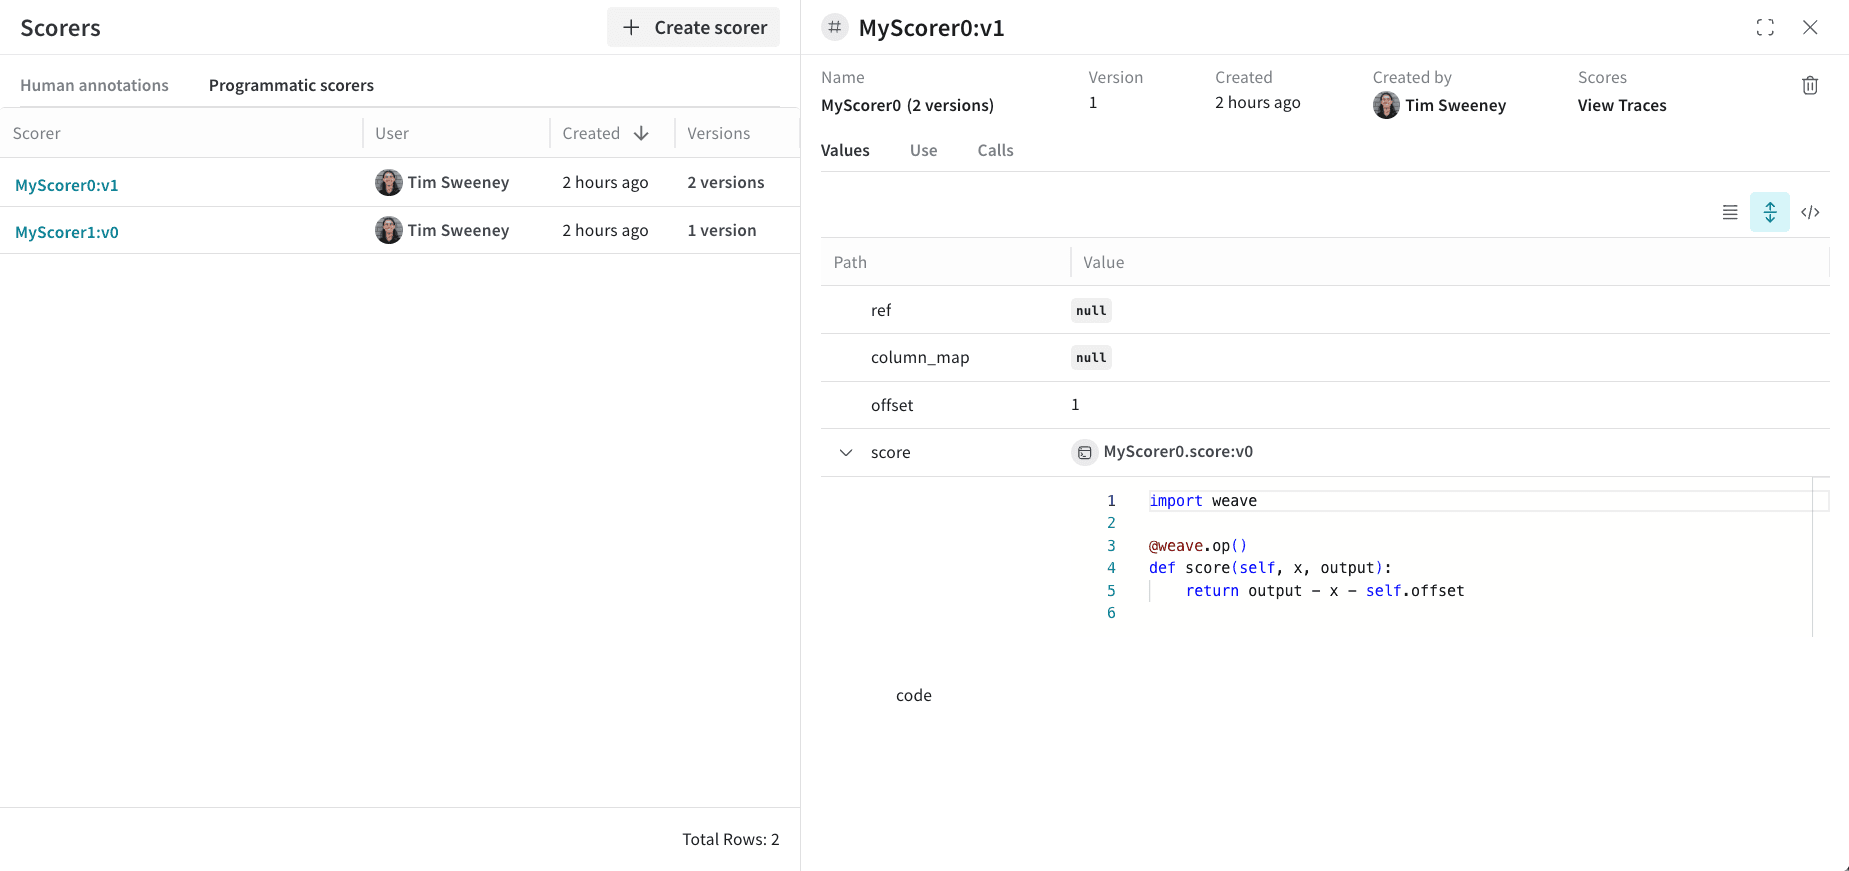 Cliquez ensuite sur le bouton **View Traces** sous **Scores** pour afficher tous les appels évalués par votre évaluateur.
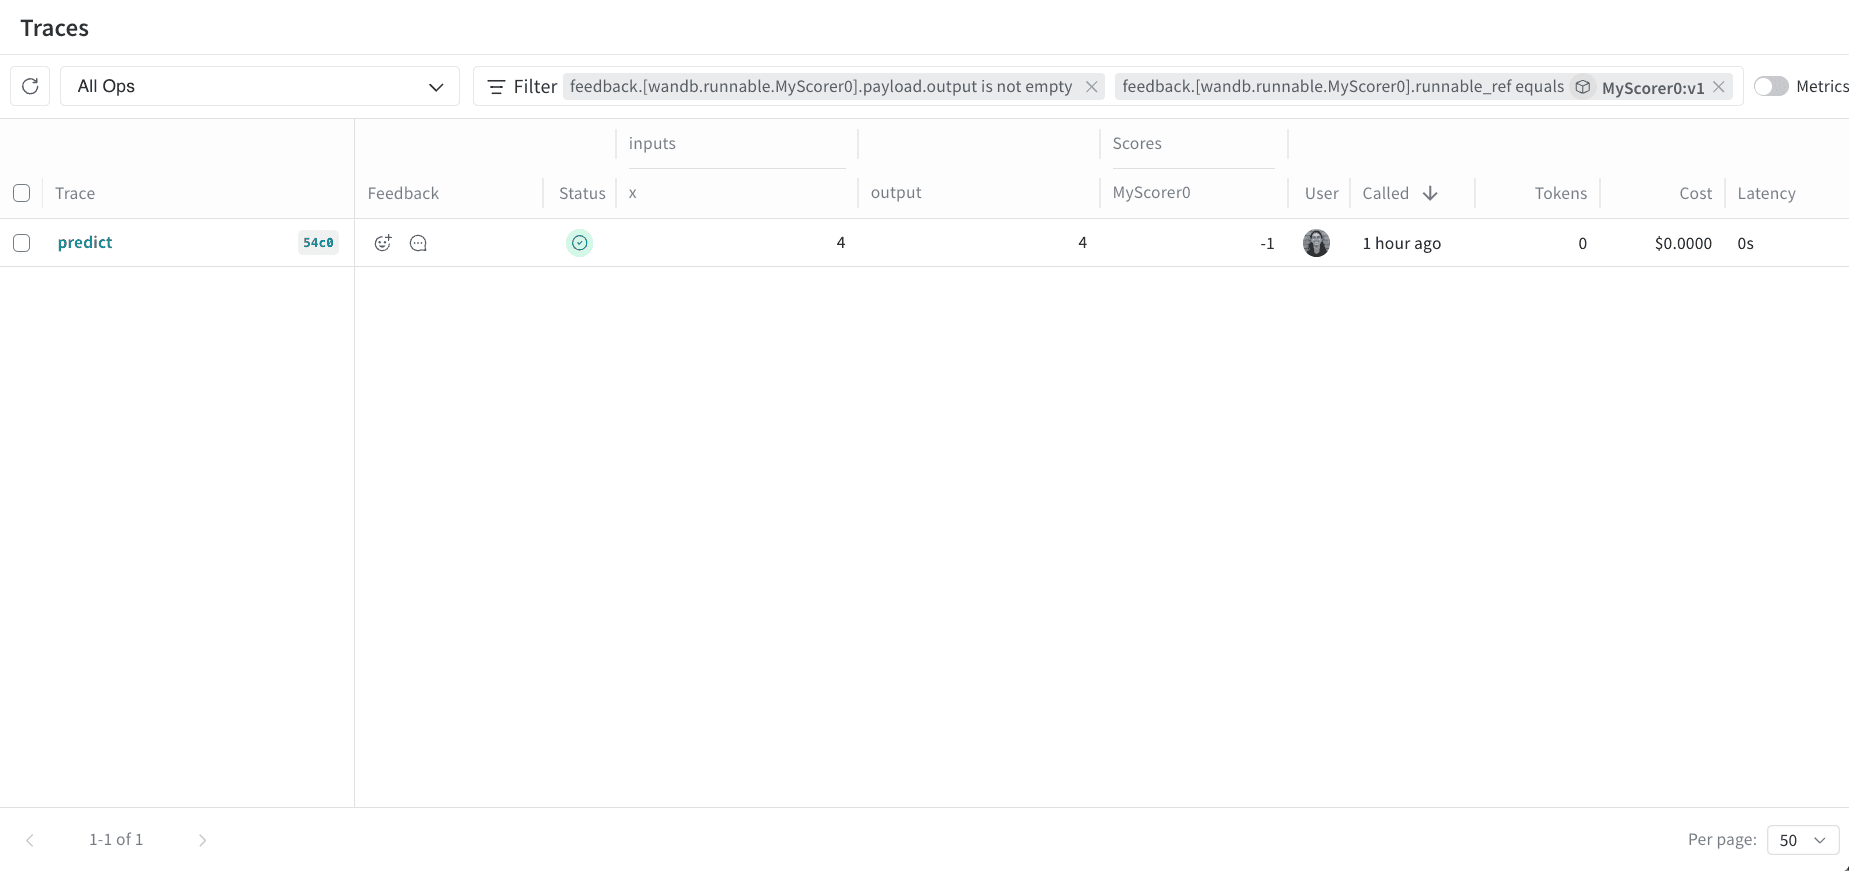 Par défaut, les résultats sont filtrés sur la version sélectionnée de l’évaluateur. Supprimez le filtre de version pour voir tous les appels évalués par n’importe quelle version de l’évaluateur.
 ## Related topics
- [Aperçu de la référence](/fr/products/wandb/ref.md)