> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Journaliser des données d’évaluation depuis votre code
> Une méthode flexible et incrémentielle pour journaliser des données d’évaluation depuis du code Python et TypeScript
Ce guide vous explique comment utiliser `EvaluationLogger` pour enregistrer des prédictions et des scores depuis votre code Python ou TypeScript existant. Vous pouvez ainsi évaluer les performances de votre modèle dans Weave sans avoir à définir au préalable un jeu de données complet et une suite d’évaluateurs. Adoptez cette approche lorsque votre jeu de données ou vos évaluateurs ne sont pas définis à l’avance, ou lorsque vous devez journaliser des données d’évaluation de manière incrémentielle pendant l’exécution de votre flux de travail.
Contrairement à l’objet `Evaluation` standard, qui nécessite un `Dataset` prédéfini et une liste d’objets `Scorer`, `EvaluationLogger` vous permet de journaliser des prédictions individuelles et leurs scores associés au fur et à mesure qu’ils deviennent disponibles.
**Vous préférez une évaluation plus structurée ?**
Si vous préférez un framework d’évaluation plus encadré, avec des jeux de données et des évaluateurs prédéfinis, consultez le [framework `Evaluation` standard](/fr/products/wandb/weave/guides/core-types/evaluations).
`EvaluationLogger` privilégie la flexibilité, tandis que le framework standard apporte un cadre et des repères.
Flux de travail de base
En suivant ces étapes, vous enregistrez une évaluation complète dans Weave, avec des scores par prédiction et une synthèse agrégée que vous pouvez consulter dans l’interface de Weights & Biases.
1. *Initialiser le logger :* créez une instance de `EvaluationLogger`, en fournissant éventuellement des métadonnées sur le `model` et le `dataset`. Si vous les omettez, Weave utilise des valeurs par défaut.
Pour capturer l’utilisation des jetons et le coût des appels LLM (par exemple, OpenAI), initialisez `EvaluationLogger` avant toute invocation du LLM.
Si vous appelez d’abord votre LLM et journalisez les prédictions ensuite, Weave ne capture pas les données de jetons ni de coût.
2. *Journaliser les prédictions :* appelez `log_prediction()` pour chaque paire d’entrée et de sortie de votre système.
3. *Journaliser les scores :* utilisez le `ScoreLogger` renvoyé pour appeler `log_score()` sur la prédiction. Vous pouvez journaliser plusieurs scores par prédiction.
4. *Terminer la prédiction :* appelez toujours `finish()` après avoir journalisé les scores d’une prédiction afin de la finaliser.
5. *Journaliser la synthèse :* une fois toutes les prédictions traitées, appelez `log_summary()` pour agréger les scores et, si vous le souhaitez, ajouter des métriques personnalisées.
Une fois `finish()` appelé sur une prédiction, vous ne pouvez plus journaliser de scores pour celle-ci.
Pour un exemple Python illustrant ce flux de travail, consultez l’[Exemple de base](#basic-example). Si la sortie et tous les scores sont disponibles en même temps, les utilisateurs de Python peuvent regrouper les étapes 2 à 4 en un appel unique avec [`log_example()`](#simplified-logging-with-log_example).
Exemple de base
L’exemple suivant montre comment utiliser `EvaluationLogger` pour journaliser des prédictions et des scores directement dans votre code existant. Remplacez `[YOUR-TEAM]/[YOUR-PROJECT]` par votre entity et votre projet W\&B.
La fonction `user_model` est définie, puis appliquée à une liste d’entrées. Pour chaque exemple :
* L’entrée et la sortie sont journalisées à l’aide de `log_prediction`.
* Un score d’exactitude (`correctness_score`) est journalisé à l’aide de `log_score`.
* `finish()` finalise la journalisation de cette prédiction.
Enfin, `log_summary` enregistre les éventuelles métriques agrégées et déclenche la synthèse automatique des scores dans Weave.
```python lines theme={"system"}
import weave
from openai import OpenAI
from weave import EvaluationLogger
weave.init('[YOUR-TEAM]/[YOUR-PROJECT]')
# Initialiser EvaluationLogger AVANT d’appeler le modèle pour garantir le suivi des jetons
eval_logger = EvaluationLogger(
model="my_model",
dataset="my_dataset"
)
# Exemple de données d’entrée (n’importe quelle structure de données convient)
eval_samples = [
{'inputs': {'a': 1, 'b': 2}, 'expected': 3},
{'inputs': {'a': 2, 'b': 3}, 'expected': 5},
{'inputs': {'a': 3, 'b': 4}, 'expected': 7},
]
# Exemple de logique de modèle avec OpenAI
@weave.op
def user_model(a: int, b: int) -> int:
oai = OpenAI()
response = oai.chat.completions.create(
messages=[{"role": "user", "content": f"What is {a}+{b}?"}],
model="gpt-4o-mini"
)
# Exploiter la réponse selon vos besoins (ici, pour simplifier, on renvoie simplement a + b)
return a + b
# Parcourir les exemples, prédire et journaliser
for sample in eval_samples:
inputs = sample["inputs"]
model_output = user_model(**inputs) # Transmettre les entrées sous forme de kwargs
# Journaliser l’entrée et la sortie de la prédiction
prediction = eval_logger.log_prediction(
inputs=inputs,
output=model_output
)
# Calculer et journaliser un score pour cette prédiction
expected = sample["expected"]
correctness_score = model_output == expected
prediction.log_score(
scorer="correctness", # Nom du scorer, sous forme de simple chaîne
score=correctness_score
)
# Terminer la journalisation de cette prédiction
prediction.finish()
# Journaliser une synthèse finale pour l’ensemble de l’évaluation.
# Weave agrège automatiquement les scores 'correctness' journalisés ci-dessus.
summary_stats = {"subjective_overall_score": 0.8}
eval_logger.log_summary(summary_stats)
print("Evaluation logging complete. View results in the Weave UI.")
```
Le SDK TypeScript propose deux modèles d’API :
* **API fire-and-forget (recommandée dans la plupart des cas)** : utilisez `logPrediction()` sans `await` pour une journalisation synchrone et non bloquante.
* **API awaitable** : utilisez `logPredictionAsync()` avec `await` lorsque vous devez vous assurer que les opérations sont terminées avant de continuer.
Utilisez l’approche fire-and-forget pour bénéficier des avantages suivants :
* **Un débit élevé** : traitez plusieurs prédictions en parallèle sans attendre la fin de chaque opération de journalisation.
* **Un impact minimal sur le code** : ajoutez la journalisation des évaluations sans restructurer votre flux async/await existant.
* **La simplicité** : moins de code répétitif et une syntaxe plus claire pour la plupart des scénarios d’évaluation.
L’approche fire-and-forget est sans risque, car `logSummary()` attend automatiquement la fin de toutes les opérations en attente avant d’agréger les résultats.
L’exemple suivant évalue les prédictions d’un modèle avec l’approche fire-and-forget. Il configure un logger d’évaluation, exécute un modèle sur trois échantillons de test, puis journalise la prédiction sans utiliser `await` :
```typescript twoslash lines {36,50} theme={"system"}
// @noErrors
import weave, {EvaluationLogger} from 'weave';
import OpenAI from 'openai';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
// Initialiser EvaluationLogger AVANT d’appeler le modèle pour garantir le suivi des jetons
const evalLogger = new EvaluationLogger({
name: 'my-eval',
model: 'my_model',
dataset: 'my_dataset'
});
// Exemple de données d’entrée
const evalSamples = [
{inputs: {a: 1, b: 2}, expected: 3},
{inputs: {a: 2, b: 3}, expected: 5},
{inputs: {a: 3, b: 4}, expected: 7},
];
// Exemple de logique de modèle reposant sur OpenAI
const userModel = weave.op(async function userModel(a: number, b: number): Promise {
const oai = new OpenAI();
const response = await oai.chat.completions.create({
messages: [{role: 'user', content: `What is ${a}+${b}?`}],
model: 'gpt-4o-mini'
});
return a + b;
});
// Parcourir les exemples, générer les prédictions et les journaliser selon l’approche fire-and-forget
for (const sample of evalSamples) {
const {inputs} = sample;
const modelOutput = await userModel(inputs.a, inputs.b);
// Fire-and-forget : await inutile pour logPrediction
const prediction = evalLogger.logPrediction(inputs, modelOutput);
// Calculer et journaliser un score pour cette prédiction
const correctnessScore = modelOutput === sample.expected;
// Fire-and-forget : await inutile pour logScore
prediction.logScore('correctness', correctnessScore);
// Fire-and-forget : await inutile pour finish
prediction.finish();
}
// logSummary attend en interne que toutes les opérations en attente soient terminées
const summaryStats = {subjective_overall_score: 0.8};
await evalLogger.logSummary(summaryStats);
console.log('Evaluation logging complete. View results in the Weave UI.');
```
Utilisez l’API awaitable lorsque vous devez vous assurer que chaque opération est terminée avant de continuer, par exemple pour la gestion des erreurs ou des dépendances séquentielles.
Dans l’exemple suivant, au lieu d’appeler `logPrediction()` sans `await`, le code utilise `logPredictionAsync()` avec `await` afin de garantir que chaque opération est terminée avant de passer à la suivante :
```typescript twoslash lines theme={"system"}
// @noErrors
// Utiliser logPredictionAsync au lieu de logPrediction
const prediction = await evalLogger.logPredictionAsync(inputs, modelOutput);
// Attendre chaque opération avec await
await prediction.logScore('correctness', correctnessScore);
await prediction.finish();
```
Journalisation simplifiée avec `log_example()`
Utilisez `log_example()` pour journaliser des entrées, une sortie et des scores en un appel unique. Cette méthode pratique regroupe `log_prediction()`, `log_score()` et `finish()` en une seule étape. Elle s'avère utile lorsque les entrées, les sorties du modèle et les scores sont déjà prêts à être journalisés, par exemple lors d'évaluations par lots ou hors ligne.
```python lines theme={"system"}
import weave
from weave import EvaluationLogger
weave.init('[YOUR-TEAM]/[YOUR-PROJECT]')
eval_logger = EvaluationLogger(
model="my_model",
dataset="my_dataset"
)
eval_samples = [
{'inputs': {'a': 1, 'b': 2}, 'expected': 3},
{'inputs': {'a': 2, 'b': 3}, 'expected': 5},
{'inputs': {'a': 3, 'b': 4}, 'expected': 7},
]
for sample in eval_samples:
inputs = sample['inputs']
output = inputs['a'] + inputs['b']
eval_logger.log_example(
inputs=inputs,
output=output,
scores={"correctness": output == sample['expected']}
)
eval_logger.log_summary({"avg_score": 1.0})
```
L’appel précédent à `log_example()` équivaut à :
```python lines theme={"system"}
prediction = eval_logger.log_prediction(inputs=inputs, output=output)
prediction.log_score(scorer="correctness", score=output == sample['expected'])
prediction.finish()
```
`log_example()` n’est pas disponible dans le SDK TypeScript de Weave. Les utilisateurs de TypeScript doivent utiliser l’approche basée sur `logPrediction()` et `logScore()` présentée dans l’[exemple de base](#basic-example).
Utilisation avancée
L’`EvaluationLogger` offre des modes d’utilisation flexibles qui vont au-delà du flux de travail de base, afin de répondre à des scénarios d’évaluation plus complexes. Les sections suivantes décrivent des techniques avancées, notamment comment utiliser des gestionnaires de contexte pour gérer automatiquement les ressources, lier les traces d’agent aux lignes d’évaluation, séparer l’exécution du modèle de la journalisation, manipuler des données de médias enrichis et comparer côte à côte plusieurs évaluations de modèles.
Utiliser des gestionnaires de contexte
`EvaluationLogger` prend en charge les gestionnaires de contexte (instructions `with`) pour les prédictions comme pour les scores. Vous obtenez ainsi un code plus lisible, un nettoyage automatique des ressources et un meilleur suivi des opérations imbriquées, comme les appels à un juge LLM.
Dans ce contexte, les instructions `with` offrent les avantages suivants :
* Appel automatique de `finish()` à la sortie du contexte.
* Meilleur suivi des jetons et des coûts pour les appels LLM imbriqués.
* Possibilité de définir la sortie après l’exécution du modèle, au sein du contexte de la prédiction.
```python lines {16,24,31,40} theme={"system"}
import openai
import weave
weave.init("nested-evaluation-example")
oai = openai.OpenAI()
# Initialiser le logger
ev = weave.EvaluationLogger(
model="gpt-4o-mini",
dataset="joke_dataset"
)
user_prompt = "Tell me a joke"
# Utiliser un gestionnaire de contexte pour la prédiction : inutile d’appeler finish()
with ev.log_prediction(inputs={"user_prompt": user_prompt}) as prediction:
# Effectuer l’appel de modèle dans le contexte
result = oai.chat.completions.create(
model="gpt-4o-mini",
messages=[{"role": "user", "content": user_prompt}],
)
# Définir la sortie après l’appel de modèle
prediction.output = result.choices[0].message.content
# Journaliser des scores simples
prediction.log_score("correctness", 1.0)
prediction.log_score("ambiguity", 0.3)
# Utiliser un gestionnaire de contexte imbriqué pour les scores nécessitant des appels LLM
with prediction.log_score("llm_judge") as score:
judge_result = oai.chat.completions.create(
model="gpt-4o-mini",
messages=[
{"role": "system", "content": "Rate how funny the joke is from 1-5"},
{"role": "user", "content": prediction.output},
],
)
# Définir la valeur du score après le calcul
score.value = judge_result.choices[0].message.content
# finish() est appelé automatiquement à la sortie du bloc 'with'
ev.log_summary({"avg_score": 1.0})
```
Cette approche garantit que toutes les opérations imbriquées sont suivies et rattachées à la prédiction parente, ce qui vous permet d’obtenir des données précises sur l’utilisation des jetons et les coûts dans l’interface de Weights & Biases.
TypeScript ne dispose pas de l’instruction `with` de Python pour les gestionnaires de contexte. Utilisez plutôt l’approche fire-and-forget avec des appels explicites à `finish()`.
L’exemple suivant journalise une prédiction, ajoute des scores ainsi qu’un score de juge LLM, puis finalise la prédiction avec `finish()` :
```typescript twoslash lines {43} theme={"system"}
// @noErrors
import weave from 'weave';
import OpenAI from 'openai';
import {EvaluationLogger} from 'weave/evaluationLogger';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
const oai = new OpenAI();
// Initialiser le logger
const ev = new EvaluationLogger({
name: 'joke-eval',
model: 'gpt-4o-mini',
dataset: 'joke_dataset',
});
const userPrompt = 'Tell me a joke';
// Obtenir la sortie du modèle
const result = await oai.chat.completions.create({
model: 'gpt-4o-mini',
messages: [{role: 'user', content: userPrompt}],
});
const modelOutput = result.choices[0].message.content;
// Journaliser la prédiction avec sa sortie
const prediction = ev.logPrediction({user_prompt: userPrompt}, modelOutput);
// Journaliser des scores simples
prediction.logScore('correctness', 1.0);
prediction.logScore('ambiguity', 0.3);
// Pour les scores de juge LLM, effectuer l’appel et journaliser le résultat
const judgeResult = await oai.chat.completions.create({
model: 'gpt-4o-mini',
messages: [
{role: 'system', content: 'Rate how funny the joke is from 1-5'},
{role: 'user', content: modelOutput || ''},
],
});
prediction.logScore('llm_judge', judgeResult.choices[0].message.content);
// Appeler explicitement finish une fois la notation terminée
prediction.finish();
await ev.logSummary({avg_score: 1.0});
```
Même si TypeScript ne propose pas de nettoyage automatique via des gestionnaires de contexte, `logSummary()` termine automatiquement toutes les prédictions en cours avant d’agréger les résultats. Vous pouvez donc vous appuyer sur ce comportement si vous préférez ne pas appeler `finish()` explicitement.
Lier les traces d’agent aux évaluations
En Python, conservez chaque appel d’agent tracé à l’intérieur de son contexte `log_prediction()`. `EvaluationLogger` définit les métadonnées du run d’évaluation, de l’exemple et de l’essai sur les spans créés dans ce contexte, et Weave s’appuie sur ces métadonnées pour lier la trace à son résultat d’évaluation.
La liaison automatique entre les évaluations et les spans d’agent n’est disponible qu’en Python. Ni l’`EvaluationLogger` TypeScript ni `Evaluation.evaluate()` ne créent de portée d’évaluation active permettant de lier les spans d’agent. En TypeScript, la seule façon de lier un span consiste à définir directement les attributs OTel décrits dans cette section, et uniquement si les deux ID d’appel sont déjà disponibles.
L’exemple suivant utilise le [SDK OpenAI Agents](/fr/products/wandb/weave/guides/integrations/agents/openai-agents-sdk). Le même principe s’applique aux autres frameworks d’agents tracés par Weave. Remplacez `[YOUR-TEAM]/[YOUR-PROJECT]` par votre entity et votre projet W\&B.
```python lines {18-28} theme={"system"}
import weave
from agents import Agent, Runner
from weave import EvaluationLogger
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
agent = Agent(
name="Support agent",
instructions="Answer with only the city name.",
)
eval_logger = EvaluationLogger(
name="support-agent-eval",
model="support-agent",
dataset="support-prompts",
)
question = "What is the capital of France?"
with eval_logger.log_prediction(
inputs={"prompt": question},
example_id="capital-of-france",
) as prediction:
result = Runner.run_sync(agent, question)
output = str(result.final_output or "")
prediction.output = output
prediction.log_score(
scorer="contains_expected_answer",
score="paris" in output.lower(),
)
eval_logger.log_summary()
```
Cette fonctionnalité n’est pas disponible en TypeScript.
Si l’agent s’exécute avant le début du contexte de prédiction ou après sa fin, Weave enregistre la trace, mais ne la lie pas au résultat d’évaluation.
Weave lie automatiquement une trace à son résultat d’évaluation lorsque l’agent s’exécute dans le contexte `log_prediction()` et qu’une intégration Weave le trace, comme dans l’exemple de code précédent. Dans le cas contraire, vous devez définir vous-même les deux ID de liaison sur les spans d’agent. La marche à suivre dépend de l’endroit où les spans sont créés :
* **Même processus, avec votre propre instrumentation :** définissez les attributs directement sur chaque span.
* **Service distinct :** transmettez les deux ID à ce service, puis définissez-les sur les spans qu’il crée.
Lier les spans que vous instrumentez vous-même
Lorsque des spans sont créés dans le contexte de `log_prediction()`, l’`EvaluationLogger` définit automatiquement tous les attributs. En revanche, si vous envoyez des spans avec votre propre instrumentation OpenTelemetry (OTel), vous devez définir les attributs directement sur chaque span à lier. Vous pouvez définir les attributs suivants pour les évaluations :
| Attribut | Type | Description |
| - | - | - |
| `weave.eval.run_id` | string | (Requis) L’ID d’appel du run d’évaluation (`Evaluation.evaluate`). Nécessaire pour inclure le span dans le résultat **Voir les spans** au niveau de l’évaluation. |
| `weave.eval.predict_and_score_call_id` | string | (Requis) L’ID d’appel de l’opération `Evaluation.predict_and_score` pour un résultat et un essai donnés. Définissez-le avec `weave.eval.run_id` pour lier le span à ce résultat. |
| `weave.eval.kind` | string | (Facultatif) La catégorie d’évaluation. Weave utilise `agent` pour les évaluations d’agents et `standard` pour les évaluations standard. |
| `weave.eval.row_digest` | string | (Facultatif) Une empreinte stable qui identifie la ligne de jeu de données évaluée. `EvaluationLogger` calcule cette valeur à partir des entrées de la prédiction, sauf si vous en fournissez une. |
| `weave.eval.example_id` | string | (Facultatif) Un identifiant de l’exemple évalué, fourni par l’appelant. |
| `weave.eval.trial_index` | integer | (Facultatif) Le numéro d’essai (à partir de zéro) pour la ligne de jeu de données. |
| `weave.eval.evaluation_name` | string | (Facultatif) Le nom lisible de l’évaluation. |
| `weave.eval.project_id` | string | (Facultatif) Contexte de projet défini par le SDK Weave. Cet attribut n’achemine ni ne lie le span. Configurez plutôt le projet de destination sur la ressource OTel. |
Envoyez le span vers le même projet Weave que l’évaluation via le point de terminaison `/agents/otel/v1/traces`. Les attributs de span OTel ne se propagent pas des spans parents aux spans enfants : définissez donc les attributs sur chaque span à lier.
Pour plus d’informations sur le point de terminaison :
* Pour envoyer des spans depuis un pipeline OTel existant, voir [Envoyer des spans OpenTelemetry vers la vue Agents](/fr/products/wandb/weave/guides/tracking/trace-agents-otel).
* Pour la spécification du point de terminaison, voir [Exporter une trace GenAI](/fr/products/wandb/weave/reference/service-api/agents/export-genai-trace).
Seuls `weave.eval.run_id` et `weave.eval.predict_and_score_call_id` établissent les liens vers l’évaluation et le résultat. L’empreinte de ligne, l’ID d’exemple, l’index d’essai, la catégorie et le nom de l’évaluation apportent du contexte et permettent le filtrage, mais ne créent pas de lien à eux seuls. Pour les deux attributs de liaison, utilisez des ID d’appel Weave, et non des ID de trace ou de span OTel.
Vous pouvez obtenir ces deux ID via l’[API de requête des résultats d’évaluation](/fr/products/wandb/weave/reference/service-api/eval-results/eval-results-query). Dans la réponse, chaque évaluation comporte un `evaluation_call_id`, et chaque essai un `predict_and_score_call_id`.
Les exemples suivants supposent que `span` est le span OTel de l’opération de l’agent. Remplacez chaque valeur entre crochets par les métadonnées du run d’évaluation et du résultat auxquels le span appartient.
L’exemple TypeScript fonctionne, car il définit directement les attributs OTel au lieu de s’appuyer sur une portée de prédiction. Utilisez-le uniquement lorsque vous disposez déjà des deux ID d’appel.
```python lines theme={"system"}
span.set_attributes(
{
"weave.eval.run_id": "[EVALUATION-RUN-CALL-ID]",
"weave.eval.predict_and_score_call_id": "[PREDICT-AND-SCORE-CALL-ID]",
"weave.eval.kind": "agent",
"weave.eval.row_digest": "[ROW-DIGEST]",
"weave.eval.example_id": "[EXAMPLE-ID]",
"weave.eval.trial_index": 0,
"weave.eval.evaluation_name": "[EVALUATION-NAME]",
}
)
```
```typescript lines theme={"system"}
span.setAttributes({
'weave.eval.run_id': '[EVALUATION-RUN-CALL-ID]',
'weave.eval.predict_and_score_call_id': '[PREDICT-AND-SCORE-CALL-ID]',
'weave.eval.kind': 'agent',
'weave.eval.row_digest': '[ROW-DIGEST]',
'weave.eval.example_id': '[EXAMPLE-ID]',
'weave.eval.trial_index': 0,
'weave.eval.evaluation_name': '[EVALUATION-NAME]',
});
```
Lier un agent qui s’exécute dans un service distinct
Lorsque votre agent s’exécute en tant que service distinct, le processus d’évaluation et l’agent ne partagent pas de mémoire : Weave ne peut pas définir automatiquement les attributs de liaison, et vous ne pouvez pas accéder directement aux objets span de l’agent. Récupérez plutôt les deux ID d’appel dans le processus d’évaluation, envoyez-les au service, puis définissez-les sur les spans qui y sont créés. Ce modèle distribué basé sur `EvaluationLogger` est disponible uniquement en Python.
L’entrée dans le contexte `log_prediction()` crée l’appel `Evaluation.predict_and_score` avant l’exécution du corps du contexte. Le contexte génère un `ScoreLogger` (lié à `prediction` dans l’exemple suivant) qui expose les deux ID d’appel. Laissez le contexte ouvert jusqu’à ce que le service réponde, afin de pouvoir journaliser sa sortie et ses scores dans le même résultat d’évaluation.
Dans le processus d’évaluation, remplacez `[AGENT-SERVICE-URL]` par le point de terminaison qui exécute votre agent, ainsi que `[YOUR-TEAM]/[YOUR-PROJECT]` :
```python lines {16-37} theme={"system"}
import requests
import weave
from weave import EvaluationLogger
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
eval_logger = EvaluationLogger(
name="support-agent-eval",
model="support-agent",
dataset="support-prompts",
)
question = "What is the capital of France?"
example_id = "capital-of-france"
trial_index = 0
with eval_logger.log_prediction(
inputs={"prompt": question},
example_id=example_id,
trial_index=trial_index,
) as prediction:
eval_context = {
"weave.eval.run_id": prediction.evaluate_call.id,
"weave.eval.predict_and_score_call_id": (
prediction.predict_and_score_call.id
),
"weave.eval.kind": "agent",
"weave.eval.example_id": example_id,
"weave.eval.trial_index": trial_index,
"weave.eval.evaluation_name": "support-agent-eval",
}
response = requests.post(
"[AGENT-SERVICE-URL]",
json={"prompt": question, "eval_context": eval_context},
timeout=60,
)
response.raise_for_status()
prediction.output = response.json()["output"]
eval_logger.log_summary()
```
Dans le service de l’agent, copiez les attributs reçus sur chaque span d’agent que vous souhaitez associer au résultat. La fonction suivante illustre le côté réception avec un span OTel brut. Configurez le service pour qu’il exporte les spans vers le même `[YOUR-TEAM]/[YOUR-PROJECT]` que l’évaluation.
```python lines {16,22} theme={"system"}
from typing import Any
import weave
from agents import Agent, Runner
from opentelemetry import trace
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
tracer = trace.get_tracer(__name__)
agent = Agent(
name="Support agent",
instructions="Answer with only the city name.",
)
def run_agent(request_body: dict[str, Any]) -> dict[str, str]:
eval_context = request_body["eval_context"]
with tracer.start_as_current_span(
"invoke_agent Support agent",
attributes={
"gen_ai.operation.name": "invoke_agent",
"gen_ai.agent.name": "Support agent",
**eval_context,
},
):
result = Runner.run_sync(agent, request_body["prompt"])
return {"output": str(result.final_output or "")}
```
Dans cet exemple, le span encapsulant est lié au résultat de l’évaluation. Si le framework d’agent crée des spans supplémentaires, copiez également `eval_context` sur ces spans : dans OTel, les spans enfants n’héritent pas des attributs du span encapsulant.
Cette fonctionnalité n’est pas disponible en TypeScript.
Afficher les spans d’agent liés depuis vos évaluations
Pour inspecter les spans liés dans l’interface de Weights & Biases :
1. Accédez à [Forge](https://forge.coreweave.com/wandb).
2. Dans le menu latéral de Weave, cliquez sur **Evals**.
3. Sélectionnez votre run d’évaluation.
4. Dans le panneau de détails de l’évaluation qui s’ouvre, sous l’onglet **Évaluation**, cliquez sur **Voir les spans**. La page **Agents** s’ouvre alors sur l’onglet **Spans**, filtré sur cette évaluation.
Lier un jeu de données existant
Lorsque vous transmettez des jeux de données bruts comme `inputs` à `log_prediction`, Weave réimporte les données à chaque run d’évaluation. Les données sont alors stockées en double, ce qui peut gaspiller de l’espace si le jeu de données est volumineux ou si de nombreuses évaluations le réutilisent.
Pour éviter cette duplication, publiez votre jeu de données vers Weave avant de lancer vos évaluations, puis transmettez les lignes du jeu de données publié comme `inputs`. Weave résout les références aux lignes publiées au moyen de références internes, sans réimporter les données. Vous bénéficiez ainsi de la même expérience liée qu’avec le framework `Evaluation` standard, dans lequel chaque prédiction renvoie à une ligne de jeu de données précise dans l’interface utilisateur de Weights & Biases.
L’exemple suivant publie un jeu de données, le lie dans l’`EvaluationLogger`, puis le récupère et le parcourt comme n’importe quel autre jeu de données.
```python lines theme={"system"}
import weave
from weave import EvaluationLogger
weave.init("[YOUR-TEAM]/[YOUR-PROJECT]")
# Publier le jeu de données (une seule fois suffit)
dataset = weave.Dataset(
name="my_eval_dataset",
rows=[
{"question": "What is the capital of France?", "expected": "Paris"},
{"question": "What U.S. state is Seattle in?", "expected": "Washington"},
{"question": "In which country is Mount Fuji?", "expected": "Japan"},
],
)
weave.publish(dataset)
# Récupérer le jeu de données publié
dataset = weave.ref("my_eval_dataset").get()
```
```typescript twoslash lines theme={"system"}
// @noErrors
import weave, {EvaluationLogger, Dataset} from 'weave';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
// Publier le jeu de données (une seule fois suffit)
const dataset = new Dataset({
name: 'my_eval_dataset',
rows: [
{"question": "What is the capital of France?", "expected": "Paris"},
{"question": "What U.S. state is Seattle in?", "expected": "Washington"},
{"question": "In which country is Mount Fuji?", "expected": "Japan"},
],
});
const datasetRef = await dataset.save();
// Récupérer le jeu de données publié
const published = await datasetRef.get();
```
Obtenir les sorties avant la journalisation
Vous pouvez d’abord calculer les sorties de votre modèle, puis journaliser séparément les prédictions et les scores. Vous dissociez ainsi la logique d’évaluation de celle de journalisation, ce qui peut rendre le code plus facile à tester et à maintenir lorsque différentes parties de votre système gèrent la génération des prédictions et le calcul des scores.
```python lines theme={"system"}
# Initialiser EvaluationLogger AVANT d'appeler le modèle pour assurer le suivi des jetons
ev = EvaluationLogger(
model="example_model",
dataset="example_dataset"
)
# Les sorties du modèle (par ex. appels OpenAI) doivent être générées après l'initialisation du logger pour le suivi des jetons
outputs = [your_output_generator(**inputs) for inputs in your_dataset]
predictions = [ev.log_prediction(inputs, output) for inputs, output in zip(your_dataset, outputs)]
for prediction, output in zip(predictions, outputs):
prediction.log_score(scorer="greater_than_5_scorer", score=output > 5)
prediction.log_score(scorer="greater_than_7_scorer", score=output > 7)
prediction.finish()
ev.log_summary()
```
L’approche fire-and-forget est particulièrement efficace pour traiter plusieurs prédictions en parallèle.
L’exemple suivant traite des évaluations par lots en parallèle en créant plusieurs instances simultanées d’`EvaluationLogger` :
```typescript twoslash lines theme={"system"}
// @noErrors
// Initialiser EvaluationLogger AVANT d'appeler le modèle pour assurer le suivi des jetons
const ev = new EvaluationLogger({
name: 'parallel-eval',
model: 'example_model',
dataset: 'example_dataset'
});
// Les sorties du modèle, comme les appels OpenAI, doivent être générées après l'initialisation du logger pour le suivi des jetons
const outputs = await Promise.all(
yourDataset.map(inputs => yourOutputGenerator(inputs))
);
// Fire-and-forget : traiter toutes les prédictions sans await
const predictions = yourDataset.map((inputs, i) =>
ev.logPrediction(inputs, outputs[i])
);
predictions.forEach((prediction, i) => {
const output = outputs[i];
// Fire-and-forget : aucun await nécessaire
prediction.logScore('greater_than_5_scorer', output > 5);
prediction.logScore('greater_than_7_scorer', output > 7);
prediction.finish();
});
// logSummary attend la fin de toutes les opérations en attente
await ev.logSummary();
```
L’approche fire-and-forget vous permet de traiter en parallèle autant d’évaluations que vos ressources de calcul le permettent.
Les entrées, les sorties et les scores peuvent contenir des médias enrichis tels que des images, des vidéos, de l’audio ou des tableaux structurés. Journaliser des médias enrichis vous permet d’examiner le contenu réel à côté des scores dans l’interface de Weights & Biases, ce qui facilite l’analyse qualitative des modèles multimodaux. Transmettez un dict ou un objet multimédia aux méthodes `log_prediction` ou `log_score`.
```python lines theme={"system"}
import io
import wave
import struct
from PIL import Image
import random
from typing import Any
import weave
def generate_random_audio_wave_read(duration=2, sample_rate=44100):
n_samples = duration * sample_rate
amplitude = 32767 # Amplitude maximale sur 16 bits
buffer = io.BytesIO()
# Écrire les données wave dans le buffer
with wave.open(buffer, 'wb') as wf:
wf.setnchannels(1)
wf.setsampwidth(2) # 16 bits
wf.setframerate(sample_rate)
for _ in range(n_samples):
sample = random.randint(-amplitude, amplitude)
wf.writeframes(struct.pack(' dict[str, Any]:
return {
"result": random.randint(0, 10),
"image": image,
"audio": audio,
}
ev = EvaluationLogger(model="example_model", dataset="example_dataset")
for inputs in rich_media_dataset:
output = your_output_generator(**inputs)
prediction = ev.log_prediction(inputs, output)
prediction.log_score(scorer="greater_than_5_scorer", score=output["result"] > 5)
prediction.log_score(scorer="greater_than_7_scorer", score=output["result"] > 7)
ev.log_summary()
```
Le SDK TypeScript prend en charge la journalisation d’images et d’audio grâce aux fonctions `weaveImage` et `weaveAudio`. L’exemple suivant charge des fichiers image et audio, les fait traiter par un modèle, puis journalise les résultats avec leurs scores.
```typescript twoslash lines theme={"system"}
// @noErrors
import weave, {EvaluationLogger} from 'weave';
import * as fs from 'fs';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
// Charger des images et de l’audio à partir de fichiers
const richMediaDataset = [
{
image: weave.weaveImage({data: fs.readFileSync('sample1.png')}),
audio: weave.weaveAudio({data: fs.readFileSync('sample1.wav')}),
},
{
image: weave.weaveImage({data: fs.readFileSync('sample2.png')}),
audio: weave.weaveAudio({data: fs.readFileSync('sample2.wav')}),
},
];
// Modèle qui traite les médias et renvoie des résultats
const yourOutputGenerator = weave.op(
async (inputs: {image: any; audio: any}) => {
const result = Math.floor(Math.random() * 10);
return {
result,
image: inputs.image,
audio: inputs.audio,
};
},
{name: 'yourOutputGenerator'}
);
const ev = new EvaluationLogger({
name: 'rich-media-eval',
model: 'example_model',
dataset: 'example_dataset',
});
for (const inputs of richMediaDataset) {
const output = await yourOutputGenerator(inputs);
// Journaliser la prédiction avec des médias enrichis dans les entrées et les sorties
const prediction = ev.logPrediction(inputs, output);
prediction.logScore('greater_than_5_scorer', output.result > 5);
prediction.logScore('greater_than_7_scorer', output.result > 7);
prediction.finish();
}
await ev.logSummary();
```
Journaliser et comparer plusieurs évaluations
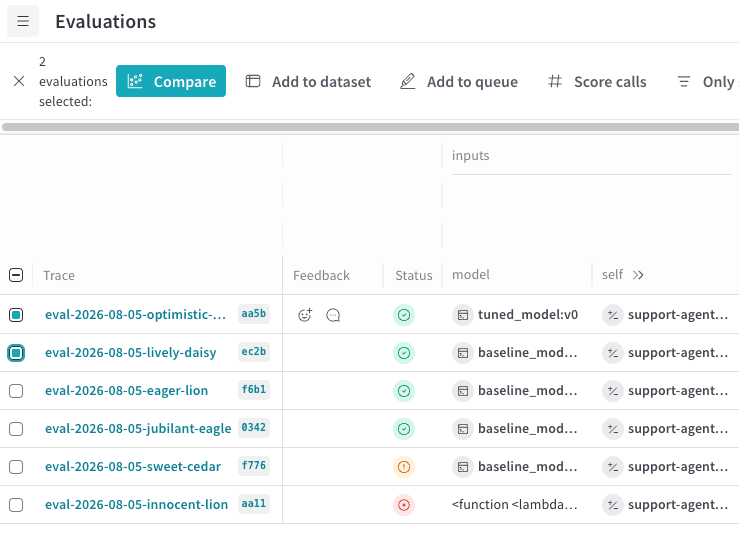
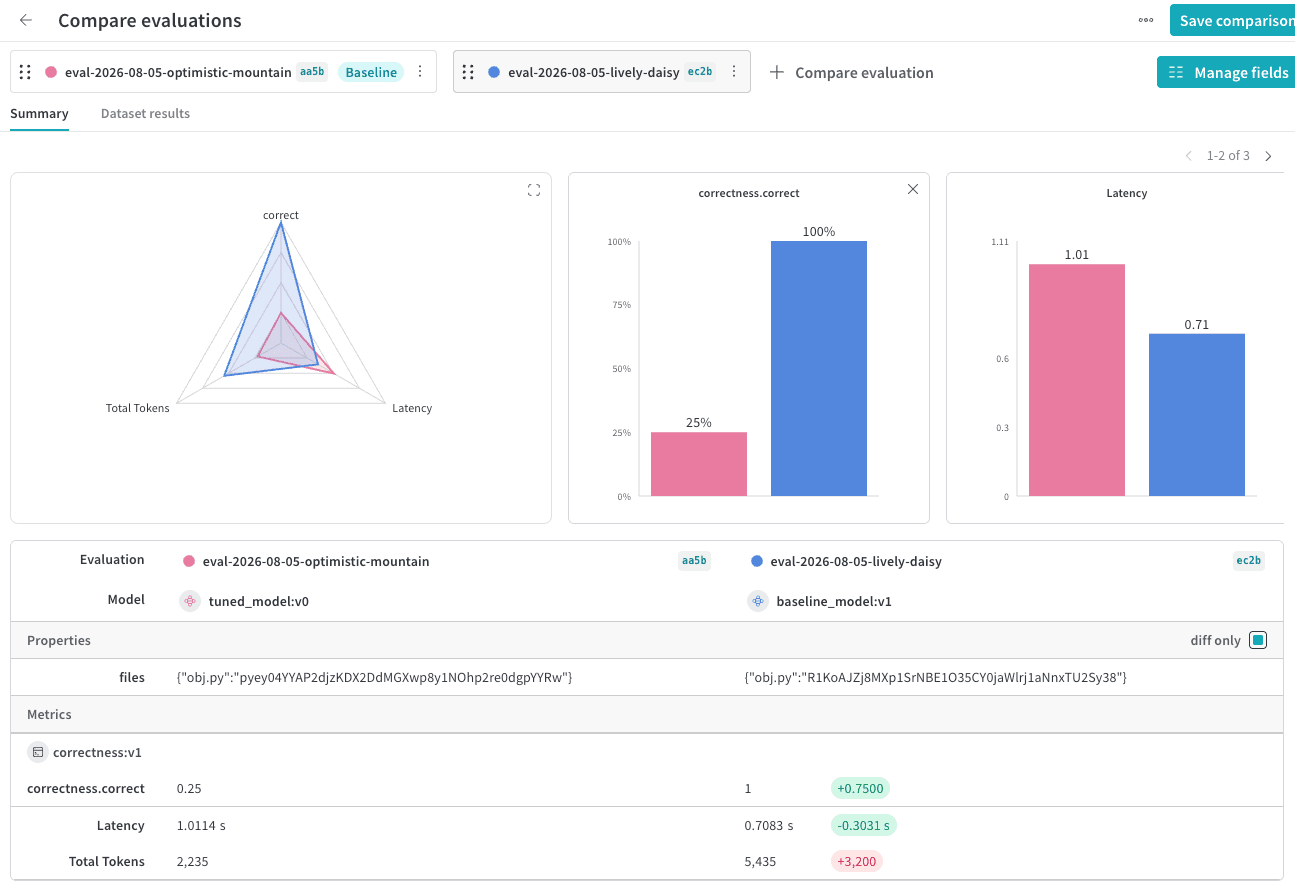
Avec `EvaluationLogger`, vous pouvez journaliser plusieurs évaluations et les comparer côte à côte dans l’interface Weights & Biases. Cela permet de comparer les performances de différents modèles sur un même jeu de données.
1. Exécutez l’exemple de code suivant.
2. Dans l’interface Weights & Biases, ouvrez l’onglet **Evals**.
3. Sélectionnez les évaluations que vous souhaitez comparer.
4. Cliquez sur **Compare**. Dans la vue Compare, vous pouvez :
* Choisir les évaluations à ajouter ou à retirer.
* Choisir les métriques à afficher ou à masquer.
* Parcourir des exemples précis pour voir comment différents modèles se sont comportés pour une même entrée d’un jeu de données donné.
Pour plus d’informations sur les comparaisons, consultez [Comparaisons](/fr/products/wandb/weave/guides/tools/comparison).
```python lines theme={"system"}
import weave
models = [
"model1",
"model2",
{"name": "model3", "metadata": {"coolness": 9001}}
]
for model in models:
# EvalLogger doit être initialisé avant les appels de modèle pour capturer les jetons
ev = EvaluationLogger(
name="comparison-eval",
model=model,
dataset="example_dataset",
scorers=["greater_than_3_scorer", "greater_than_5_scorer", "greater_than_7_scorer"],
eval_attributes={"experiment_id": "exp_123"}
)
for inputs in your_dataset:
output = your_output_generator(**inputs)
prediction = ev.log_prediction(inputs=inputs, output=output)
prediction.log_score(scorer="greater_than_3_scorer", score=output > 3)
prediction.log_score(scorer="greater_than_5_scorer", score=output > 5)
prediction.log_score(scorer="greater_than_7_scorer", score=output > 7)
prediction.finish()
ev.log_summary()
```
```typescript twoslash lines theme={"system"}
// @noErrors
import weave from 'weave';
import {EvaluationLogger} from 'weave/evaluationLogger';
import {WeaveObject} from 'weave/weaveObject';
await weave.init('[YOUR-TEAM]/[YOUR-PROJECT]');
const models = [
'model1',
'model2',
new WeaveObject({name: 'model3', metadata: {coolness: 9001}})
];
for (const model of models) {
// EvalLogger doit être initialisé avant les appels de modèle pour capturer les jetons
const ev = new EvaluationLogger({
name: 'comparison-eval',
model: model,
dataset: 'example_dataset',
description: 'Model comparison evaluation',
scorers: ['greater_than_3_scorer', 'greater_than_5_scorer', 'greater_than_7_scorer'],
attributes: {experiment_id: 'exp_123'}
});
for (const inputs of yourDataset) {
const output = await yourOutputGenerator(inputs);
// Approche fire-and-forget pour une journalisation propre et efficace
const prediction = ev.logPrediction(inputs, output);
prediction.logScore('greater_than_3_scorer', output > 3);
prediction.logScore('greater_than_5_scorer', output > 5);
prediction.logScore('greater_than_7_scorer', output > 7);
prediction.finish();
}
await ev.logSummary();
}
```
Conseils d’utilisation
Les conseils suivants vous aideront à tirer le meilleur parti de `EvaluationLogger` :
* Appelez `finish()` dès que possible après chaque prédiction.
* Utilisez `log_summary` pour capturer les métriques qui ne sont pas liées à une prédiction en particulier (par exemple, la latence globale).
* La journalisation de médias enrichis est utile pour l’analyse qualitative.
* **Finalisation automatique** : par souci de clarté, appelez explicitement `finish()` sur chaque prédiction. `logSummary()` finalise automatiquement toutes les prédictions qui ne l’ont pas encore été. Toutefois, une fois `finish()` appelé, vous ne pouvez plus journaliser de scores pour cette prédiction.
* **Options de configuration** : utilisez les options de configuration, notamment `name`, `description`, `dataset`, `model`, `scorers` et `attributes`, pour organiser et filtrer vos évaluations dans l’interface de Weights & Biases.
## Related topics
- [Créer et suivre des graphiques à partir d’expériences](/fr/products/wandb/track/log/plots.md)