> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Gestion des données PII
> Gérez les informations personnelles identifiables (PII) dans les applications LLM à l'aide des outils de masquage et de filtrage des données de W&B Weave.
Ceci est un notebook interactif. Vous pouvez l'exécuter localement ou utiliser les liens ci-dessous :
* [Ouvrir dans Google Colab](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/pii.ipynb)
* [Voir la source sur GitHub](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/pii.ipynb)
Dans ce guide, vous apprendrez à utiliser W\&B Weave tout en préservant la confidentialité de vos informations personnelles identifiables (PII). Protéger les PII vous permet de respecter les exigences de confidentialité et de conformité, tout en tirant parti du traçage et de l'évaluation des LLM. Ce guide s'adresse aux développeurs qui intègrent Weave dans des applications LLM traitant des données utilisateur sensibles.
Ce guide présente les méthodes suivantes pour identifier, masquer et anonymiser les données PII :
1. **Les expressions régulières**, pour identifier et masquer les données PII.
2. **[Presidio](https://microsoft.github.io/presidio/) de Microsoft**, un SDK Python de protection des données. Cet outil fournit des fonctionnalités de masquage et de remplacement.
3. **[Faker](https://faker.readthedocs.io/en/master/)**, une bibliothèque Python qui génère des données fictives, combinée à Presidio pour anonymiser les données PII.
Vous apprendrez également à utiliser la *personnalisation de la journalisation des entrées/sorties de `weave.op`* et *`autopatch_settings`* pour intégrer le masquage et l'anonymisation des PII à votre flux de travail. Pour plus d'informations, voir [Personnaliser les entrées et sorties journalisées](/fr/products/wandb/weave/guides/tracking/ops#customize-logged-inputs-and-outputs).
Pour commencer, procédez comme suit :
1. Consultez la section [Aperçu](#overview).
2. Vérifiez que les [prérequis](#prerequisites) sont remplis.
3. Découvrez les [méthodes disponibles](#redaction-methods-overview) pour identifier, masquer et anonymiser les données PII.
4. [Appliquez ces méthodes aux appels Weave](#apply-the-methods-to-weave-calls).
Aperçu
Cette section présente la journalisation des entrées et des sorties à l’aide de `weave.op`, ainsi que les bonnes pratiques pour manipuler des données personnelles identifiables (PII) dans Weave.
Les ops Weave vous permettent de définir des fonctions de post-traitement des entrées et des sorties. Ces fonctions vous permettent de modifier les données transmises à votre appel LLM ou journalisées dans Weave.
L’exemple suivant définit deux fonctions de post-traitement et les transmet comme arguments à `weave.op()`.
```python lines theme={"system"}
from dataclasses import dataclass
from typing import Any
import weave
# Classe d’encapsulation des entrées
@dataclass
class CustomObject:
x: int
secret_password: str
# Commencez par définir les fonctions de post-traitement des entrées et des sorties :
def postprocess_inputs(inputs: dict[str, Any]) -> dict[str, Any]:
return {k:v for k,v in inputs.items() if k != "hide_me"}
def postprocess_output(output: CustomObject) -> CustomObject:
return CustomObject(x=output.x, secret_password="REDACTED")
# Ensuite, lorsque vous utilisez le décorateur `@weave.op`, passez-lui ces fonctions de traitement en arguments :
@weave.op(
postprocess_inputs=postprocess_inputs,
postprocess_output=postprocess_output,
)
def some_llm_call(a: int, hide_me: str) -> CustomObject:
return CustomObject(x=a, secret_password=hide_me)
```
Bonnes pratiques pour utiliser Weave avec des données personnelles (PII)
Avant d’utiliser Weave avec des données personnelles (PII), consultez les bonnes pratiques suivantes. Elles sont regroupées par étape du cycle de vie du développement et complétées par des recommandations sur le chiffrement.
Pendant les tests
* Journalisez des données anonymisées pour vérifier la détection des PII.
* Suivez les processus de gestion des PII avec Weave Traces.
* Mesurez les performances de l’anonymisation sans exposer de véritables PII.
En production
* Ne journalisez jamais de données personnelles identifiables (PII) brutes.
* Chiffrez les champs sensibles avant la journalisation.
Conseils de chiffrement
* Utilisez un chiffrement réversible pour les données que vous devrez déchiffrer ultérieurement.
* Appliquez un hachage à sens unique aux ID uniques qu’il n’est pas nécessaire de retrouver en clair.
* Envisagez un chiffrement spécialisé pour les données que vous devez analyser sans les déchiffrer.
Prérequis
Avant d’appliquer l’une des méthodes de masquage, effectuez les étapes de configuration suivantes pour installer les dépendances, configurer les clés API, initialiser votre projet Weave et charger les données d’exemple.
1. Commencez par installer les paquets requis.
```python lines theme={"system"}
%%capture
# @title paquets Python requis :
!pip install cryptography
!pip install presidio_analyzer
!pip install presidio_anonymizer
!python -m spacy download en_core_web_lg # Presidio utilise le moteur NLP de spaCy
!pip install Faker # nous utiliserons Faker pour remplacer les données personnelles par des données fictives
!pip install weave # Pour tirer parti des traces
!pip install set-env-colab-kaggle-dotenv -q # pour les variables d’environnement
!pip install anthropic # pour utiliser Sonnet
!pip install cryptography # pour chiffrer nos données
```
2. Créez des clés API aux emplacements suivants :
* [Paramètres utilisateur W\&B](https://forge.coreweave.com/settings)
* [Anthropic Console](https://platform.claude.com/login?returnTo=%2Fsettings%2Fkeys)
```python lines theme={"system"}
%%capture
# @title Configurer correctement vos clés API
# Voir https://pypi.org/project/set-env-colab-kaggle-dotenv/ pour les instructions d’utilisation.
from set_env import set_env
_ = set_env("ANTHROPIC_API_KEY")
_ = set_env("WANDB_API_KEY")
```
3. Initialisez votre projet Weave.
```python lines theme={"system"}
import weave
# Créer un nouveau projet Weave
WEAVE_PROJECT = "pii_cookbook"
weave.init(WEAVE_PROJECT)
```
4. Chargez le jeu de données de démonstration contenant des PII, qui comprend 10 blocs de texte.
```python lines theme={"system"}
import requests
url = "https://raw.githubusercontent.com/wandb/docs/main/weave/cookbooks/source/10_pii_data.json"
response = requests.get(url)
pii_data = response.json()
print('PII data first sample: "' + pii_data[0]["text"] + '"')
```
Aperçu des méthodes de masquage
Une fois les [prérequis](#prerequisites) remplis, vous pouvez choisir l’une des méthodes suivantes pour détecter et protéger les données personnelles (PII). Chaque méthode identifie et masque les PII, et peut également les anonymiser :
1. Des **expressions régulières** pour identifier les PII et les masquer.
2. **Microsoft [Presidio](https://microsoft.github.io/presidio/)**, un SDK Python de protection des données qui fournit des fonctionnalités de masquage et de remplacement.
3. **[Faker](https://faker.readthedocs.io/en/master/)**, une bibliothèque Python permettant de générer des données fictives.
Méthode 1 : Filtrer à l’aide d’expressions régulières
Les [expressions régulières (regex)](https://docs.python.org/3/library/re.html) constituent une méthode simple pour identifier et masquer les données personnelles (PII). Les regex vous permettent de définir des motifs capables de reconnaître différents formats d’informations sensibles, comme les numéros de téléphone, les adresses e-mail ou les numéros de sécurité sociale. Grâce aux regex, vous pouvez parcourir de grands volumes de texte et remplacer ou masquer des informations sans recourir à des techniques de NLP plus complexes.
```python lines theme={"system"}
import re
# Définir une fonction qui nettoie les données personnelles (PII) à l’aide d’expressions régulières
def redact_with_regex(text):
# Motif de numéro de téléphone
# \b : Limite de mot
# \d{3} : Exactement 3 chiffres
# [-.]? : Tiret ou point facultatif
# \d{3} : 3 autres chiffres
# [-.]? : Tiret ou point facultatif
# \d{4} : Exactement 4 chiffres
# \b : Limite de mot
text = re.sub(r"\b\d{3}[-.]?\d{3}[-.]?\d{4}\b", "", text)
# Motif d’adresse e-mail
# \b : Limite de mot
# [A-Za-z0-9._%+-]+ : Un ou plusieurs caractères autorisés dans la partie locale d’une adresse e-mail
# @ : Caractère @ littéral
# [A-Za-z0-9.-]+ : Un ou plusieurs caractères autorisés dans un nom de domaine
# \. : Point littéral
# [A-Z|a-z]{2,} : Au moins deux lettres majuscules ou minuscules (TLD)
# \b : Limite de mot
text = re.sub(
r"\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Z|a-z]{2,}\b", "", text
)
# Motif de numéro de sécurité sociale américain (SSN)
# \b : Limite de mot
# \d{3} : Exactement 3 chiffres
# - : Tiret littéral
# \d{2} : Exactement 2 chiffres
# - : Tiret littéral
# \d{4} : Exactement 4 chiffres
# \b : Limite de mot
text = re.sub(r"\b\d{3}-\d{2}-\d{4}\b", "", text)
# Motif de nom simple (non exhaustif)
# \b : Limite de mot
# [A-Z] : Une lettre majuscule
# [a-z]+ : Une ou plusieurs lettres minuscules
# \s : Un caractère d’espacement
# [A-Z] : Une lettre majuscule
# [a-z]+ : Une ou plusieurs lettres minuscules
# \b : Limite de mot
text = re.sub(r"\b[A-Z][a-z]+ [A-Z][a-z]+\b", "", text)
return text
```
Pour tester la fonction, exécutez le code suivant avec un exemple de texte :
```python lines theme={"system"}
# Tester la fonction
test_text = "My name is John Doe, my email is john.doe@example.com, my phone is 123-456-7890, and my SSN is 123-45-6789."
cleaned_text = redact_with_regex(test_text)
print(f"Raw text:\n\t{test_text}")
print(f"Redacted text:\n\t{cleaned_text}")
```
Méthode 2 : masquer avec Microsoft Presidio
Cette méthode supprime entièrement les données PII à l’aide de [Microsoft Presidio](https://microsoft.github.io/presidio/). Presidio masque les PII et les remplace par un espace réservé indiquant le type de PII. Par exemple, dans `"My name is Alex"`, Presidio remplace `Alex` par ``.
Presidio prend en charge nativement les [entités courantes](https://microsoft.github.io/presidio/supported_entities/). L’exemple suivant masque toutes les entités de type `PHONE_NUMBER`, `PERSON`, `LOCATION`, `EMAIL_ADDRESS` ou `US_SSN`. Le traitement Presidio est encapsulé dans une fonction.
```python lines theme={"system"}
from presidio_analyzer import AnalyzerEngine
from presidio_anonymizer import AnonymizerEngine
# Configurer l’Analyzer, qui charge un module NLP (un modèle spaCy par défaut) ainsi que d’autres outils de reconnaissance des données personnelles (PII).
analyzer = AnalyzerEngine()
# Configurer l’Anonymizer, qui utilisera les résultats de l’Analyzer pour anonymiser le texte.
anonymizer = AnonymizerEngine()
# Encapsuler le processus de masquage Presidio dans une fonction
def redact_with_presidio(text):
# Analyser le texte pour identifier les données personnelles (PII)
results = analyzer.analyze(
text=text,
entities=["PHONE_NUMBER", "PERSON", "LOCATION", "EMAIL_ADDRESS", "US_SSN"],
language="en",
)
# Anonymiser les données personnelles (PII) identifiées
anonymized_text = anonymizer.anonymize(text=text, analyzer_results=results)
return anonymized_text.text
```
Pour tester la fonction, exécutez le code suivant avec un exemple de texte :
```python lines theme={"system"}
text = "My phone number is 212-555-5555 and my name is alex"
# Tester la fonction
anonymized_text = redact_with_presidio(text)
print(f"Raw text:\n\t{text}")
print(f"Redacted text:\n\t{anonymized_text}")
```
Méthode 3 : anonymiser par remplacement avec Faker et Presidio
Au lieu de masquer le texte, vous pouvez l’anonymiser : MS Presidio remplace alors les données personnelles (PII), comme les noms et les numéros de téléphone, par des données fictives générées par la bibliothèque Python [Faker](https://faker.readthedocs.io/en/master/). Par exemple, supposons que vous disposiez des données suivantes :
`"My name is Raphael and I like to fish. My phone number is 212-555-5555"`
Une fois traitées par Presidio et Faker, ces données pourraient ressembler à ceci :
`"My name is Katherine Dixon and I like to fish. My phone number is 667.431.7379"`
Pour utiliser Presidio conjointement avec Faker, vous devez fournir des références à vos opérateurs personnalisés. Ces opérateurs indiquent à Presidio les fonctions Faker chargées de remplacer les données personnelles par des données fictives.
```python lines theme={"system"}
from faker import Faker
from presidio_anonymizer import AnonymizerEngine
from presidio_anonymizer.entities import OperatorConfig
fake = Faker()
# Créer les fonctions Faker (notez qu’elles doivent recevoir une valeur en argument)
def fake_name(x):
return fake.name()
def fake_number(x):
return fake.phone_number()
# Créer un opérateur personnalisé pour les entités PERSON et PHONE_NUMBER"
operators = {
"PERSON": OperatorConfig("custom", {"lambda": fake_name}),
"PHONE_NUMBER": OperatorConfig("custom", {"lambda": fake_number}),
}
text_to_anonymize = (
"My name is Raphael and I like to fish. My phone number is 212-555-5555"
)
# Sortie de l’analyseur
analyzer_results = analyzer.analyze(
text=text_to_anonymize, entities=["PHONE_NUMBER", "PERSON"], language="en"
)
anonymizer = AnonymizerEngine()
# n’oubliez pas de transmettre à l’anonymiseur les opérateurs définis ci-dessus
anonymized_results = anonymizer.anonymize(
text=text_to_anonymize, analyzer_results=analyzer_results, operators=operators
)
print(f"Raw text:\n\t{text_to_anonymize}")
print(f"Anonymized text:\n\t{anonymized_results.text}")
```
Pour regrouper le code dans une seule classe et compléter la liste des entités avec celles identifiées précédemment, exécutez le code suivant :
```python lines theme={"system"}
from typing import ClassVar
from faker import Faker
from presidio_anonymizer import AnonymizerEngine
from presidio_anonymizer.entities import OperatorConfig
# Une classe personnalisée qui étend Faker pour générer des données fictives
class MyFaker(Faker):
# Créer les fonctions Faker (notez qu’elles doivent recevoir une valeur)
def fake_address(self):
return fake.address()
def fake_ssn(self):
return fake.ssn()
def fake_name(self):
return fake.name()
def fake_number(self):
return fake.phone_number()
def fake_email(self):
return fake.email()
# Créer des opérateurs personnalisés pour les entités
operators: ClassVar[dict[str, OperatorConfig]] = {
"PERSON": OperatorConfig("custom", {"lambda": fake_name}),
"PHONE_NUMBER": OperatorConfig("custom", {"lambda": fake_number}),
"EMAIL_ADDRESS": OperatorConfig("custom", {"lambda": fake_email}),
"LOCATION": OperatorConfig("custom", {"lambda": fake_address}),
"US_SSN": OperatorConfig("custom", {"lambda": fake_ssn}),
}
def redact_and_anonymize_with_faker(self, text):
anonymizer = AnonymizerEngine()
analyzer_results = analyzer.analyze(
text=text,
entities=["PHONE_NUMBER", "PERSON", "LOCATION", "EMAIL_ADDRESS", "US_SSN"],
language="en",
)
anonymized_results = anonymizer.anonymize(
text=text, analyzer_results=analyzer_results, operators=self.operators
)
return anonymized_results.text
```
Pour tester la fonction, exécutez le code suivant avec un exemple de texte :
```python lines theme={"system"}
faker = MyFaker()
text_to_anonymize = (
"My name is Raphael and I like to fish. My phone number is 212-555-5555"
)
anonymized_text = faker.redact_and_anonymize_with_faker(text_to_anonymize)
print(f"Raw text:\n\t{text_to_anonymize}")
print(f"Anonymized text:\n\t{anonymized_text}")
```
Méthode 4 : utiliser `autopatch_settings`
Vous pouvez utiliser `autopatch_settings` pour configurer la gestion des données personnelles (PII) directement lors de l'initialisation, pour une ou plusieurs des intégrations LLM prises en charge. W\&B recommande cette approche si vous souhaitez centraliser la gestion des PII pour tous les appels à une intégration donnée. Cette méthode présente les avantages suivants :
1. La logique de gestion des PII est centralisée et définie dès l'initialisation, ce qui évite de disperser une logique personnalisée dans le code.
2. Vous pouvez personnaliser ou désactiver entièrement les flux de travail de traitement des PII pour certaines intégrations.
Pour configurer la gestion des PII avec `autopatch_settings`, définissez `postprocess_inputs` ou `postprocess_output` dans `op_settings` pour l'une des intégrations LLM prises en charge.
```python lines theme={"system"}
def postprocess(inputs: dict) -> dict:
if "SENSITIVE_KEY" in inputs:
inputs["SENSITIVE_KEY"] = "REDACTED"
return inputs
client = weave.init(
...,
autopatch_settings={
"openai": {
"op_settings": {
"postprocess_inputs": postprocess,
"postprocess_output": ...,
}
},
"anthropic": {
"op_settings": {
"postprocess_inputs": ...,
"postprocess_output": ...,
}
}
},
)
```
Appliquer les méthodes aux appels Weave
Maintenant que vous avez vu chaque méthode de masquage séparément, les exemples suivants montrent comment les intégrer dans des modèles Weave et prévisualiser les résultats dans Weave Traces.
Commencez par créer un [modèle Weave](/fr/products/wandb/weave/guides/core-types/models). Un modèle Weave regroupe des informations telles que les paramètres de configuration, les poids du modèle et le code qui définit le fonctionnement du modèle.
Le modèle comprend une fonction predict qui appelle l’API Anthropic. Claude Sonnet d’Anthropic effectue une analyse de sentiment, tandis que les appels LLM sont tracés à l’aide de [Traces](/fr/products/wandb/weave/quickstart). Claude Sonnet reçoit un bloc de texte et renvoie l’une des classifications de sentiment suivantes : *positif*, *négatif* ou *neutre*. Le modèle comprend également les fonctions de post-traitement qui garantissent que les données personnelles (PII) sont masquées ou anonymisées avant d’être envoyées au LLM.
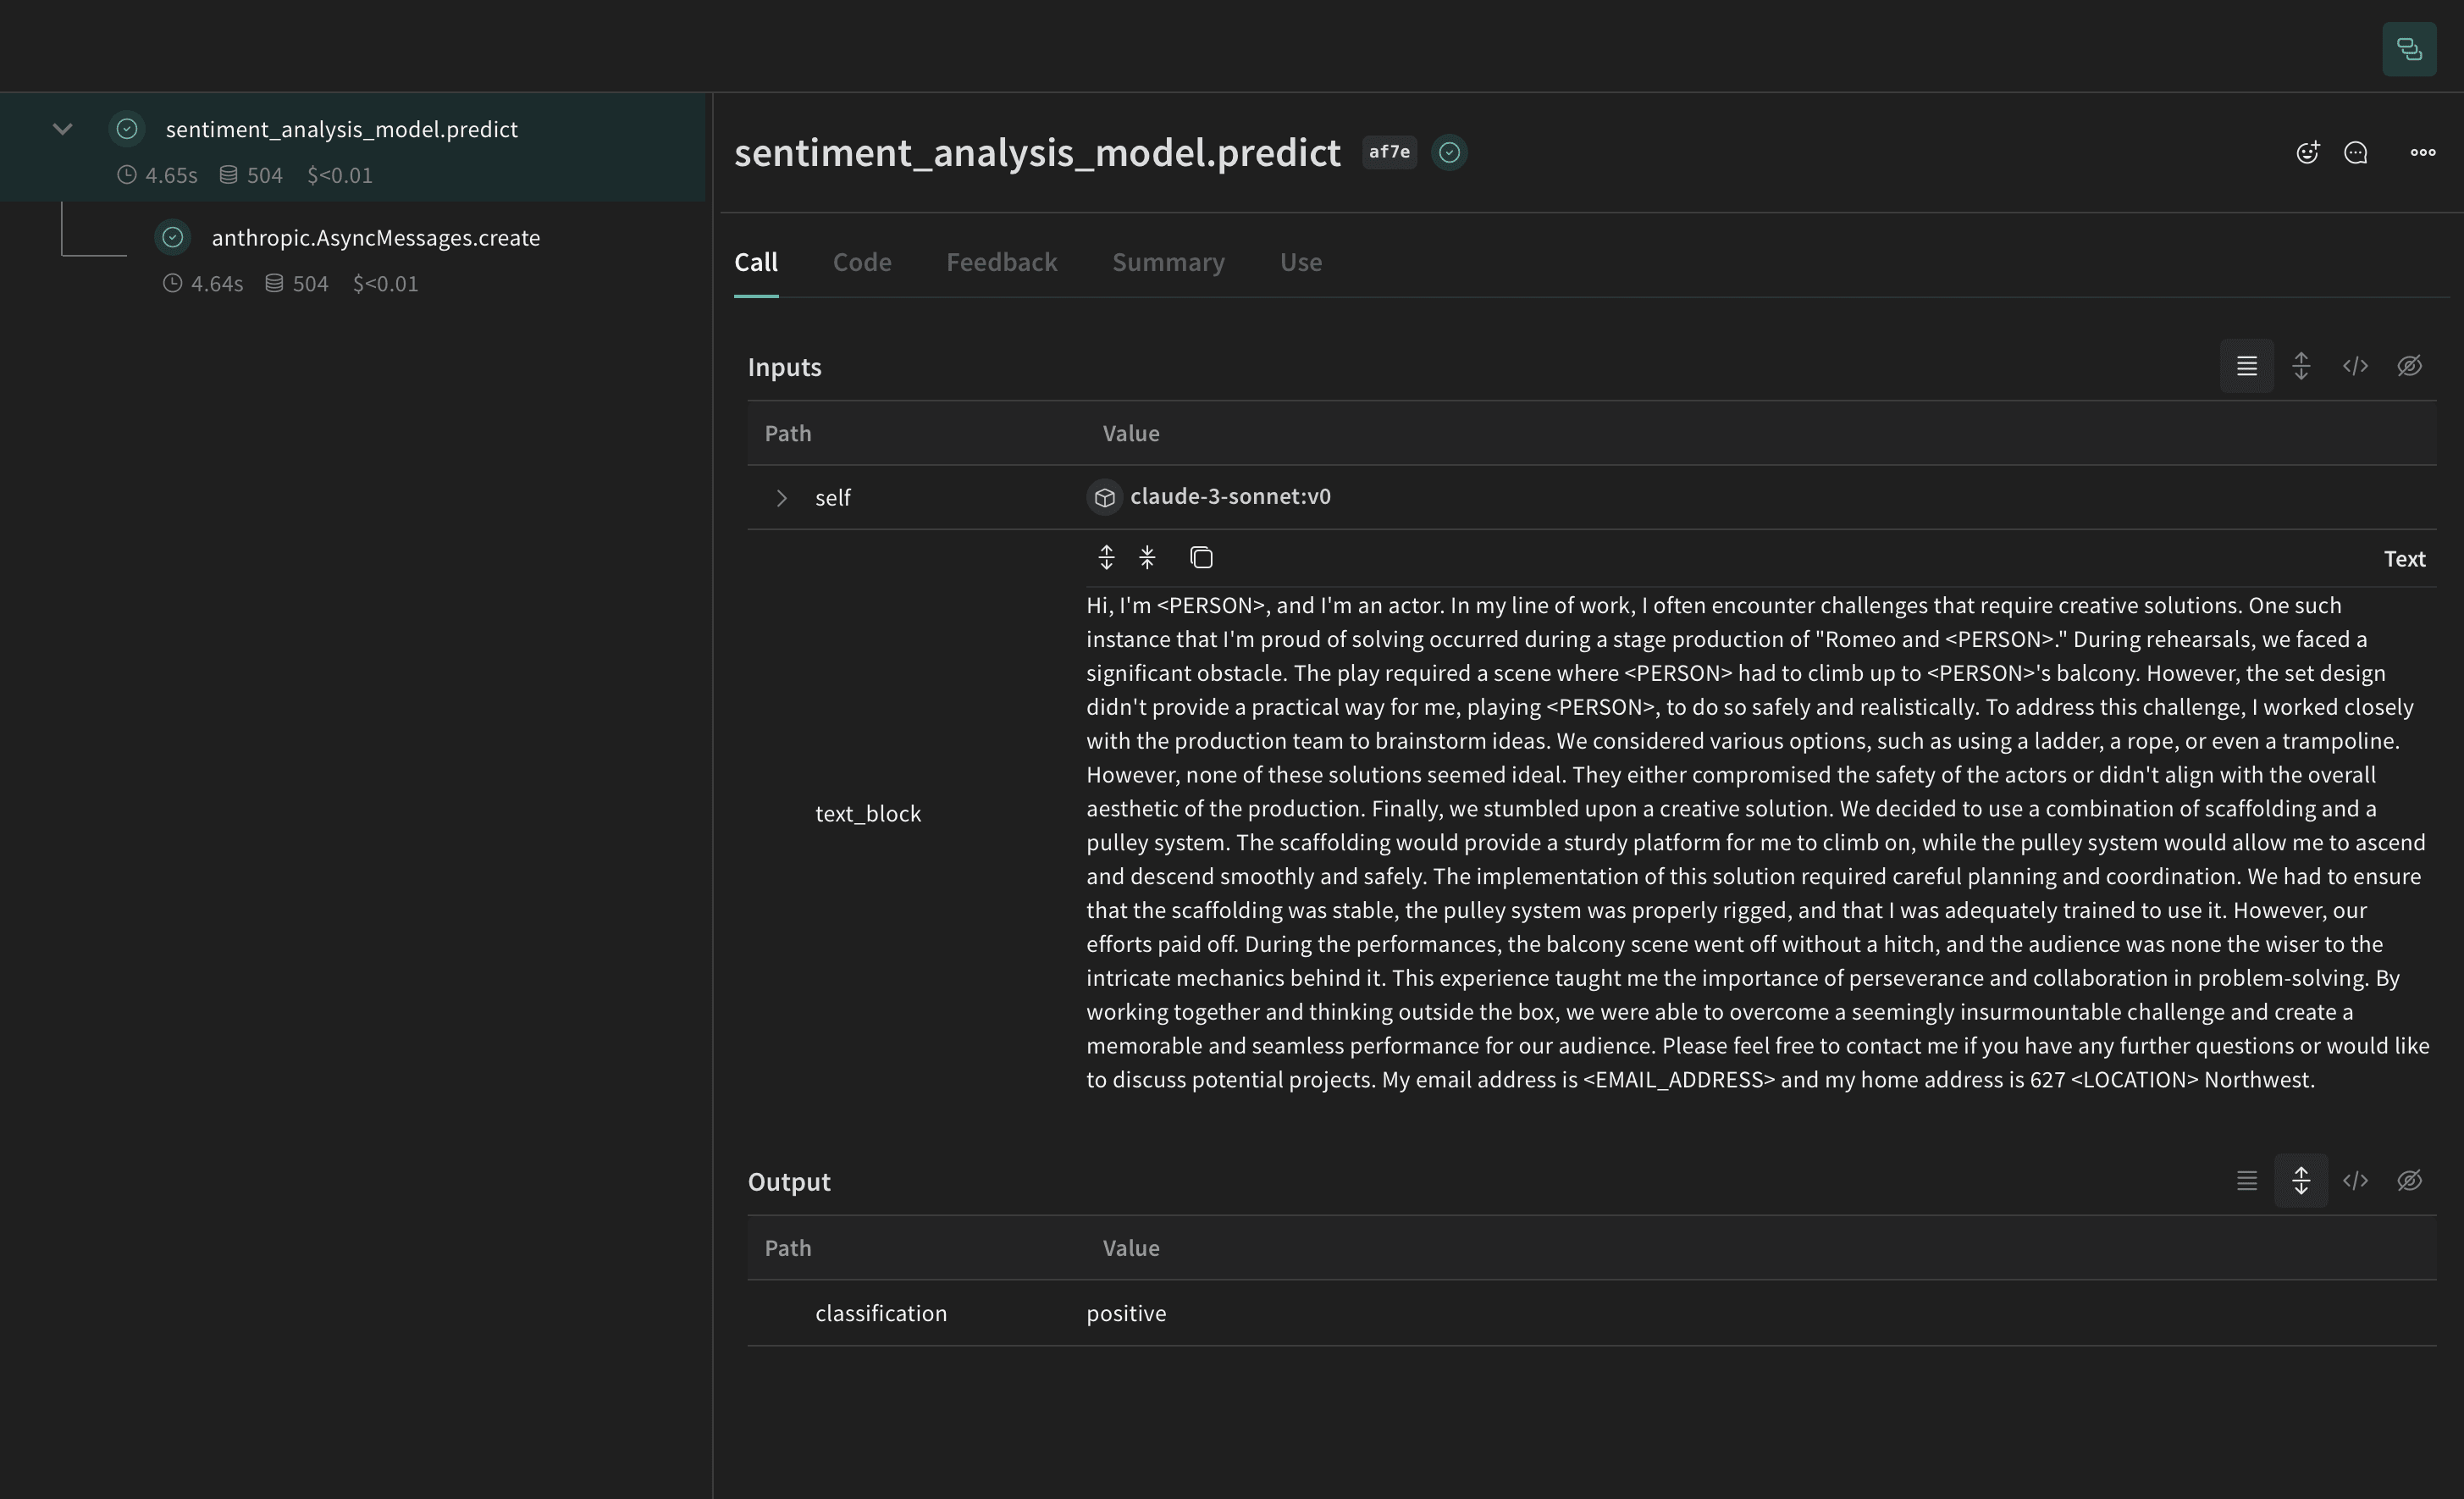
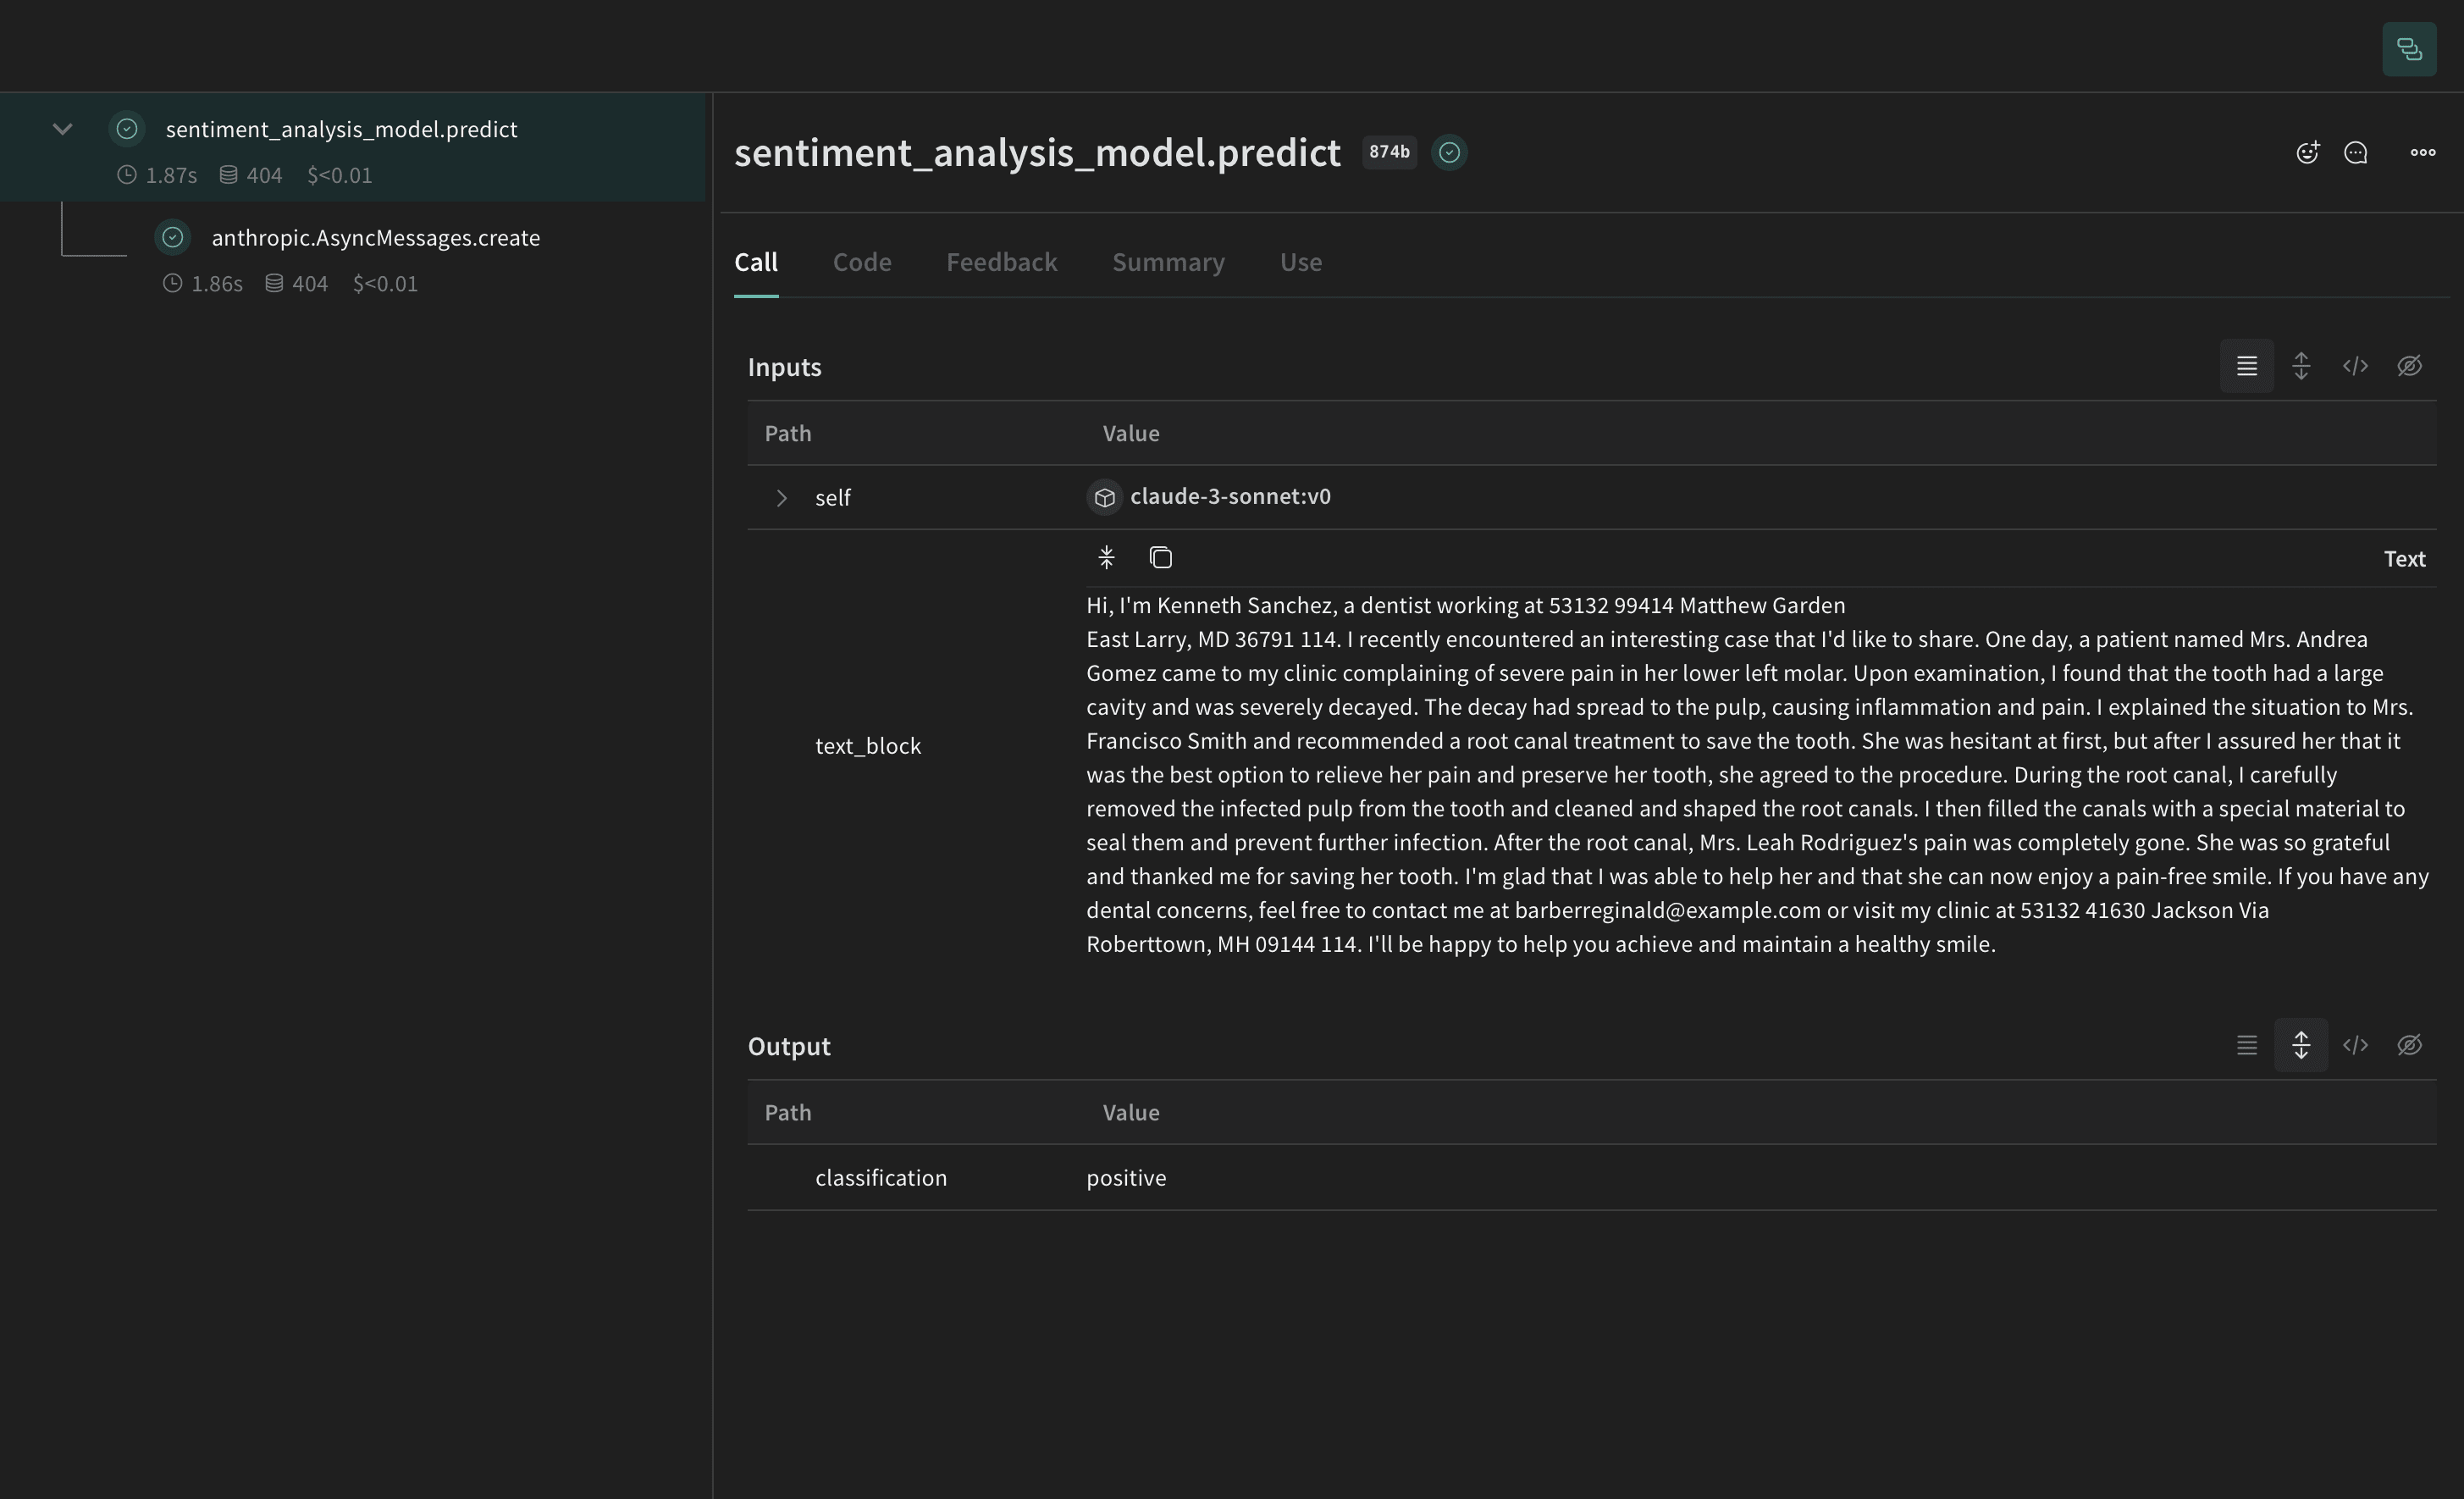
Une fois ce code exécuté, vous obtenez des liens vers la page du projet Weave, ainsi que vers la trace (appels LLM) correspondant à votre exécution. Utilisez ces liens pour vérifier que les fonctions de post-traitement ont bien masqué ou anonymisé l’entrée avant qu’elle n’atteigne le LLM.
Méthode regex
Pour commencer, vous pouvez utiliser des regex afin d’identifier et de masquer les données personnelles (PII) dans le texte d’origine.
```python lines theme={"system"}
import json
from typing import Any
import anthropic
import weave
# Définir une fonction de post-traitement des entrées qui applique notre masquage par regex à l’op Weave de prédiction du modèle
def postprocess_inputs_regex(inputs: dict[str, Any]) -> dict:
inputs["text_block"] = redact_with_regex(inputs["text_block"])
return inputs
# Modèle Weave / fonction predict
class SentimentAnalysisRegexPiiModel(weave.Model):
model_name: str
system_prompt: str
temperature: int
@weave.op(
postprocess_inputs=postprocess_inputs_regex,
)
async def predict(self, text_block: str) -> dict:
client = anthropic.AsyncAnthropic()
response = await client.messages.create(
max_tokens=1024,
model=self.model_name,
system=self.system_prompt,
messages=[
{"role": "user", "content": [{"type": "text", "text": text_block}]}
],
)
result = response.content[0].text
if result is None:
raise ValueError("No response from model")
parsed = json.loads(result)
return parsed
```
```python lines theme={"system"}
# créer notre modèle LLM avec un prompt système
model = SentimentAnalysisRegexPiiModel(
name="claude-3-sonnet",
model_name="claude-3-5-sonnet-20240620",
system_prompt='You are a Sentiment Analysis classifier. You will be classifying text based on their sentiment. Your input will be a block of text. You will answer with one the following rating option["positive", "negative", "neutral"]. Your answer should be one word in json format: {classification}. Ensure that it is valid JSON.',
temperature=0,
)
print("Model: ", model)
# pour chaque bloc de texte, anonymiser d'abord, puis effectuer la prédiction
for entry in pii_data:
await model.predict(entry["text"])
```
Méthode de masquage Presidio
Utilisez ensuite Presidio pour identifier et masquer les données PII du texte original.
 ```python lines theme={"system"}
from typing import Any
import weave
# Définir une fonction de post-traitement des entrées qui applique notre masquage Presidio à l’op Weave de prédiction du modèle
def postprocess_inputs_presidio(inputs: dict[str, Any]) -> dict:
inputs["text_block"] = redact_with_presidio(inputs["text_block"])
return inputs
# Modèle Weave / fonction predict
class SentimentAnalysisPresidioPiiModel(weave.Model):
model_name: str
system_prompt: str
temperature: int
@weave.op(
postprocess_inputs=postprocess_inputs_presidio,
)
async def predict(self, text_block: str) -> dict:
client = anthropic.AsyncAnthropic()
response = await client.messages.create(
max_tokens=1024,
model=self.model_name,
system=self.system_prompt,
messages=[
{"role": "user", "content": [{"type": "text", "text": text_block}]}
],
)
result = response.content[0].text
if result is None:
raise ValueError("No response from model")
parsed = json.loads(result)
return parsed
```
```python lines theme={"system"}
# créer notre modèle LLM avec un prompt système
model = SentimentAnalysisPresidioPiiModel(
name="claude-3-sonnet",
model_name="claude-3-5-sonnet-20240620",
system_prompt='You are a Sentiment Analysis classifier. You will be classifying text based on their sentiment. Your input will be a block of text. You will answer with one the following rating option["positive", "negative", "neutral"]. Your answer should be one word in json format: {classification}. Ensure that it is valid JSON.',
temperature=0,
)
print("Model: ", model)
# pour chaque bloc de texte, anonymiser d'abord, puis effectuer la prédiction
for entry in pii_data:
await model.predict(entry["text"])
```
Méthode de remplacement avec Faker et Presidio
Dans cet exemple, vous utilisez Faker pour générer des données PII de remplacement anonymisées, et Presidio pour identifier et remplacer les données PII dans le texte d’origine.
 ```python lines theme={"system"}
from typing import Any
import weave
# Définir une fonction de post-traitement des entrées qui applique notre anonymisation Faker et le masquage Presidio à l’op Weave de prédiction du modèle
faker = MyFaker()
def postprocess_inputs_faker(inputs: dict[str, Any]) -> dict:
inputs["text_block"] = faker.redact_and_anonymize_with_faker(inputs["text_block"])
return inputs
# Modèle Weave / fonction predict
class SentimentAnalysisFakerPiiModel(weave.Model):
model_name: str
system_prompt: str
temperature: int
@weave.op(
postprocess_inputs=postprocess_inputs_faker,
)
async def predict(self, text_block: str) -> dict:
client = anthropic.AsyncAnthropic()
response = await client.messages.create(
max_tokens=1024,
model=self.model_name,
system=self.system_prompt,
messages=[
{"role": "user", "content": [{"type": "text", "text": text_block}]}
],
)
result = response.content[0].text
if result is None:
raise ValueError("No response from model")
parsed = json.loads(result)
return parsed
```
```python lines theme={"system"}
# créer notre modèle LLM avec un prompt système
model = SentimentAnalysisFakerPiiModel(
name="claude-3-sonnet",
model_name="claude-3-5-sonnet-20240620",
system_prompt='You are a Sentiment Analysis classifier. You will be classifying text based on their sentiment. Your input will be a block of text. You will answer with one the following rating option["positive", "negative", "neutral"]. Your answer should be one word in json format: {classification}. Ensure that it is valid JSON.',
temperature=0,
)
print("Model: ", model)
# pour chaque bloc de texte, anonymiser d’abord, puis effectuer la prédiction
for entry in pii_data:
await model.predict(entry["text"])
```
Méthode `autopatch_settings`
Dans l’exemple suivant, `postprocess_inputs` pour `anthropic` est défini sur la fonction `postprocess_inputs_regex()` lors de l’initialisation. La fonction `postprocess_inputs_regex` applique la méthode `redact_with_regex` définie dans [Méthode 1 : Filtrer à l’aide d’expressions régulières](#method-1-filter-using-regular-expressions). Ainsi, `redact_with_regex` s’applique à toutes les entrées de n’importe quel modèle `anthropic`.
```python lines theme={"system"}
from typing import Any
import weave
client = weave.init(
...,
autopatch_settings={
"anthropic": {
"op_settings": {
"postprocess_inputs": postprocess_inputs_regex,
}
}
},
)
# Définir une fonction de post-traitement des entrées qui applique notre masquage par regex à l’op Weave de prédiction du modèle
def postprocess_inputs_regex(inputs: dict[str, Any]) -> dict:
inputs["text_block"] = redact_with_regex(inputs["text_block"])
return inputs
# Modèle Weave / fonction predict
class SentimentAnalysisRegexPiiModel(weave.Model):
model_name: str
system_prompt: str
temperature: int
async def predict(self, text_block: str) -> dict:
client = anthropic.AsyncAnthropic()
response = await client.messages.create(
max_tokens=1024,
model=self.model_name,
system=self.system_prompt,
messages=[
{"role": "user", "content": [{"type": "text", "text": text_block}]}
],
)
result = response.content[0].text
if result is None:
raise ValueError("No response from model")
parsed = json.loads(result)
return parsed
```
```python lines theme={"system"}
# créer notre modèle LLM avec un prompt système
model = SentimentAnalysisRegexPiiModel(
name="claude-3-sonnet",
model_name="claude-3-5-sonnet-20240620",
system_prompt='You are a Sentiment Analysis classifier. You will be classifying text based on their sentiment. Your input will be a block of text. You will answer with one the following rating option["positive", "negative", "neutral"]. Your answer should be one word in json format: {classification}. Ensure that it is valid JSON.',
temperature=0,
)
print("Model: ", model)
# pour chaque bloc de texte, anonymiser d’abord, puis effectuer la prédiction
for entry in pii_data:
await model.predict(entry["text"])
```
Facultatif : chiffrer vos données
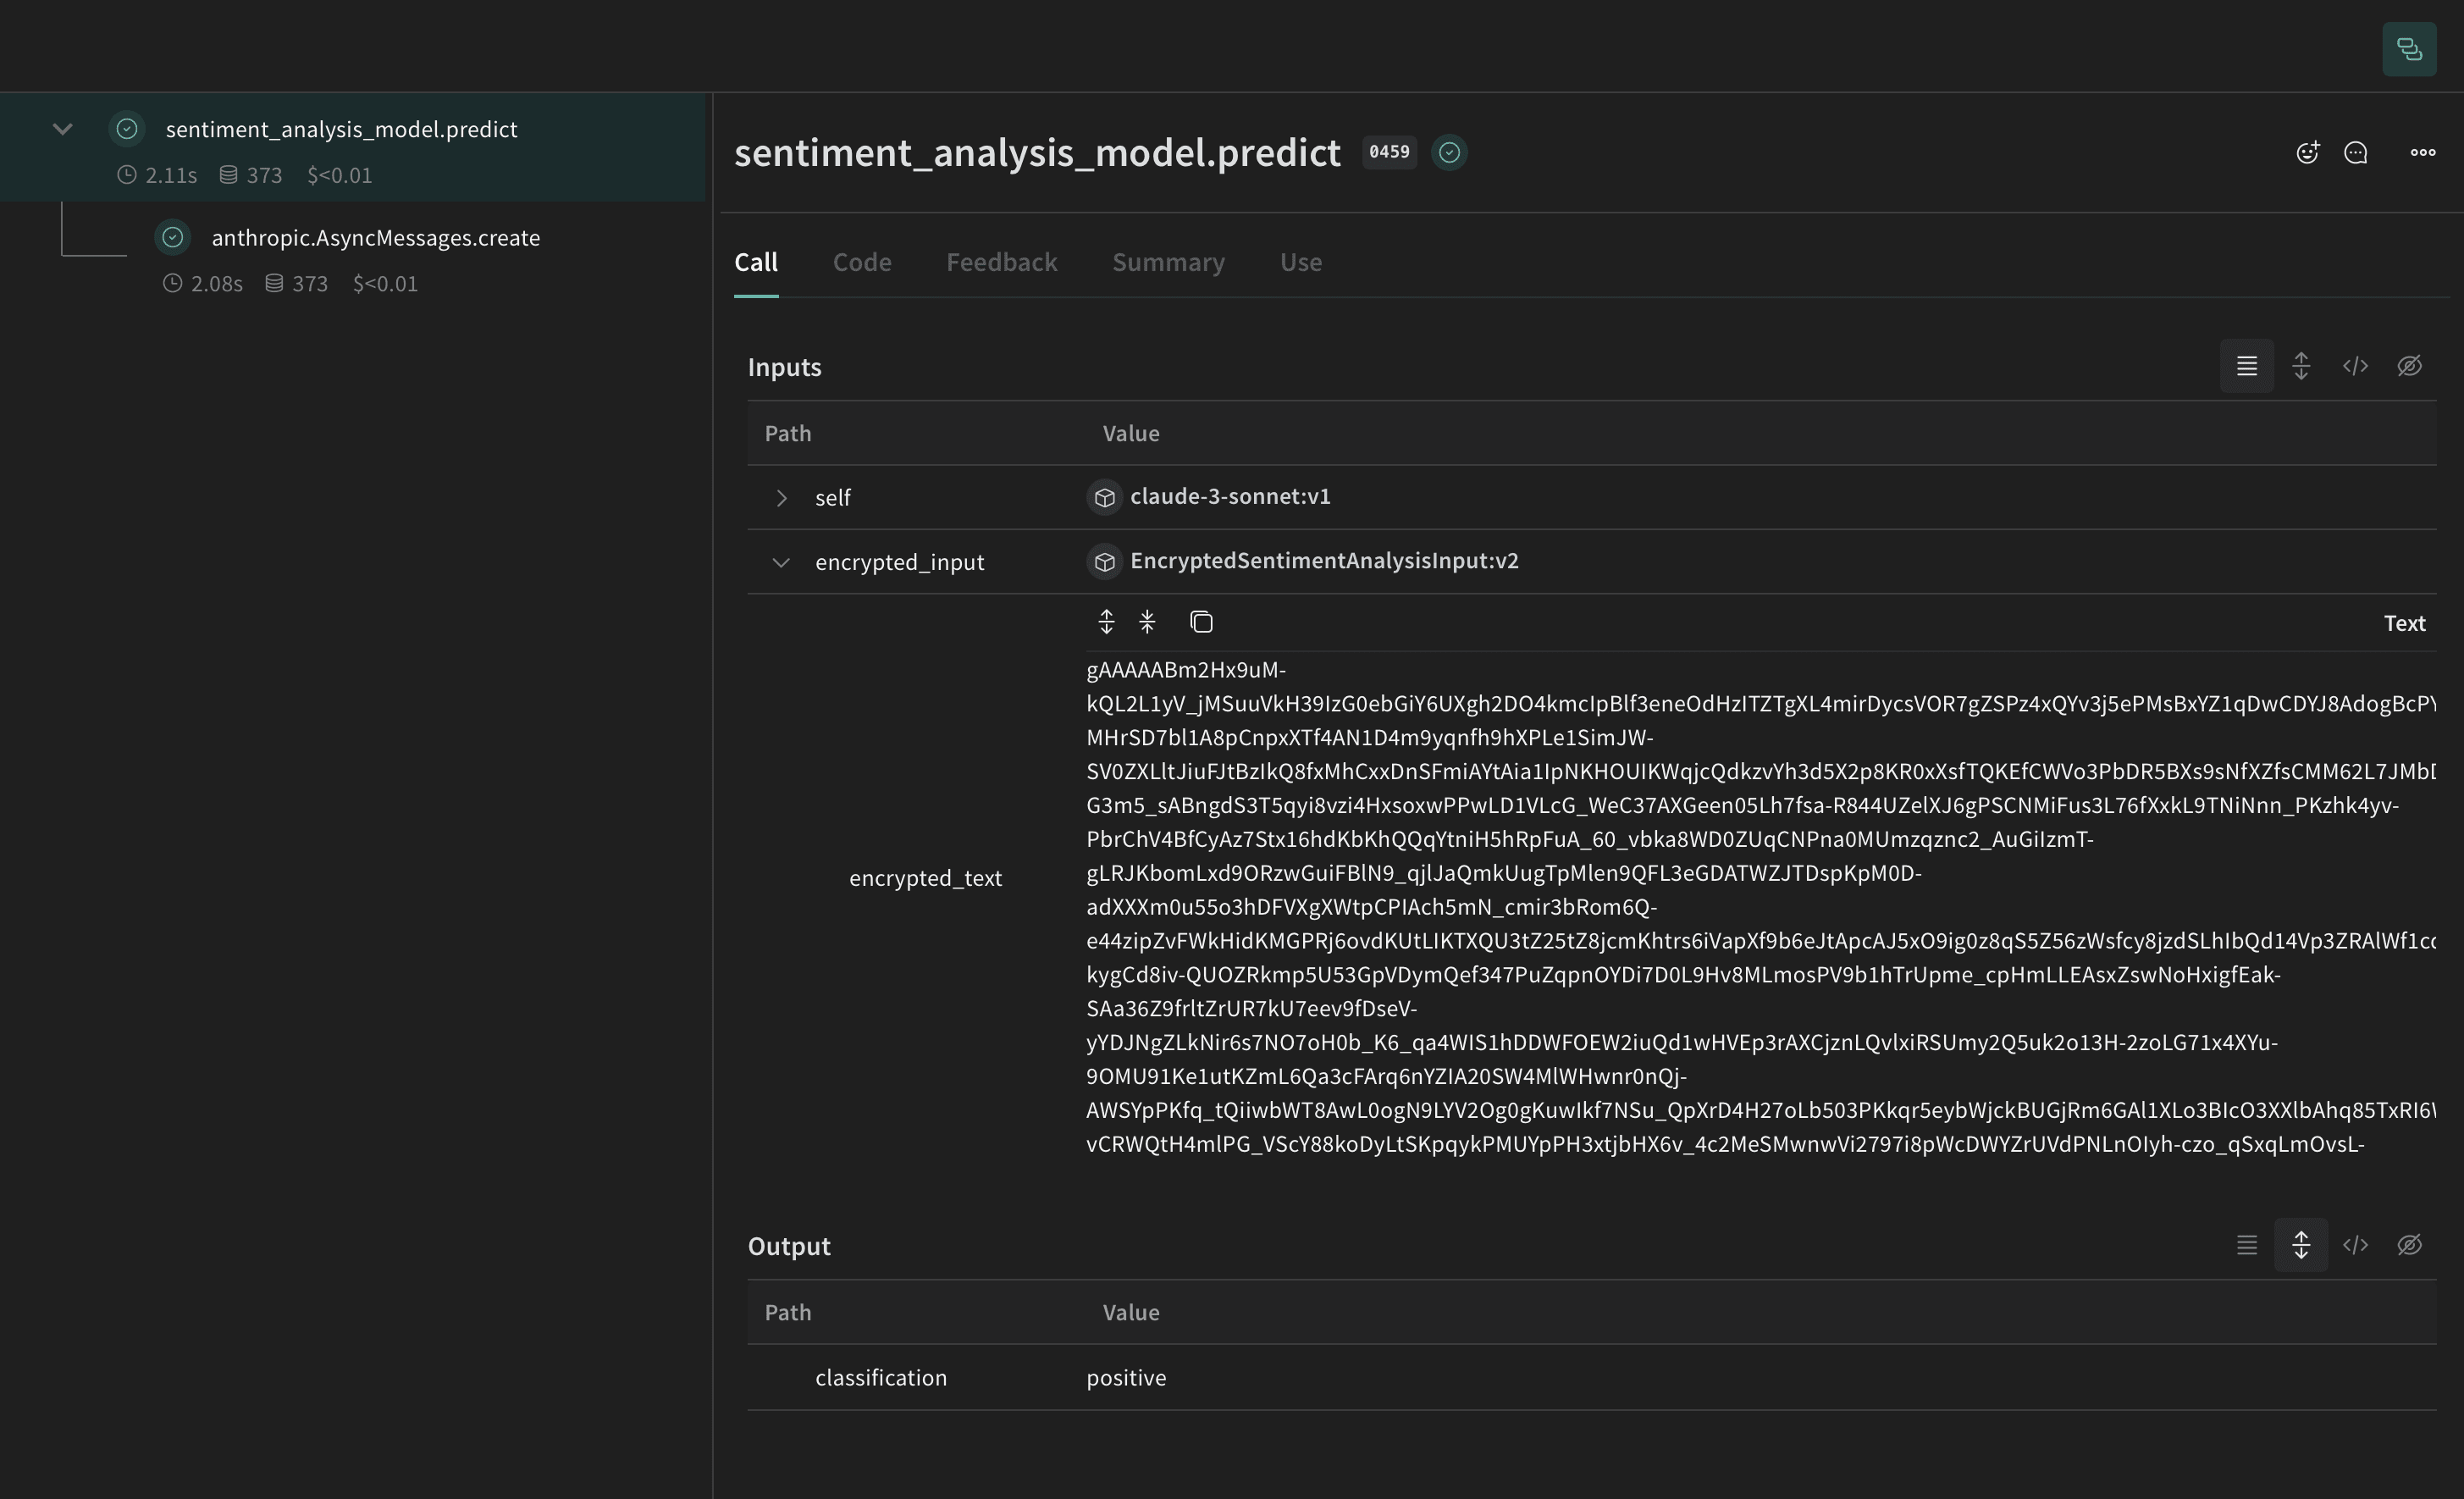 Outre l'anonymisation des PII, vous pouvez renforcer la sécurité en chiffrant vos données avec le chiffrement symétrique [Fernet](https://cryptography.io/en/latest/fernet/) de la bibliothèque cryptography. Ainsi, même si les données anonymisées sont interceptées, elles restent illisibles sans la clé de chiffrement. L'exemple suivant montre comment chiffrer le texte d'entrée avant sa journalisation, puis le déchiffrer dans la méthode `predict` du modèle.
```python lines theme={"system"}
import os
from cryptography.fernet import Fernet
from pydantic import BaseModel, ValidationInfo, model_validator
def get_fernet_key():
# Vérifier si la clé existe dans les variables d’environnement
key = os.environ.get('FERNET_KEY')
if key is None:
# Si la clé n’existe pas, en générer une nouvelle
key = Fernet.generate_key()
# Enregistrer la clé dans une variable d’environnement
os.environ['FERNET_KEY'] = key.decode()
else:
# Si la clé existe, s’assurer qu’elle est de type bytes
key = key.encode()
return key
cipher_suite = Fernet(get_fernet_key())
class EncryptedSentimentAnalysisInput(BaseModel):
encrypted_text: str = None
@model_validator(mode="before")
def encrypt_fields(cls, values):
if "text" in values and values["text"] is not None:
values["encrypted_text"] = cipher_suite.encrypt(values["text"].encode()).decode()
del values["text"]
return values
@property
def text(self):
if self.encrypted_text:
return cipher_suite.decrypt(self.encrypted_text.encode()).decode()
return None
@text.setter
def text(self, value):
self.encrypted_text = cipher_suite.encrypt(str(value).encode()).decode()
@classmethod
def encrypt(cls, text: str):
return cls(text=text)
def decrypt(self):
return self.text
# sentiment_analysis_model modifié pour utiliser la nouvelle classe EncryptedSentimentAnalysisInput
class sentiment_analysis_model(weave.Model):
model_name: str
system_prompt: str
temperature: int
@weave.op()
async def predict(self, encrypted_input: EncryptedSentimentAnalysisInput) -> dict:
client = AsyncAnthropic()
decrypted_text = encrypted_input.decrypt() # Utilisation de la classe personnalisée pour déchiffrer le texte
response = await client.messages.create(
max_tokens=1024,
model=self.model_name,
system=self.system_prompt,
messages=[
{ "role": "user",
"content":[
{
"type": "text",
"text": decrypted_text
}
]
}
]
)
result = response.content[0].text
if result is None:
raise ValueError("No response from model")
parsed = json.loads(result)
return parsed
model = sentiment_analysis_model(
name="claude-3-sonnet",
model_name="claude-3-5-sonnet-20240620",
system_prompt="You are a Sentiment Analysis classifier. You will be classifying text based on their sentiment. Your input will be a block of text. You will answer with one the following rating option[\"positive\", \"negative\", \"neutral\"]. Your answer should one word in json format dict where the key is classification.",
temperature=0
)
for entry in pii_data:
encrypted_input = EncryptedSentimentAnalysisInput.encrypt(entry["text"])
await model.predict(encrypted_input)
```