> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Tracer et évaluer un pipeline de vision par ordinateur avec Weave
> Découvrez comment tracer et évaluer un pipeline de vision par ordinateur avec W&B Weave
Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens ci-dessous :
* [Ouvrir dans Google Colab](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/ocr-pipeline.ipynb)
* [Voir la source sur GitHub](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/ocr-pipeline.ipynb)
Ce tutoriel vous montre comment créer, tracer et évaluer un pipeline de vision par ordinateur qui effectue une reconnaissance d’entités nommées (NER) sur des images d’informations de patients écrites à la main. À la fin, vous disposerez d’un pipeline de reconnaissance optique de caractères (OCR) fonctionnel reposant sur un modèle vision-langage (VLM), ainsi que d’une Évaluation W\&B Weave qui mesure la précision avec laquelle le pipeline extrait des champs structurés à partir des images. Ce guide s’adresse aux développeurs qui souhaitent utiliser Weave pour affiner leurs prompts par itérations successives et mesurer de manière systématique la qualité des pipelines d’extraction multimodale.
Les sections suivantes présentent cinq étapes : la création et l’amélioration itérative des prompts, la récupération du dataset, la création du pipeline NER, la définition des évaluateurs et l’exécution d’une évaluation.
Prérequis
Avant de commencer, installez et importez les bibliothèques requises, obtenez votre clé API W\&B et initialisez votre projet Weave. Cette étape permet à votre environnement de s’authentifier auprès de W\&B et de journaliser des traces dans votre projet Weave.
```python lines theme={"system"}
# Installer les dépendances requises
!pip install openai weave -q
python
import json
import os
from google.colab import userdata
from openai import OpenAI
import weave
python
# Obtenir les clés API
os.environ["OPENAI_API_KEY"] = userdata.get(
"OPENAI_API_KEY"
) # définissez les clés en tant que secrets d’environnement Colab dans le menu de gauche
os.environ["WANDB_API_KEY"] = userdata.get("WANDB_API_KEY")
# Définir le nom du projet
# Remplacez la valeur de PROJECT par le nom de votre projet
PROJECT = "vlm-handwritten-ner"
# Initialiser le projet Weave
weave.init(PROJECT)
```
Créer des prompts et les faire évoluer avec Weave
Une bonne ingénierie de prompts est essentielle pour que le modèle extraie correctement les entités. Dans cette section, vous rédigez un prompt initial, vous le publiez dans Weave pour suivre ses modifications au fil du temps, puis vous l’affinez avec des règles de validation plus strictes.
Commencez par créer un prompt de base qui indique au modèle ce qu’il doit extraire des données d’image et comment mettre en forme le résultat. Ensuite, stockez le prompt dans Weave pour en assurer le suivi et le faire évoluer par itérations.
````python lines theme={"system"}
# Créer votre objet de prompt avec Weave
prompt = """
Extract all readable text from this image. Format the extracted entities as a valid JSON.
Do not return any extra text, just the JSON. Do not include ```json```
Use the following format:
{"Patient Name": "James James","Date": "4/22/2025","Patient ID": "ZZZZZZZ123","Group Number": "3452542525"}
"""
system_prompt = weave.StringPrompt(prompt)
# Publier votre prompt dans Weave
weave.publish(system_prompt, name="NER-prompt")
````
Ensuite, améliorez le prompt en y ajoutant des instructions et des règles de validation supplémentaires afin de réduire les erreurs dans les sorties. Publier la version révisée sous le même nom permet à Weave de suivre le prompt en tant que nouvelle version, et donc de comparer les résultats d’une itération à l’autre.
````python lines theme={"system"}
better_prompt = """
You are a precision OCR assistant. Given an image of patient information, extract exactly these fields into a single JSON object (and nothing else):
- Patient Name
- Date (MM/DD/YYYY)
- Patient ID
- Group Number
Validation rules:
1. Date must match MM/DD/YY; if not, set Date to "".
2. Patient ID must be alphanumeric; if unreadable, set to "".
3. Always zero-pad months and days (e.g. "04/07/25").
4. Omit any markup, commentary, or code fences.
5. Return strictly valid JSON with only those four keys.
Do not return any extra text, just the JSON. Do not include ```json```
Example output:
{"Patient Name":"James James","Date":"04/22/25","Patient ID":"ZZZZZZZ123","Group Number":"3452542525"}
"""
# Modifier le prompt
system_prompt = weave.StringPrompt(better_prompt)
# Publier le prompt modifié dans Weave
weave.publish(system_prompt, name="NER-prompt")
````
Obtenir le dataset
Une fois le prompt en place, il vous faut des données d’entrée à faire passer dans le pipeline. Récupérez le dataset de notes manuscrites qui servira d’entrée au pipeline d’OCR.
Les images du dataset sont déjà encodées en `base64`, ce qui permet au LLM de les utiliser sans aucun prétraitement.
```python lines theme={"system"}
# Récupérer le dataset depuis le projet Weave suivant
dataset = weave.ref(
"weave://wandb-smle/vlm-handwritten-ner/object/NER-eval-dataset:G8MEkqWBtvIxPYAY23sXLvqp8JKZ37Cj0PgcG19dGjw"
).get()
# Accéder à un exemple précis du dataset
example_image = dataset.rows[3]["image_base64"]
# Afficher example_image
from IPython.display import HTML, display
html = f' '
display(HTML(html))
```
Créer le pipeline NER
Maintenant que vous disposez d’un prompt et d’un dataset, créez le pipeline NER qui les relie au VLM. Le pipeline se compose de deux fonctions :
* Une fonction `encode_image` qui prend en entrée une image PIL issue du dataset et renvoie une représentation de l’image sous forme de chaîne encodée en `base64`, pouvant être transmise au VLM.
* Une fonction `extract_named_entities_from_image` qui prend en entrée une image et un prompt système, puis renvoie les entités extraites de cette image selon les consignes du prompt système.
```python lines theme={"system"}
# Fonction traçable qui utilise GPT-4-Vision
def extract_named_entities_from_image(image_base64) -> dict:
# Initialiser le client LLM
client = OpenAI()
# Configurer le prompt d’instructions
# Vous pouvez aussi utiliser un prompt stocké dans Weave avec weave.ref("weave://wandb-smle/vlm-handwritten-ner/object/NER-prompt:FmCv4xS3RFU21wmNHsIYUFal3cxjtAkegz2ylM25iB8").get().content.strip()
prompt = better_prompt
response = client.responses.create(
model="gpt-4.1",
input=[
{
"role": "user",
"content": [
{"type": "input_text", "text": prompt},
{
"type": "input_image",
"image_url": image_base64,
},
],
}
],
)
return response.output_text
```
Créez maintenant une fonction appelée `named_entity_recognation` qui :
* Transmet les données d’image au pipeline NER.
* Renvoie un JSON correctement formaté contenant les résultats.
Utilisez le [décorateur `@weave.op()`](/fr/products/wandb/weave/reference/python-sdk/trace/op) pour suivre et tracer automatiquement l’exécution de la fonction dans l’interface Weights & Biases.
À chaque exécution de `named_entity_recognation`, les résultats complets de la trace s’affichent dans l’interface Weights & Biases. Pour consulter les traces, accédez à l’onglet **Traces** de votre projet Weave.
```python lines theme={"system"}
# Fonction NER pour les évaluations
@weave.op()
def named_entity_recognation(image_base64, id):
result = {}
try:
# 1) appeler l’op de vision et récupérer une chaîne JSON
output_text = extract_named_entities_from_image(image_base64)
# 2) parser le JSON une seule fois
result = json.loads(output_text)
print(f"Processed: {str(id)}")
except Exception as e:
print(f"Failed to process {str(id)}: {e}")
return result
```
Enfin, exécutez le pipeline sur le dataset et consultez les résultats. Cette étape génère les sorties du modèle que vous évaluerez dans la section suivante.
Le code suivant parcourt le dataset et enregistre les résultats dans un fichier local `processing_results.json`. Vous pouvez également consulter les résultats dans l’interface utilisateur de Weights & Biases.
```python lines theme={"system"}
# Résultats en sortie
results = []
# parcourir toutes les images du dataset
for row in dataset.rows:
result = named_entity_recognation(row["image_base64"], str(row["id"]))
result["image_id"] = str(row["id"])
results.append(result)
# Enregistrer tous les résultats dans un fichier JSON
output_file = "processing_results.json"
with open(output_file, "w") as f:
json.dump(results, f, indent=2)
print(f"Results saved to: {output_file}")
```
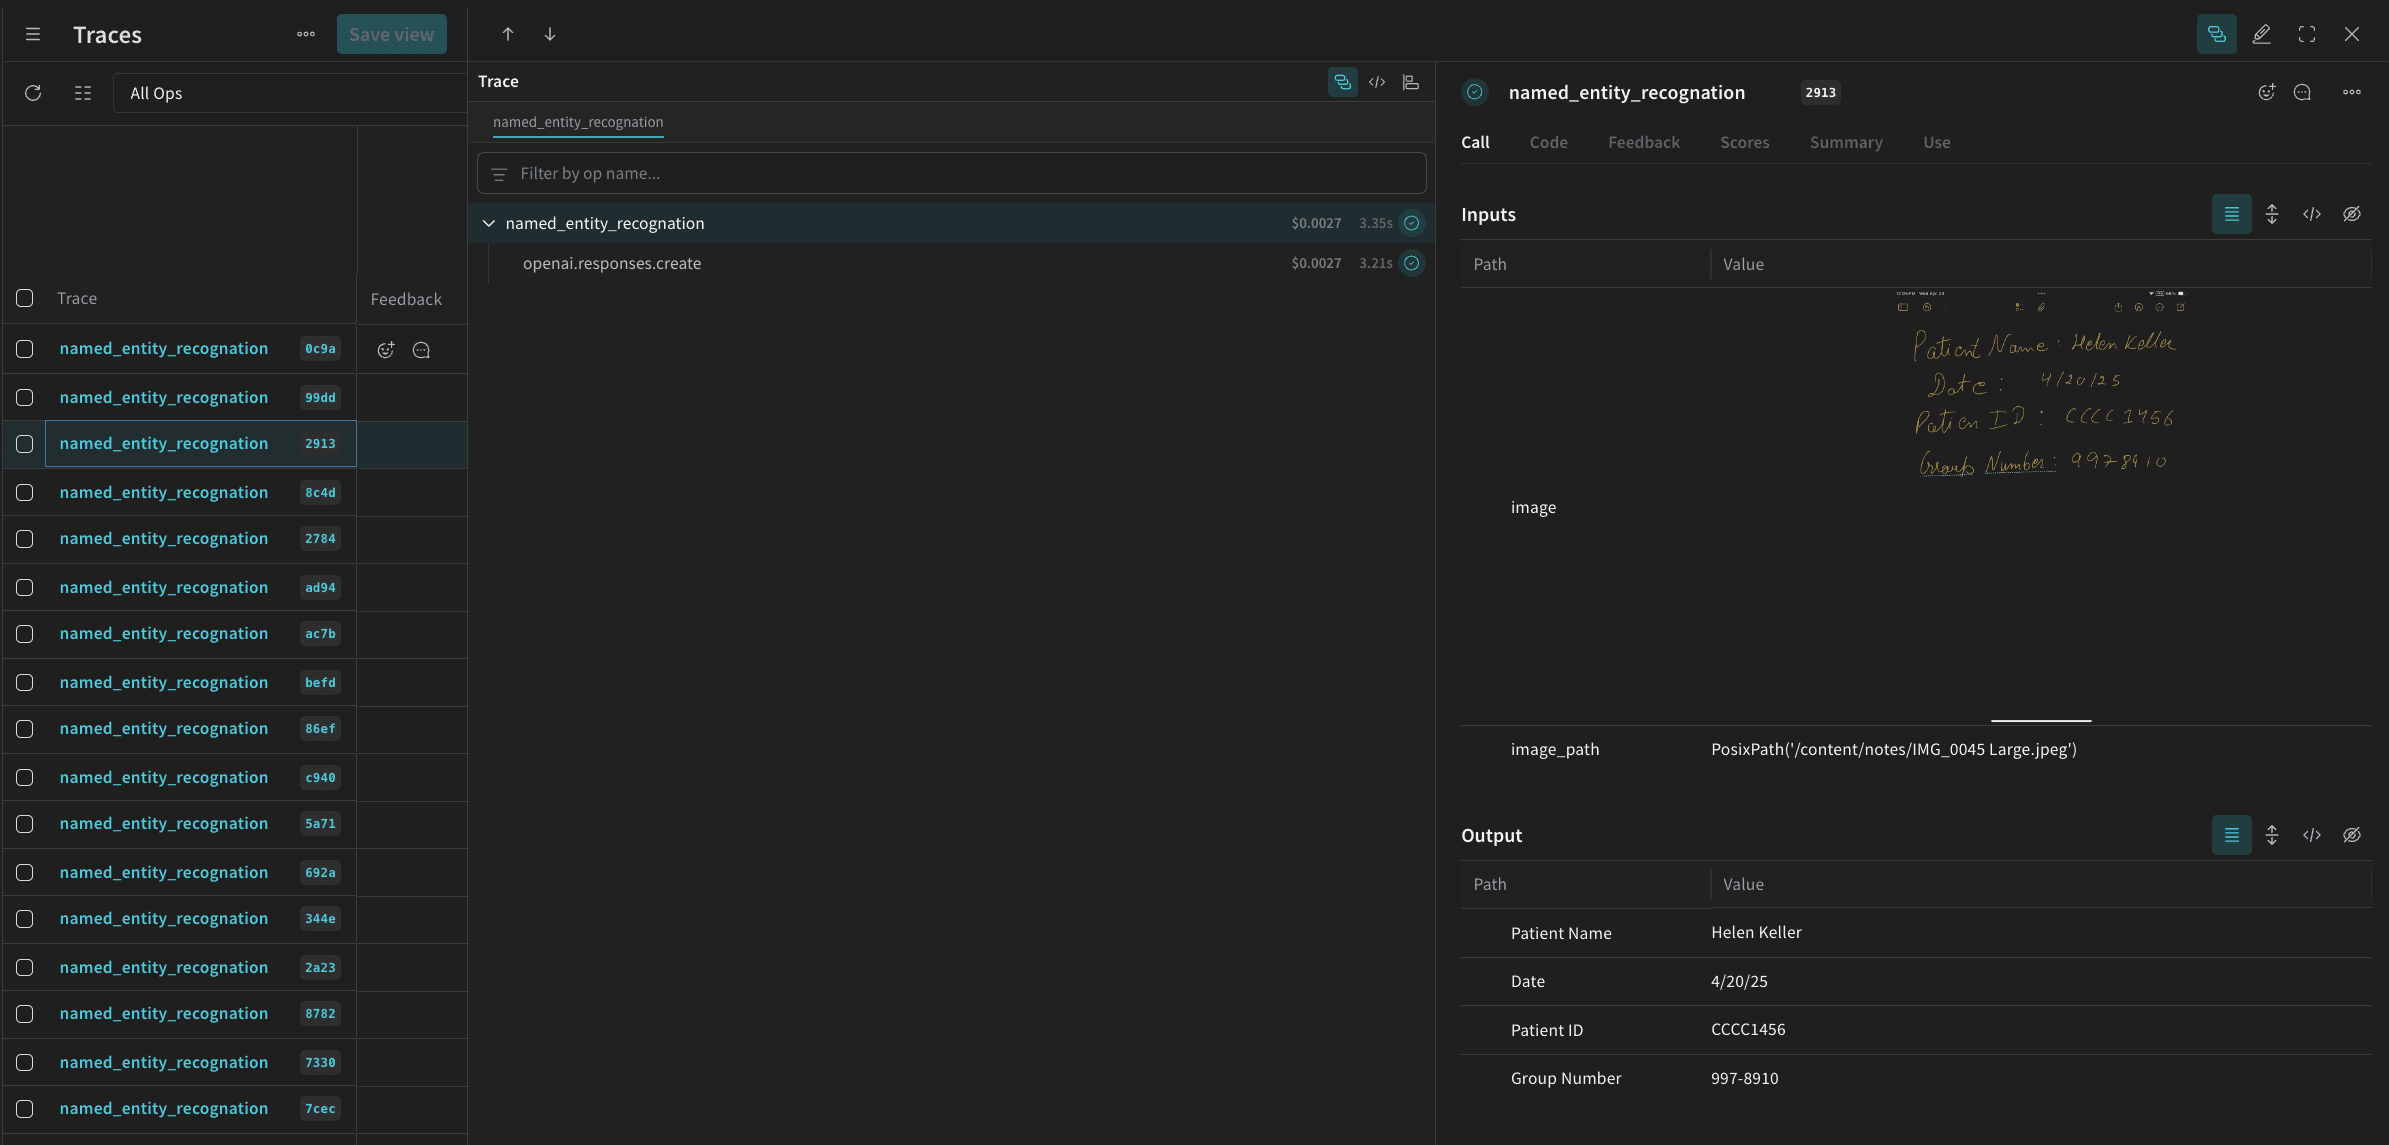
Un résultat semblable à celui-ci s’affiche dans le tableau **Traces** de l’interface utilisateur de Weights & Biases.
Évaluez le pipeline avec Weave
Maintenant que vous avez créé un pipeline de reconnaissance d’entités nommées (NER) à l’aide d’un VLM, vous pouvez utiliser Weave pour l’évaluer de manière systématique et mesurer ses performances. L’évaluation du pipeline vous permet de mesurer la qualité de l’extraction sur l’ensemble du dataset, plutôt que de vous fier à des vérifications ponctuelles. Pour plus d’informations sur les évaluations dans Weave, consultez [Aperçu des évaluations](/fr/products/wandb/weave/guides/core-types/evaluations).
L’[Évaluateur](/fr/products/wandb/weave/guides/evaluation/scorers) est un élément fondamental d’une Évaluation Weave. Les évaluateurs analysent les sorties de l’IA et renvoient des métriques d’évaluation. Ils prennent la sortie de l’IA, l’analysent et renvoient un dictionnaire de résultats. Si nécessaire, les évaluateurs peuvent s’appuyer sur vos données d’entrée comme référence et produire des informations supplémentaires, comme des explications ou le raisonnement issu de l’évaluation.
Dans cette section, vous allez créer deux évaluateurs pour évaluer le pipeline :
* Évaluateur programmatique.
* Évaluateur LLM-as-a-judge.
Évaluateur programmatique
Le premier évaluateur est une vérification déterministe qui s’exécute sans LLM. L’évaluateur programmatique, `check_for_missing_fields_programatically`, prend en entrée la sortie du modèle (celle de la fonction `named_entity_recognition`) et identifie les `keys` manquantes ou vides dans les résultats.
Cette vérification permet d’identifier les échantillons pour lesquels le modèle n’a pas réussi à capturer certains champs.
```python lines theme={"system"}
# Ajoutez weave.op() pour suivre l’exécution du scorer
@weave.op()
def check_for_missing_fields_programatically(model_output):
# Clés requises pour chaque entrée
required_fields = {"Patient Name", "Date", "Patient ID", "Group Number"}
for key in required_fields:
if (
key not in model_output
or model_output[key] is None
or str(model_output[key]).strip() == ""
):
return False # Cette entrée comporte un champ manquant ou vide
return True # Tous les champs requis sont présents et renseignés
```
Évaluateur LLM-as-a-judge
Comme l’évaluateur programmatique ne détecte que les champs manquants ou vides, un second évaluateur est nécessaire pour vérifier que les valeurs extraites correspondent bien au contenu de l’image. À cette étape de l’évaluation, vous fournissez à la fois les données de l’image et la sortie du modèle, afin que l’évaluation reflète les performances réelles de la reconnaissance d’entités nommées (NER). Le contenu de l’image est explicitement pris en compte, et pas uniquement la sortie du modèle.
L’évaluateur utilisé pour cette étape, `check_for_missing_fields_with_llm`, s’appuie sur un LLM pour effectuer la notation (en l’occurrence `gpt-4o` d’OpenAI). Comme le définit le contenu de `eval_prompt`, `check_for_missing_fields_with_llm` produit une valeur `Boolean`. Si tous les champs correspondent aux informations de l’image et que le formatage est correct, l’évaluateur renvoie `true`. Si un champ est manquant, vide, incorrect ou ne concorde pas, le résultat est `false`, et l’évaluateur renvoie également un message expliquant le problème.
```python lines theme={"system"}
# Prompt système du LLM juge (LLM-as-a-judge)
eval_prompt = """
You are an OCR validation system. Your role is to assess whether the structured text extracted from an image accurately reflects the information in that image.
Only validate the structured text and use the image as your source of truth.
Expected input text format:
{"Patient Name": "First Last", "Date": "04/23/25", "Patient ID": "131313JJH", "Group Number": "35453453"}
Evaluation criteria:
- All four fields must be present.
- No field should be empty or contain placeholder/malformed values.
- The "Date" should be in MM/DD/YY format (e.g., "04/07/25") (zero padding the date is allowed)
Scoring:
- Return: {"Correct": true, "Reason": ""} if **all fields** match the information in the image and formatting is correct.
- Return: {"Correct": false, "Reason": "EXPLANATION"} if **any** field is missing, empty, incorrect, or mismatched.
Output requirements:
- Respond with a valid JSON object only.
- "Correct" must be a JSON boolean: true or false (not a string or number).
- "Reason" must be a short, specific string indicating all the problem — e.g., "Patient Name mismatch", "Date not zero-padded", or "Missing Group Number".
- Do not return any additional explanation or formatting.
Your response must be exactly one of the following:
{"Correct": true, "Reason": null}
OR
{"Correct": false, "Reason": "EXPLANATION_HERE"}
"""
# Ajouter weave.op() pour suivre l’exécution du Scorer
@weave.op()
def check_for_missing_fields_with_llm(model_output, image_base64):
client = OpenAI()
response = client.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "developer", "content": [{"text": eval_prompt, "type": "text"}]},
{
"role": "user",
"content": [
{
"type": "image_url",
"image_url": {
"url": image_base64,
},
},
{"type": "text", "text": str(model_output)},
],
},
],
response_format={"type": "json_object"},
)
response = json.loads(response.choices[0].message.content)
return response
```
Exécuter l’évaluation
Une fois les deux évaluateurs définis, vous pouvez exécuter l’évaluation. Définissez un appel d’évaluation qui parcourt automatiquement le `dataset` fourni et journalise l’ensemble des résultats dans l’interface utilisateur de Weights & Biases.
Le code suivant lance l’évaluation et applique les deux évaluateurs à chaque sortie du pipeline NER. Les résultats s’affichent dans l’onglet **Evals** de l’interface utilisateur de Weights & Biases.
```python lines theme={"system"}
evaluation = weave.Evaluation(
dataset=dataset,
scorers=[
check_for_missing_fields_with_llm,
check_for_missing_fields_programatically,
],
name="Evaluate_4.1_NER",
)
print(await evaluation.evaluate(named_entity_recognation))
```
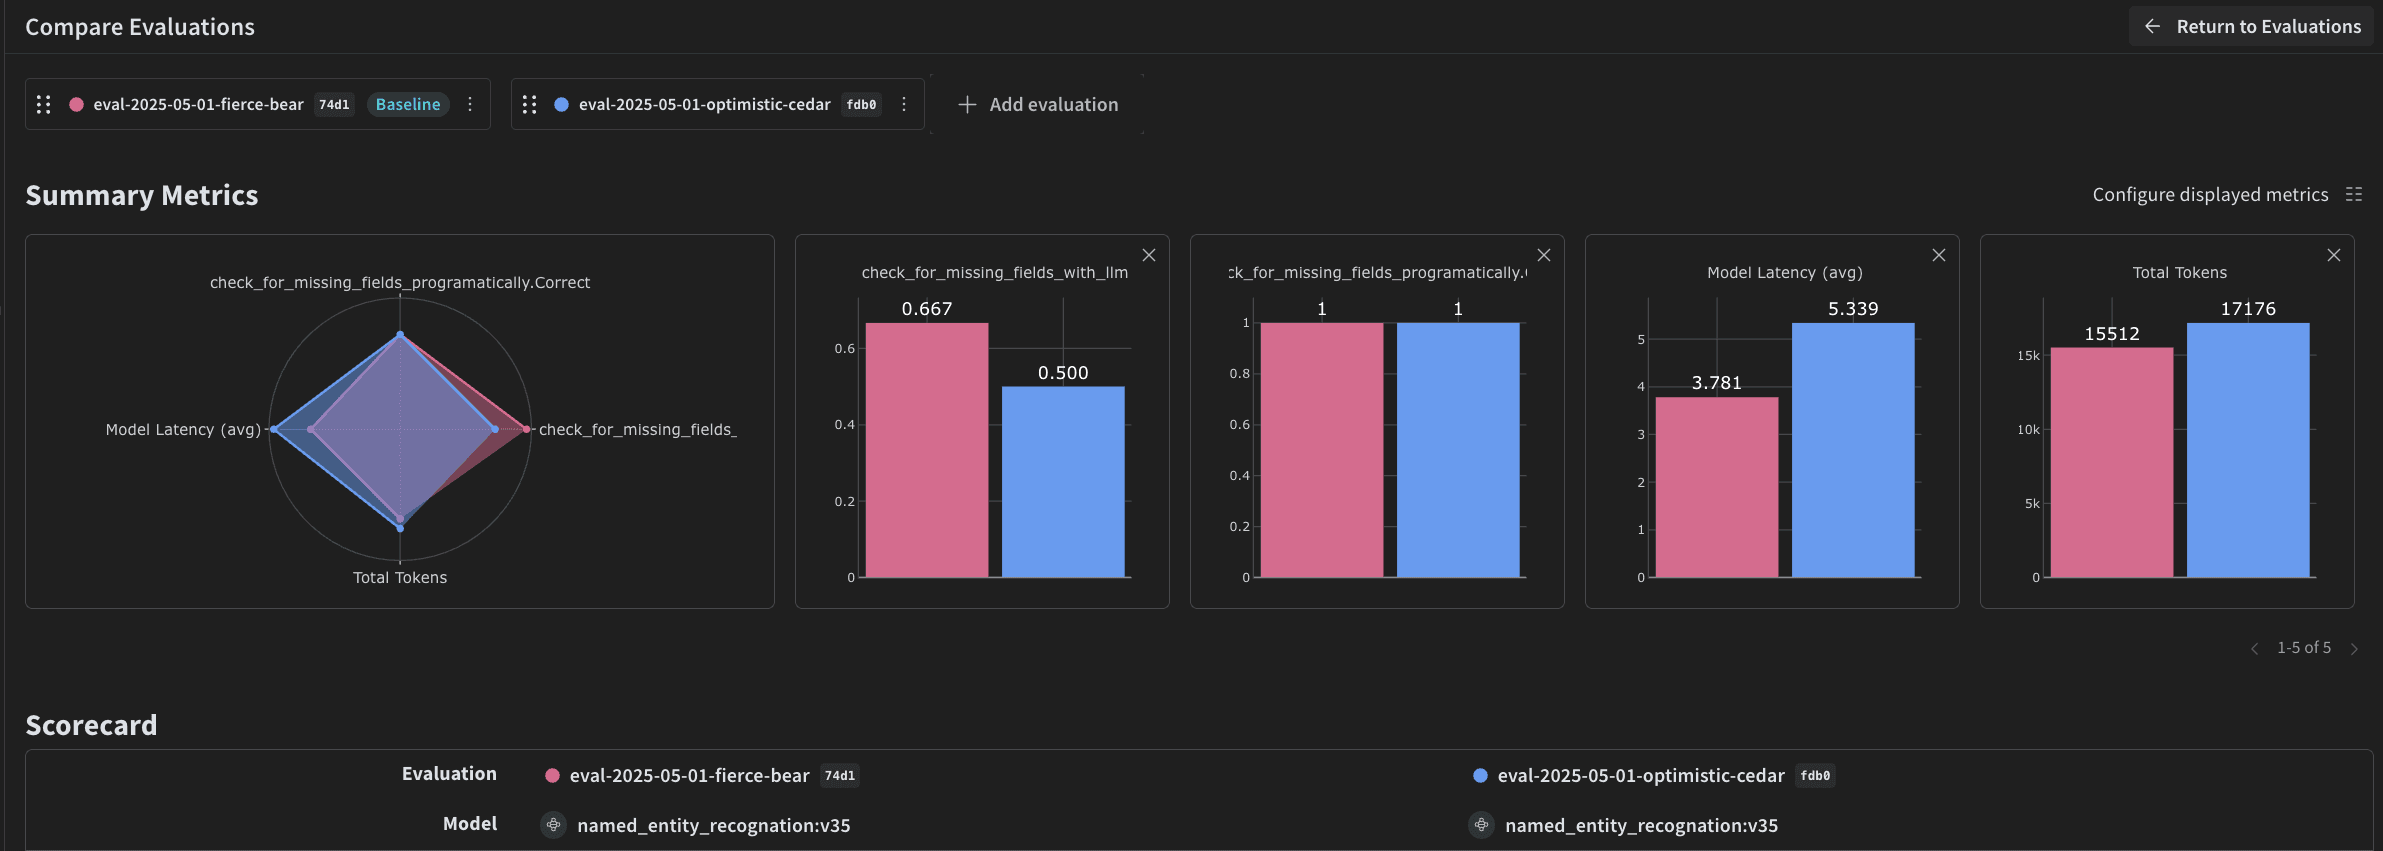
Une fois le code précédent exécuté, Weave génère un lien vers le tableau Evaluation dans l’interface utilisateur de Weights & Biases. Suivez ce lien pour afficher les résultats et comparer différentes itérations du pipeline selon les modèles, les prompts et les datasets de votre choix. L’interface utilisateur de Weights & Biases crée automatiquement pour votre équipe une visualisation semblable à celle-ci.