> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Importer depuis un fichier CSV
> Importez des datasets à partir de fichiers CSV dans W&B Weave pour les utiliser dans vos flux de travail d’évaluation, de traçage et de comparaison de modèles.
Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens suivants :
* [Ouvrir dans Google Colab](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/import_from_csv.ipynb)
* [Voir la source sur GitHub](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/import_from_csv.ipynb)
Importer des traces depuis des systèmes tiers
Ce notebook vous montre comment importer dans W\&B Weave des traces de conversation historiques provenant d’un fichier CSV, afin de les analyser, de comparer le comportement des modèles et d’exécuter des évaluations sur des données générées en dehors d’une application instrumentée avec Weave.
Il arrive que vous ne puissiez pas instrumenter votre code Python ou JavaScript avec l’intégration Weave pour obtenir des traces en temps réel de votre application d’IA générative. Souvent, ces traces ne sont disponibles qu’a posteriori, au format CSV ou JSON.
Ce notebook utilise l’API Python de bas niveau de Weave pour extraire les données d’un fichier CSV et les importer dans Weave, afin que vous puissiez les analyser et les évaluer.
Le dataset d’exemple utilisé dans ce guide pratique présente la structure suivante :
```text theme={"system"}
conversation_id,turn_index,start_time,user_input,ground_truth,answer_text
1234,1,2024-09-04 13:05:39,This is the beginning, ['This was the beginning'], That was the beginning
1235,1,2024-09-04 13:02:11,This is another trace,, That was another trace
1235,2,2024-09-04 13:04:19,This is the next turn,, That was the next turn
1236,1,2024-09-04 13:02:10,This is a 3 turn conversation,, Woah thats a lot of turns
1236,2,2024-09-04 13:02:30,This is the second turn, ['That was definitely the second turn'], You are correct
1236,3,2024-09-04 13:02:53,This is the end,, Well good riddance!
```
Pour comprendre les choix d’importation effectués dans ce notebook, gardez à l’esprit que les traces Weave présentent des relations parent-enfant continues, de type 1:N. Un même parent peut avoir plusieurs enfants, et ce parent peut lui-même être l’enfant d’un autre parent.
Ce notebook utilise `conversation_id` comme identifiant parent et `turn_index` comme identifiant enfant afin de fournir une journalisation complète des conversations.
Vous devez adapter les variables des sections suivantes à votre propre dataset, à vos chemins de fichiers et à votre projet Weights & Biases.
Configurer l’environnement
Installez et importez tous les paquets nécessaires.
Définissez `WANDB_API_KEY` dans votre environnement afin de pouvoir vous connecter avec `wandb.login()` (fournissez cette clé à Colab sous forme de secret).
Indiquez dans `name_of_file` le nom du fichier que vous téléversez sur Colab, puis indiquez dans `name_of_wandb_project` le projet Weights & Biases dans lequel vous souhaitez journaliser les données.
`name_of_wandb_project` peut également être au format `[TEAM_NAME]/[PROJECT_NAME]` afin de spécifier l’équipe dans laquelle journaliser les traces.
Ensuite, récupérez un client Weave en appelant `weave.init()`.
```python lines theme={"system"}
%pip install wandb weave pandas datetime --quiet
python
import os
import pandas as pd
import wandb
from google.colab import userdata
import weave
## Écrire le fichier d’exemples sur le disque
with open("/content/import_cookbook_data.csv", "w") as f:
f.write(
"conversation_id,turn_index,start_time,user_input,ground_truth,answer_text\n"
)
f.write(
'1234,1,2024-09-04 13:05:39,This is the beginning, ["This was the beginning"], That was the beginning\n'
)
f.write(
"1235,1,2024-09-04 13:02:11,This is another trace,, That was another trace\n"
)
f.write(
"1235,2,2024-09-04 13:04:19,This is the next turn,, That was the next turn\n"
)
f.write(
"1236,1,2024-09-04 13:02:10,This is a 3 turn conversation,, Woah thats a lot of turns\n"
)
f.write(
'1236,2,2024-09-04 13:02:30,This is the second turn, ["That was definitely the second turn"], You are correct\n'
)
f.write("1236,3,2024-09-04 13:02:53,This is the end,, Well good riddance!\n")
os.environ["WANDB_API_KEY"] = userdata.get("WANDB_API_KEY")
name_of_file = "/content/import_cookbook_data.csv"
name_of_wandb_project = "import-weave-traces-cookbook"
wandb.login()
python
weave_client = weave.init(name_of_wandb_project)
```
Charger les données
Une fois l’environnement prêt, vous pouvez charger les données CSV et les mettre en forme afin qu’elles correspondent à la structure parent-enfant attendue par Weave.
Chargez les données dans un DataFrame pandas, puis triez-les par `conversation_id` et `turn_index` pour que les parents et les enfants soient dans le bon ordre.
Vous obtenez ainsi un DataFrame pandas à deux colonnes, dans lequel les tours de conversation figurent sous forme de tableau dans `conversation_data`.
```python lines theme={"system"}
## Charger les données et les mettre en forme
df = pd.read_csv(name_of_file)
sorted_df = df.sort_values(["conversation_id", "turn_index"])
# Fonction qui crée un tableau de dictionnaires pour chaque conversation
def create_conversation_dict_array(group):
return group.drop("conversation_id", axis=1).to_dict("records")
# Regrouper le DataFrame par conversation_id et appliquer l’agrégation
result_df = (
sorted_df.groupby("conversation_id")
.apply(create_conversation_dict_array)
.reset_index()
)
result_df.columns = ["conversation_id", "conversation_data"]
# Afficher le résultat de l’agrégation
result_df.head()
```
Journaliser les traces vers Weave
Une fois les données structurées en conversations et en tours de conversation, l’étape suivante consiste à écrire ces enregistrements dans Weave sous forme d’Appels parents et enfants.
Parcourez le DataFrame pandas :
* Créez un Appel parent pour chaque `conversation_id`.
* Parcourez le tableau des tours de conversation pour créer des Appels enfants triés selon leur `turn_index`.
Concepts importants de l’API Python de bas niveau :
* Un Appel Weave équivaut à une trace Weave. Cet Appel peut être associé à un parent ou à des enfants.
* D’autres éléments peuvent être associés à un Appel Weave, comme du feedback et des métadonnées. Cet exemple n’associe que des entrées et des sorties, mais vous pouvez ajouter ces autres éléments lors de votre importation si les données les fournissent.
* Un Appel Weave est `created` puis `finished`, car ces Appels sont conçus pour être suivis en temps réel. Comme il s’agit ici d’une importation a posteriori, vous créez et terminez les Appels une fois les objets définis et reliés entre eux.
* La valeur `op` d’un Appel permet à Weave de regrouper les Appels de même structure. Dans cet exemple, tous les Appels parents sont de type `Conversation` et tous les Appels enfants sont de type `Turn`. Vous pouvez adapter ce choix selon vos besoins.
* Un Appel peut avoir des `inputs` et un `output`. Les `inputs` sont définis à la création de l’Appel, et l’`output` lorsque l’Appel se termine.
```python lines theme={"system"}
# Journaliser les traces vers Weave
# Parcourir nos conversations agrégées
for _, row in result_df.iterrows():
# Définir notre conversation parente :
# nous créons maintenant un « call » avec le weave_client défini précédemment
parent_call = weave_client.create_call(
# La valeur Op enregistre cet élément comme une Weave Op, ce qui nous permettra par la suite de récupérer facilement ces éléments en groupe
op="Conversation",
# Les entrées de notre conversation de haut niveau sont l’ensemble des tours de conversation qu’elle contient
inputs={
"conversation_data": row["conversation_data"][:-1]
if len(row["conversation_data"]) > 1
else row["conversation_data"]
},
# Notre parent Conversation n’a lui-même aucun parent
parent=None,
# Le nom sous lequel cette conversation apparaîtra dans l’interface utilisateur
display_name=f"conversation-{row['conversation_id']}",
)
# La sortie du parent est la dernière trace de la conversation
parent_output = row["conversation_data"][len(row["conversation_data"]) - 1]
# Nous parcourons maintenant tous les tours de conversation du parent
# et les journalisons comme enfants de la conversation
for item in row["conversation_data"]:
item_id = f"{row['conversation_id']}-{item['turn_index']}"
# Nous créons ici un autre call, rattaché à la conversation
call = weave_client.create_call(
# Chaque trace individuelle de la conversation est qualifiée de « Turn »
op="Turn",
# Nous fournissons toutes les entrées du tour de conversation, y compris la 'ground_truth' RAG
inputs={
"turn_index": item["turn_index"],
"start_time": item["start_time"],
"user_input": item["user_input"],
"ground_truth": item["ground_truth"],
},
# Nous en faisons un enfant du parent défini précédemment
parent=parent_call,
# Nous lui attribuons un nom qui permettra de l’identifier dans Weave
display_name=item_id,
)
# La sortie du call est la réponse
output = {
"answer_text": item["answer_text"],
}
# Comme ces traces correspondent à des échanges déjà terminés, nous finalisons le call du tour de conversation
weave_client.finish_call(call=call, output=output)
# Maintenant que tous ses enfants sont journalisés, nous finalisons également le call parent
weave_client.finish_call(call=parent_call, output=parent_output)
```
Résultat : traces journalisées vers Weave
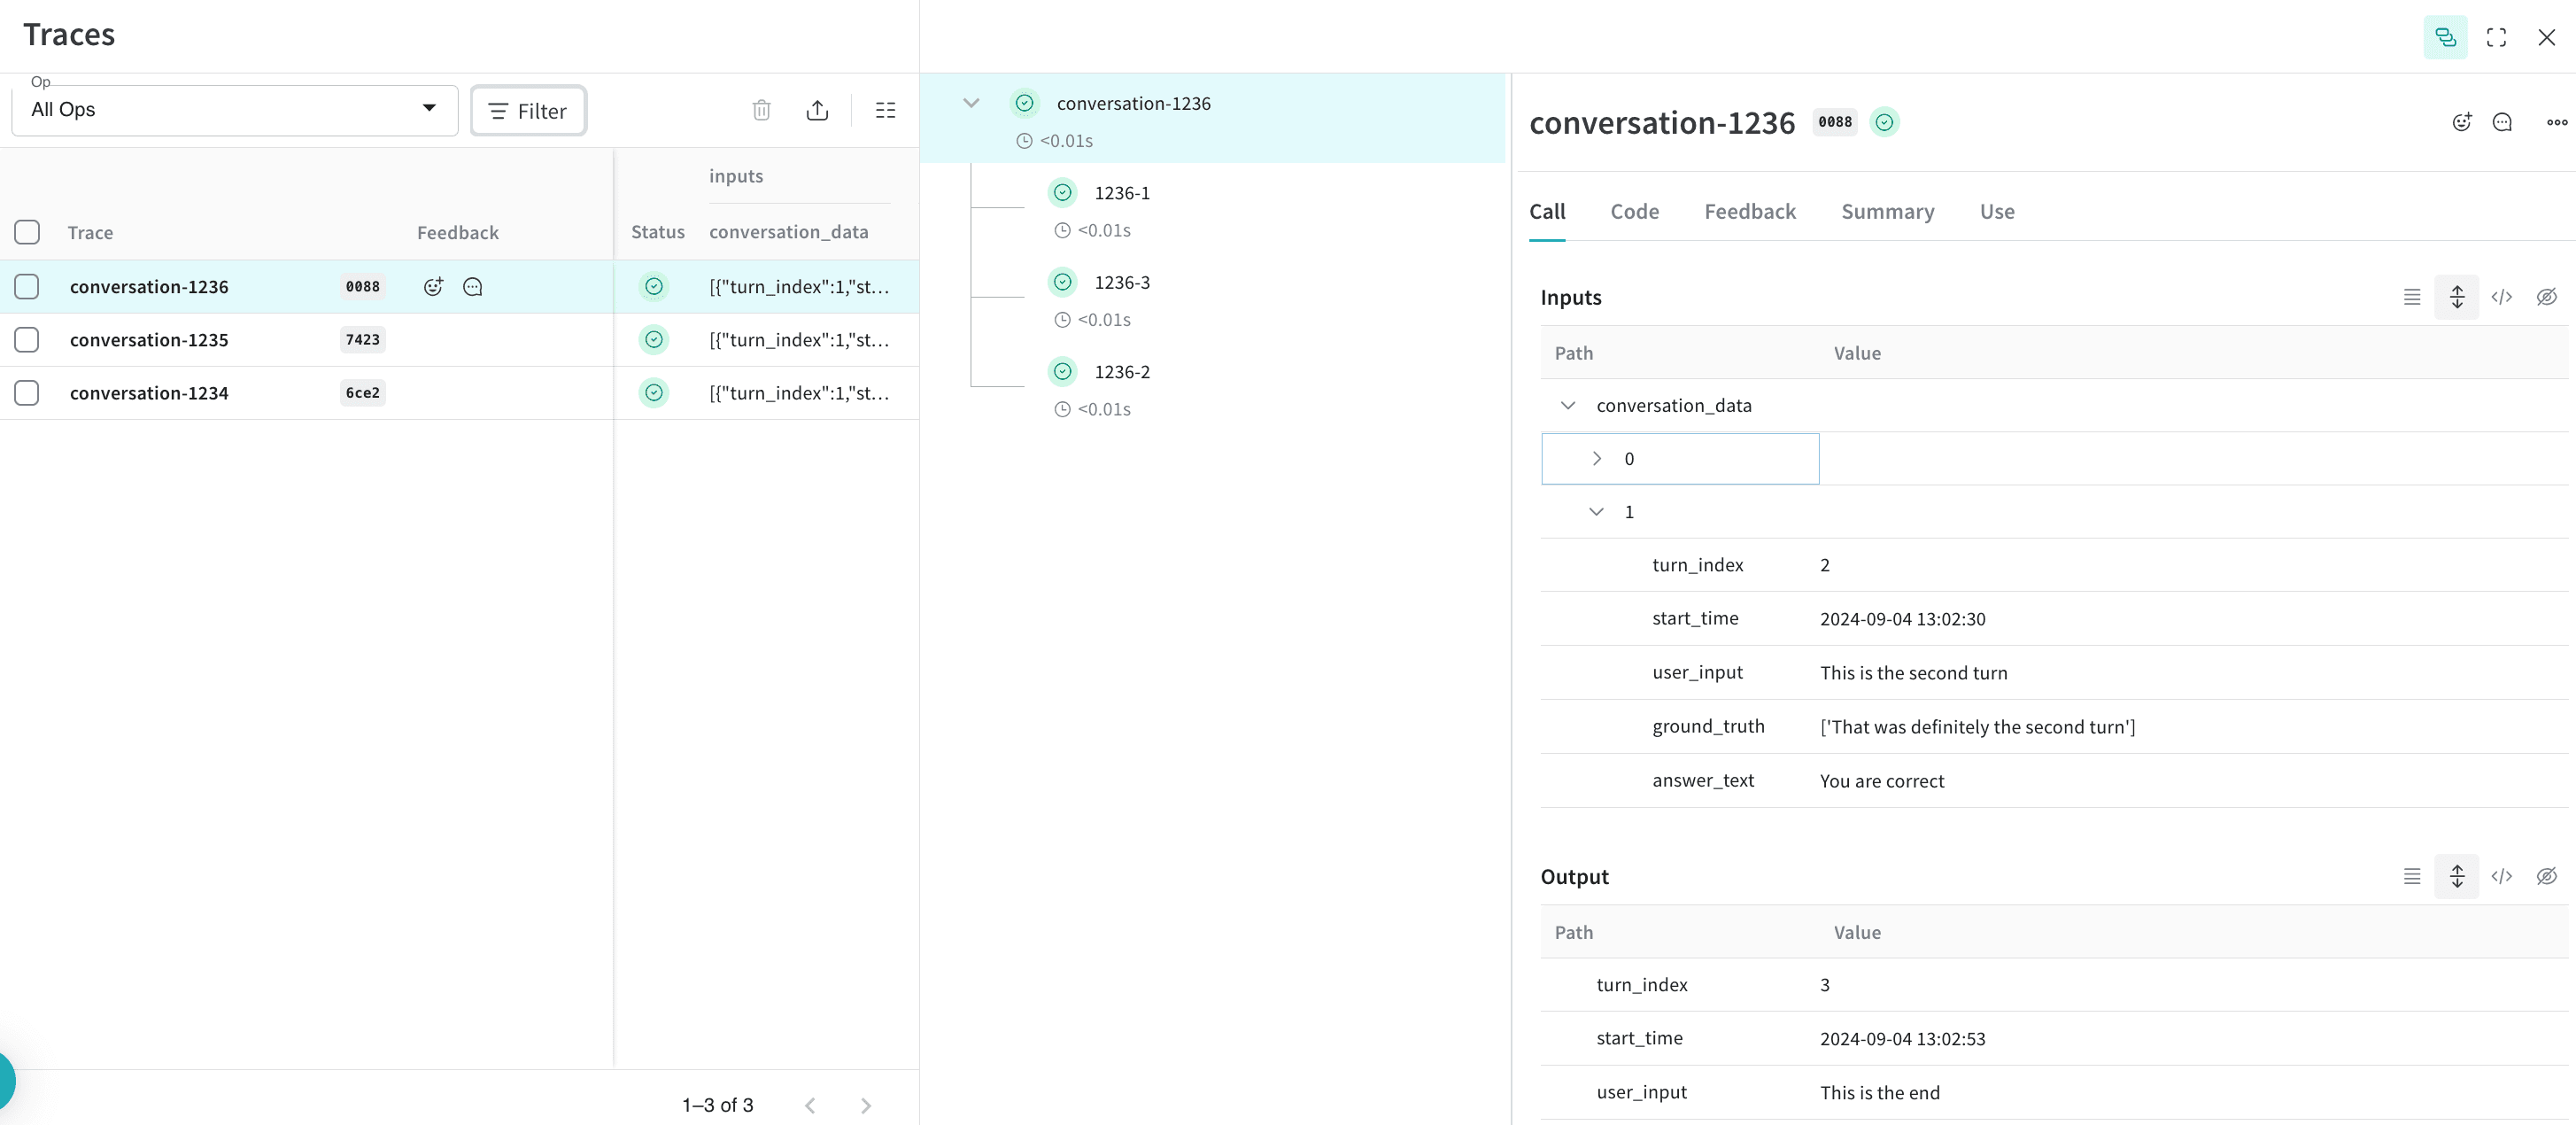
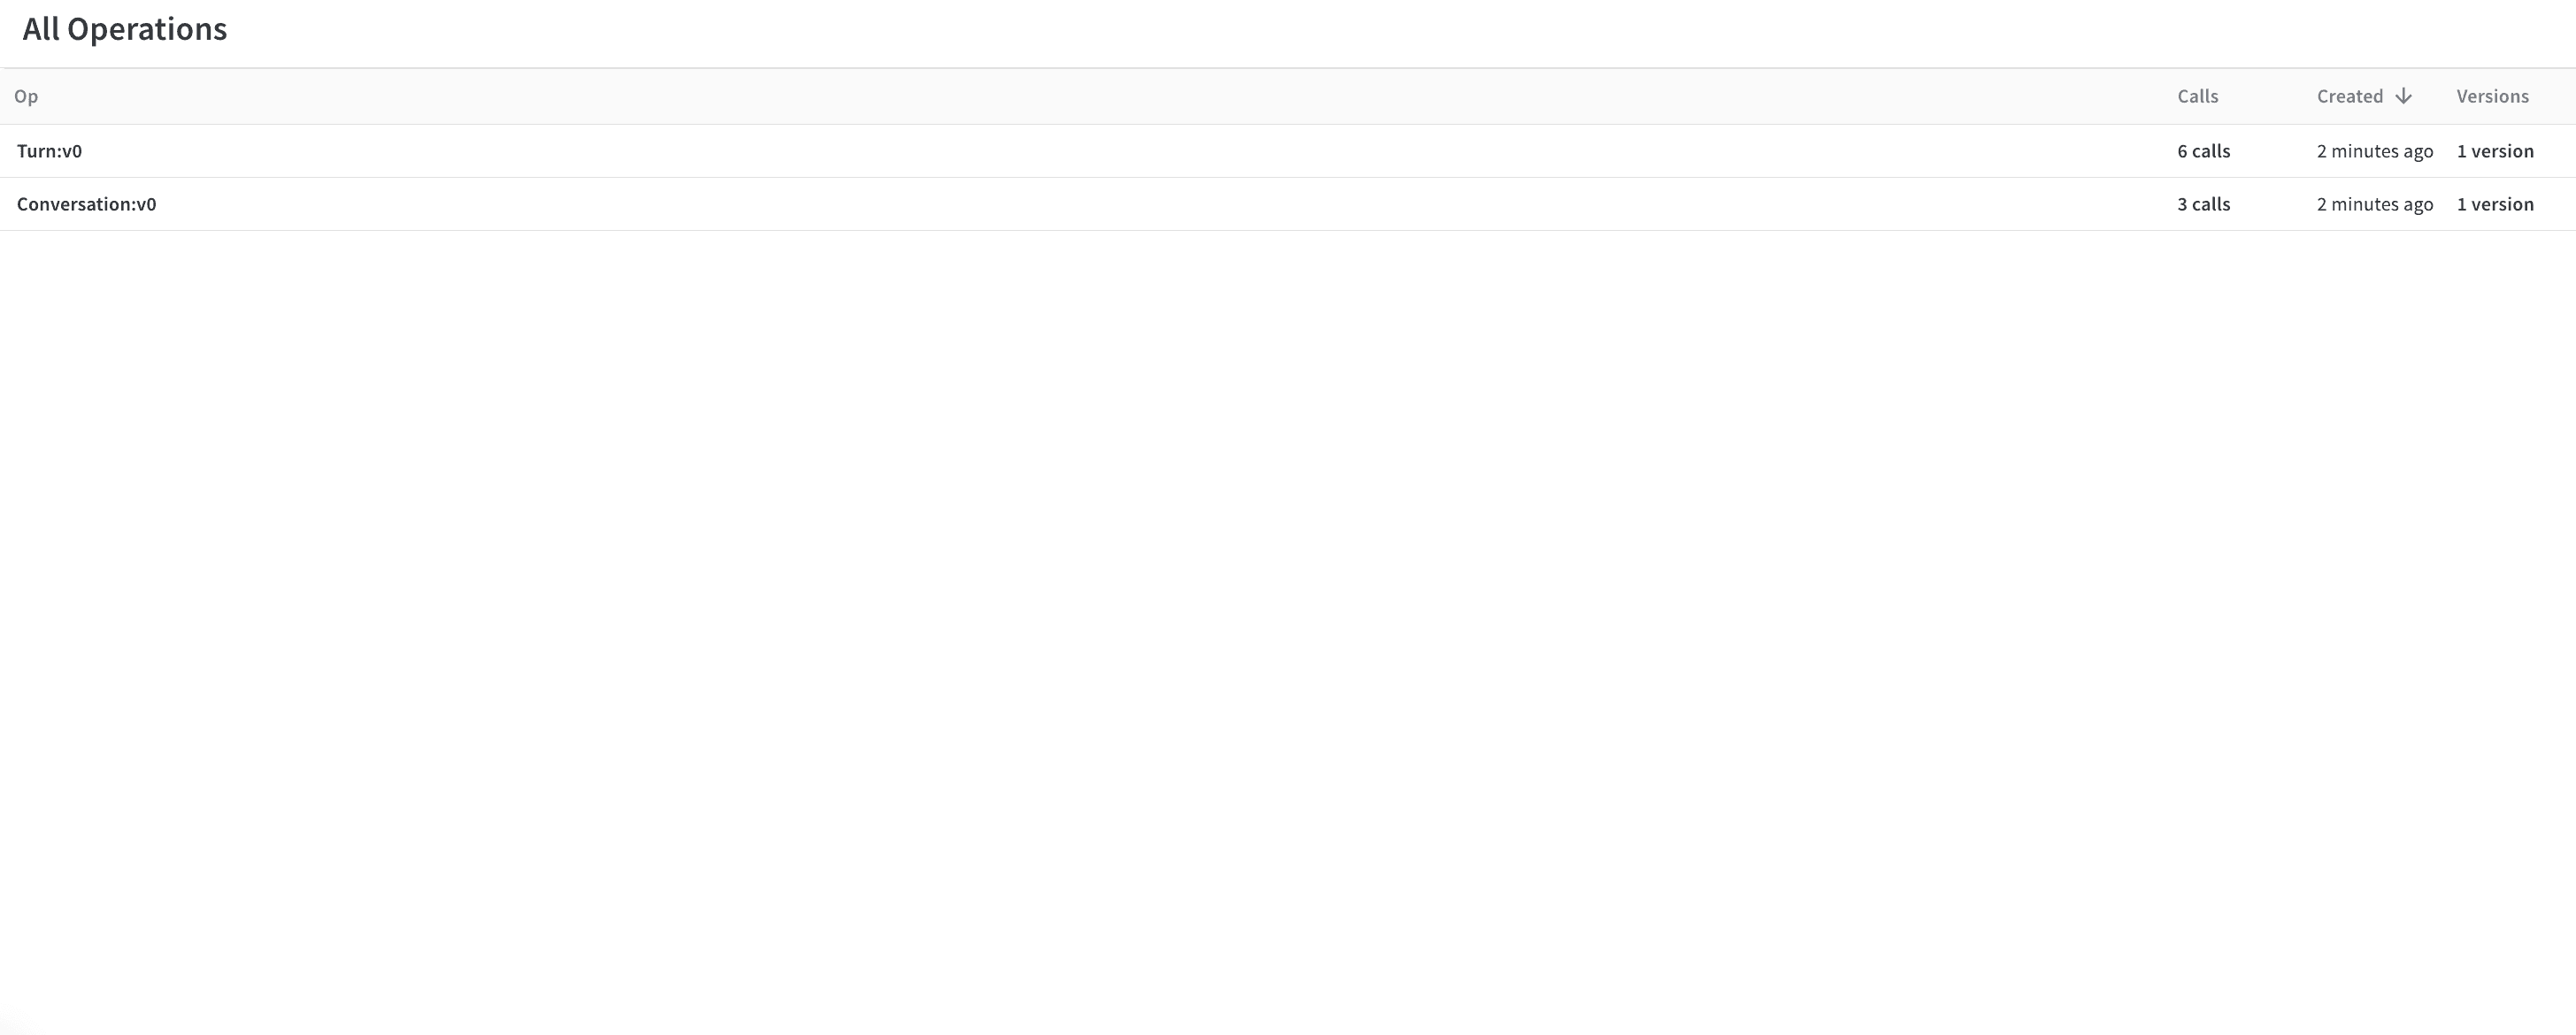
À ce stade, vos données CSV ont été importées dans Weave. Vous pouvez désormais parcourir les conversations et leurs tours de conversation dans l’interface de Weights & Biases, regroupés sous les opérations `Conversation` et `Turn` que vous avez définies.
Traces :
 Opérations :
Facultatif : exportez vos traces pour exécuter des évaluations
Une fois les traces dans Weave et la structure des conversations bien comprise, vous pouvez les exporter vers un autre processus pour exécuter des Weave Evaluations.
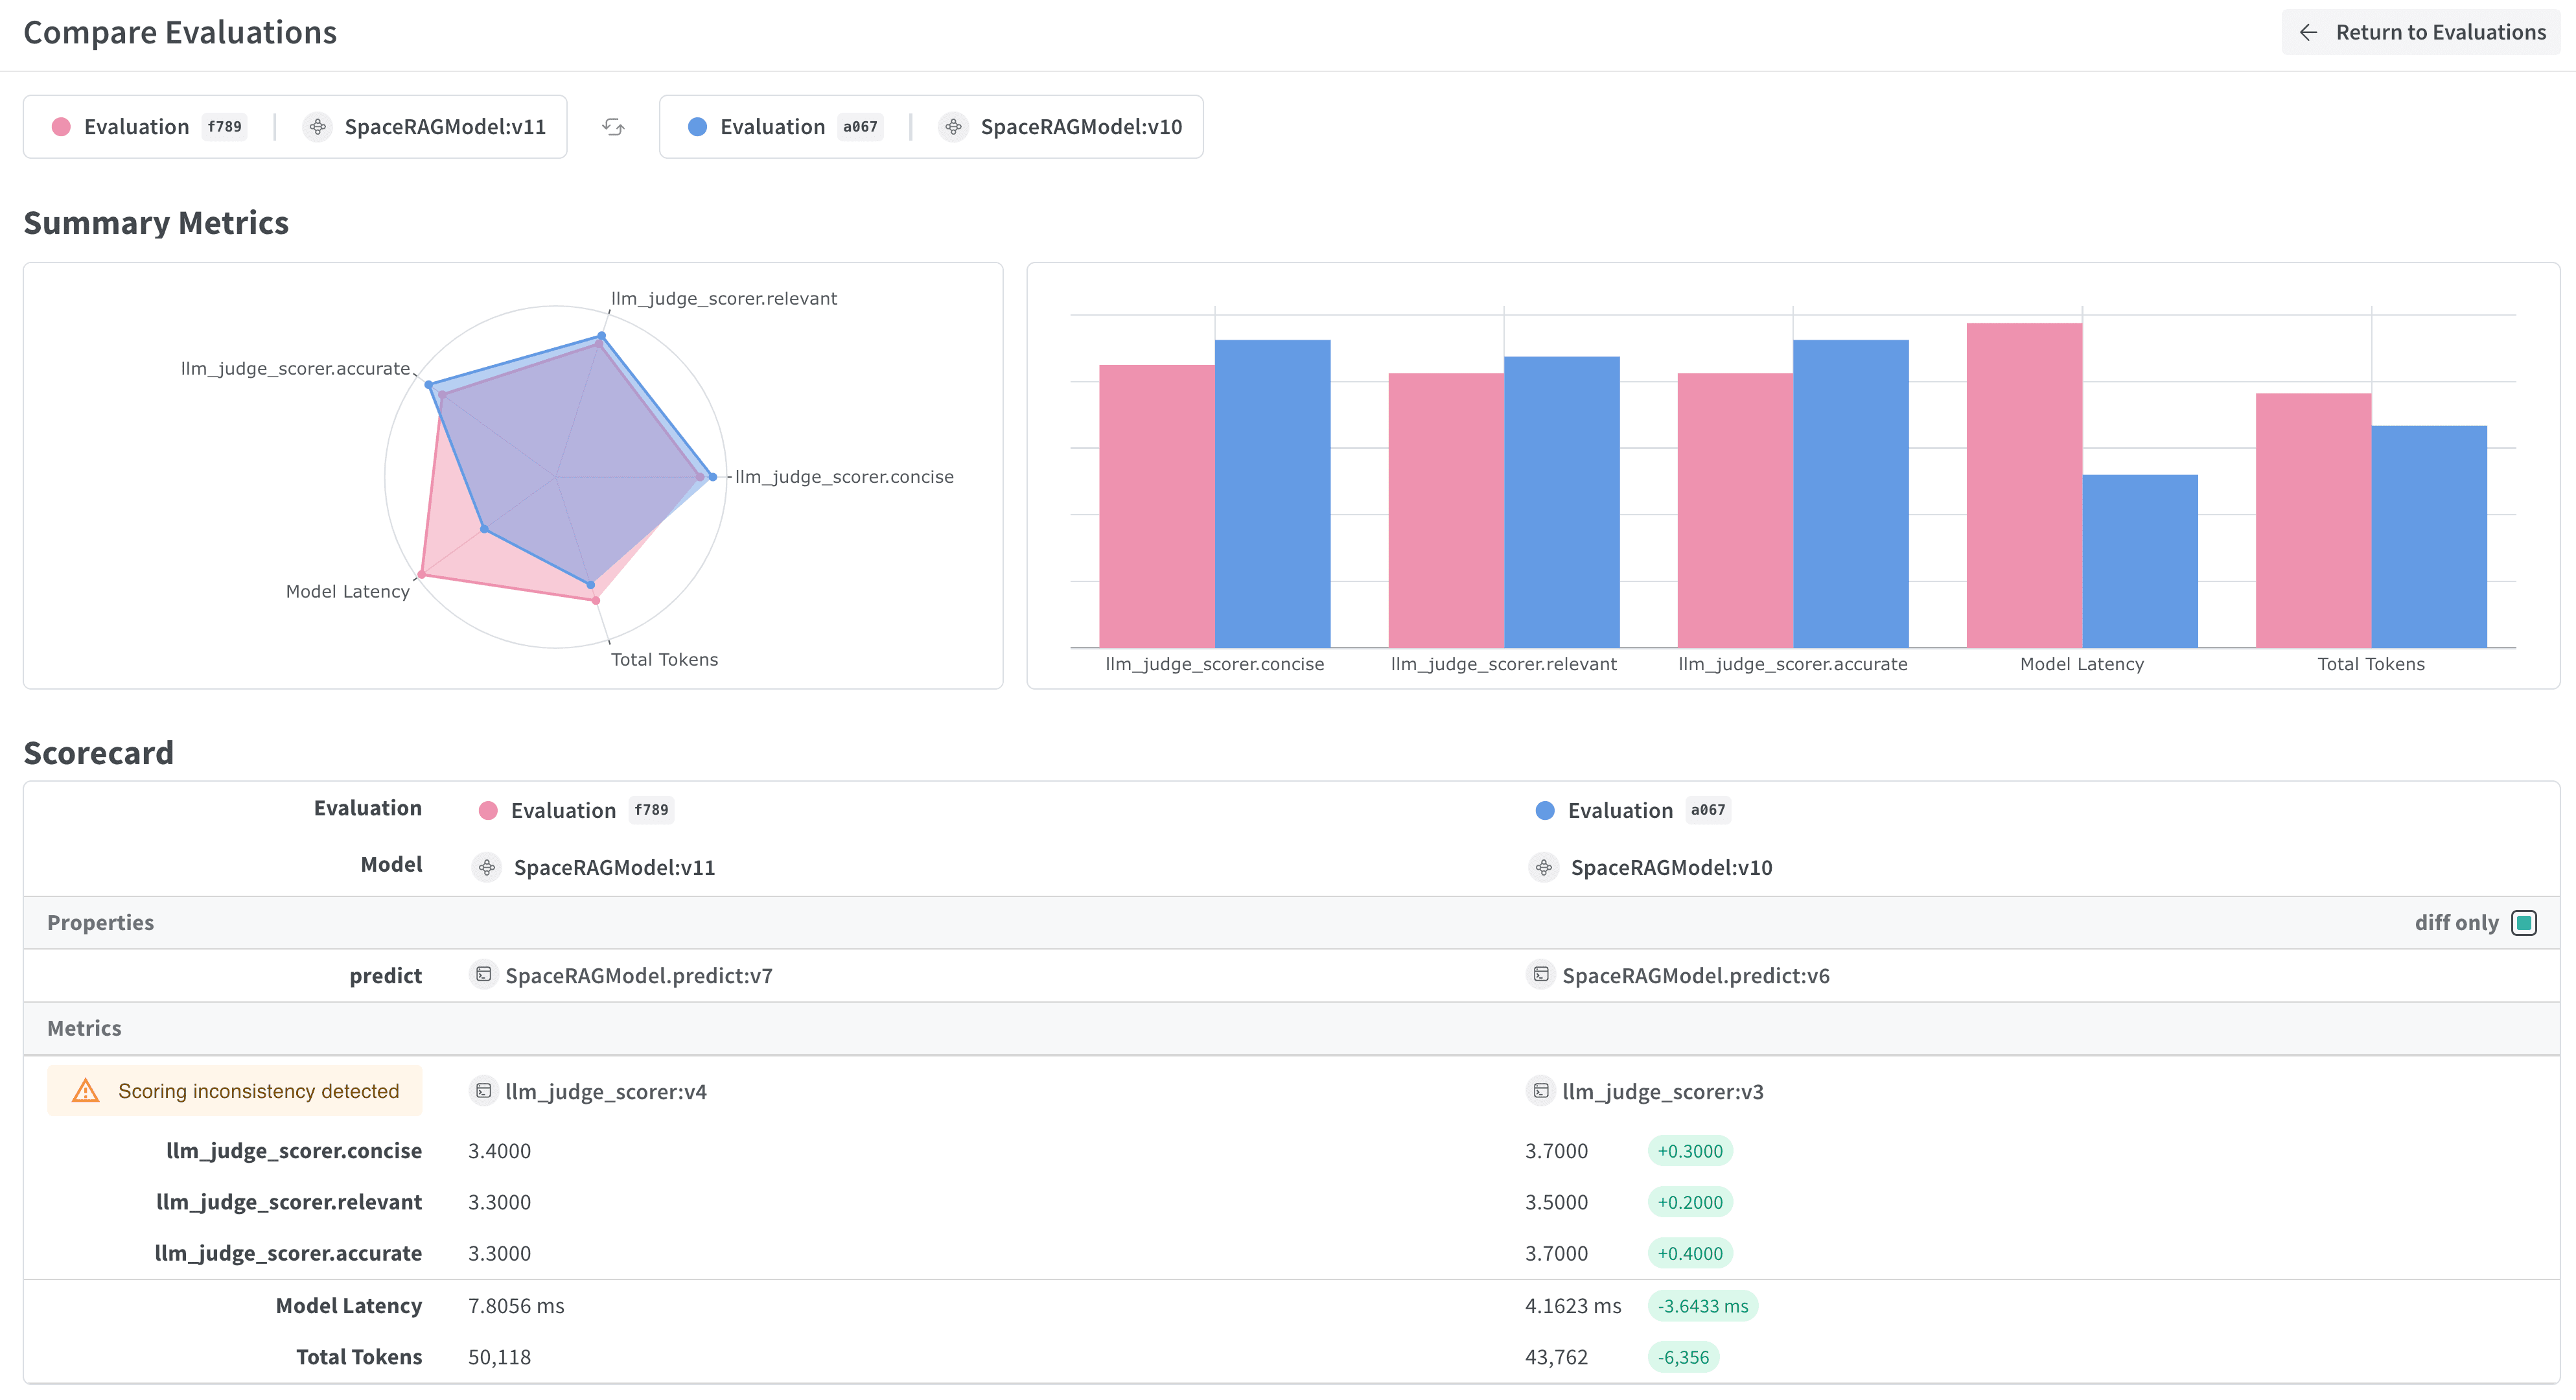 Pour ce faire, récupérez toutes les conversations depuis W\&B à l’aide de l’API de requête, puis créez-en un dataset.
```python lines theme={"system"}
## Cette cellule ne s’exécute pas par défaut ; commentez la ligne ci-dessous pour exécuter ce script
%%script false --no-raise-error
## Obtenir toutes les traces Conversation et préparer le jeu de données d’évaluation
# Nous créons un filtre de requête qui récupère tous nos objets Conversation
# La réf. ci-dessous est propre à votre projet ; pour l’obtenir, accédez
# aux Operations de votre projet dans l’interface utilisateur, cliquez sur l’objet
# « Conversations », puis sur l’onglet « Use » du panneau latéral.
weave_ref_for_conversation_op = "weave://wandb-smle/import-weave-traces-cookbook/op/Conversation:tzUhDyzVm5bqQsuqh5RT4axEXSosyLIYZn9zbRyenaw"
filter = weave.trace_server.trace_server_interface.CallsFilter(
op_names=[weave_ref_for_conversation_op],
)
# Nous exécutons la requête
conversation_traces = weave_client.get_calls(filter=filter)
rows = []
# Nous parcourons nos traces de conversation pour en tirer des lignes de jeu de données
for single_conv in conversation_traces:
# Dans cet exemple, seules les conversations ayant utilisé notre pipeline RAG
# nous intéressent ; nous filtrons donc ce type de conversations
is_rag = False
for single_trace in single_conv.inputs['conversation_data']:
if single_trace['ground_truth'] is not None:
is_rag = True
break
if single_conv.output['ground_truth'] is not None:
is_rag = True
# Lorsqu’une conversation a utilisé RAG, nous l’ajoutons à notre jeu de données
if is_rag:
inputs = []
ground_truths = []
answers = []
# Nous parcourons chaque tour de conversation
for turn in single_conv.inputs['conversation_data']:
inputs.append(turn.get('user_input', ''))
ground_truths.append(turn.get('ground_truth', ''))
answers.append(turn.get('answer_text', ''))
## Gérer le cas des conversations à un seul tour
if len(single_conv.inputs) != 1 or single_conv.inputs['conversation_data'][0].get('turn_index') != single_conv.output.get('turn_index'):
inputs.append(single_conv.output.get('user_input', ''))
ground_truths.append(single_conv.output.get('ground_truth', ''))
answers.append(single_conv.output.get('answer_text', ''))
data = {
'question': inputs,
'contexts': ground_truths,
'answer': answers
}
rows.append(data)
# Une fois les lignes du jeu de données créées, nous créons l’objet Dataset et
# le publions vers Weave afin de pouvoir le récupérer ultérieurement
dset = weave.Dataset(name = "conv_traces_for_eval", rows=rows)
weave.publish(dset)
```
Résultat
Le dataset exporté est désormais republié dans Weave et peut servir d’entrée pour une évaluation.
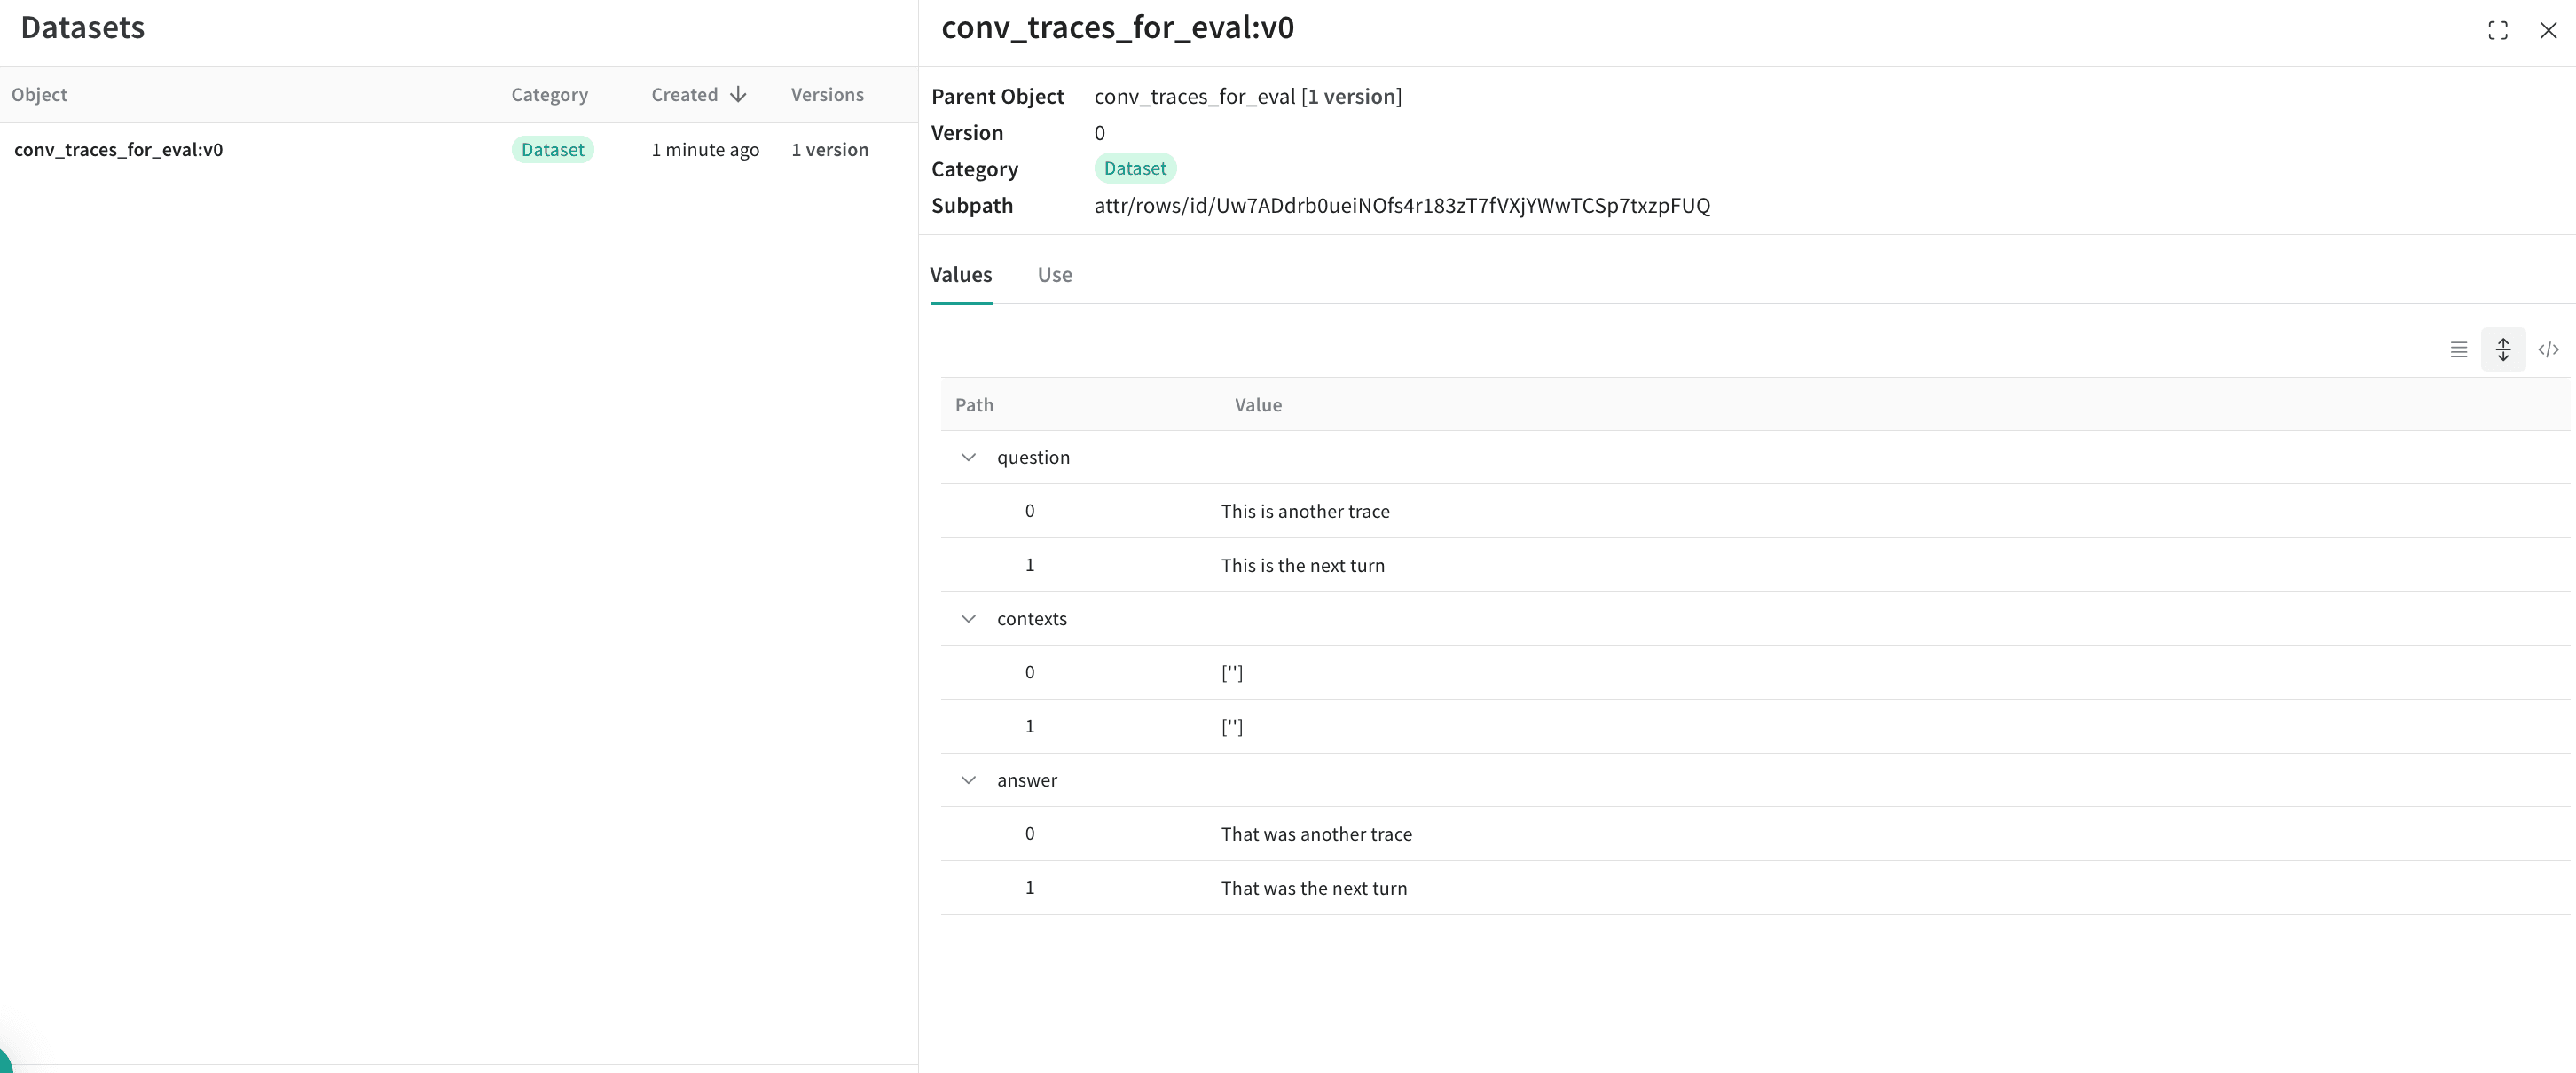 Pour en savoir plus sur les évaluations, consultez le [Démarrage rapide](/fr/products/wandb/weave/tutorial-rag), qui explique comment utiliser votre nouveau dataset pour évaluer votre application RAG.