> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Optimisation des prompts avec DSPy
> Découvrez comment utiliser l’optimisation des prompts de DSPy avec W&B Weave
Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens suivants :
* [Ouvrir dans Google Colab](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/dspy_prompt_optimization.ipynb)
* [Voir la source sur GitHub](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/dspy_prompt_optimization.ipynb)
[BIG-bench (Beyond the Imitation Game Benchmark)](https://github.com/google/BIG-bench) est un benchmark collaboratif qui évalue les grands modèles de langage et extrapole leurs capacités futures sur plus de 200 tâches. [BIG-Bench Hard (BBH)](https://github.com/suzgunmirac/BIG-Bench-Hard) regroupe les 23 tâches BIG-Bench les plus difficiles, que la génération actuelle de modèles de langage peut avoir du mal à résoudre.
Ce tutoriel montre comment améliorer les performances d’un flux de travail LLM appliqué à la tâche de jugement causal du benchmark BIG-bench Hard, et comment évaluer différentes stratégies de prompting. Vous utiliserez [DSPy](https://dspy.ai) pour implémenter le flux de travail LLM et optimiser la stratégie de prompting, ainsi que [Weave](/fr/products/wandb/weave) pour suivre le flux de travail LLM et évaluer les stratégies de prompting.
À la fin de ce tutoriel, vous aurez créé un programme DSPy de référence pour le raisonnement causal, vous l’aurez évalué avec Weave, vous aurez appliqué un optimiseur DSPy pour améliorer sa stratégie de prompting, puis comparé le programme optimisé à la référence. Ce tutoriel s’adresse aux praticiens qui souhaitent appliquer l’optimisation des prompts à leurs propres flux de travail LLM et utiliser Weave pour suivre et comparer les résultats.
Installer les dépendances
Avant de commencer, installez les bibliothèques utilisées tout au long du tutoriel. Ce tutoriel utilise les bibliothèques suivantes :
* [DSPy](https://dspy.ai) pour créer et optimiser le flux de travail LLM.
* [Weave](/fr/products/wandb/weave) pour suivre le flux de travail LLM et évaluer différentes stratégies de prompting.
* [datasets](https://huggingface.co/docs/datasets/index) pour accéder au dataset BIG-Bench Hard depuis le Hugging Face Hub.
```python lines theme={"system"}
!pip install -qU dspy weave "datasets<4"
```
Ce tutoriel utilisant l’[API OpenAI](https://openai.com/index/openai-api/) comme fournisseur de LLM, vous avez également besoin d’une clé API OpenAI. Pour obtenir votre propre clé API, vous pouvez [vous inscrire](https://platform.openai.com/signup) sur la plateforme OpenAI.
```python lines theme={"system"}
import os
from getpass import getpass
api_key = getpass("Enter you OpenAI API key: ")
os.environ["OPENAI_API_KEY"] = api_key
```
Activer le suivi avec Weave
Cette section configure Weave afin que les appels DSPy effectués dans la suite du tutoriel soient automatiquement tracés et consultables dans l'interface utilisateur de Weights & Biases.
Weave s'intègre à DSPy. Il suffit d'ajouter [`weave.init`](/fr/products/wandb/weave/reference/python-sdk/trace/weave_client#method-init) au début de votre code pour tracer automatiquement vos fonctions DSPy, que vous pourrez ensuite explorer dans l'interface utilisateur de Weights & Biases. Pour plus d'informations, voir la [documentation de l'intégration Weave pour DSPy](/fr/products/wandb/weave/guides/integrations/dspy).
```python lines theme={"system"}
import weave
weave.init(project_name="dspy-bigbench-hard")
```
Ce tutoriel utilise une classe de métadonnées qui hérite de [`weave.Object`](/fr/products/wandb/weave/reference/python-sdk#class-object) pour gérer les métadonnées.
```python lines theme={"system"}
class Metadata(weave.Object):
dataset_address: str = "maveriq/bigbenchhard"
big_bench_hard_task: str = "causal_judgement"
num_train_examples: int = 50
openai_model: str = "gpt-4o-mini"
openai_max_tokens: int = 2048
max_bootstrapped_demos: int = 8
max_labeled_demos: int = 8
metadata = Metadata()
```
Gestion des versions des objets : les objets `Metadata` sont automatiquement versionnés et tracés dès lors que les fonctions qui les utilisent sont tracées.
Charger le dataset BIG-Bench Hard
Une fois le suivi Weave activé, l’étape suivante consiste à préparer les données qui serviront à entraîner et à évaluer le programme DSPy.
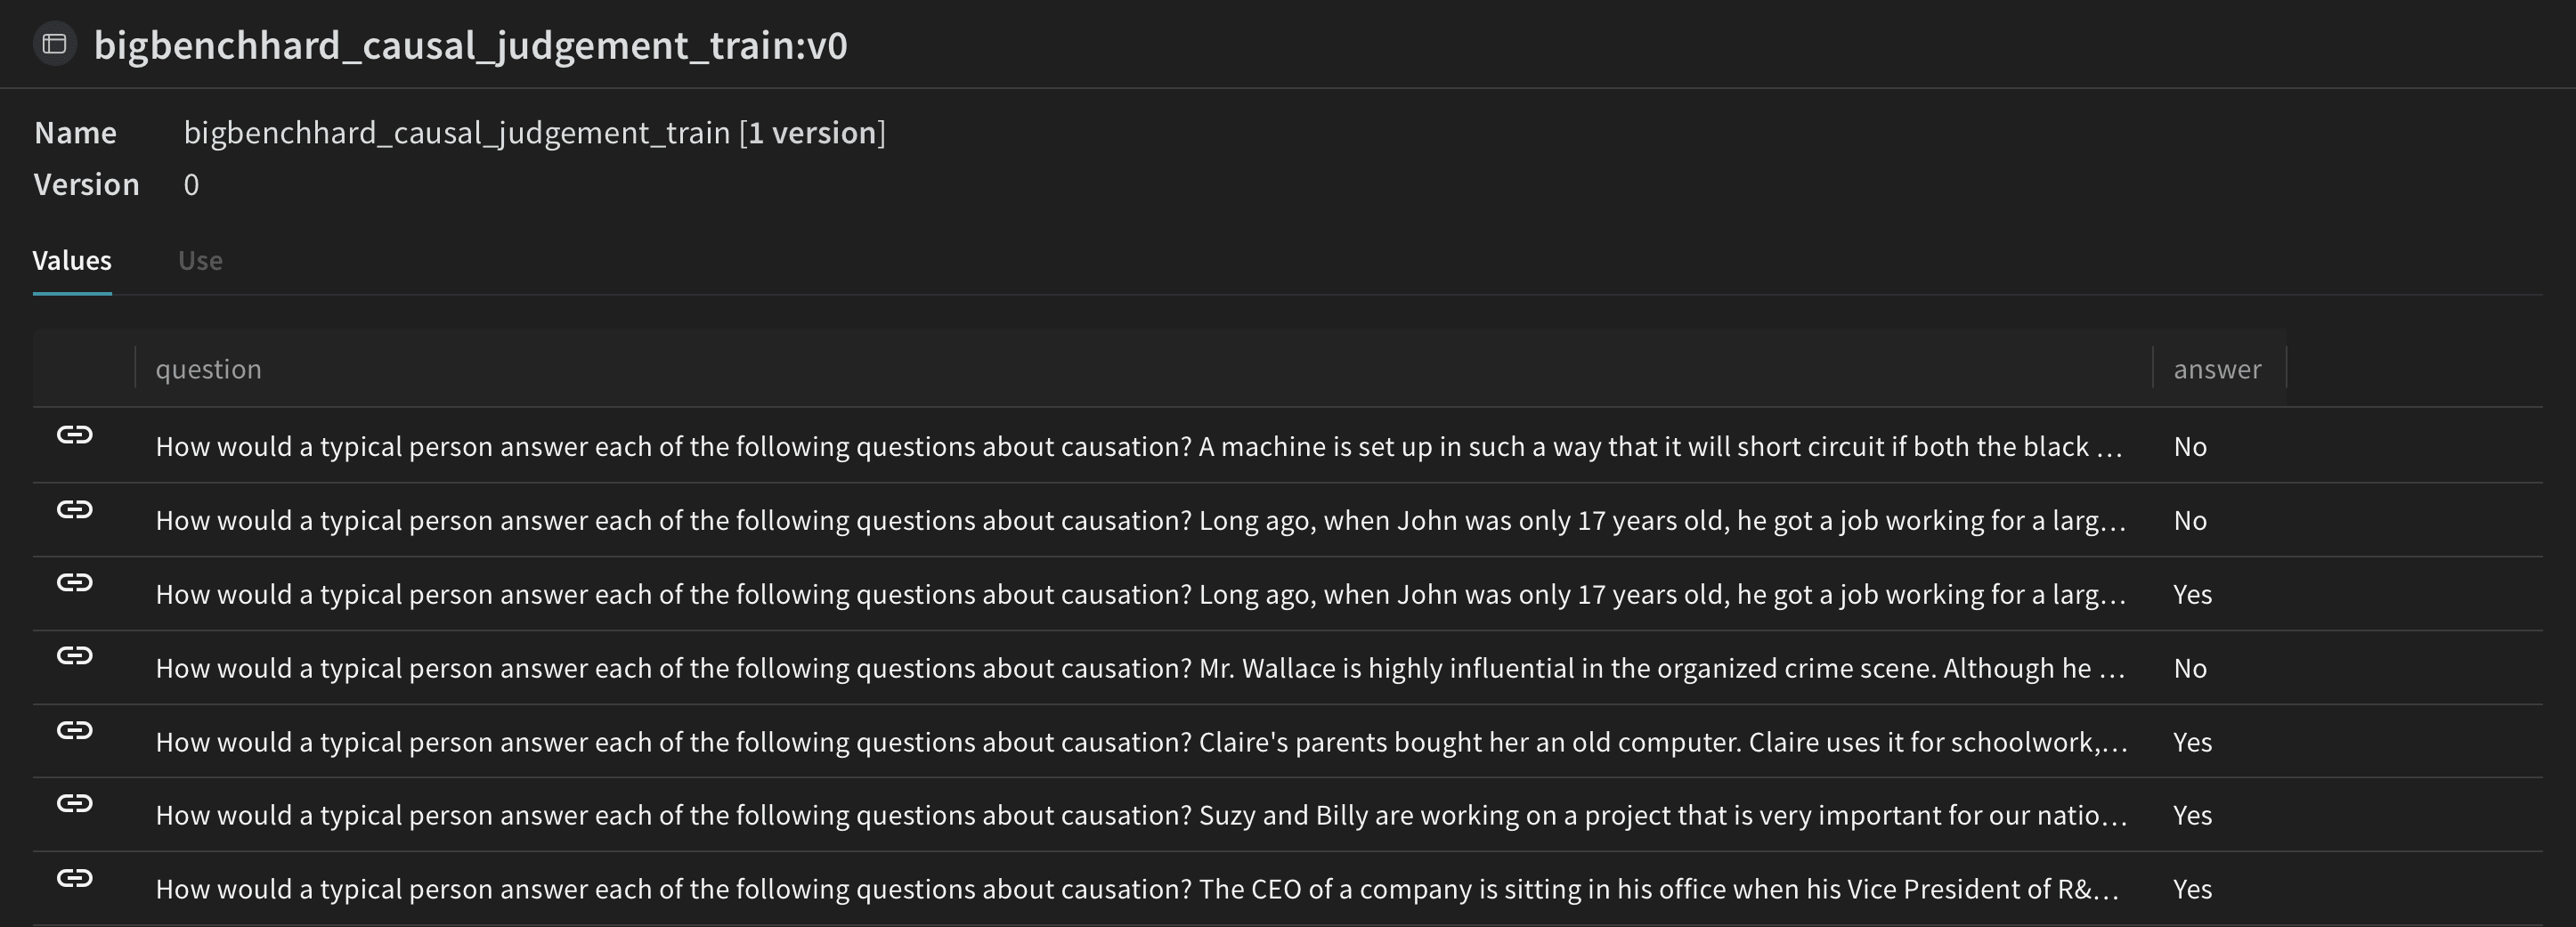
Chargez ce dataset depuis le HuggingFace Hub, divisez-le en ensembles d’entraînement et de validation, puis [publiez](/fr/products/wandb/weave/guides/core-types/datasets)-les sur Weave. La publication vous permet de versionner les datasets, mais aussi d’utiliser [`weave.Evaluation`](/fr/products/wandb/weave/guides/core-types/evaluations) pour évaluer votre stratégie de prompting.
```python lines theme={"system"}
import dspy
from datasets import load_dataset
@weave.op()
def get_dataset(metadata: Metadata):
# charger le jeu de données BIG-Bench Hard correspondant à la tâche depuis le Hub Hugging Face
dataset = load_dataset(metadata.dataset_address, metadata.big_bench_hard_task)[
"train"
]
# créer les jeux de données d’entraînement et de validation
rows = [{"question": data["input"], "answer": data["target"]} for data in dataset]
train_rows = rows[0 : metadata.num_train_examples]
val_rows = rows[metadata.num_train_examples :]
# créer les exemples d’entraînement et de validation, constitués d’objets `dspy.Example`
dspy_train_examples = [
dspy.Example(row).with_inputs("question") for row in train_rows
]
dspy_val_examples = [dspy.Example(row).with_inputs("question") for row in val_rows]
# publier les jeux de données sur Weave afin de versionner les données et de les utiliser pour l’évaluation
weave.publish(
weave.Dataset(
name=f"bigbenchhard_{metadata.big_bench_hard_task}_train", rows=train_rows
)
)
weave.publish(
weave.Dataset(
name=f"bigbenchhard_{metadata.big_bench_hard_task}_val", rows=val_rows
)
)
return dspy_train_examples, dspy_val_examples
dspy_train_examples, dspy_val_examples = get_dataset(metadata)
```
Le programme DSPy
Une fois le dataset publié dans Weave, vous pouvez définir le programme DSPy de référence que vous évaluerez et optimiserez par la suite.
[DSPy](https://dspy.ai) est un framework qui éloigne la création de nouveaux pipelines de LM de la manipulation de chaînes de caractères libres pour la rapprocher de la programmation (composition d’opérateurs modulaires pour construire des graphes de transformation de texte), un compilateur générant automatiquement, à partir d’un programme, des stratégies d’invocation de LM et des prompts optimisés.
Utilisez [`dspy.LM`](https://dspy.ai/learn/programming/language_models) pour configurer le modèle de langage et [`dspy.configure`](https://dspy.ai/api/utils/configure/) pour le définir comme modèle par défaut.
```python lines theme={"system"}
llm = dspy.LM("openai/gpt-4o-mini")
dspy.configure(lm=llm)
```
Écrire la signature de raisonnement causal
Une [signature](https://dspy.ai/learn/programming/signatures) est une spécification déclarative du comportement d’entrée/sortie d’un [module DSPy](https://dspy.ai/learn/programming/modules). Les modules DSPy sont des composants qui s’adaptent à la tâche (à la manière des couches d’un réseau de neurones) et qui abstraient une transformation de texte donnée.
```python lines theme={"system"}
class CausalReasoning(dspy.Signature):
"""You are an expert in causal reasoning. Analyze the given question carefully
and answer Yes or No. Provide a detailed explanation justifying your answer."""
question: str = dspy.InputField(desc="The question to be answered")
answer: str = dspy.OutputField(desc="Yes or No")
confidence: float = dspy.OutputField(desc="Confidence score between 0 and 1")
explanation: str = dspy.OutputField(desc="Detailed explanation for the answer")
class CausalReasoningModule(dspy.Module):
def __init__(self):
self.prog = dspy.Predict(CausalReasoning)
@weave.op()
def forward(self, question: str) -> dict:
result = self.prog(question=question)
return {
"answer": result.answer,
"confidence": result.confidence,
"explanation": result.explanation,
}
```
Testez le flux de travail LLM (c’est-à-dire le `CausalReasoningModule`) sur un exemple tiré du sous-ensemble de raisonnement causal de BIG-Bench Hard.
```python lines theme={"system"}
import rich
baseline_module = CausalReasoningModule()
prediction = baseline_module(dspy_train_examples[0]["question"])
rich.print(prediction)
```
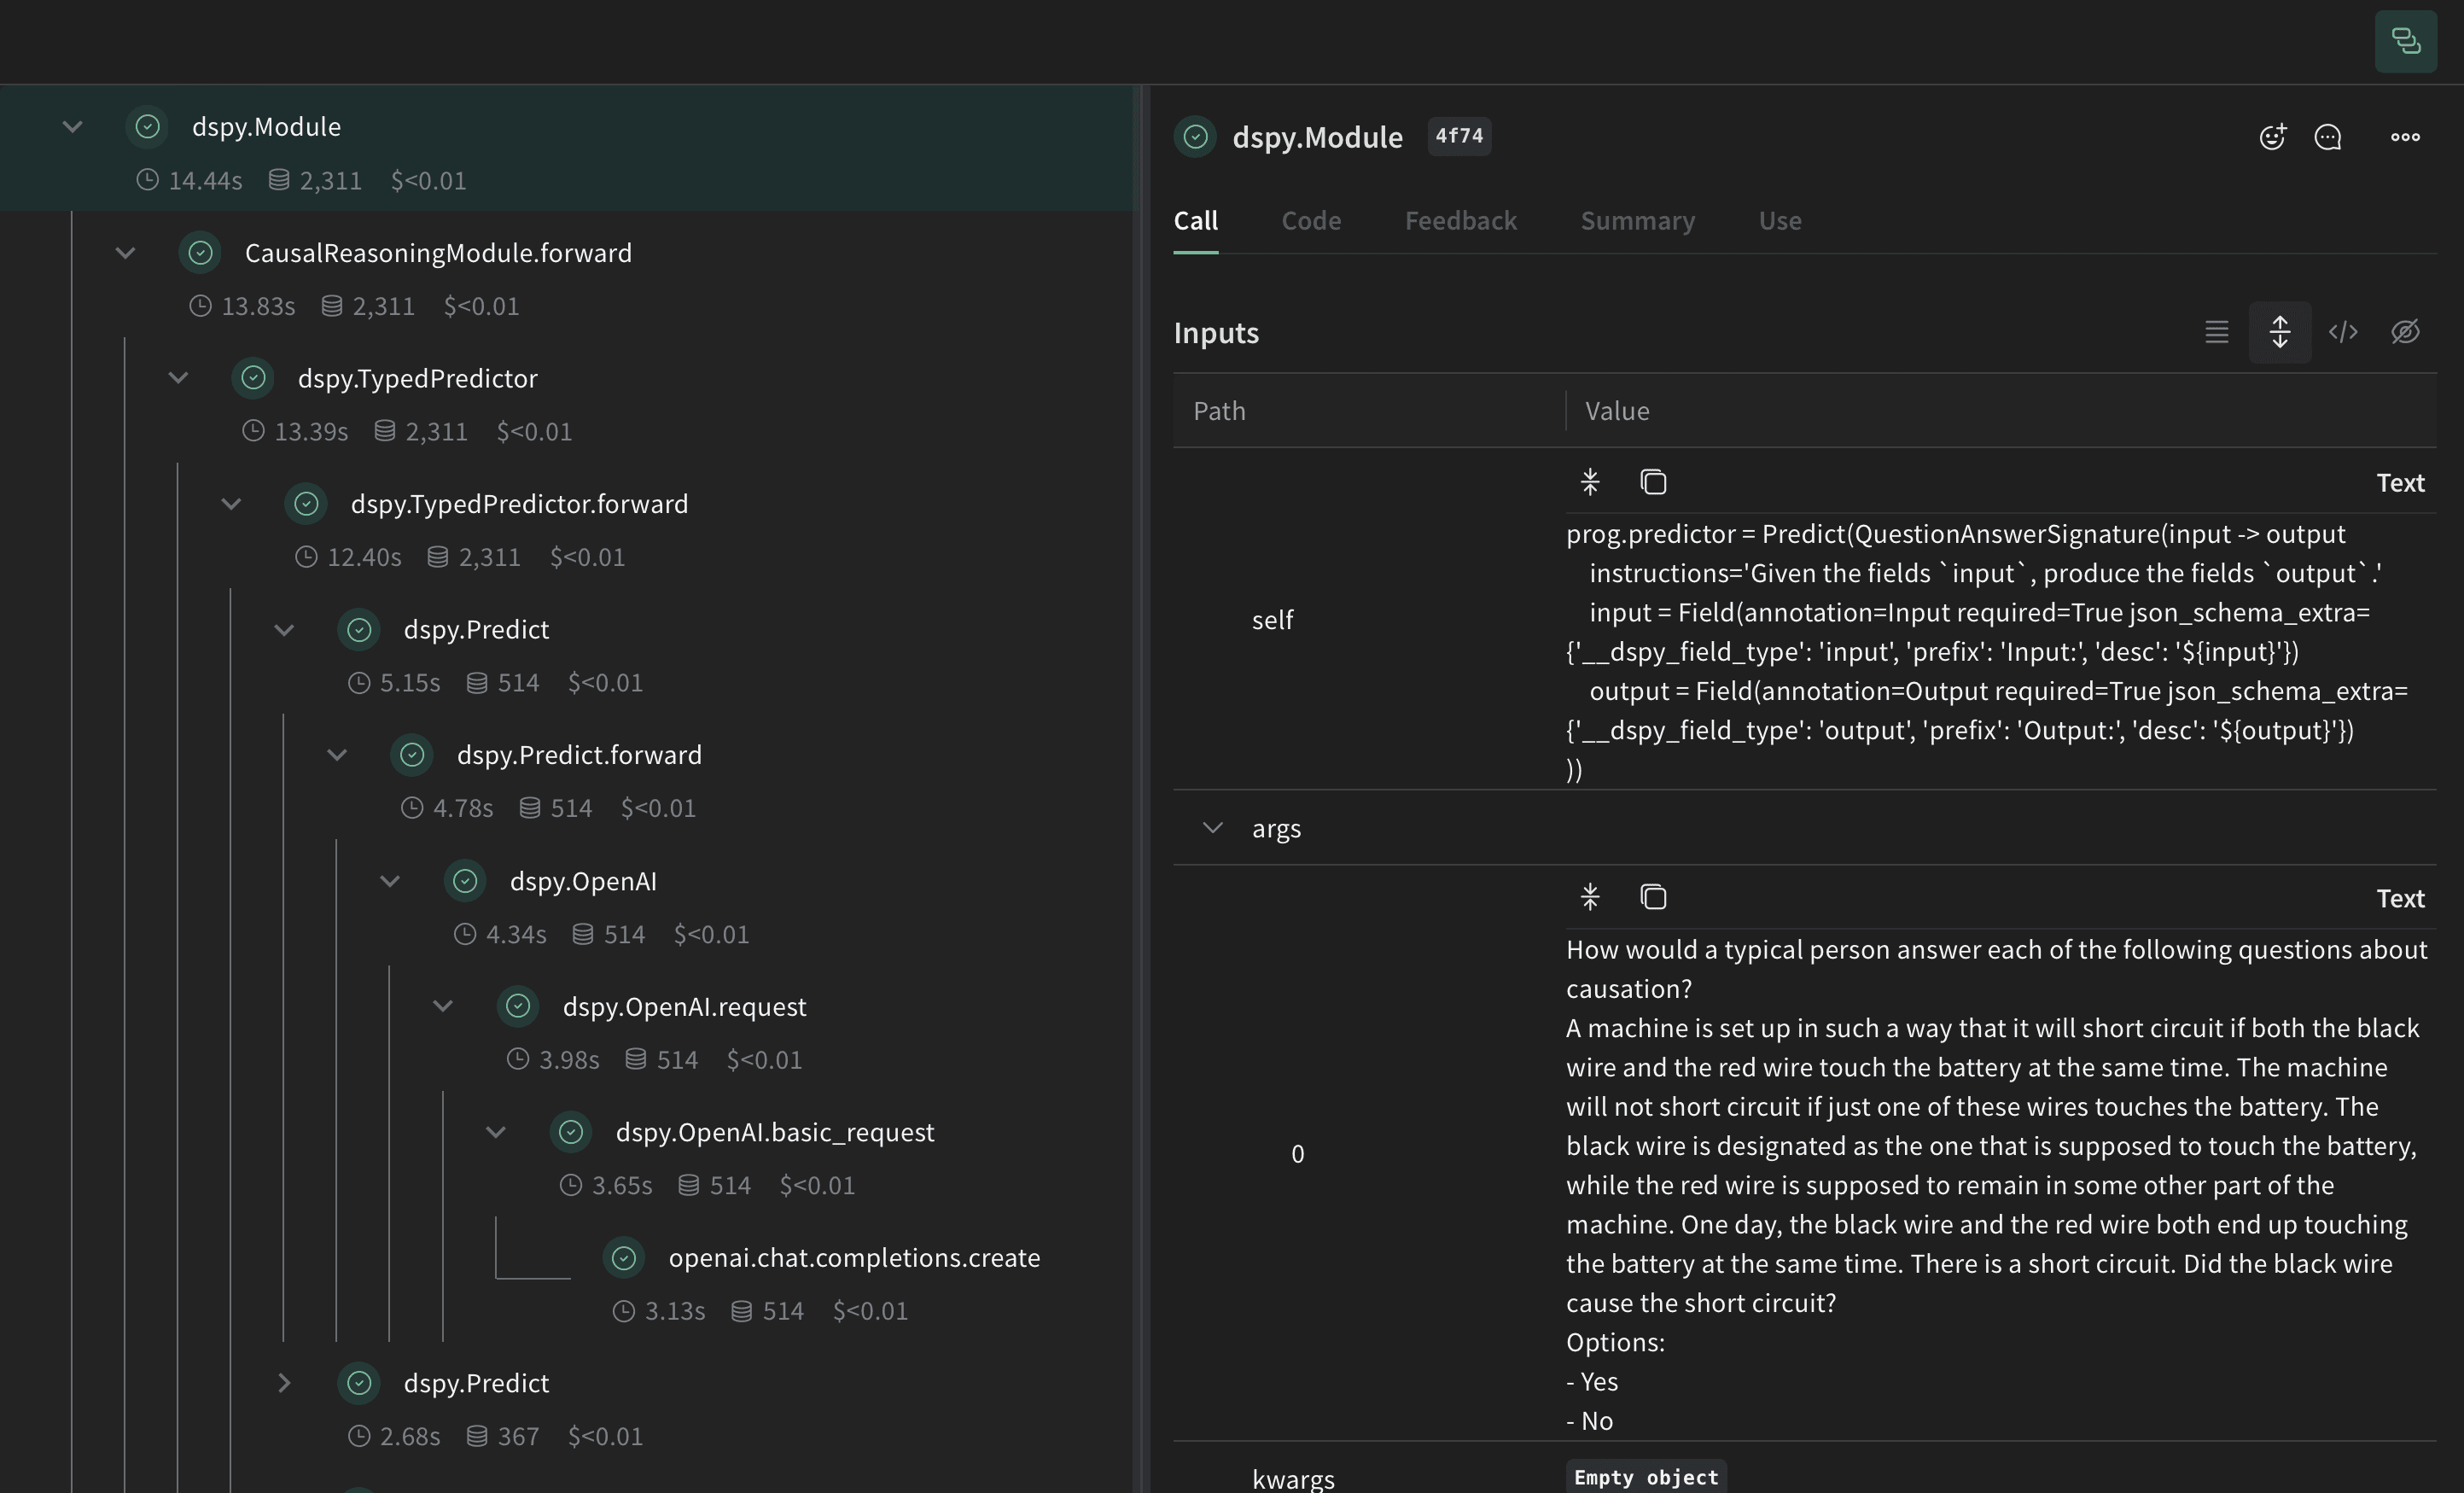
Évaluer le programme DSPy
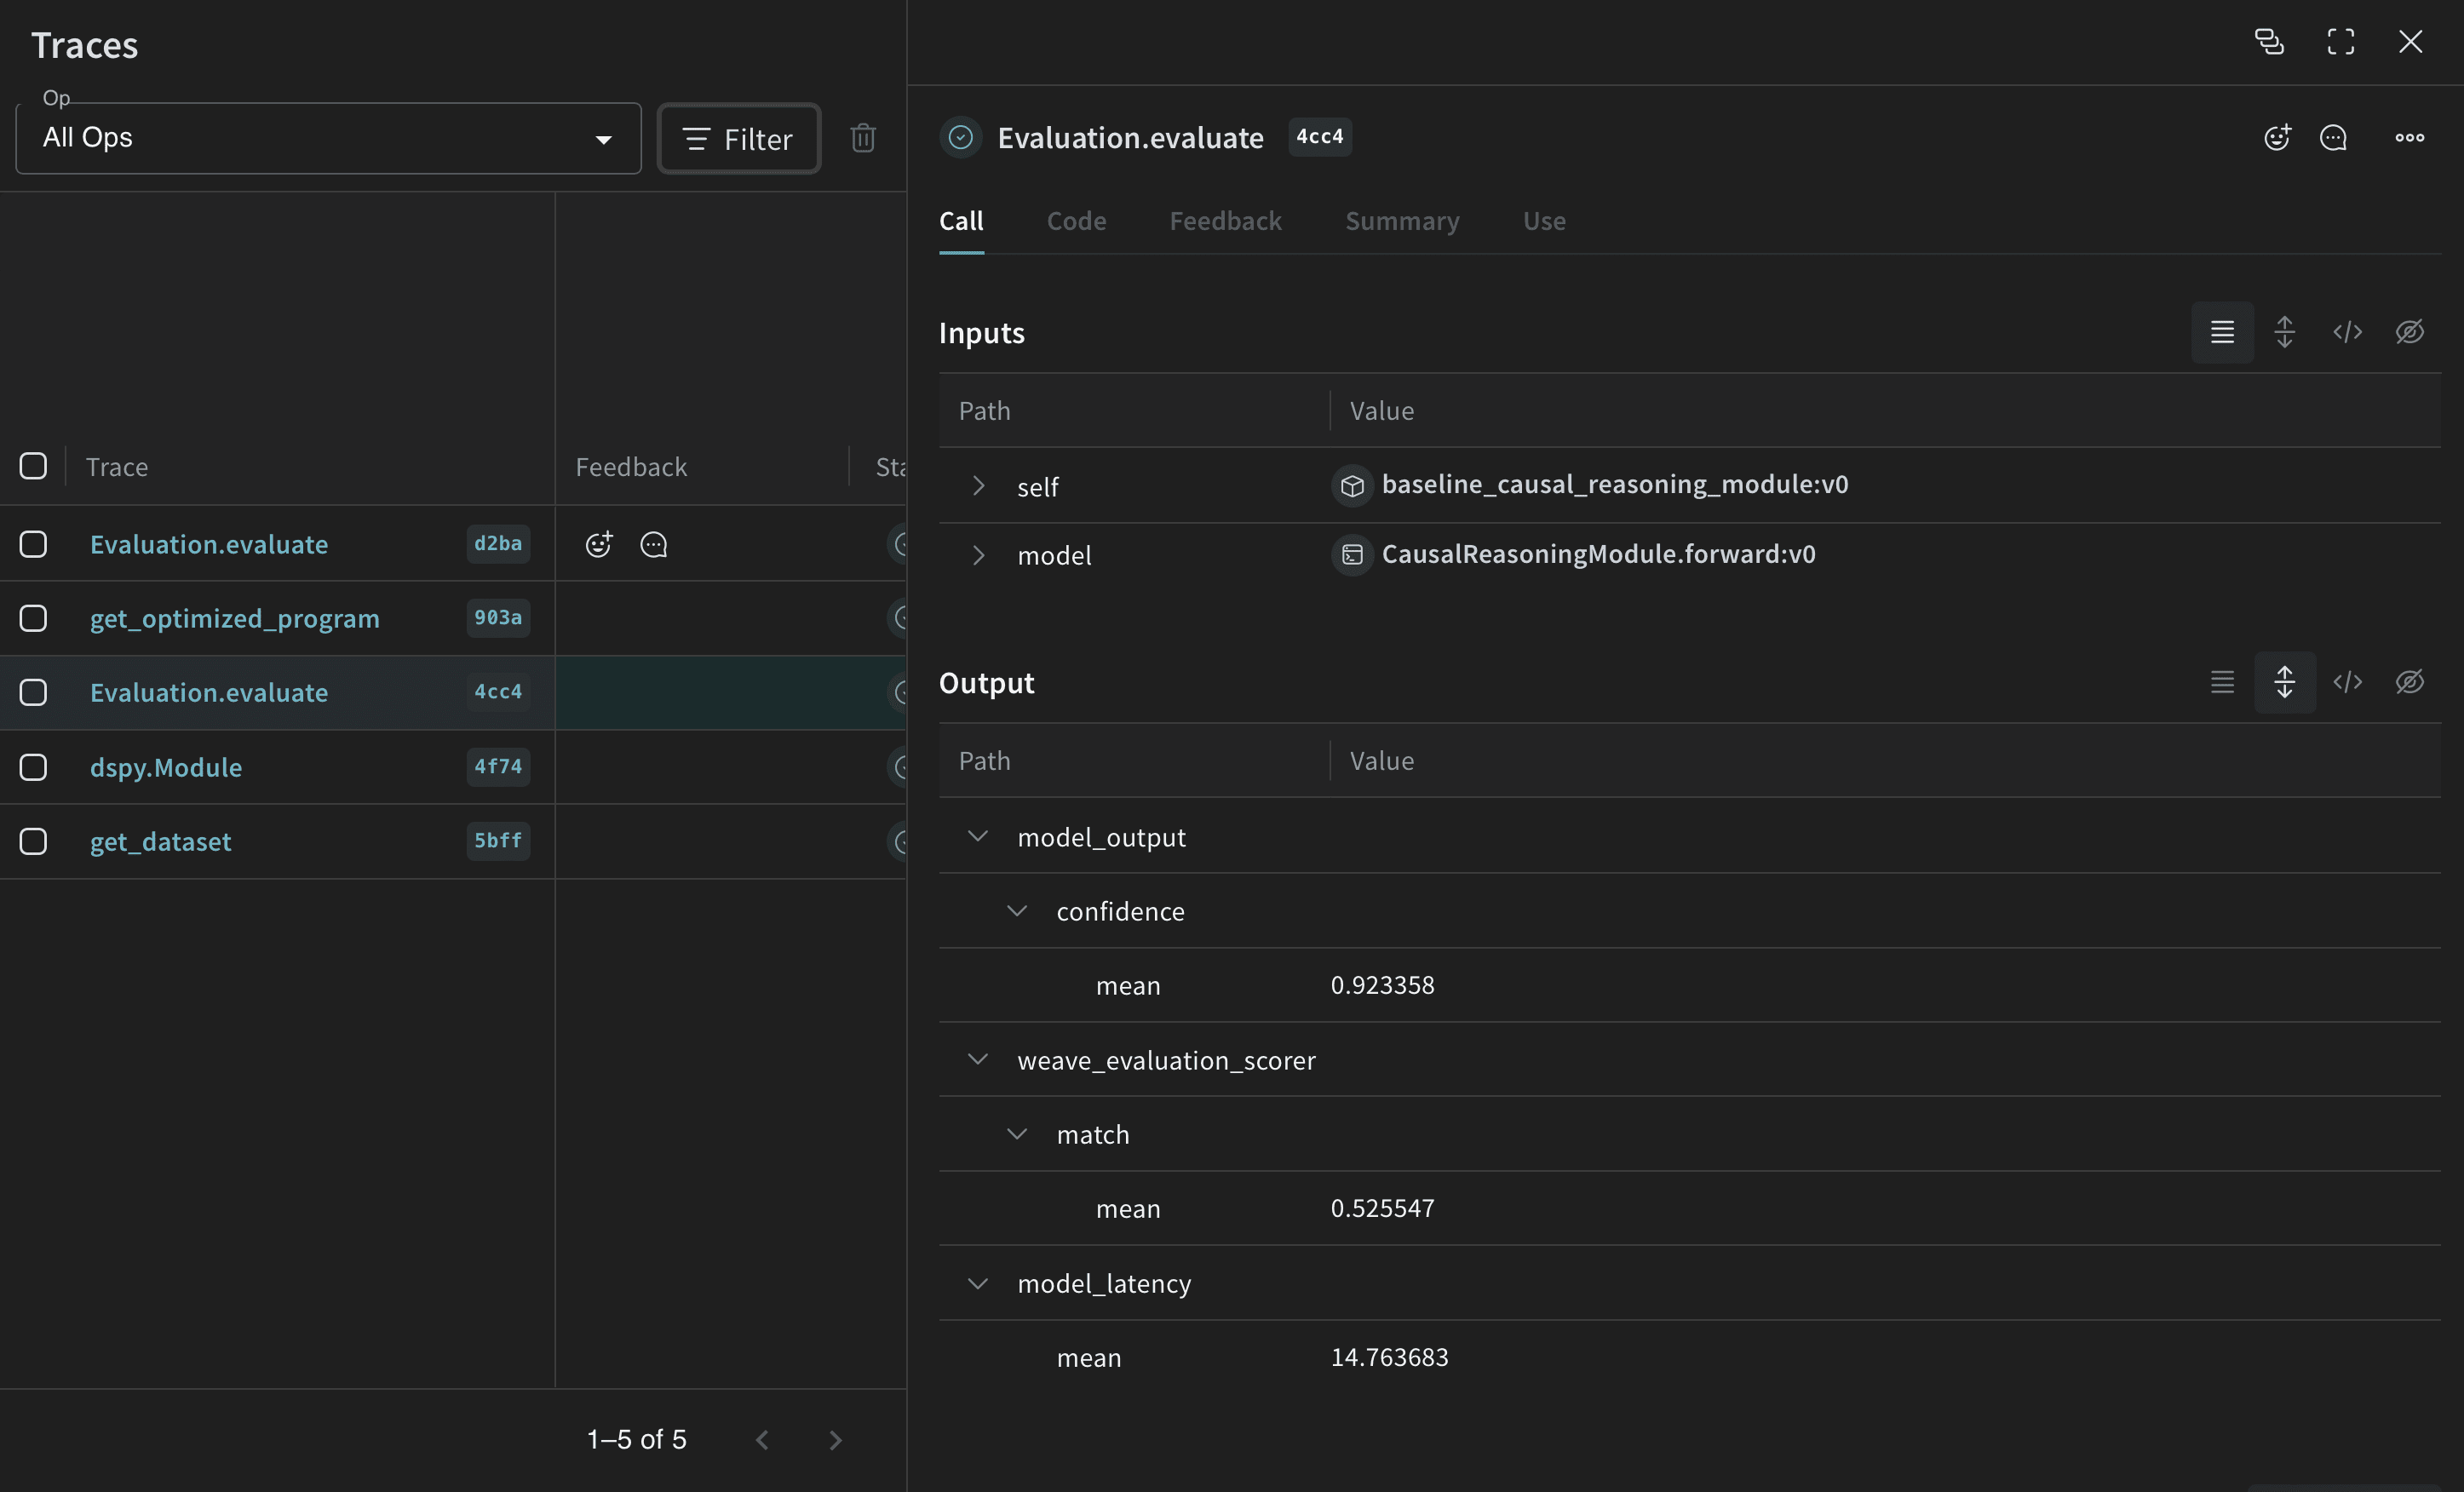
Maintenant que vous disposez d’une stratégie de prompting de référence, évaluez-la sur l’ensemble de validation à l’aide de [`weave.Evaluation`](/fr/products/wandb/weave/guides/core-types/evaluations), avec une métrique qui compare la réponse prédite à la vérité terrain. Weave prend chaque exemple, le transmet à votre application et évalue la sortie à l’aide de plusieurs fonctions de score personnalisées. Vous obtenez ainsi une vue d’ensemble des performances de votre application, ainsi qu’une interface riche pour examiner en détail chaque sortie et chaque score.
Commencez par créer une fonction de score qui détermine si la réponse prédite correspond à la vérité terrain. Les fonctions de score Weave reçoivent la valeur de retour du modèle dans `output`, ainsi que, sous forme d’arguments supplémentaires, toutes les clés correspondantes de l’exemple du dataset. Ici, `answer` provient du dataset et `output` est le dict renvoyé par `CausalReasoningModule.forward`.
```python lines theme={"system"}
@weave.op()
def weave_evaluation_scorer(answer: str, output: dict) -> dict:
return {"match": int(answer.lower() == output["answer"].lower())}
```
Ensuite, encapsulez le module dans une fonction tracée que `weave.Evaluation` peut appeler. Les noms des arguments du wrapper doivent correspondre aux noms des colonnes du dataset exploitées par le modèle.
```python lines theme={"system"}
@weave.op()
def predict(question: str) -> dict:
return baseline_module(question=question)
```
Vous pouvez maintenant définir l’évaluation et l’exécuter.
```python lines theme={"system"}
validation_dataset = weave.ref(
f"bigbenchhard_{metadata.big_bench_hard_task}_val:v0"
).get()
evaluation = weave.Evaluation(
name="baseline_causal_reasoning_module",
dataset=validation_dataset,
scorers=[weave_evaluation_scorer],
)
await evaluation.evaluate(predict)
```
 Si vous exécutez le code à partir d’un script Python, vous pouvez utiliser le code suivant pour lancer l’évaluation :
```python lines theme={"system"}
import asyncio
asyncio.run(evaluation.evaluate(predict))
```
L’exécution de l’évaluation sur le dataset de raisonnement causal coûte environ 0,24 \$ en crédits OpenAI.
Optimiser le programme DSPy
Une fois les performances de référence mesurées, vous pouvez appliquer un optimiseur DSPy et comparer le résultat à la référence.
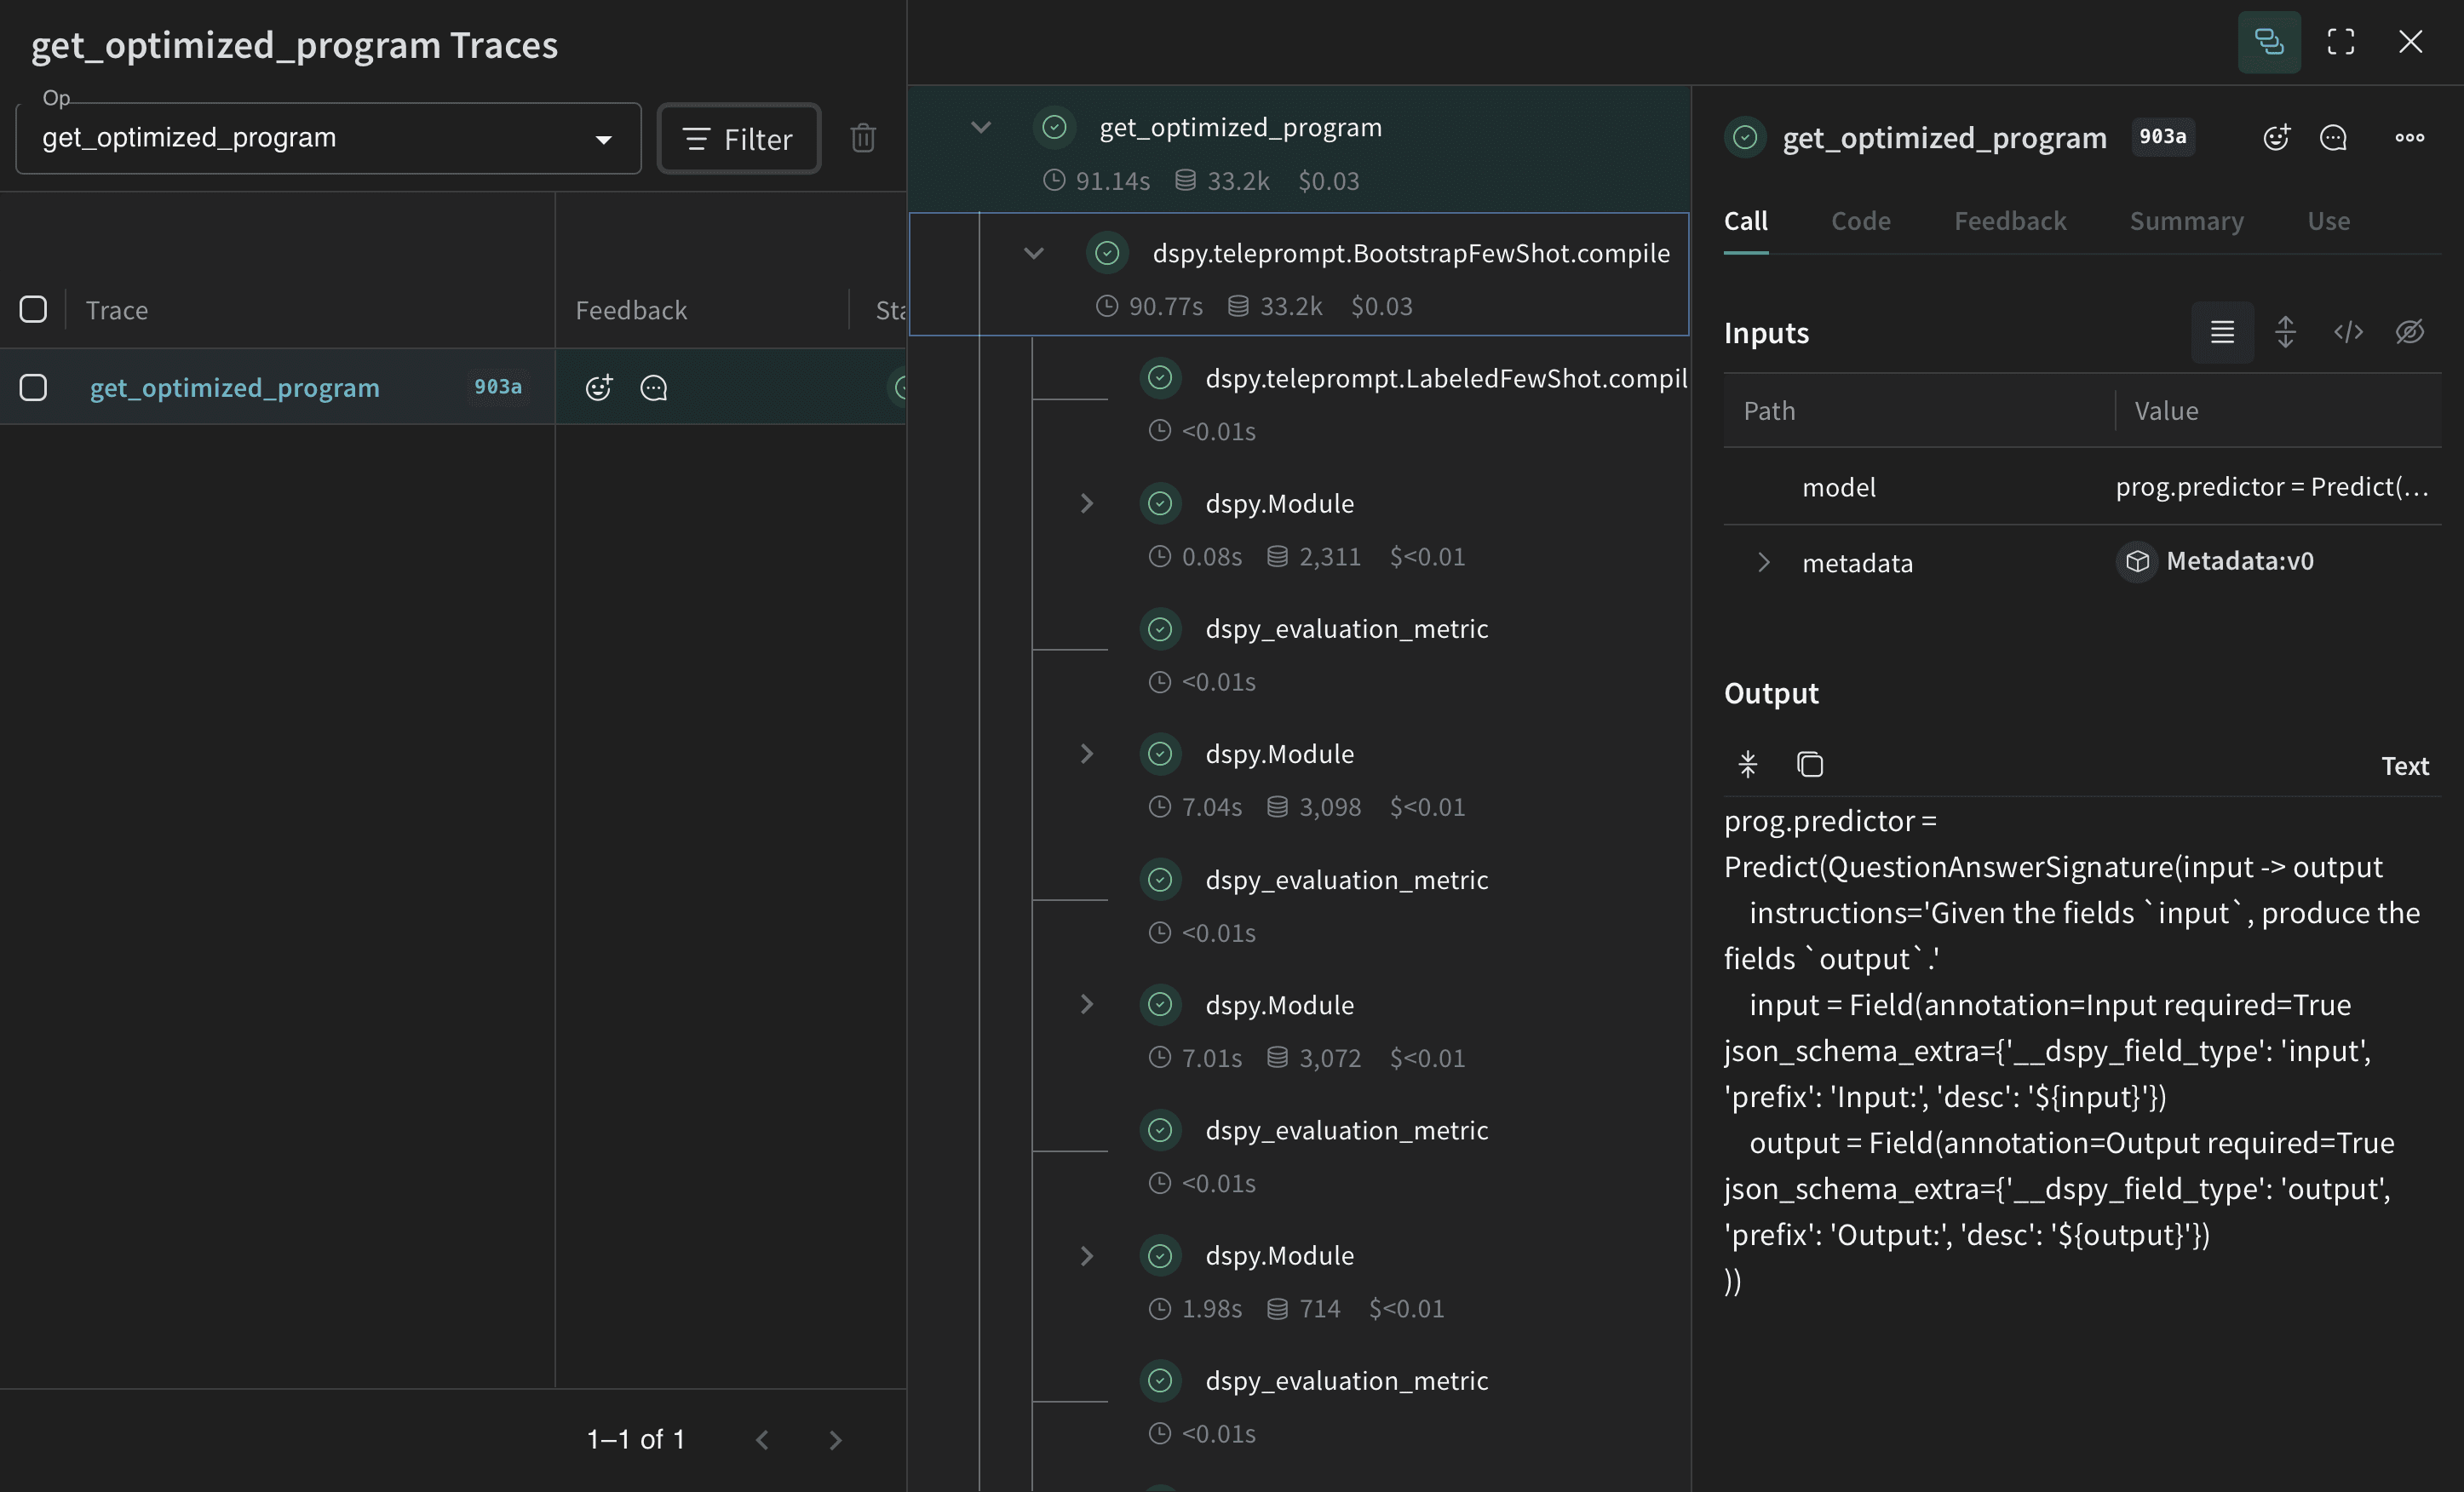
Maintenant que vous disposez d’un programme DSPy de référence, améliorez ses performances en raisonnement causal à l’aide de l’optimiseur [BootstrapFewShot](https://dspy.ai/api/optimizers/BootstrapFewShot/), qui peut ajuster les paramètres d’un programme DSPy afin de maximiser les métriques spécifiées.
```python lines theme={"system"}
from dspy.teleprompt import BootstrapFewShot
@weave.op()
def get_optimized_program(model: dspy.Module, metadata: Metadata) -> dspy.Module:
@weave.op()
def dspy_evaluation_metric(true, prediction, trace=None):
return prediction["answer"].lower() == true.answer.lower()
teleprompter = BootstrapFewShot(
metric=dspy_evaluation_metric,
max_bootstrapped_demos=metadata.max_bootstrapped_demos,
max_labeled_demos=metadata.max_labeled_demos,
)
return teleprompter.compile(model, trainset=dspy_train_examples)
optimized_module = get_optimized_program(baseline_module, metadata)
```
 L’exécution de l’évaluation sur le dataset de raisonnement causal coûte environ 0,04 \$ en crédits OpenAI.
Maintenant que vous disposez du programme optimisé (c’est-à-dire de la stratégie de prompting optimisée), évaluez-le de nouveau sur l’ensemble de validation et comparez-le au programme DSPy de référence.
```python lines theme={"system"}
@weave.op()
def predict_optimized(question: str) -> dict:
return optimized_module(question=question)
evaluation = weave.Evaluation(
name="optimized_causal_reasoning_module",
dataset=validation_dataset,
scorers=[weave_evaluation_scorer],
)
await evaluation.evaluate(predict_optimized)
```
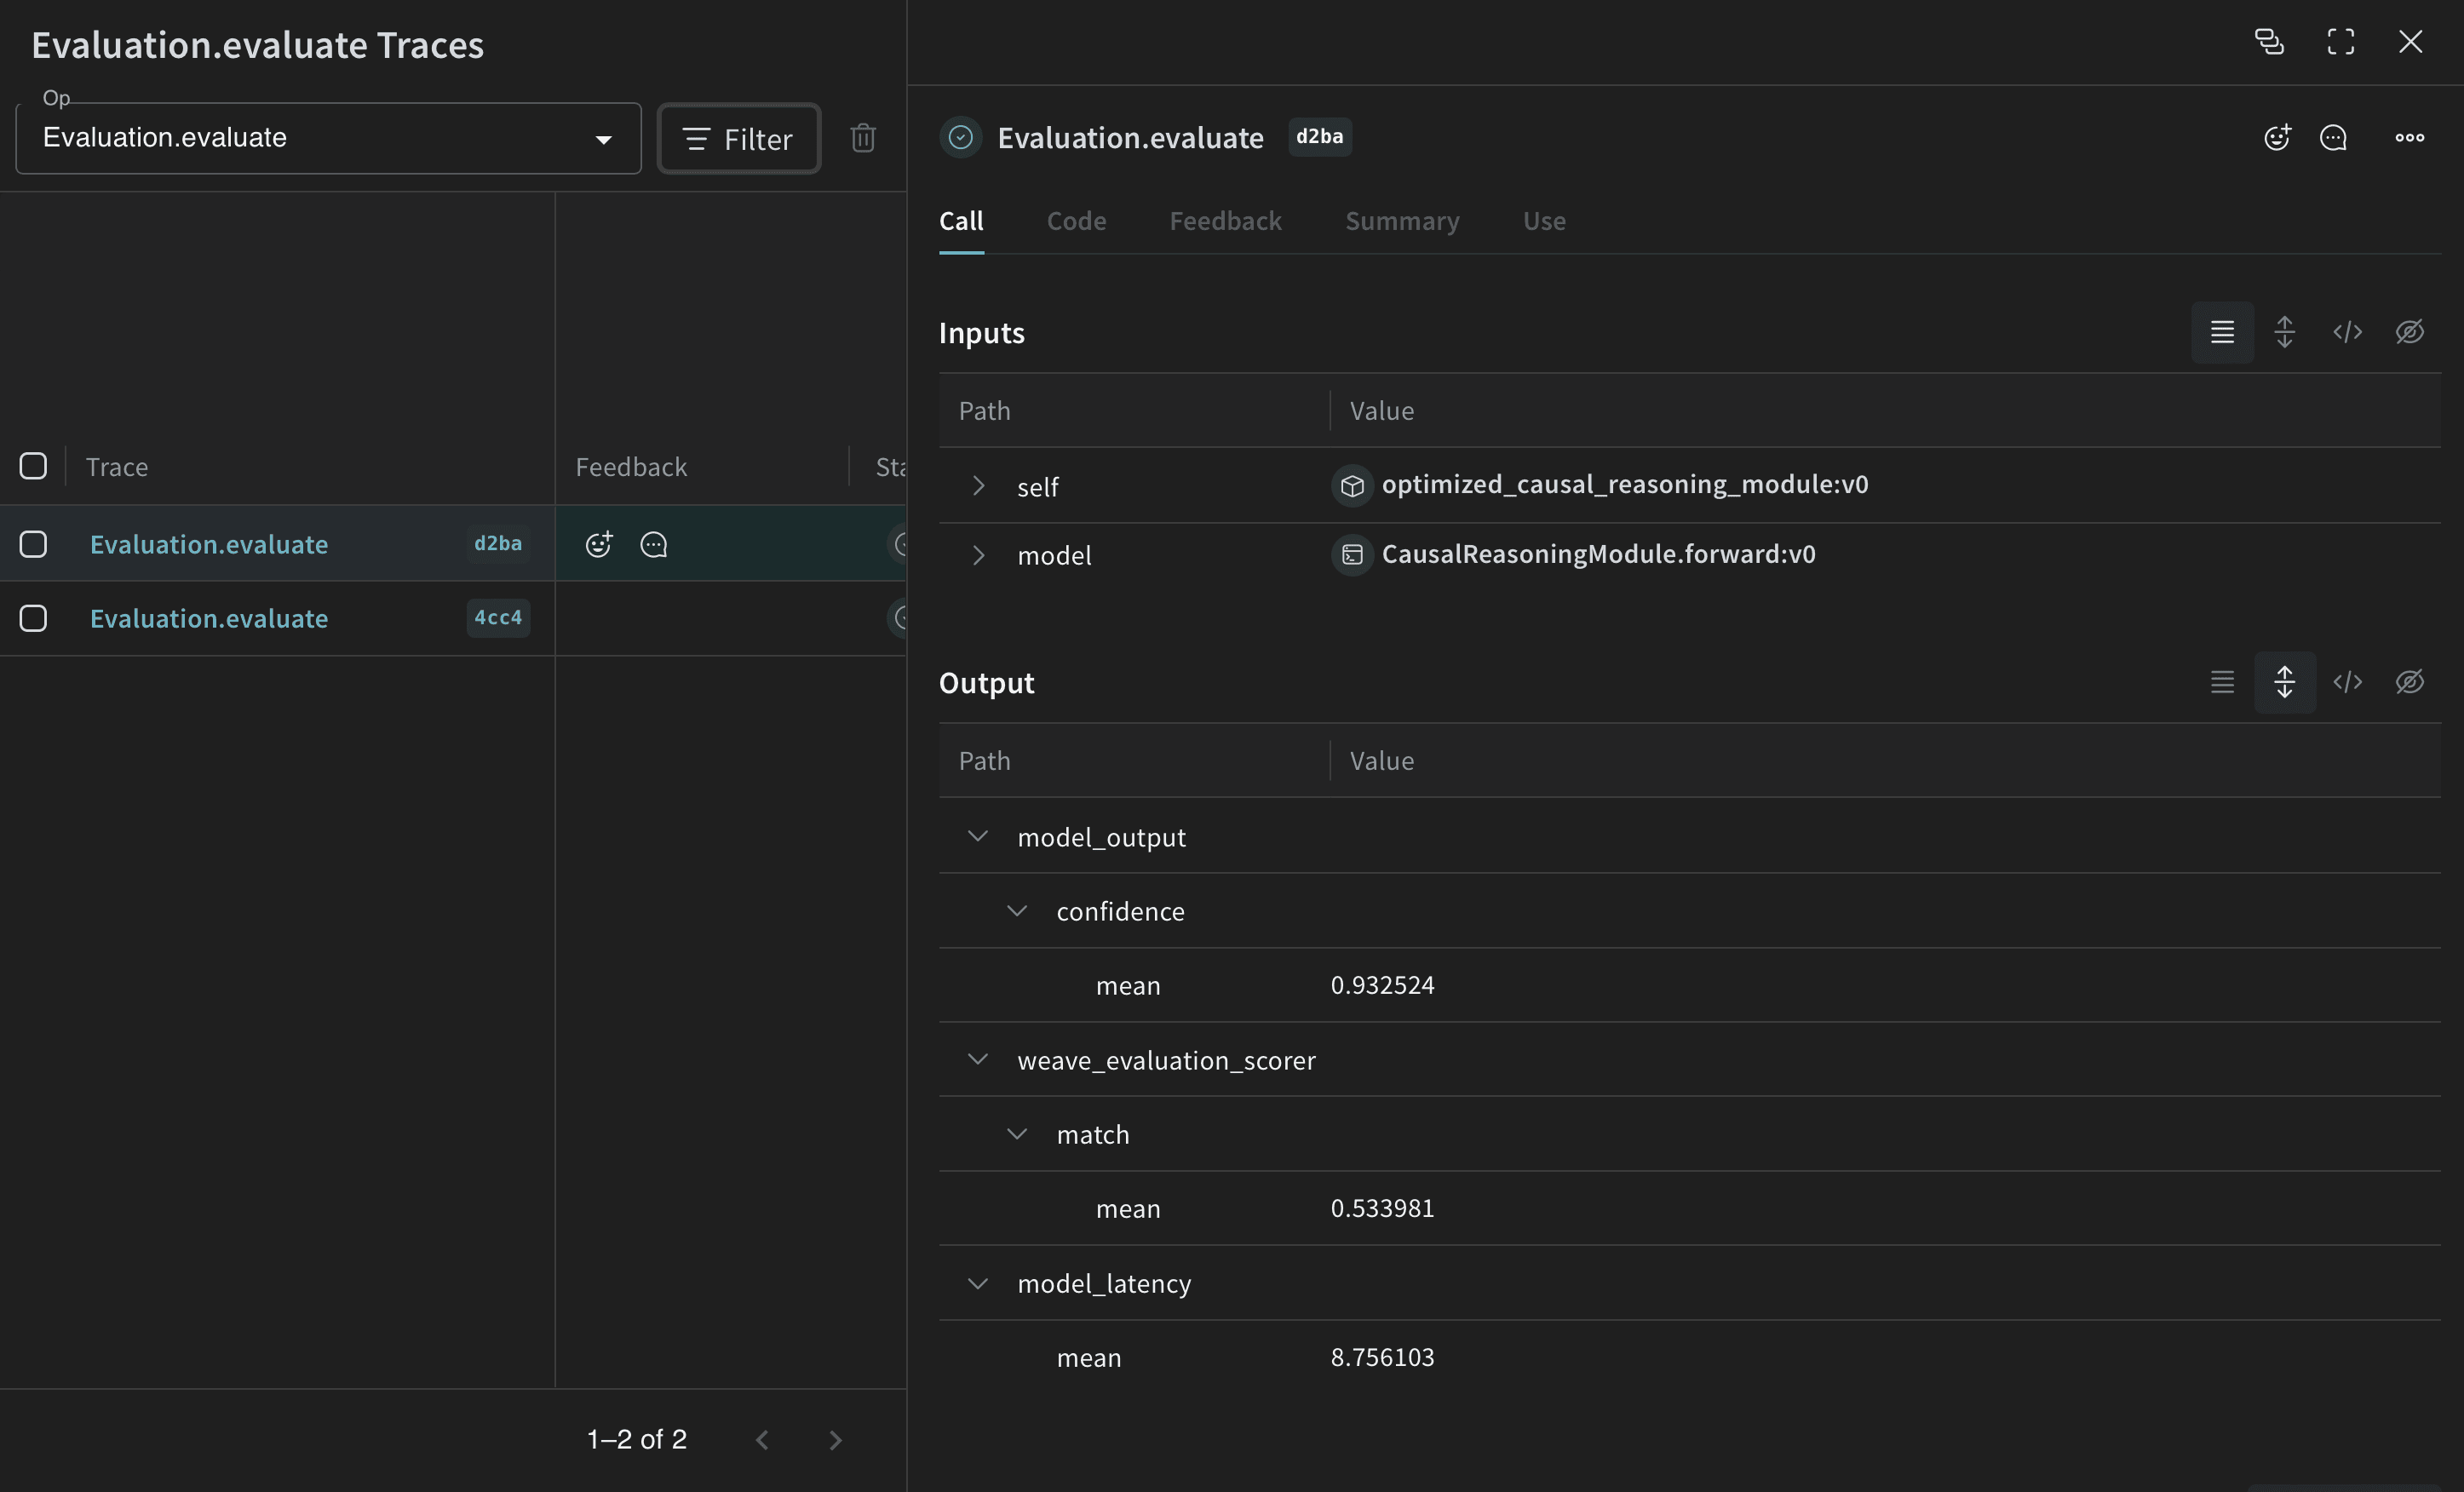 En comparant l’évaluation du programme de référence à celle du programme optimisé, on constate que ce dernier répond avec une meilleure précision aux questions de raisonnement causal.
Conclusion
Dans ce tutoriel, vous avez appris à utiliser DSPy pour l’optimisation des prompts, en association avec Weave pour le suivi et l’évaluation, afin de comparer le programme d’origine et le programme optimisé.