> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Codegen
> Créez et évaluez des pipelines de génération de code avec W&B Weave pour tracer les prompts, les sorties et les métriques de qualité.
Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens suivants :
* [Ouvrir dans Google Colab](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/codegen.ipynb)
* [Voir la source sur GitHub](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/codegen.ipynb)
Générer du code de qualité, correctement structuré, documenté et testé, n’a rien de simple. Ce guide s’adresse aux développeurs qui souhaitent créer un flux de travail de génération de code reposant sur un LLM et en mesurer la qualité de manière systématique. Ce notebook montre comment créer un pipeline de génération de code qui produit des fonctions Python, évaluées à l’aide de la suite de tests HumanEval. Le pipeline s’appuie sur Weave pour le suivi et la comparaison des évaluations, et sur les modèles GPT d’OpenAI pour générer du code avec des sorties structurées.
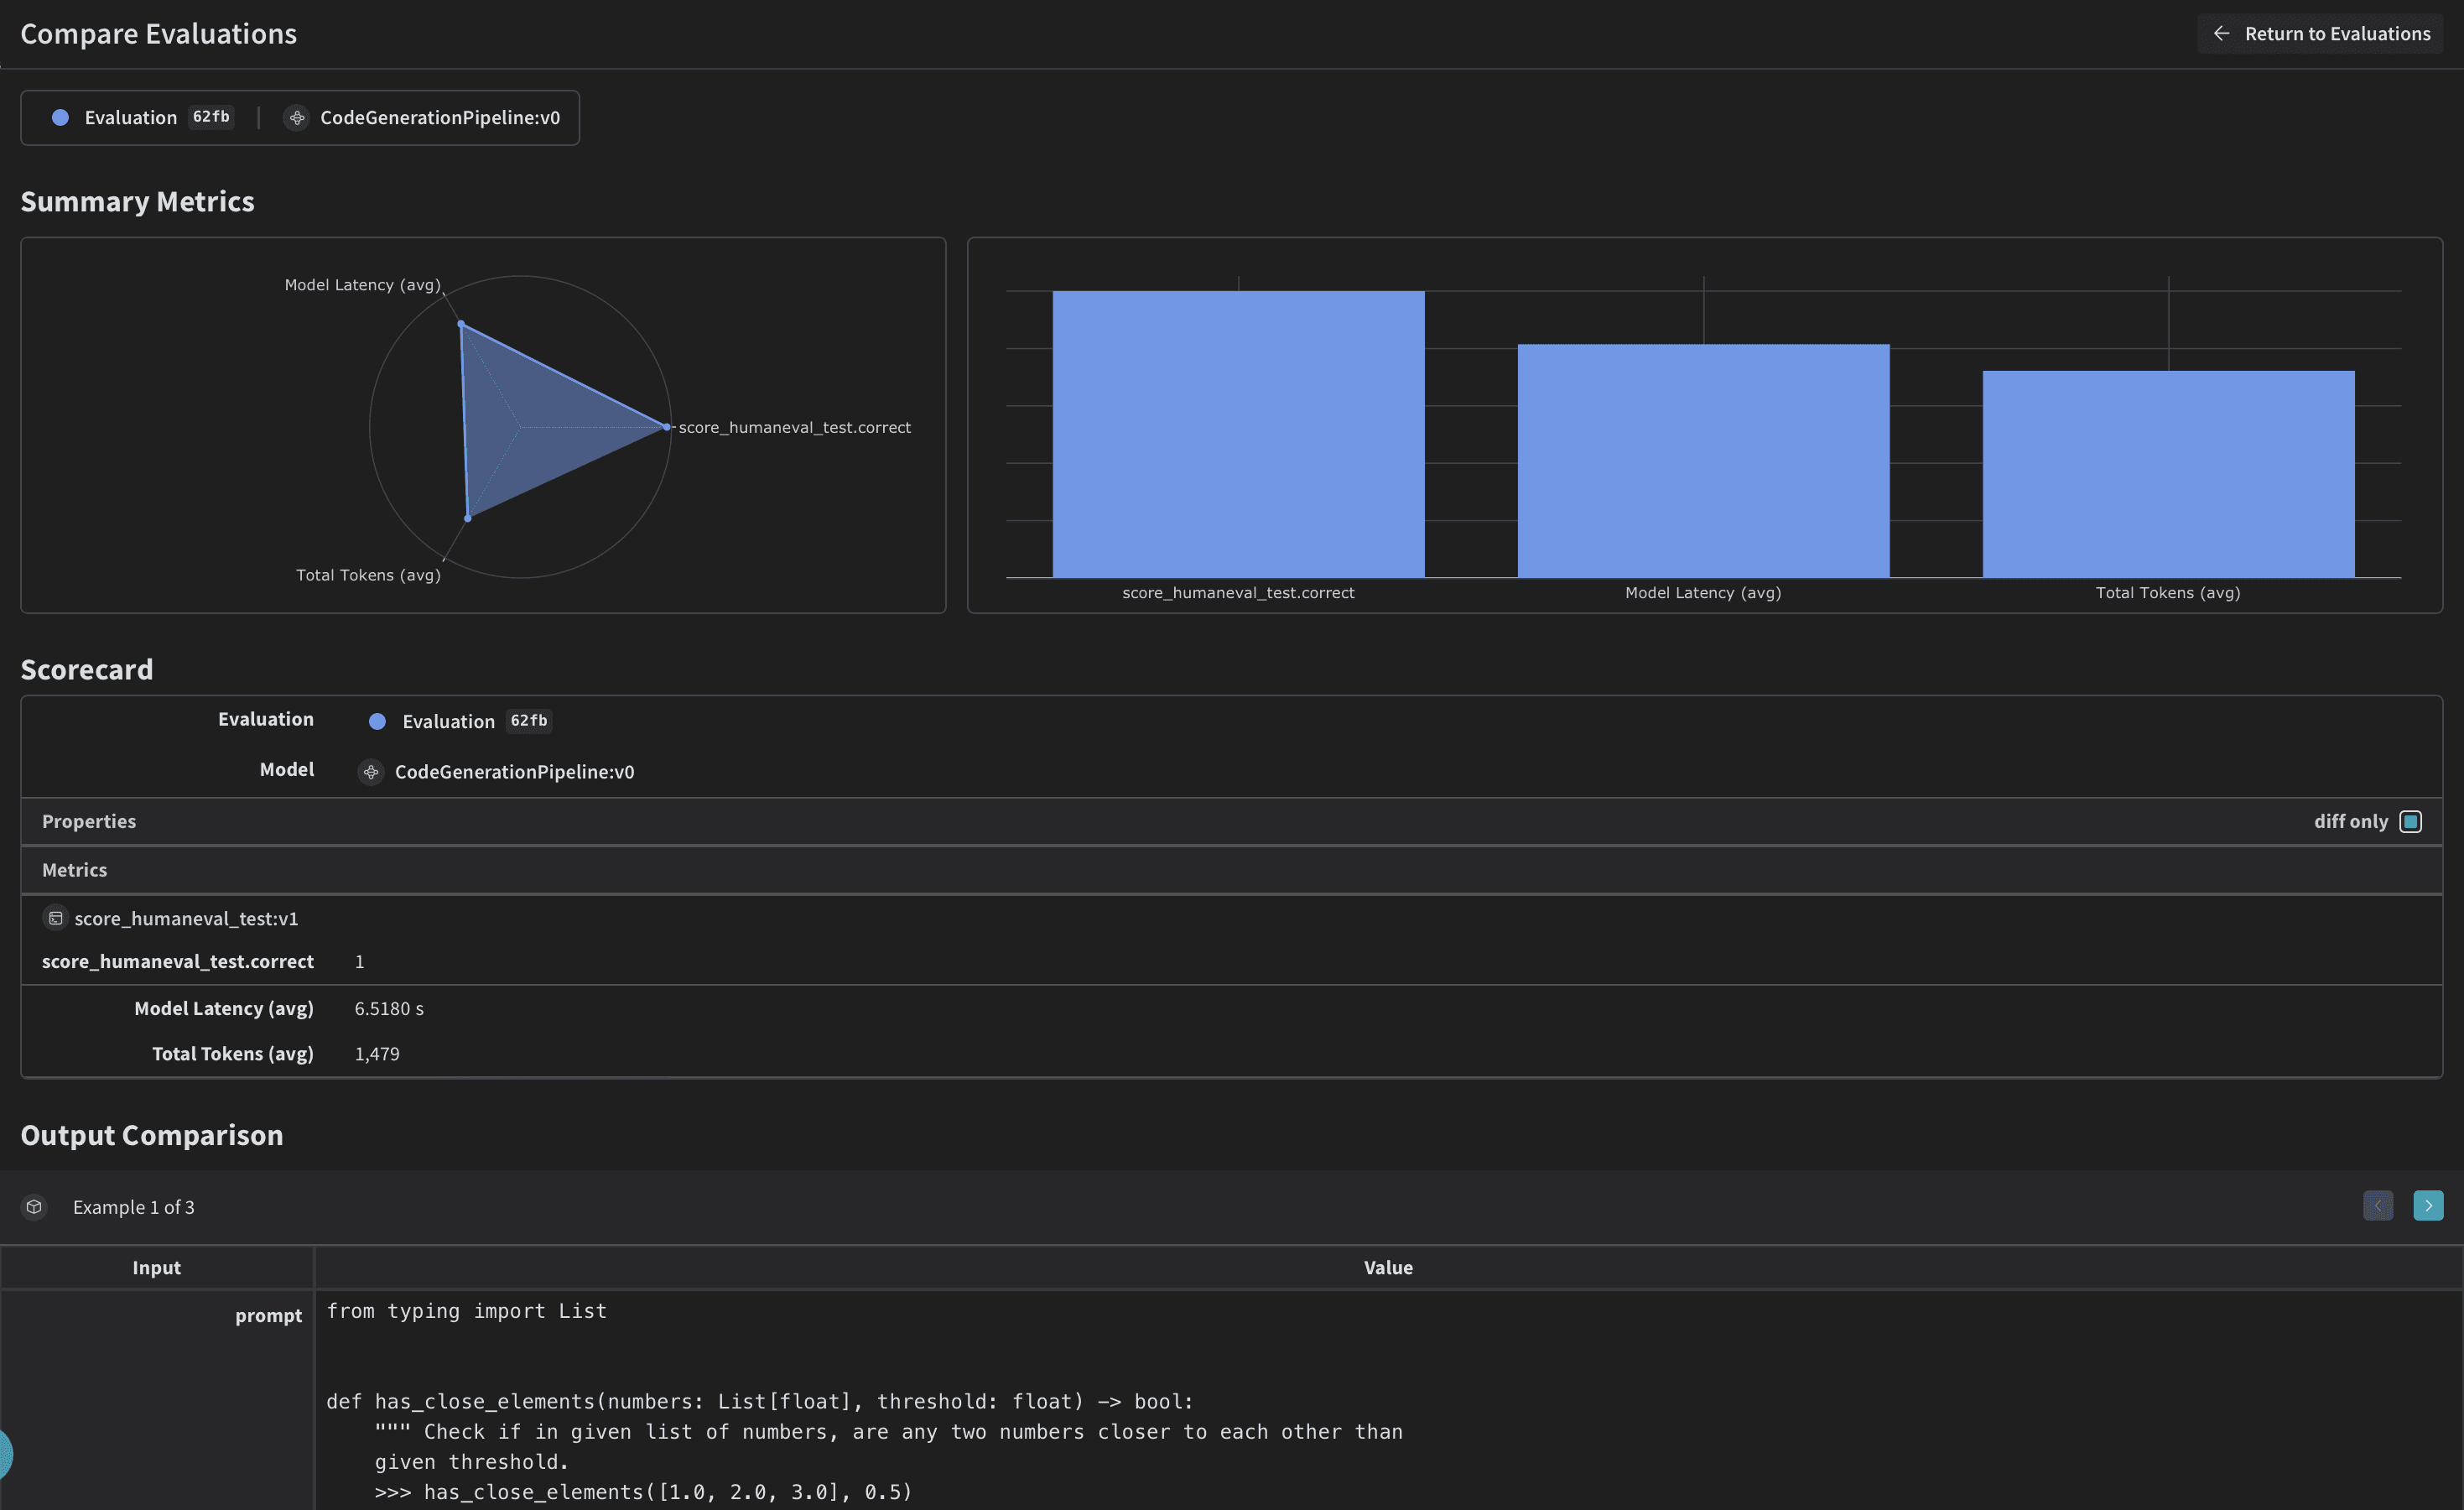
Pourquoi utiliser Weave
Ce tutoriel utilise Weave pour mettre en œuvre et évaluer un pipeline de génération de code. Vous apprendrez à :
* **Suivre votre pipeline LLM** : journalisez les entrées, les sorties et les étapes intermédiaires de votre processus de génération de code.
* **Évaluer les sorties du LLM** : créez et comparez des évaluations du code généré à l’aide d’outils de débogage et de visualisations.
Configurer l’environnement
Configurez votre environnement et importez les bibliothèques nécessaires. Ces dépendances fournissent les outils de mise en forme, le chargeur de dataset ainsi que les clients OpenAI et Weave utilisés tout au long du pipeline.
```python lines theme={"system"}
!pip install -qU autopep8 autoflake weave isort openai set-env-colab-kaggle-dotenv datasets
python
%%capture
# Contournement temporaire d’un bug dans openai :
# TypeError: Client.__init__() got an unexpected keyword argument 'proxies'
# Voir https://community.openai.com/t/error-with-openai-1-56-0-client-init-got-an-unexpected-keyword-argument-proxies/1040332/15
!pip install "httpx<0.28"
python
import ast
import os
import re
import subprocess
import tempfile
import traceback
import autopep8
import isort
from autoflake import fix_code
from datasets import load_dataset
from openai import OpenAI
from pydantic import BaseModel
from set_env import set_env
import weave
from weave import Dataset, Evaluation
set_env("WANDB_API_KEY")
set_env("OPENAI_API_KEY")
python
WEAVE_PROJECT = "codegen-cookbook-example"
weave.init(WEAVE_PROJECT)
python
client = OpenAI()
python
human_eval = load_dataset("openai_humaneval")
selected_examples = human_eval["test"][:3]
```
Weave suit automatiquement les appels d’API OpenAI, y compris leurs entrées, leurs sorties et leurs métadonnées. Vous n'avez besoin d’ajouter aucun code de journalisation supplémentaire pour vos interactions avec OpenAI : Weave s’en charge en arrière-plan.
Sorties structurées et modèles Pydantic
Ce pipeline de génération de code utilise le [mode de sorties structurées](https://platform.openai.com/docs/guides/structured-outputs) d'OpenAI ainsi que des modèles Pydantic pour obtenir du modèle de langage des réponses cohérentes et bien formatées. Cette approche présente plusieurs avantages :
* **Sécurité des types** : définir des modèles Pydantic pour les sorties attendues permet d'appliquer une structure stricte au code généré, aux runners de programmes et aux tests unitaires.
* **Analyse simplifiée** : le mode de sorties structurées convertit directement la réponse du modèle en instances des modèles Pydantic prédéfinis, ce qui limite le recours à des post-traitements complexes.
* **Fiabilité accrue** : en spécifiant précisément le format attendu, vous réduisez le risque que le modèle de langage produise des sorties inattendues ou mal formées.
L'exemple suivant définit des modèles Pydantic et les utilise avec les sorties structurées d'OpenAI :
```python lines theme={"system"}
class GeneratedCode(BaseModel):
function_signature: str
function_args_with_docstring_within_triple_quotes: str
code_logic: str
class FormattedGeneratedCode(BaseModel):
full_code: str
```
Pour obtenir du code propre et cohérent, implémentez une classe `CodeFormatter` à l’aide d’opérations Weave. Ce formateur applique des règles de linting et de style au code généré, au runner du programme et aux tests unitaires.
```python lines theme={"system"}
class CodeFormatter(BaseModel):
@weave.op()
def lint_code(self, code: str) -> str:
# Remplacer les sauts de ligne échappés par de vrais sauts de ligne
code = code.replace("\\n", "\n")
# Supprimer les imports et variables inutilisés
code = fix_code(
code, remove_all_unused_imports=True, remove_unused_variables=True
)
# Trier les imports
code = isort.code(code)
# Appliquer le formatage PEP 8
code = autopep8.fix_code(code, options={"aggressive": 2})
return code
@weave.op()
def add_imports(self, code: str) -> str:
tree = ast.parse(code)
from_imports = {}
global_names = set()
for node in ast.walk(tree):
if isinstance(node, ast.Name) and node.id not in dir(__builtins__):
global_names.add(node.id)
# N’ajouter que les imports typing réellement utilisés
typing_imports = global_names.intersection(
{"List", "Dict", "Tuple", "Set", "Optional", "Union"}
)
if typing_imports:
from_imports["typing"] = typing_imports
# Exclure les noms définis dans la fonction
function_def = next(
node for node in tree.body if isinstance(node, ast.FunctionDef)
)
local_names = {arg.arg for arg in function_def.args.args}
local_names.update(
node.id
for node in ast.walk(function_def)
if isinstance(node, ast.Name) and isinstance(node.ctx, ast.Store)
)
global_names -= local_names
global_names -= {"sorted"} # Exclure les fonctions intégrées
# Générer les instructions d’import
import_statements = []
for module, names in from_imports.items():
names_str = ", ".join(sorted(names))
import_statements.append(f"from {module} import {names_str}")
return (
"\n".join(import_statements) + ("\n\n" if import_statements else "") + code
)
@weave.op()
def format_generated_code(
self, generated_code: GeneratedCode
) -> FormattedGeneratedCode:
# Assembler les différentes parties du code
full_code = f"{generated_code.function_signature}\n{generated_code.function_args_with_docstring_within_triple_quotes}\n{generated_code.code_logic}"
# Garantir une indentation correcte
lines = full_code.split("\n")
indented_lines = []
for i, line in enumerate(lines):
if i == 0: # Signature de la fonction
indented_lines.append(line)
elif i == 1: # Arguments de la fonction (docstring)
indented_lines.append(" " + line)
else: # Corps de la fonction
indented_lines.append(" " + line)
full_code = "\n".join(indented_lines)
# Passer le code au linter
full_code = self.lint_code(full_code)
# Ajouter les imports
cleaned_code = self.add_imports(full_code)
return FormattedGeneratedCode(full_code=cleaned_code)
```
Cette classe `CodeFormatter` fournit plusieurs opérations Weave permettant de nettoyer et de formater le code généré :
* Remplacement des sauts de ligne échappés par de véritables sauts de ligne.
* Suppression des imports et des variables inutilisés.
* Tri des imports.
* Application du formatage PEP 8.
* Ajout des imports manquants.
Définir le `CodeGenerationPipeline`
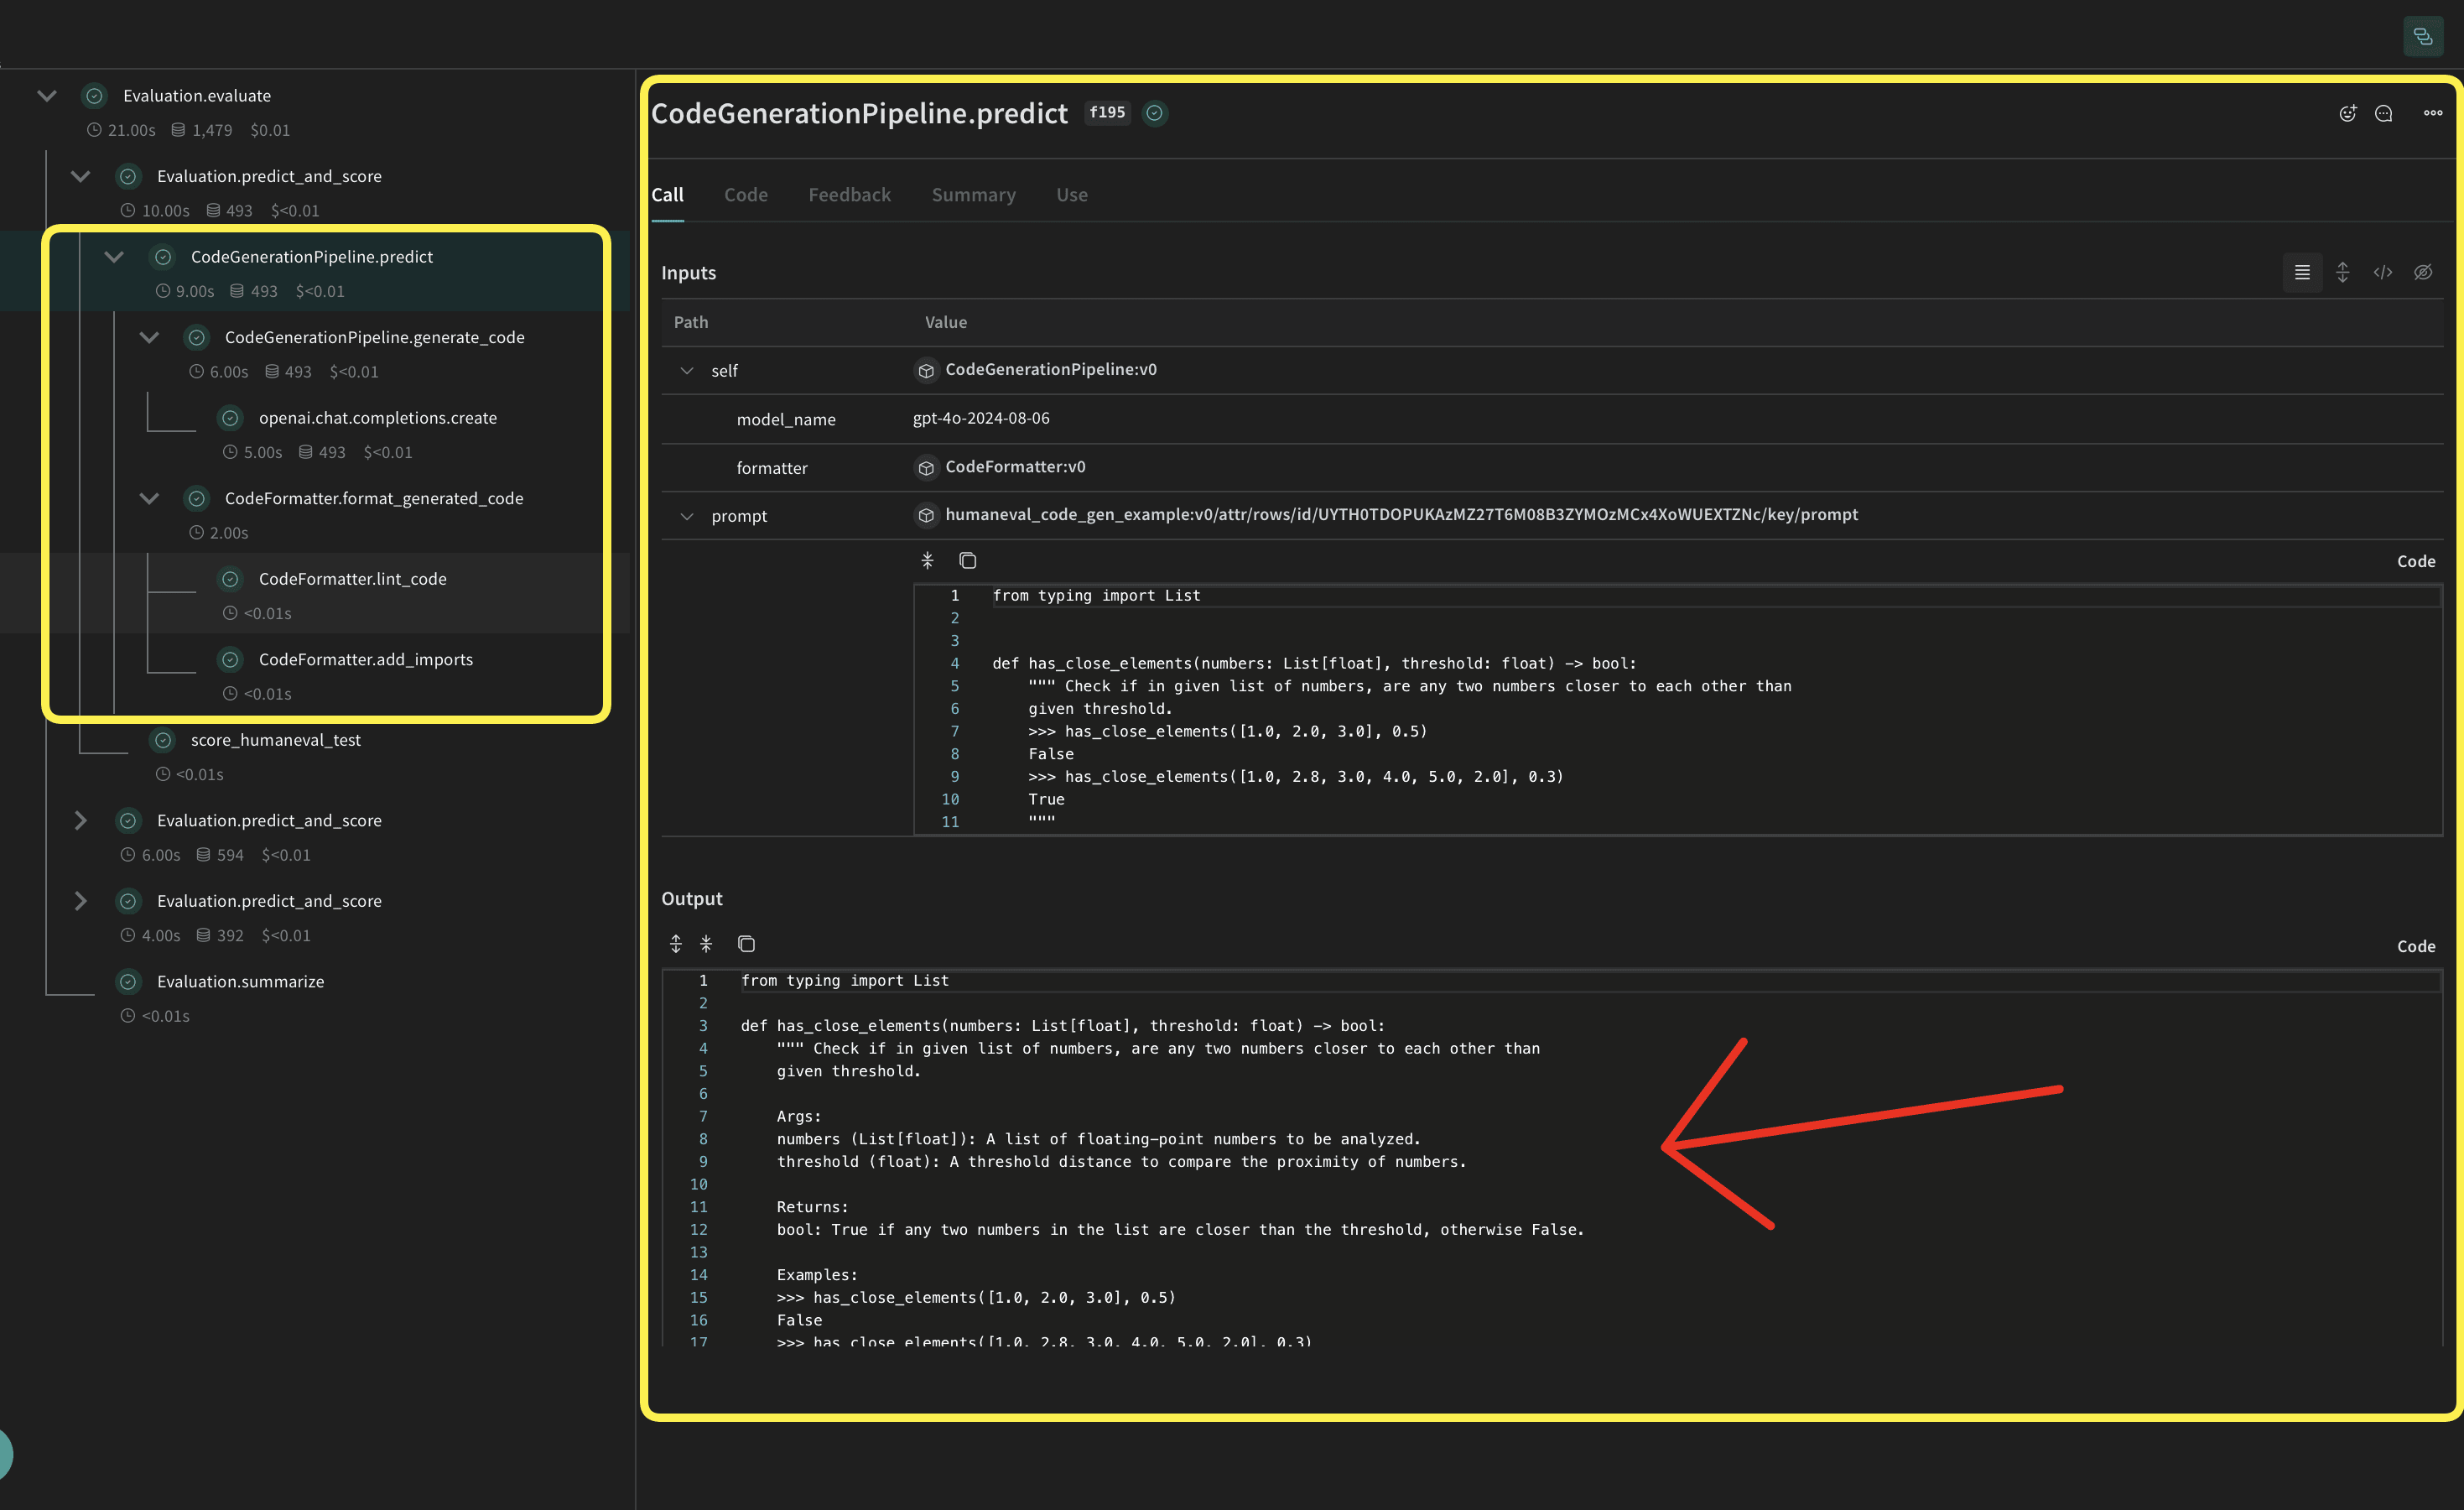 Une fois le formateur en place, l’étape suivante consiste à implémenter la logique principale de génération de code, qui relie le prompt, l’appel LLM et le formateur.
Cet exemple utilise un `weave.Model` afin que le modèle soit automatiquement versionné à chaque modification. Le `model_name` est défini comme attribut : vous pouvez ainsi l’expérimenter, puis examiner ses différences et le comparer dans Weave. Les appels de fonctions sont suivis avec `@weave.op` : leurs entrées et leurs sorties sont ainsi journalisées, ce qui facilite le suivi des erreurs et le débogage.
```python lines theme={"system"}
class CodeGenerationPipeline(weave.Model):
model_name: str
formatter: CodeFormatter
def __init__(
self, model_name: str = "gpt-4o", formatter: CodeFormatter | None = None
):
if formatter is None:
formatter = CodeFormatter()
super().__init__(model_name=model_name, formatter=formatter)
self.model_name = model_name
self.formatter = formatter
@weave.op()
async def predict(self, prompt: str):
generated_code = self.generate_code(prompt)
formatted_generated_code = self.formatter.format_generated_code(generated_code)
return formatted_generated_code.full_code
@weave.op()
def generate_code(self, prompt: str) -> GeneratedCode:
completion = client.beta.chat.completions.parse(
model=self.model_name,
messages=[
{
"role": "system",
"content": "You are an expert Python code generator.",
},
{"role": "user", "content": prompt},
],
response_format=GeneratedCode,
)
message = completion.choices[0].message
if message.parsed:
return message.parsed
else:
raise ValueError(message.refusal)
```
Cette classe `CodeGenerationPipeline` encapsule la logique de génération de code sous la forme d'un Weave Model, ce qui présente plusieurs avantages :
* Suivi automatique des expériences : Weave capture les entrées, les sorties et les paramètres de chaque run du modèle.
* Gestion des versions : toute modification des attributs ou du code du modèle est automatiquement versionnée, ce qui constitue un historique de l'évolution de votre pipeline de génération de code au fil du temps.
* Reproductibilité : grâce à la gestion des versions et au suivi, vous pouvez reproduire n'importe quel résultat ou configuration antérieurs de votre pipeline de génération de code.
* Gestion des hyperparamètres : les attributs du modèle (comme `model_name`) sont définis et suivis d'un run à l'autre, ce qui facilite l'expérimentation.
* Intégration à l'écosystème Weave : `weave.Model` relie votre pipeline aux autres outils Weave, comme les évaluations et les fonctionnalités de déploiement.
Implémenter des métriques d’évaluation
Pour évaluer la qualité du code généré, implémentez des métriques d’évaluation à l’aide d’une sous-classe de `weave.Scorer`. Celle-ci exécute `score` sur chaque `model_output` du dataset. `model_output` correspond à la sortie de la fonction `predict` de `weave.Model`. `prompt` provient du dataset `human-eval`.
```python lines theme={"system"}
CODE_TEMPLATE = """
{model_output}
{test}
if __name__ == "__main__":
check({entry_point})
"""
python
@weave.op()
async def score_humaneval_test(test: str, entry_point: str, output: str):
generated_code = output
# Extraire les cas de test de la chaîne de test
test_cases = re.findall(r"assert.*", test)
test_cases_str = "\n ".join(test_cases)
# Générer le code source complet
full_code = CODE_TEMPLATE.format(
model_output=generated_code,
test=test,
test_cases=test_cases_str,
entry_point=entry_point,
)
# Créer un fichier temporaire pour stocker le code
with tempfile.NamedTemporaryFile(delete=False, suffix=".py") as tmp_file:
# Écrire le code généré dans le fichier temporaire
tmp_file.write(full_code.encode())
tmp_file_path = tmp_file.name
try:
# Exécuter le fichier Python temporaire dans un sous-processus, avec un délai d’expiration
result = subprocess.run(
["python", tmp_file_path],
capture_output=True,
text=True,
timeout=10, # Délai d’expiration de 10 secondes
)
print(result)
if result.returncode == 0:
return {"correct": True}
else:
return {"correct": False, "error": result.stderr, "output": result.stdout}
except subprocess.TimeoutExpired:
return {"correct": False, "error": "TimeoutExpired"}
except Exception as e:
return {"correct": False, "error": traceback.format_exc()}
finally:
# Veiller à supprimer le fichier temporaire après l’exécution
os.remove(tmp_file_path)
```
Ces fonctions d’évaluation exécutent le code généré et renvoient une valeur booléenne indiquant si le code a réussi le test fourni par le dataset.
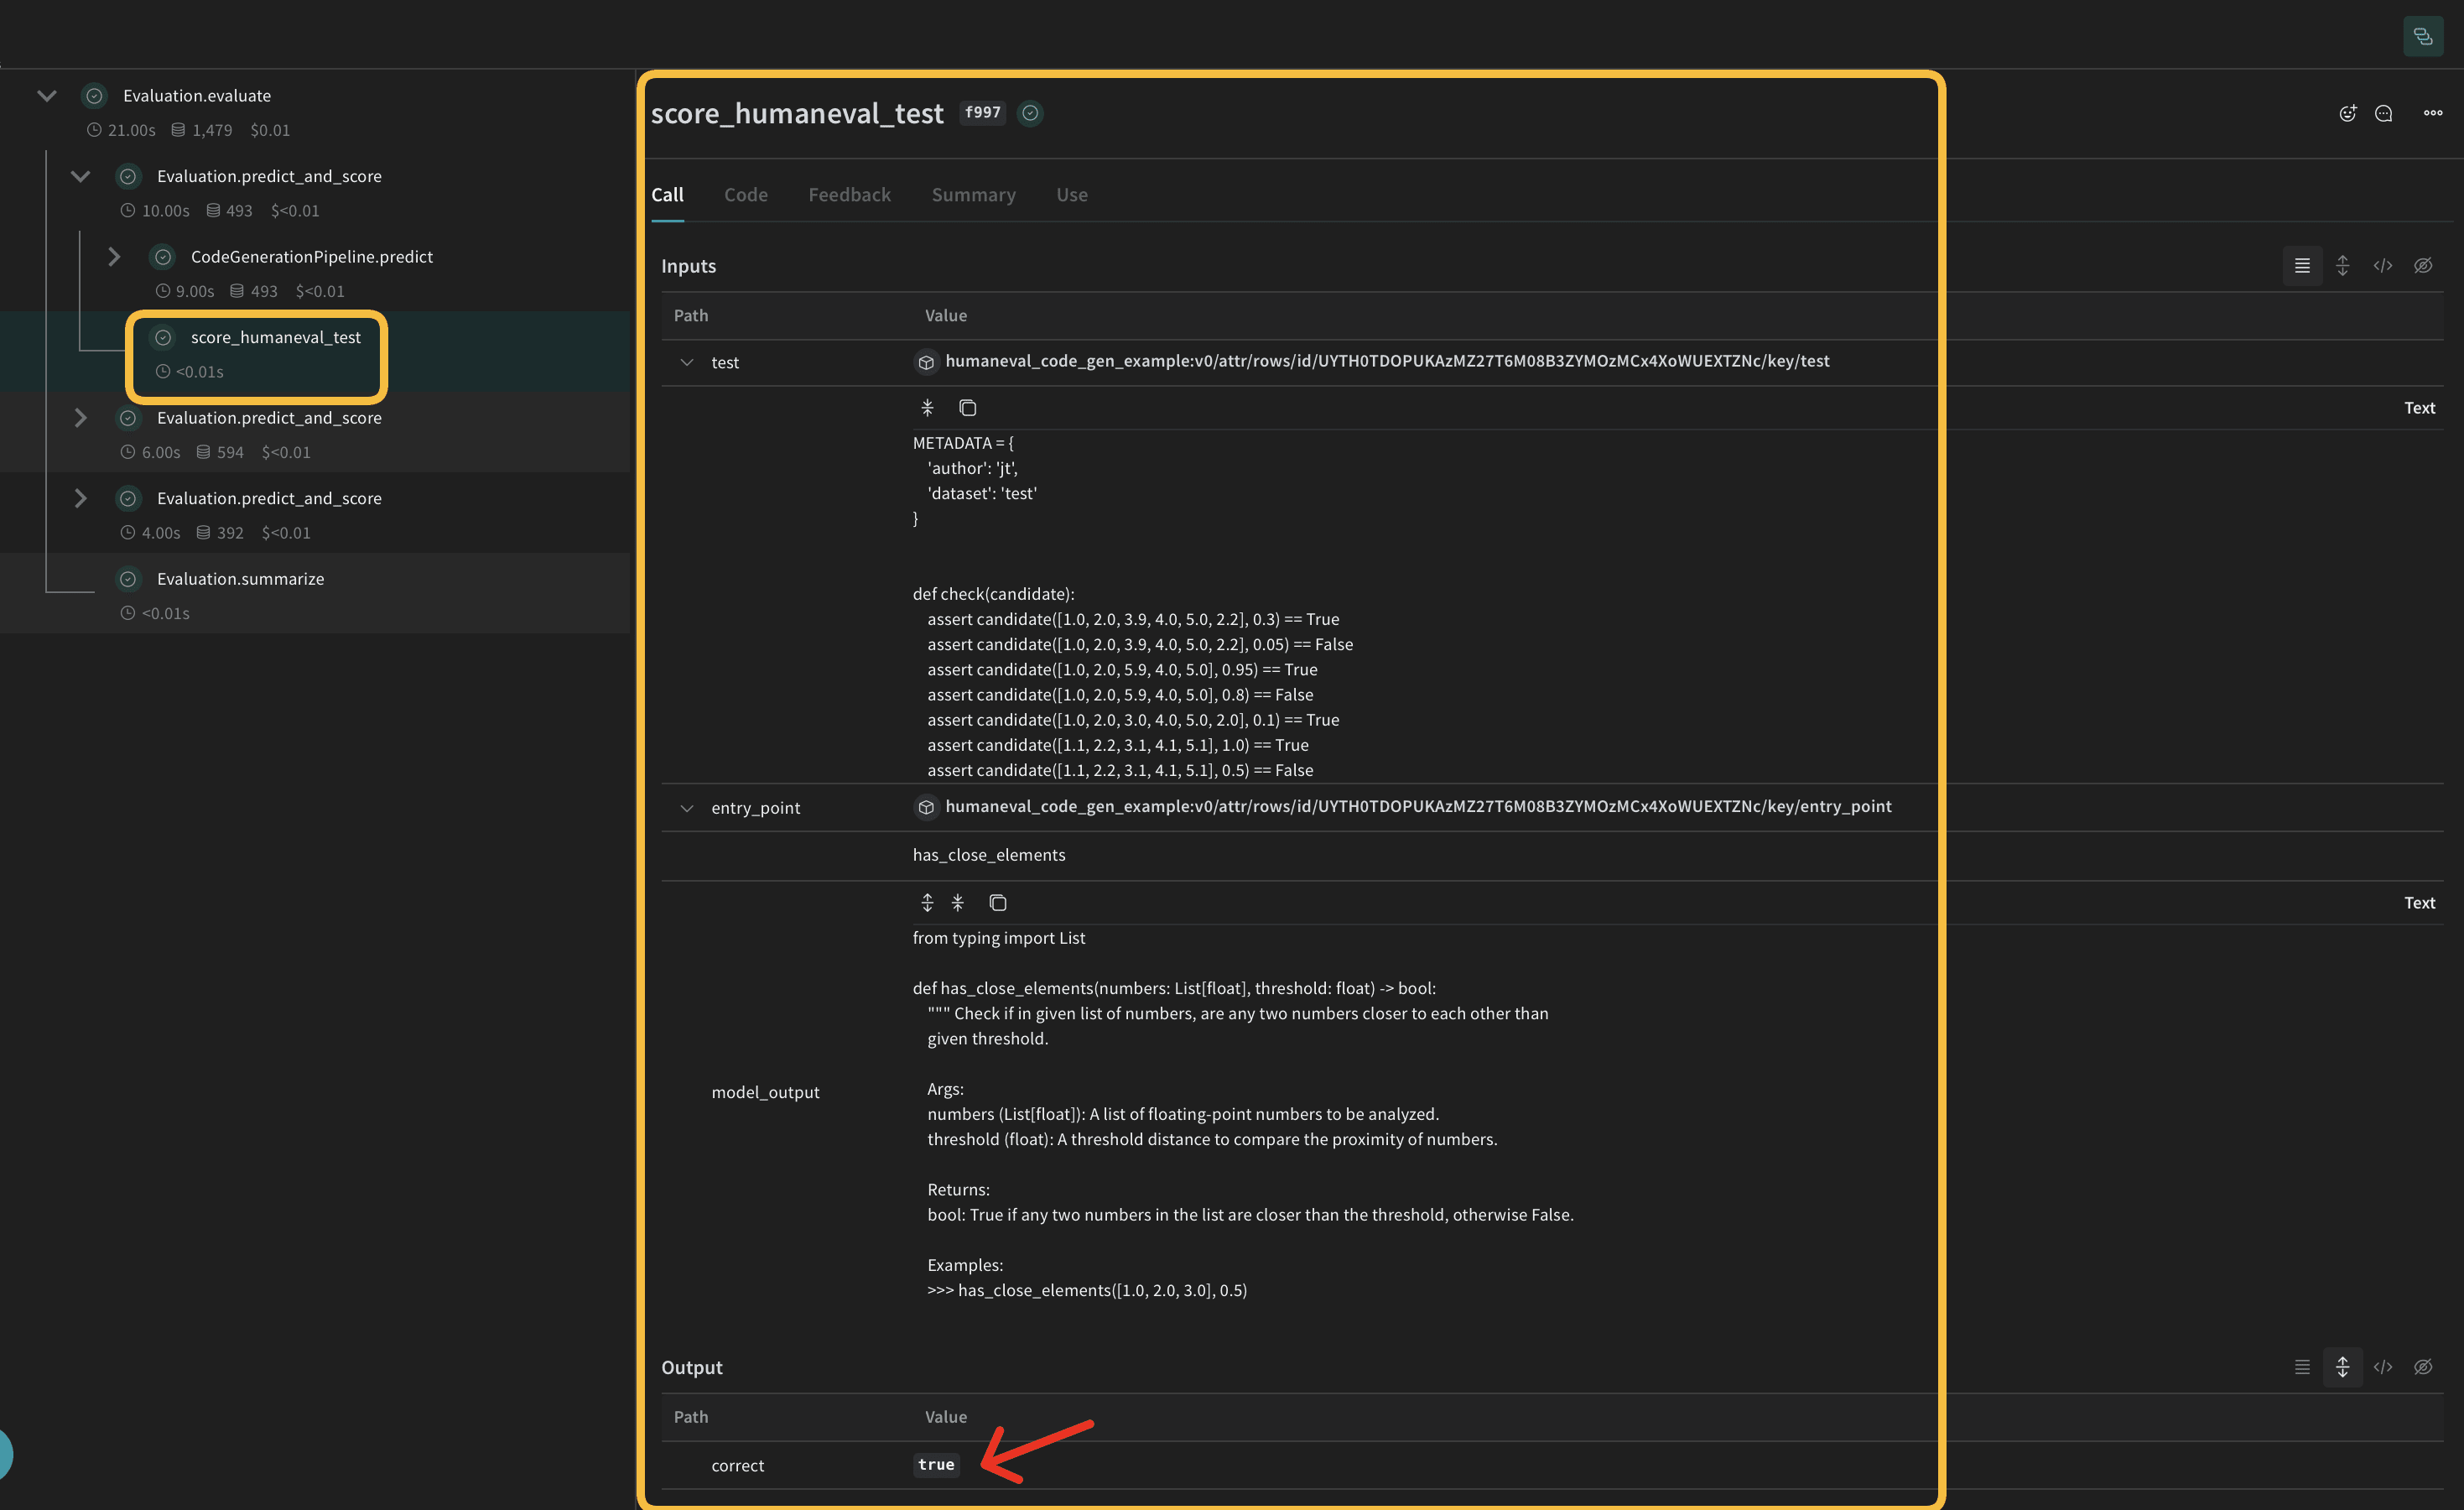
Créer un dataset Weave et exécuter l’évaluation
Une fois le pipeline et le scorer définis, la dernière étape consiste à constituer le dataset d’évaluation et à exécuter l’évaluation de bout en bout. Pour évaluer le pipeline, créez un dataset Weave et lancez une évaluation :
```python lines theme={"system"}
formatted_selected_examples = [
{
"task_id": task_id,
"prompt": prompt,
"canonical_solution": solution,
"test": test,
"entry_point": entry_point,
}
for task_id, prompt, solution, test, entry_point in zip(
selected_examples["task_id"],
selected_examples["prompt"],
selected_examples["canonical_solution"],
selected_examples["test"],
selected_examples["entry_point"],
)
]
python
prompt_dataset = Dataset(
name="humaneval_code_gen_example",
rows=[
{
"prompt": example["prompt"],
"test": example["test"],
"entry_point": example["entry_point"],
}
for example in formatted_selected_examples
],
)
weave.publish(prompt_dataset)
python
EVAL_RUN = True
python
for model_name in ["gpt-4o-2024-08-06"]:
pipeline = CodeGenerationPipeline(model_name=model_name)
if not EVAL_RUN:
dataset = prompt_dataset.rows[2]
result = await pipeline.predict(dataset["prompt"])
score_result = await score_humaneval_test(
dataset["test"], dataset["entry_point"], result["generated_code"].full_code
)
else:
evaluation = Evaluation(
name="minimal_code_gen_evaluation",
dataset=prompt_dataset,
scorers=[score_humaneval_test],
)
results = await evaluation.evaluate(pipeline)
```
Ce code crée un dataset à partir des exemples de prompts, définit le scorer de test HumanEval et lance une évaluation du pipeline de génération de code. Une fois l’évaluation terminée, vous pouvez examiner les résultats dans l’interface de Weights & Biases et les comparer d’un run à l’autre.
Conclusion
Cet exemple montre comment implémenter un pipeline de génération de code avec Weave et les modèles de langage d’OpenAI. Vous avez appris à :
* Créer des opérations Weave pour chaque étape du processus de génération de code.
* Encapsuler le pipeline dans un Weave Model pour simplifier le suivi et l’évaluation.
* Implémenter des métriques d’évaluation personnalisées à l’aide d’opérations Weave.
* Créer un dataset et lancer une évaluation du pipeline.
Weave suit les entrées, les sorties et les étapes intermédiaires tout au long du processus de génération de code, ce qui facilite le débogage, l’optimisation et l’évaluation de votre application LLM.
Pour en savoir plus sur Weave et ses fonctionnalités, consultez la [documentation Weave](/fr/products/wandb/weave). Vous pouvez faire évoluer cet exemple pour traiter des datasets plus volumineux, implémenter des métriques d’évaluation plus sophistiquées ou l’intégrer à d’autres flux de travail LLM.