> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Audio avec Weave
> Suivez et évaluez les données audio de vos applications LLM grâce aux fonctionnalités de journalisation et de traçage audio de W&B Weave.
Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens suivants :
* [Ouvrir dans Google Colab](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/audio_with_weave.ipynb)
* [Voir la source sur GitHub](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/audio_with_weave.ipynb)
Ce notebook vous montre comment utiliser Weave pour journaliser et tracer l’audio généré par les API audio d’OpenAI, afin d’inspecter les prompts, les sorties audio et les transcriptions avec les autres données de votre application LLM. Il s’adresse aux développeurs qui utilisent déjà les modèles audio d’OpenAI et qui souhaitent gagner en observabilité sur leurs traces audio.
Le notebook utilise d’abord l’API de complétions de chat d’OpenAI avec GPT 4o Audio Preview pour générer des réponses audio à partir de prompts textuels, puis les suivre dans Weave.
 Pour le cas d’usage avancé, le notebook utilise l’API Realtime d’OpenAI pour diffuser de l’audio en temps réel. Vous pourrez ainsi voir comment Weave capture les deux interlocuteurs d’une conversation en direct. Cliquez sur la miniature suivante pour voir la [démonstration vidéo](https://www.youtube.com/watch?v=lnnd73xDElw).
[](https://www.youtube.com/watch?v=lnnd73xDElw "Démonstration audio Realtime de Weave")
Configuration
Cette section permet d’installer les paquets Python, de charger les identifiants d’authentification de l’API et d’importer les bibliothèques nécessaires à l’exemple de complétions de chat.
Commencez par installer les dépendances OpenAI (`openai`) et Weave (`weave`), ainsi que `set-env`, la dépendance de gestion des clés API.
```python lines theme={"system"}
%%capture
!pip install openai
!pip install weave
!pip install set-env-colab-kaggle-dotenv -q # pour les variables d'environnement
python
%%capture
# Contournement temporaire d'un bug dans openai :
# TypeError: Client.__init__() got an unexpected keyword argument 'proxies'
# Voir https://community.openai.com/t/error-with-openai-1-56-0-client-init-got-an-unexpected-keyword-argument-proxies/1040332/15
!pip install "httpx<0.28"
```
Chargez ensuite les clés API requises pour OpenAI et Weave. Cet exemple utilise `set_env`, qui est compatible avec le gestionnaire de clés secrètes de Google Colab et remplace `google.colab.userdata`, propre à Colab. Voir les [instructions d'utilisation de `set-env-colab-kaggle-dotenv`](https://pypi.org/project/set-env-colab-kaggle-dotenv/).
```python lines theme={"system"}
# Définir les variables d’environnement.
from set_env import set_env
_ = set_env("OPENAI_API_KEY")
_ = set_env("WANDB_API_KEY")
```
Enfin, importez les bibliothèques requises.
```python lines theme={"system"}
import base64
import os
import time
import wave
import numpy as np
from IPython.display import display
from openai import OpenAI
import weave
```
Exemple de streaming et de stockage audio
Une fois les dépendances installées et les identifiants d’authentification chargés, vous pouvez configurer un appel au point de terminaison de complétions d'OpenAI en activant la modalité audio. Commencez par créer le client OpenAI et initialiser un projet Weave afin que Weave journalise les appels suivants dans votre workspace.
```python lines theme={"system"}
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
weave.init("openai-audio-chat")
```
Définissez maintenant la requête de complétion OpenAI et ajoutez le décorateur Weave (op). Le décorateur `@weave.op()` indique à Weave de capturer les entrées, les sorties et le fichier audio de la fonction dans une trace.
Le code suivant définit la fonction `prompt_endpoint_and_log_trace`. Cette fonction comporte trois étapes principales :
1. Créer un objet de complétion à l’aide du modèle `gpt-4o-audio-preview`, qui prend en charge les entrées et sorties textuelles et audio.
* Demander au modèle de compter lentement jusqu’à 13 en variant les accents.
* Configurer la complétion en mode `stream`.
2. Ouvrir un nouveau fichier de sortie pour recevoir les données diffusées en continu, fragment par fragment.
3. Renvoyer un descripteur de fichier ouvert pointant vers le fichier audio afin que Weave journalise les données audio dans la trace.
```python lines theme={"system"}
SAMPLE_RATE = 22050
@weave.op()
def prompt_endpoint_and_log_trace(system_prompt=None, user_prompt=None):
if not system_prompt:
system_prompt = "You're the fastest counter in the world"
if not user_prompt:
user_prompt = "Count to 13 super super slow, enunciate each number with a dramatic flair, changing up accents as you go along. British, French, German, Spanish, etc."
# Requête à l’API OpenAI avec la modalité audio
completion = client.chat.completions.create(
model="gpt-4o-audio-preview",
modalities=["text", "audio"],
audio={"voice": "fable", "format": "pcm16"},
stream=True,
messages=[
{"role": "system", "content": system_prompt},
{"role": "user", "content": user_prompt},
],
)
# Ouvrir un fichier WAV en écriture
with wave.open("./output.wav", "wb") as wav_file:
wav_file.setnchannels(1) # Mono
wav_file.setsampwidth(2) # 16-bit
wav_file.setframerate(SAMPLE_RATE) # Fréquence d’échantillonnage (à ajuster si nécessaire)
# Écrire les fragments au fur et à mesure de leur réception en streaming depuis l’API
for chunk in completion:
if (
hasattr(chunk, "choices")
and chunk.choices is not None
and len(chunk.choices) > 0
and hasattr(chunk.choices[0].delta, "audio")
and chunk.choices[0].delta.audio.get("data") is not None
):
# Décoder les données audio encodées en base64
audio_data = base64.b64decode(chunk.choices[0].delta.audio.get("data"))
# Écrire le fragment courant dans le fichier WAV
wav_file.writeframes(audio_data)
# Renvoyer le fichier à l’op Weave
return wave.open("output.wav", "rb")
```
Tests
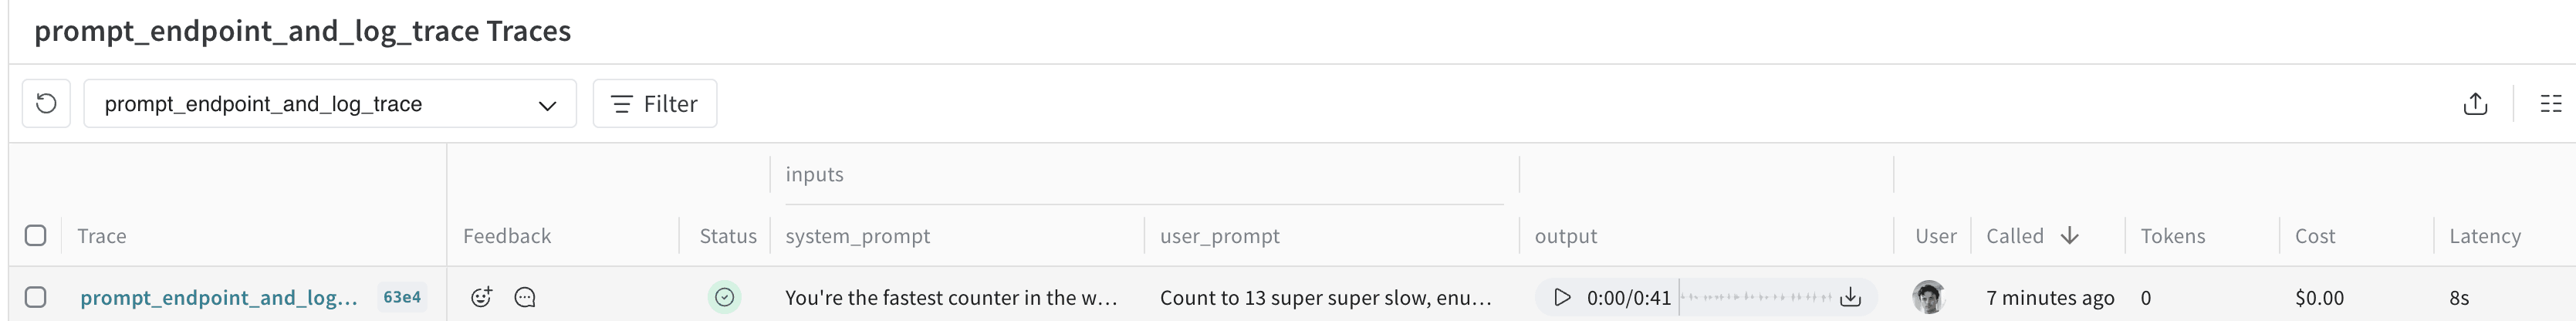
Après avoir défini la fonction, exécutez la cellule suivante pour l’appeler de bout en bout et vérifier que l’audio est bien généré et journalisé. Weave stocke les prompts système et utilisateur dans une trace, avec l’audio produit en sortie.
Une fois la cellule exécutée, cliquez sur le lien de la trace affiché dans la sortie de la cellule pour consulter votre trace. Vous disposez désormais dans Weave d’un appel audio chat complétion complet et tracé.
```python lines theme={"system"}
from IPython.display import Audio
# Appeler la fonction pour écrire le flux audio
prompt_endpoint_and_log_trace(
system_prompt="You're the fastest counter in the world",
user_prompt="Count to 13 super super slow, enunciate each number with a dramatic flair, changing up accents as you go along. British, French, German, Spanish, etc.",
)
# Afficher le flux audio mis à jour
display(Audio("output.wav", rate=SAMPLE_RATE, autoplay=True))
```
Utilisation avancée : API Realtime avec Weave
La suite de ce cookbook présente un exemple plus avancé qui associe l’API Realtime d’OpenAI à Weave pour tracer une conversation audio bidirectionnelle en direct.
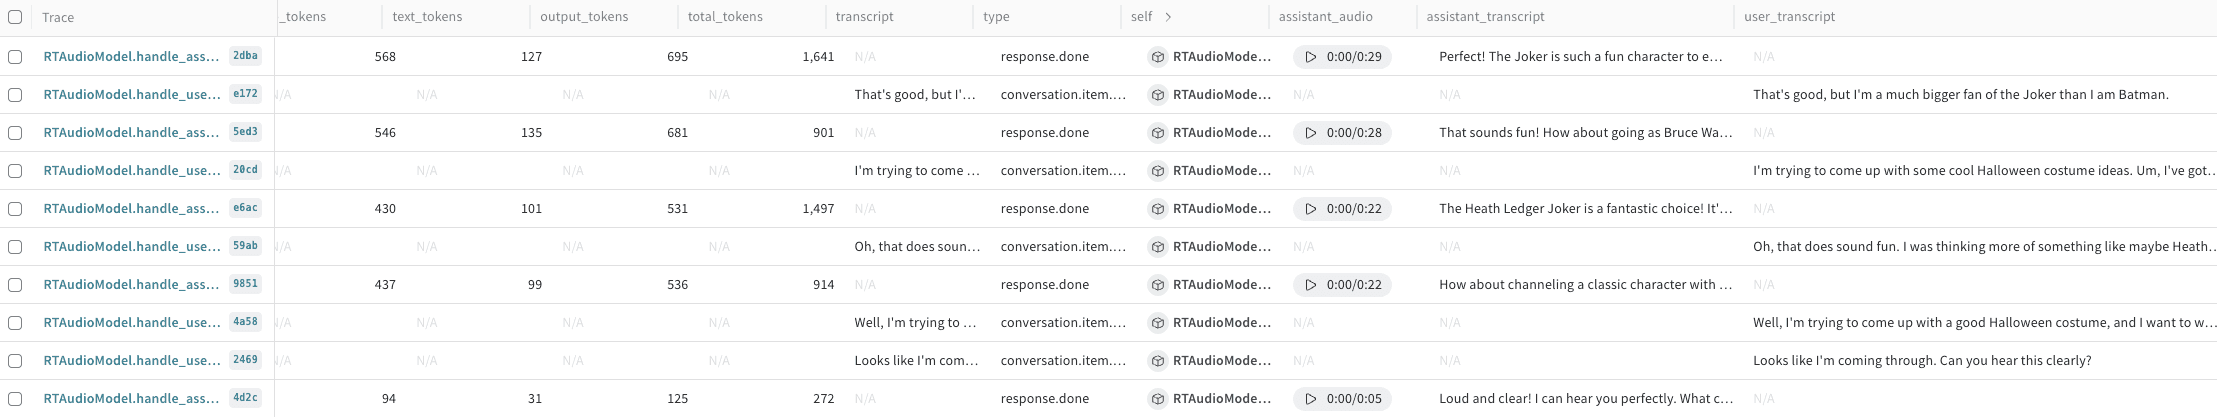 L’API Realtime d’OpenAI est une API conversationnelle permettant de créer des assistants audio et texte en temps réel.
Avant d’exécuter l’exemple Realtime, prenez connaissance des exigences suivantes :
* Consultez les cellules de la section [Configuration du microphone](#microphone-configuration).
* En raison des limitations de l’environnement d’exécution de Google Colab, vous devez exécuter cet exemple sur votre machine hôte, sous forme de Jupyter Notebook. Il ne peut pas être exécuté dans le navigateur.
* Sur macOS, vous devez installer `portaudio` via [Brew](https://formulae.brew.sh/formula/portaudio) pour que PyAudio fonctionne.
* L’option `enable_audio_playback` permet de lire l’audio produit par l’assistant. Si vous l’activez, un casque est indispensable, car la détection d’écho nécessiterait une implémentation complexe.
Configuration des exigences
L’exemple Realtime nécessite des paquets supplémentaires pour les E/S audio et la communication via WebSocket. Installez-les, puis rechargez vos variables d’environnement.
```python lines theme={"system"}
%%capture
!pip install numpy==2.0
!pip install weave
!pip install pyaudio # Sur Mac, vous devrez peut-être d’abord installer portaudio avec `brew install portaudio`
!pip install websocket-client
!pip install set-env-colab-kaggle-dotenv -q # pour les variables d’environnement
!pip install resampy
python
import io
import json
import os
import threading
from typing import Optional
import pyaudio
import resampy
import websocket
from set_env import set_env
import weave
python
# Définir les variables d’environnement.
# Pour les instructions d’utilisation, voir https://pypi.org/project/set-env-colab-kaggle-dotenv/.
_ = set_env("OPENAI_API_KEY")
_ = set_env("WANDB_API_KEY")
```
Configuration du microphone
Comme l’exemple Realtime enregistre le son de votre microphone et le restitue via vos haut-parleurs, vous devez indiquer à PyAudio les périphériques à utiliser.
Exécutez la cellule suivante pour trouver tous les périphériques audio disponibles. Renseignez ensuite `INPUT_DEVICE_INDEX` et `OUTPUT_DEVICE_INDEX` en fonction des périphériques listés. Votre périphérique d’entrée doit disposer d’au moins un canal d’entrée, et votre périphérique de sortie d’au moins un canal de sortie.
```python lines theme={"system"}
# Obtenir la liste des périphériques depuis pyaudio pour configurer la cellule suivante
p = pyaudio.PyAudio()
devices_data = {i: p.get_device_info_by_index(i) for i in range(p.get_device_count())}
for i, device in devices_data.items():
print(
f"Found device @{i}: {device['name']} with sample rate: {device['defaultSampleRate']} and input channels: {device['maxInputChannels']} and output channels: {device['maxOutputChannels']}"
)
python
INPUT_DEVICE_INDEX = 3 # @param # Choisir en fonction de la liste des périphériques ci-dessus. Vérifiez que le périphérique dispose d’au moins un canal d’entrée.
OUTPUT_DEVICE_INDEX = 12 # @param # Choisir en fonction de la liste des périphériques ci-dessus. Vérifiez que le périphérique dispose d’au moins un canal de sortie.
enable_audio_playback = True # @param {type:"boolean"} # Activer la lecture audio de l’assistant. Nécessite un casque.
# Paramètres d’enregistrement et de streaming audio
INPUT_DEVICE_CHANNELS = devices_data[INPUT_DEVICE_INDEX][
"maxInputChannels"
] # D’après la liste des périphériques ci-dessus
SAMPLE_RATE = int(
devices_data[INPUT_DEVICE_INDEX]["defaultSampleRate"]
) # D’après la liste des périphériques ci-dessus
CHUNK = int(SAMPLE_RATE / 10) # Échantillons par image multimédia
SAMPLE_WIDTH = p.get_sample_size(pyaudio.paInt16) # Échantillons par image multimédia pour le format
CHUNK_DURATION = 0.3 # Secondes d’audio par fragment envoyé à l’API OAI
OAI_SAMPLE_RATE = (
24000 # La fréquence d’échantillonnage OAI est de 24 kHz ; elle est nécessaire pour lire ou enregistrer l’audio de l’assistant
)
OUTPUT_DEVICE_CHANNELS = 1 # Définir sur 1 pour une sortie mono
```
Implémentation du schéma de l’API Realtime d’OpenAI
Les sections suivantes construisent pas à pas le client Realtime : le schéma des messages, un module d’écriture audio, le modèle instrumenté avec Weave et l’enregistreur.
Le SDK Python d’OpenAI ne prend pas encore en charge l’API Realtime. Pour une meilleure lisibilité, cet exemple implémente le schéma complet de l’API Realtime d’OpenAI avec Pydantic ; cette implémentation pourra être abandonnée dès que la prise en charge officielle sera disponible.
Schéma Pydantic pour l’API Realtime d’OpenAI
```python lines theme={"system"}
from enum import Enum
from typing import Any, Literal, Union
from pydantic import BaseModel, Field, ValidationError
class BaseEvent(BaseModel):
type: Union["ClientEventTypes", "ServerEventTypes"]
event_id: Optional[str] = None # Ajouter event_id comme champ facultatif pour tous les événements
# def model_dump_json(self, *args, **kwargs):
# # Inclure uniquement les champs différents de None
# return super().model_dump_json(*args, exclude_none=True, **kwargs)
class ChatMessage(BaseModel):
role: Literal["user", "assistant"]
content: str
timestamp: float
""" CLIENT EVENTS """
class ClientEventTypes(str, Enum):
SESSION_UPDATE = "session.update"
CONVERSATION_ITEM_CREATE = "conversation.item.create"
CONVERSATION_ITEM_TRUNCATE = "conversation.item.truncate"
CONVERSATION_ITEM_DELETE = "conversation.item.delete"
RESPONSE_CREATE = "response.create"
RESPONSE_CANCEL = "response.cancel"
INPUT_AUDIO_BUFFER_APPEND = "input_audio_buffer.append"
INPUT_AUDIO_BUFFER_COMMIT = "input_audio_buffer.commit"
INPUT_AUDIO_BUFFER_CLEAR = "input_audio_buffer.clear"
ERROR = "error"
#### Mise à jour de la session
class TurnDetection(BaseModel):
type: Literal["server_vad"]
threshold: float = Field(..., ge=0.0, le=1.0)
prefix_padding_ms: int
silence_duration_ms: int
class InputAudioTranscription(BaseModel):
model: Optional[str] = None
class ToolParameterProperty(BaseModel):
type: str
class ToolParameter(BaseModel):
type: str
properties: dict[str, ToolParameterProperty]
required: list[str]
class Tool(BaseModel):
type: Literal["function", "code_interpreter", "file_search"]
name: Optional[str] = None
description: Optional[str] = None
parameters: Optional[ToolParameter] = None
class Session(BaseModel):
modalities: Optional[list[str]] = None
instructions: Optional[str] = None
voice: Optional[str] = None
input_audio_format: Optional[str] = None
output_audio_format: Optional[str] = None
input_audio_transcription: Optional[InputAudioTranscription] = None
turn_detection: Optional[TurnDetection] = None
tools: Optional[list[Tool]] = None
tool_choice: Optional[str] = None
temperature: Optional[float] = None
max_output_tokens: Optional[int] = None
class SessionUpdate(BaseEvent):
type: Literal[ClientEventTypes.SESSION_UPDATE] = ClientEventTypes.SESSION_UPDATE
session: Session
#### Tampons audio
class InputAudioBufferAppend(BaseEvent):
type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_APPEND] = (
ClientEventTypes.INPUT_AUDIO_BUFFER_APPEND
)
audio: str
class InputAudioBufferCommit(BaseEvent):
type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_COMMIT] = (
ClientEventTypes.INPUT_AUDIO_BUFFER_COMMIT
)
class InputAudioBufferClear(BaseEvent):
type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_CLEAR] = (
ClientEventTypes.INPUT_AUDIO_BUFFER_CLEAR
)
#### Messages
class MessageContent(BaseModel):
type: Literal["input_audio"]
audio: str
class ConversationItemContent(BaseModel):
type: Literal["input_text", "input_audio", "text", "audio"]
text: Optional[str] = None
audio: Optional[str] = None
transcript: Optional[str] = None
class FunctionCallContent(BaseModel):
call_id: str
name: str
arguments: str
class FunctionCallOutputContent(BaseModel):
output: str
class ConversationItem(BaseModel):
id: Optional[str] = None
type: Literal["message", "function_call", "function_call_output"]
status: Optional[Literal["completed", "in_progress", "incomplete"]] = None
role: Literal["user", "assistant", "system"]
content: list[
Union[ConversationItemContent, FunctionCallContent, FunctionCallOutputContent]
]
call_id: Optional[str] = None
name: Optional[str] = None
arguments: Optional[str] = None
output: Optional[str] = None
class ConversationItemCreate(BaseEvent):
type: Literal[ClientEventTypes.CONVERSATION_ITEM_CREATE] = (
ClientEventTypes.CONVERSATION_ITEM_CREATE
)
item: ConversationItem
class ConversationItemTruncate(BaseEvent):
type: Literal[ClientEventTypes.CONVERSATION_ITEM_TRUNCATE] = (
ClientEventTypes.CONVERSATION_ITEM_TRUNCATE
)
item_id: str
content_index: int
audio_end_ms: int
class ConversationItemDelete(BaseEvent):
type: Literal[ClientEventTypes.CONVERSATION_ITEM_DELETE] = (
ClientEventTypes.CONVERSATION_ITEM_DELETE
)
item_id: str
#### Réponses
class ResponseCreate(BaseEvent):
type: Literal[ClientEventTypes.RESPONSE_CREATE] = ClientEventTypes.RESPONSE_CREATE
class ResponseCancel(BaseEvent):
type: Literal[ClientEventTypes.RESPONSE_CANCEL] = ClientEventTypes.RESPONSE_CANCEL
# Mettre à jour l’union Event pour y inclure tous les types d’événements
ClientEvent = Union[
SessionUpdate,
InputAudioBufferAppend,
InputAudioBufferCommit,
InputAudioBufferClear,
ConversationItemCreate,
ConversationItemTruncate,
ConversationItemDelete,
ResponseCreate,
ResponseCancel,
]
""" SERVER EVENTS """
class ServerEventTypes(str, Enum):
ERROR = "error"
RESPONSE_AUDIO_TRANSCRIPT_DONE = "response.audio_transcript.done"
RESPONSE_AUDIO_TRANSCRIPT_DELTA = "response.audio_transcript.delta"
RESPONSE_AUDIO_DELTA = "response.audio.delta"
SESSION_CREATED = "session.created"
SESSION_UPDATED = "session.updated"
CONVERSATION_CREATED = "conversation.created"
INPUT_AUDIO_BUFFER_COMMITTED = "input_audio_buffer.committed"
INPUT_AUDIO_BUFFER_CLEARED = "input_audio_buffer.cleared"
INPUT_AUDIO_BUFFER_SPEECH_STARTED = "input_audio_buffer.speech_started"
INPUT_AUDIO_BUFFER_SPEECH_STOPPED = "input_audio_buffer.speech_stopped"
CONVERSATION_ITEM_CREATED = "conversation.item.created"
CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED = (
"conversation.item.input_audio_transcription.completed"
)
CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED = (
"conversation.item.input_audio_transcription.failed"
)
CONVERSATION_ITEM_TRUNCATED = "conversation.item.truncated"
CONVERSATION_ITEM_DELETED = "conversation.item.deleted"
RESPONSE_CREATED = "response.created"
RESPONSE_DONE = "response.done"
RESPONSE_OUTPUT_ITEM_ADDED = "response.output_item.added"
RESPONSE_OUTPUT_ITEM_DONE = "response.output_item.done"
RESPONSE_CONTENT_PART_ADDED = "response.content_part.added"
RESPONSE_CONTENT_PART_DONE = "response.content_part.done"
RESPONSE_TEXT_DELTA = "response.text.delta"
RESPONSE_TEXT_DONE = "response.text.done"
RESPONSE_AUDIO_DONE = "response.audio.done"
RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA = "response.function_call_arguments.delta"
RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE = "response.function_call_arguments.done"
RATE_LIMITS_UPDATED = "rate_limits.updated"
#### Erreurs
class ErrorDetails(BaseModel):
type: Optional[str] = None
code: Optional[str] = None
message: Optional[str] = None
param: Optional[str] = None
class ErrorEvent(BaseEvent):
type: Literal[ServerEventTypes.ERROR] = ServerEventTypes.ERROR
error: ErrorDetails
#### Session
class SessionCreated(BaseEvent):
type: Literal[ServerEventTypes.SESSION_CREATED] = ServerEventTypes.SESSION_CREATED
session: Session
class SessionUpdated(BaseEvent):
type: Literal[ServerEventTypes.SESSION_UPDATED] = ServerEventTypes.SESSION_UPDATED
session: Session
#### Conversation
class Conversation(BaseModel):
id: str
object: Literal["realtime.conversation"]
class ConversationCreated(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_CREATED] = (
ServerEventTypes.CONVERSATION_CREATED
)
conversation: Conversation
class ConversationItemCreated(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_ITEM_CREATED] = (
ServerEventTypes.CONVERSATION_ITEM_CREATED
)
previous_item_id: Optional[str] = None
item: ConversationItem
class ConversationItemInputAudioTranscriptionCompleted(BaseEvent):
type: Literal[
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
] = ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
item_id: str
content_index: int
transcript: str
class ConversationItemInputAudioTranscriptionFailed(BaseEvent):
type: Literal[
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED
] = ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED
item_id: str
content_index: int
error: dict[str, Any]
class ConversationItemTruncated(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_ITEM_TRUNCATED] = (
ServerEventTypes.CONVERSATION_ITEM_TRUNCATED
)
item_id: str
content_index: int
audio_end_ms: int
class ConversationItemDeleted(BaseEvent):
type: Literal[ServerEventTypes.CONVERSATION_ITEM_DELETED] = (
ServerEventTypes.CONVERSATION_ITEM_DELETED
)
item_id: str
#### Réponse
class ResponseUsage(BaseModel):
total_tokens: int
input_tokens: int
output_tokens: int
input_token_details: Optional[dict[str, int]] = None
output_token_details: Optional[dict[str, int]] = None
class ResponseOutput(BaseModel):
id: str
object: Literal["realtime.item"]
type: str
status: str
role: str
content: list[dict[str, Any]]
class ResponseContentPart(BaseModel):
type: str
text: Optional[str] = None
class ResponseOutputItemContent(BaseModel):
type: str
text: Optional[str] = None
class ResponseStatusDetails(BaseModel):
type: str
reason: str
class ResponseOutputItem(BaseModel):
id: str
object: Literal["realtime.item"]
type: str
status: str
role: str
content: list[ResponseOutputItemContent]
class Response(BaseModel):
id: str
object: Literal["realtime.response"]
status: str
status_details: Optional[ResponseStatusDetails] = None
output: list[ResponseOutput]
usage: Optional[ResponseUsage]
class ResponseCreated(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_CREATED] = ServerEventTypes.RESPONSE_CREATED
response: Response
class ResponseDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_DONE] = ServerEventTypes.RESPONSE_DONE
response: Response
class ResponseOutputItemAdded(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED] = (
ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED
)
response_id: str
output_index: int
item: ResponseOutputItem
class ResponseOutputItemDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE] = (
ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE
)
response_id: str
output_index: int
item: ResponseOutputItem
class ResponseContentPartAdded(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_CONTENT_PART_ADDED] = (
ServerEventTypes.RESPONSE_CONTENT_PART_ADDED
)
response_id: str
item_id: str
output_index: int
content_index: int
part: ResponseContentPart
class ResponseContentPartDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_CONTENT_PART_DONE] = (
ServerEventTypes.RESPONSE_CONTENT_PART_DONE
)
response_id: str
item_id: str
output_index: int
content_index: int
part: ResponseContentPart
#### Texte de la réponse
class ResponseTextDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_TEXT_DELTA] = (
ServerEventTypes.RESPONSE_TEXT_DELTA
)
response_id: str
item_id: str
output_index: int
content_index: int
delta: str
class ResponseTextDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_TEXT_DONE] = (
ServerEventTypes.RESPONSE_TEXT_DONE
)
response_id: str
item_id: str
output_index: int
content_index: int
text: str
#### Audio de la réponse
class ResponseAudioTranscriptDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE] = (
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE
)
transcript: str
class ResponseAudioTranscriptDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA] = (
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA
)
delta: str
class ResponseAudioDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_DELTA] = (
ServerEventTypes.RESPONSE_AUDIO_DELTA
)
response_id: str
item_id: str
delta: str
class ResponseAudioDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_AUDIO_DONE] = (
ServerEventTypes.RESPONSE_AUDIO_DONE
)
response_id: str
item_id: str
output_index: int
content_index: int
class InputAudioBufferCommitted(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED
)
previous_item_id: Optional[str] = None
item_id: Optional[str] = None
event_id: Optional[str] = None
class InputAudioBufferCleared(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED
)
class InputAudioBufferSpeechStarted(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED
)
audio_start_ms: int
item_id: str
class InputAudioBufferSpeechStopped(BaseEvent):
type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED] = (
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED
)
audio_end_ms: int
item_id: str
#### Appels de fonction
class ResponseFunctionCallArgumentsDelta(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA] = (
ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA
)
response_id: str
item_id: str
output_index: int
call_id: str
delta: str
class ResponseFunctionCallArgumentsDone(BaseEvent):
type: Literal[ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE] = (
ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE
)
response_id: str
item_id: str
output_index: int
call_id: str
arguments: str
#### Limites de débit
class RateLimit(BaseModel):
name: str
limit: int
remaining: int
reset_seconds: float
class RateLimitsUpdated(BaseEvent):
type: Literal[ServerEventTypes.RATE_LIMITS_UPDATED] = (
ServerEventTypes.RATE_LIMITS_UPDATED
)
rate_limits: list[RateLimit]
ServerEvent = Union[
ErrorEvent,
ConversationCreated,
ResponseAudioTranscriptDone,
ResponseAudioTranscriptDelta,
ResponseAudioDelta,
ResponseCreated,
ResponseDone,
ResponseOutputItemAdded,
ResponseOutputItemDone,
ResponseContentPartAdded,
ResponseContentPartDone,
ResponseTextDelta,
ResponseTextDone,
ResponseAudioDone,
ConversationItemInputAudioTranscriptionCompleted,
SessionCreated,
SessionUpdated,
InputAudioBufferCleared,
InputAudioBufferSpeechStarted,
InputAudioBufferSpeechStopped,
ConversationItemCreated,
ConversationItemInputAudioTranscriptionFailed,
ConversationItemTruncated,
ConversationItemDeleted,
RateLimitsUpdated,
]
EVENT_TYPE_TO_MODEL = {
ServerEventTypes.ERROR: ErrorEvent,
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE: ResponseAudioTranscriptDone,
ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA: ResponseAudioTranscriptDelta,
ServerEventTypes.RESPONSE_AUDIO_DELTA: ResponseAudioDelta,
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED: ConversationItemInputAudioTranscriptionCompleted,
ServerEventTypes.SESSION_CREATED: SessionCreated,
ServerEventTypes.SESSION_UPDATED: SessionUpdated,
ServerEventTypes.CONVERSATION_CREATED: ConversationCreated,
ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED: InputAudioBufferCommitted,
ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED: InputAudioBufferCleared,
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED: InputAudioBufferSpeechStarted,
ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED: InputAudioBufferSpeechStopped,
ServerEventTypes.CONVERSATION_ITEM_CREATED: ConversationItemCreated,
ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED: ConversationItemInputAudioTranscriptionFailed,
ServerEventTypes.CONVERSATION_ITEM_TRUNCATED: ConversationItemTruncated,
ServerEventTypes.CONVERSATION_ITEM_DELETED: ConversationItemDeleted,
ServerEventTypes.RESPONSE_CREATED: ResponseCreated,
ServerEventTypes.RESPONSE_DONE: ResponseDone,
ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED: ResponseOutputItemAdded,
ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE: ResponseOutputItemDone,
ServerEventTypes.RESPONSE_CONTENT_PART_ADDED: ResponseContentPartAdded,
ServerEventTypes.RESPONSE_CONTENT_PART_DONE: ResponseContentPartDone,
ServerEventTypes.RESPONSE_TEXT_DELTA: ResponseTextDelta,
ServerEventTypes.RESPONSE_TEXT_DONE: ResponseTextDone,
ServerEventTypes.RESPONSE_AUDIO_DONE: ResponseAudioDone,
ServerEventTypes.RATE_LIMITS_UPDATED: RateLimitsUpdated,
}
def parse_server_event(event_data: dict) -> ServerEvent:
event_type = event_data.get("type")
if not event_type:
raise ValueError("Event data is missing 'type' field")
model_class = EVENT_TYPE_TO_MODEL.get(event_type)
if not model_class:
raise ValueError(f"Unknown event type: {event_type}")
try:
return model_class(**event_data)
except ValidationError as e:
raise ValueError(f"Failed to parse event of type {event_type}: {str(e)}") from e
```
Enregistreur de flux audio (sur disque et en mémoire)
La classe utilitaire suivante met en mémoire tampon les fragments audio reçus en streaming dans un fichier WAV (ou dans un tampon en mémoire), afin que l’audio puisse ensuite être transmis à Weave pour la journalisation.
```python lines theme={"system"}
class StreamingWavWriter:
"""Writes audio integer or byte array chunks to a WAV file."""
wav_file = None
buffer = None
in_memory = False
def __init__(
self,
filename=None,
channels=INPUT_DEVICE_CHANNELS,
sample_width=SAMPLE_WIDTH,
framerate=SAMPLE_RATE,
):
self.in_memory = filename is None
if self.in_memory:
self.buffer = io.BytesIO()
self.wav_file = wave.open(self.buffer, "wb")
else:
self.wav_file = wave.open(filename, "wb")
self.wav_file.setnchannels(channels)
self.wav_file.setsampwidth(sample_width)
self.wav_file.setframerate(framerate)
def append_int16_chunk(self, int16_data):
if int16_data is not None:
self.wav_file.writeframes(
int16_data.tobytes()
if isinstance(int16_data, np.ndarray)
else int16_data
)
def close(self):
self.wav_file.close()
def get_wav_buffer(self):
assert self.in_memory, "Buffer only available if stream is in memory."
return self.buffer
```
Modèle audio en temps réel
Le modèle audio en temps réel (RT) utilise un WebSocket pour envoyer des événements à l’API Realtime d’OpenAI. Le modèle fonctionne comme suit :
1. **init** : initialise les tampons locaux (audio d’entrée) et les flux (flux de lecture de l’assistant, flux d’écriture sur disque de l’audio de l’utilisateur), puis ouvre une connexion à l’API Realtime.
2. **receive\_messages\_thread** : un thread se charge de recevoir les messages de l’API. Le code traite quatre principaux types d’événements :
* `RESPONSE_AUDIO_TRANSCRIPT_DONE` : le serveur signale que la réponse de l’assistant est terminée et fournit la transcription.
* `CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED` : le serveur signale que l’audio de l’utilisateur a été transcrit et envoie la transcription correspondante. Le code journalise la transcription vers Weave et l’affiche à l’utilisateur.
* `RESPONSE_AUDIO_DELTA` : le serveur envoie un nouveau fragment de l’audio de réponse de l’assistant. Le code l’ajoute aux données de la réponse en cours, identifiée par son ID, puis l’envoie au flux de sortie pour lecture.
* `RESPONSE_DONE` : le serveur signale la fin d’une réponse de l’assistant. Le code récupère tous les fragments audio associés à la réponse, ainsi que la transcription, et les journalise dans Weave.
3. **send\_audio** : un gestionnaire ajoute les fragments audio de l’utilisateur à un tampon et envoie les fragments audio lorsque ce tampon atteint une certaine taille.
```python lines theme={"system"}
class RTAudioModel(weave.Model):
"""Model class for realtime e2e audio OpenAI model interaction with Whisper user transcription for logging."""
realtime_model_name: str = "gpt-4o-realtime-preview-2024-10-01" # interaction avec un modèle exclusivement audio, de bout en bout et en temps réel
stop_event: Optional[threading.Event] = threading.Event() # Événement permettant d’arrêter le modèle
ws: Optional[websocket.WebSocket] = None # WebSocket pour communiquer avec OpenAI
user_wav_writer: Optional[StreamingWavWriter] = (
None # Flux d’écriture de la sortie de l’utilisateur dans un fichier
)
input_audio_buffer: Optional[np.ndarray] = None # Tampon pour les fragments audio de l’utilisateur
assistant_outputs: dict[str, StreamingWavWriter] = (
None # Sorties de l’assistant agrégées pour l’envoi vers Weave
)
playback_stream: Optional[pyaudio.Stream] = (
None # Flux de lecture des réponses de l’assistant
)
def __init__(self):
super().__init__()
self.stop_event.clear()
self.user_wav_writer = StreamingWavWriter(
filename="user_audio.wav", framerate=SAMPLE_RATE
)
self.input_audio_buffer = np.array([], dtype=np.int16)
self.ws = websocket.WebSocket()
self.assistant_outputs = {}
# Ouvrir le flux de lecture audio de l’assistant si cette option est activée
if enable_audio_playback:
self.playback_stream = pyaudio.PyAudio().open(
format=pyaudio.paInt16,
channels=OUTPUT_DEVICE_CHANNELS,
rate=OAI_SAMPLE_RATE,
output=True,
output_device_index=OUTPUT_DEVICE_INDEX,
)
# Connecter le WebSocket
try:
self.ws.connect(
f"wss://api.openai.com/v1/realtime?model={self.realtime_model_name}",
header={
"Authorization": f"Bearer {os.environ.get('OPENAI_API_KEY')}",
"OpenAI-Beta": "realtime=v1",
},
)
# Envoyer le message de configuration
config_event = SessionUpdate(
session=Session(
modalities=["text", "audio"], # modalités à utiliser
input_audio_transcription=InputAudioTranscription(
model="whisper-1"
), # whisper-1 pour la transcription
turn_detection=TurnDetection(
type="server_vad",
threshold=0.3,
prefix_padding_ms=300,
silence_duration_ms=600,
), # VAD côté serveur pour détecter les silences
)
)
self.ws.send(config_event.model_dump_json(exclude_none=True))
self.log_ws_message(config_event.model_dump_json(exclude_none=True), "Sent")
# Démarrer l’écouteur
websocket_thread = threading.Thread(target=self.receive_messages_thread)
websocket_thread.daemon = True
websocket_thread.start()
except Exception as e:
print(f"Error connecting to WebSocket: {e}")
##### Intégration Weave et gestionnaires de messages #####
def handle_assistant_response_audio_delta(self, data: ResponseAudioDelta):
if data.response_id not in self.assistant_outputs:
self.assistant_outputs[data.response_id] = StreamingWavWriter(
framerate=OAI_SAMPLE_RATE
)
data_bytes = base64.b64decode(data.delta)
self.assistant_outputs[data.response_id].append_int16_chunk(data_bytes)
if enable_audio_playback:
self.playback_stream.write(data_bytes)
return {"assistant_audio": data_bytes}
@weave.op()
def handle_assistant_response_done(self, data: ResponseDone):
wave_file_stream = self.assistant_outputs[data.response.id]
wave_file_stream.close()
wave_file_stream.buffer.seek(0)
weave_payload = {
"assistant_audio": wave.open(wave_file_stream.get_wav_buffer(), "rb"),
"assistant_transcript": data.response.output[0]
.content[0]
.get("transcript", "Transcript Unavailable."),
}
return weave_payload
@weave.op()
def handle_user_transcription_done(
self, data: ConversationItemInputAudioTranscriptionCompleted
):
return {"user_transcript": data.transcript}
##### Réception et envoi des messages #####
def receive_messages_thread(self):
while not self.stop_event.is_set():
try:
data = json.loads(self.ws.recv())
self.log_ws_message(json.dumps(data, indent=2))
parsed_event = parse_server_event(data)
if parsed_event.type == ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE:
print("Assistant: ", parsed_event.transcript)
elif (
parsed_event.type
== ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
):
print("User: ", parsed_event.transcript)
self.handle_user_transcription_done(parsed_event)
elif parsed_event.type == ServerEventTypes.RESPONSE_AUDIO_DELTA:
self.handle_assistant_response_audio_delta(parsed_event)
elif parsed_event.type == ServerEventTypes.RESPONSE_DONE:
self.handle_assistant_response_done(parsed_event)
elif parsed_event.type == ServerEventTypes.ERROR:
print(
f"\nError from server: {parsed_event.error.model_dump_json(exclude_none=True)}"
)
except websocket.WebSocketConnectionClosedException:
print("\nWebSocket connection closed")
break
except json.JSONDecodeError:
continue
except Exception as e:
print(f"\nError in receive_messages: {e}")
break
def send_audio(self, audio_chunk):
if self.ws and self.ws.connected:
self.input_audio_buffer = np.append(
self.input_audio_buffer, np.frombuffer(audio_chunk, dtype=np.int16)
)
if len(self.input_audio_buffer) >= SAMPLE_RATE * CHUNK_DURATION:
try:
# Rééchantillonner l’audio à la fréquence d’échantillonnage d’OAI
resampled_audio = (
resampy.resample(
self.input_audio_buffer, SAMPLE_RATE, OAI_SAMPLE_RATE
)
if SAMPLE_RATE != OAI_SAMPLE_RATE
else self.input_audio_buffer
)
# Envoyer le fragment audio à l’API OAI
audio_event = InputAudioBufferAppend(
audio=base64.b64encode(
resampled_audio.astype(np.int16).tobytes()
).decode("utf-8") # Convertir le tableau audio en octets base64
)
self.ws.send(audio_event.model_dump_json(exclude_none=True))
self.log_ws_message(
audio_event.model_dump_json(exclude_none=True), "Sent"
)
finally:
self.user_wav_writer.append_int16_chunk(self.input_audio_buffer)
# Vider le tampon audio
self.input_audio_buffer = np.array([], dtype=np.int16)
else:
print("Error sending audio: websocket not initialized.")
##### Fonctions utilitaires générales #####
def log_ws_message(self, message, direction="Received"):
with open("websocket_log.txt", "a") as log_file:
log_file.write(
f"{time.strftime('%Y-%m-%d %H:%M:%S')} - {direction}: {message}\n"
)
def stop(self):
self.stop_event.set()
if self.ws:
self.ws.close()
self.user_wav_writer.close()
```
Enregistreur audio
Une fois le modèle défini, il vous faut un moyen de lui transmettre l’entrée du microphone. Cet exemple utilise un flux d’entrée PyAudio associé à un gestionnaire lié à la méthode `send_audio` du modèle RTAudio. Le code renvoie le flux au thread principal pour qu’il puisse se fermer proprement à la fin du programme.
```python lines theme={"system"}
# Flux de capture audio
def record_audio(realtime_model: RTAudioModel) -> pyaudio.Stream:
"""Setup a Pyaudio input stream and use the RTAudioModel as a callback for streaming data."""
def audio_callback(in_data, frame_count, time_info, status):
realtime_model.send_audio(in_data)
return (None, pyaudio.paContinue)
p = pyaudio.PyAudio()
stream = p.open(
format=pyaudio.paInt16,
channels=INPUT_DEVICE_CHANNELS,
rate=SAMPLE_RATE,
input=True,
input_device_index=INPUT_DEVICE_INDEX,
frames_per_buffer=CHUNK,
stream_callback=audio_callback,
)
stream.start_stream()
print("Recording started. Please begin speaking to your personal assistant...")
return stream
```
Thread principal
Cette dernière cellule assemble les composants précédents et lance l’assistant en temps réel. Le thread principal initialise un Realtime Audio Model intégrant Weave. Le code ouvre ensuite un enregistrement et attend une interruption clavier de l’utilisateur. Lorsque vous arrêtez la cellule, vous disposez d’une trace Weave complète de la conversation, y compris les transcriptions et l’audio de l’utilisateur et de l’assistant.
```python lines theme={"system"}
weave.init(project_name="realtime-oai-audio-testing")
realtime_model = RTAudioModel()
if realtime_model.ws and realtime_model.ws.connected:
recording_stream: pyaudio.Stream = record_audio(realtime_model)
try:
while not realtime_model.stop_event.is_set():
time.sleep(1)
except KeyboardInterrupt:
pass
except Exception as e:
print(f"Error in main loop: {e}")
import traceback
traceback.print_exc()
finally:
print("Exiting...")
realtime_model.stop()
if recording_stream and recording_stream.is_active():
recording_stream.stop_stream()
recording_stream.close()
else:
print(
"WebSocket connection failed. Please check your API key and internet connection."
)
```