> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
> Utilisez W&B pour journaliser des expériences d’entraînement distribué sur plusieurs GPU.
# Journaliser des expériences d’entraînement distribué
Lors d’une expérience d’entraînement distribué, vous entraînez un modèle sur plusieurs machines ou clients en parallèle. W\&B peut vous aider à suivre ces expériences. Selon votre cas d’utilisation, suivez les expériences d’entraînement distribué à l’aide de l’une des approches suivantes :
* **Suivre un seul processus** : suivez avec W\&B le processus de rank 0 (également appelé « leader » ou « coordinateur »). Il s’agit d’une solution courante pour journaliser des expériences d’entraînement distribué avec la classe [PyTorch Distributed Data Parallel](https://pytorch.org/docs/stable/generated/torch.nn.parallel.DistributedDataParallel.html#torch.nn.parallel.DistributedDataParallel) (DDP).
* **Suivre plusieurs processus** : pour plusieurs processus, vous pouvez :
* Suivre chaque processus séparément, avec un run par processus. Vous pouvez éventuellement les regrouper dans l’interface de l’application W\&B.
* Suivre tous les processus dans un seul run.
**Connexions simultanées**
Chaque connexion simultanée consomme des ressources de calcul, de mémoire et de réseau. Même les connexions client vides, qui ne journalisent aucune métrique, envoient régulièrement des mises à jour des métriques système, ce qui ralentit le chargement des graphiques.
W\&B vous recommande de limiter le nombre maximum de connexions client simultanées en fonction de votre charge de travail et de surveiller l’utilisation des ressources au fil du temps. W\&B a effectué des tests avec une limite stricte de 300 connexions client simultanées dans le **Cloud dédié**.
Dans les organisations du **Cloud mutualisé**, les connexions client pour l’entraînement distribué sont soumises aux mêmes [limites de débit](/fr/products/wandb/track/limits#rate-limits) que les runs d’entraînement classiques. Les utilisateurs des [forfaits Teams et Enterprise](https://coreweave.com/forge-pricing) bénéficient de limites de débit plus élevées que ceux du forfait Free.
Suivre un seul processus
Cette section explique comment suivre les valeurs et les métriques accessibles à votre processus de rank 0. Utilisez cette approche pour suivre uniquement les métriques disponibles depuis un seul processus. Il s’agit généralement de l’utilisation du GPU/CPU, du comportement sur un jeu de validation partagé, des gradients et des paramètres, ainsi que des valeurs de perte sur des exemples de données représentatifs.
Dans le processus de rank 0, initialisez un run W\&B avec [`wandb.init()`](/fr/products/wandb/ref/python/functions/init) et journalisez les expériences ([`wandb.Run.log()`](/fr/products/wandb/ref/python/experiments/run#method-runlog)) dans ce run.
L’[exemple de script Python (`log-ddp.py`)](https://github.com/wandb/examples/blob/master/examples/pytorch/pytorch-ddp/log-ddp.py) suivant illustre une manière de suivre des métriques sur deux GPU d’une même machine avec PyTorch DDP. [PyTorch DDP](https://pytorch.org/tutorials/intermediate/ddp_tutorial.html) (`DistributedDataParallel` dans`torch.nn`) est une bibliothèque couramment utilisée pour l’entraînement distribué. Les principes de base s’appliquent à toute configuration d’entraînement distribué, mais l’implémentation peut varier.
Le script Python :
1. Démarre plusieurs processus avec `torch.distributed.launch`.
2. Vérifie le rank à l’aide de l’argument de ligne de commande `--local_rank`.
3. Si le rank vaut 0, configure de manière conditionnelle la journalisation `wandb` dans la fonction [`train()`](https://github.com/wandb/examples/blob/master/examples/pytorch/pytorch-ddp/log-ddp.py#L24).
```python theme={"system"}
if __name__ == "__main__":
# Obtenir les arguments
args = parse_args()
if args.local_rank == 0: # uniquement dans le processus principal
# Initialiser le run wandb
run = wandb.init(
entity=args.entity,
project=args.project,
)
# Entraîner le modèle avec DDP
train(args, run)
else:
train(args)
```
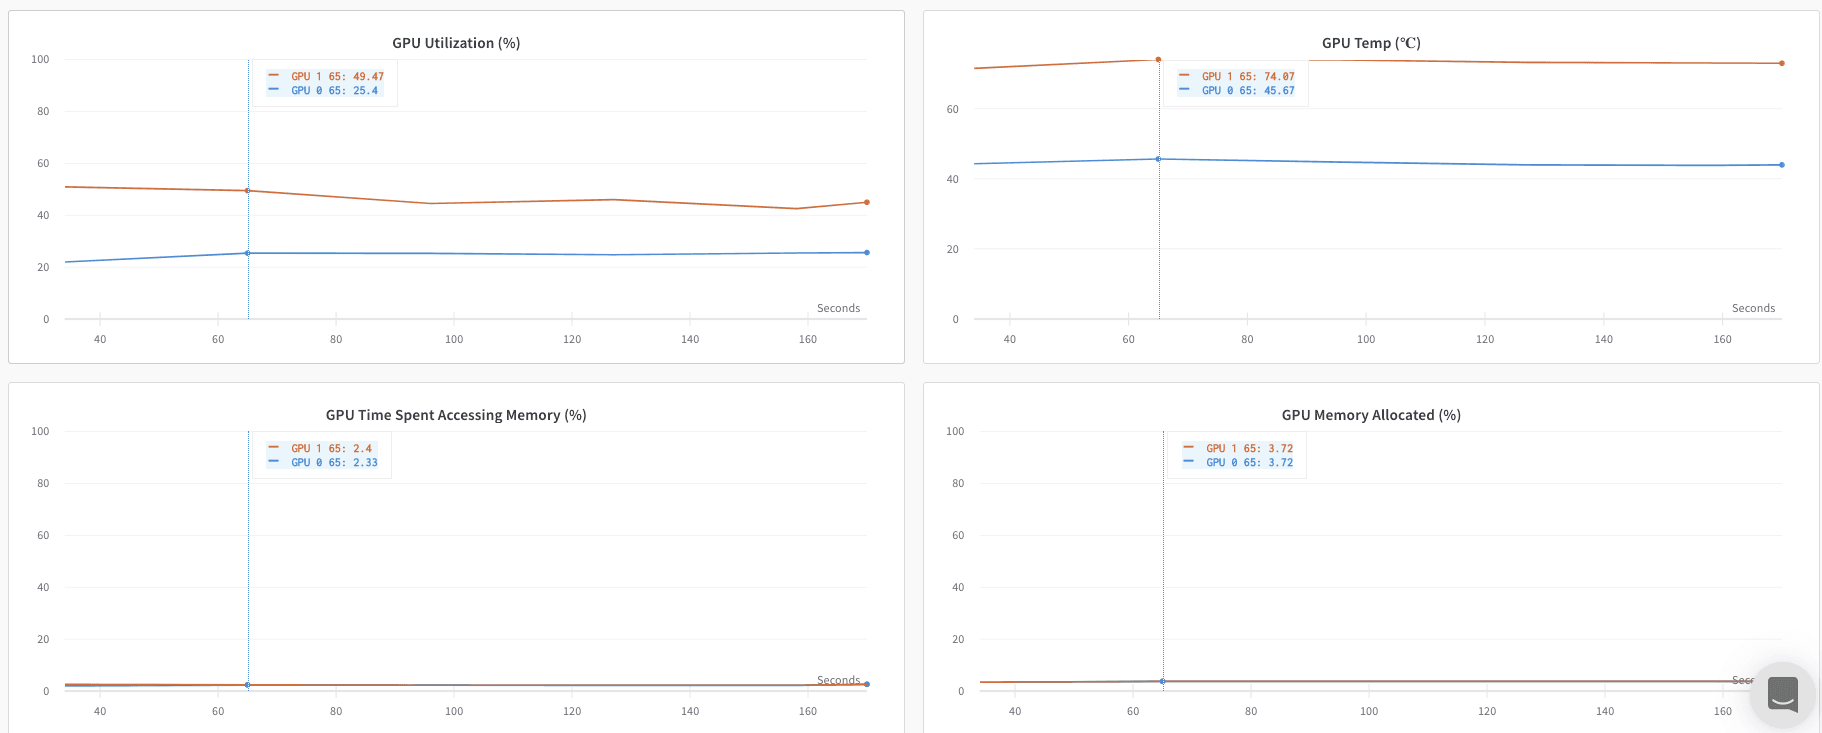
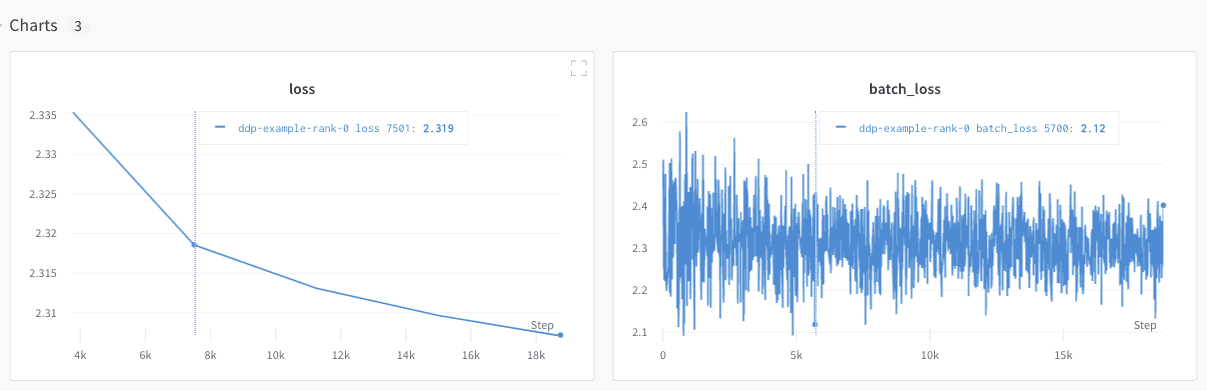
Explorez un [exemple de tableau de bord présentant les métriques suivies à partir d’un seul processus](https://forge.coreweave.com/wandb/ayush-thakur/DDP/runs/1s56u3hc/system).
Le tableau de bord affiche les métriques système des deux GPU, comme la température et l’utilisation.
 En revanche, les valeurs de perte en fonction de l’époque et de la taille de lot n’ont été journalisées que depuis un seul GPU.
Suivre plusieurs processus
Pour suivre plusieurs processus avec W\&B, adoptez l’une des approches suivantes :
* [Suivre chaque processus séparément](/fr/products/wandb/track/log/distributed-training#track-each-process-separately) en créant un run par processus.
* [Suivre tous les processus dans un seul run](/fr/products/wandb/track/log/distributed-training#track-all-processes-to-a-single-run).
Suivre chaque processus séparément
Cette section explique comment suivre chaque processus séparément en créant un run par processus. Dans chaque run, vous journalisez les métriques, les artifacts, etc., qui lui sont propres. Appelez `wandb.Run.finish()` à la fin de l’entraînement pour indiquer que le run est terminé et que tous les processus se ferment correctement.
Il peut être difficile de suivre les runs répartis sur plusieurs expériences. Pour y remédier, fournissez une valeur au paramètre `group` lorsque vous initialisez W\&B (`wandb.init(group='group-name')`) afin de savoir à quelle expérience appartient chaque run. Pour en savoir plus sur le suivi des runs W\&B d’entraînement et d’évaluation au sein des expériences, consultez [Regrouper des runs](/fr/products/wandb/runs/grouping).
**Utilisez cette approche si vous souhaitez suivre les métriques de chaque processus**. Il s’agit généralement des données et des prédictions de chaque nœud (pour déboguer la distribution des données) et des métriques de lots individuels en dehors du nœud principal. Cette approche n’est pas nécessaire pour obtenir les métriques système de tous les nœuds, ni les statistiques de synthèse disponibles sur le nœud principal.
L’extrait de code Python suivant montre comment définir le paramètre group lorsque vous initialisez W\&B :
```python theme={"system"}
if __name__ == "__main__":
# Récupérer les arguments
args = parse_args()
# Initialiser le run
run = wandb.init(
entity=args.entity,
project=args.project,
group="DDP", # regrouper tous les runs de l’expérience dans un même groupe
)
# Entraîner le modèle avec DDP
train(args, run)
run.finish() # marquer le run comme terminé
```
Explorez l’interface de l’application W\&B pour consulter un [exemple de tableau de bord](https://wandb.ai/ayush-thakur/DDP?workspace=user-noahluna) présentant des métriques suivies depuis plusieurs processus. Notez que deux runs W\&B sont regroupés dans la barre latérale gauche. Cliquez sur un groupe pour afficher la page dédiée à ce groupe au sein de l’expérience. Cette page affiche les métriques de chaque processus séparément.
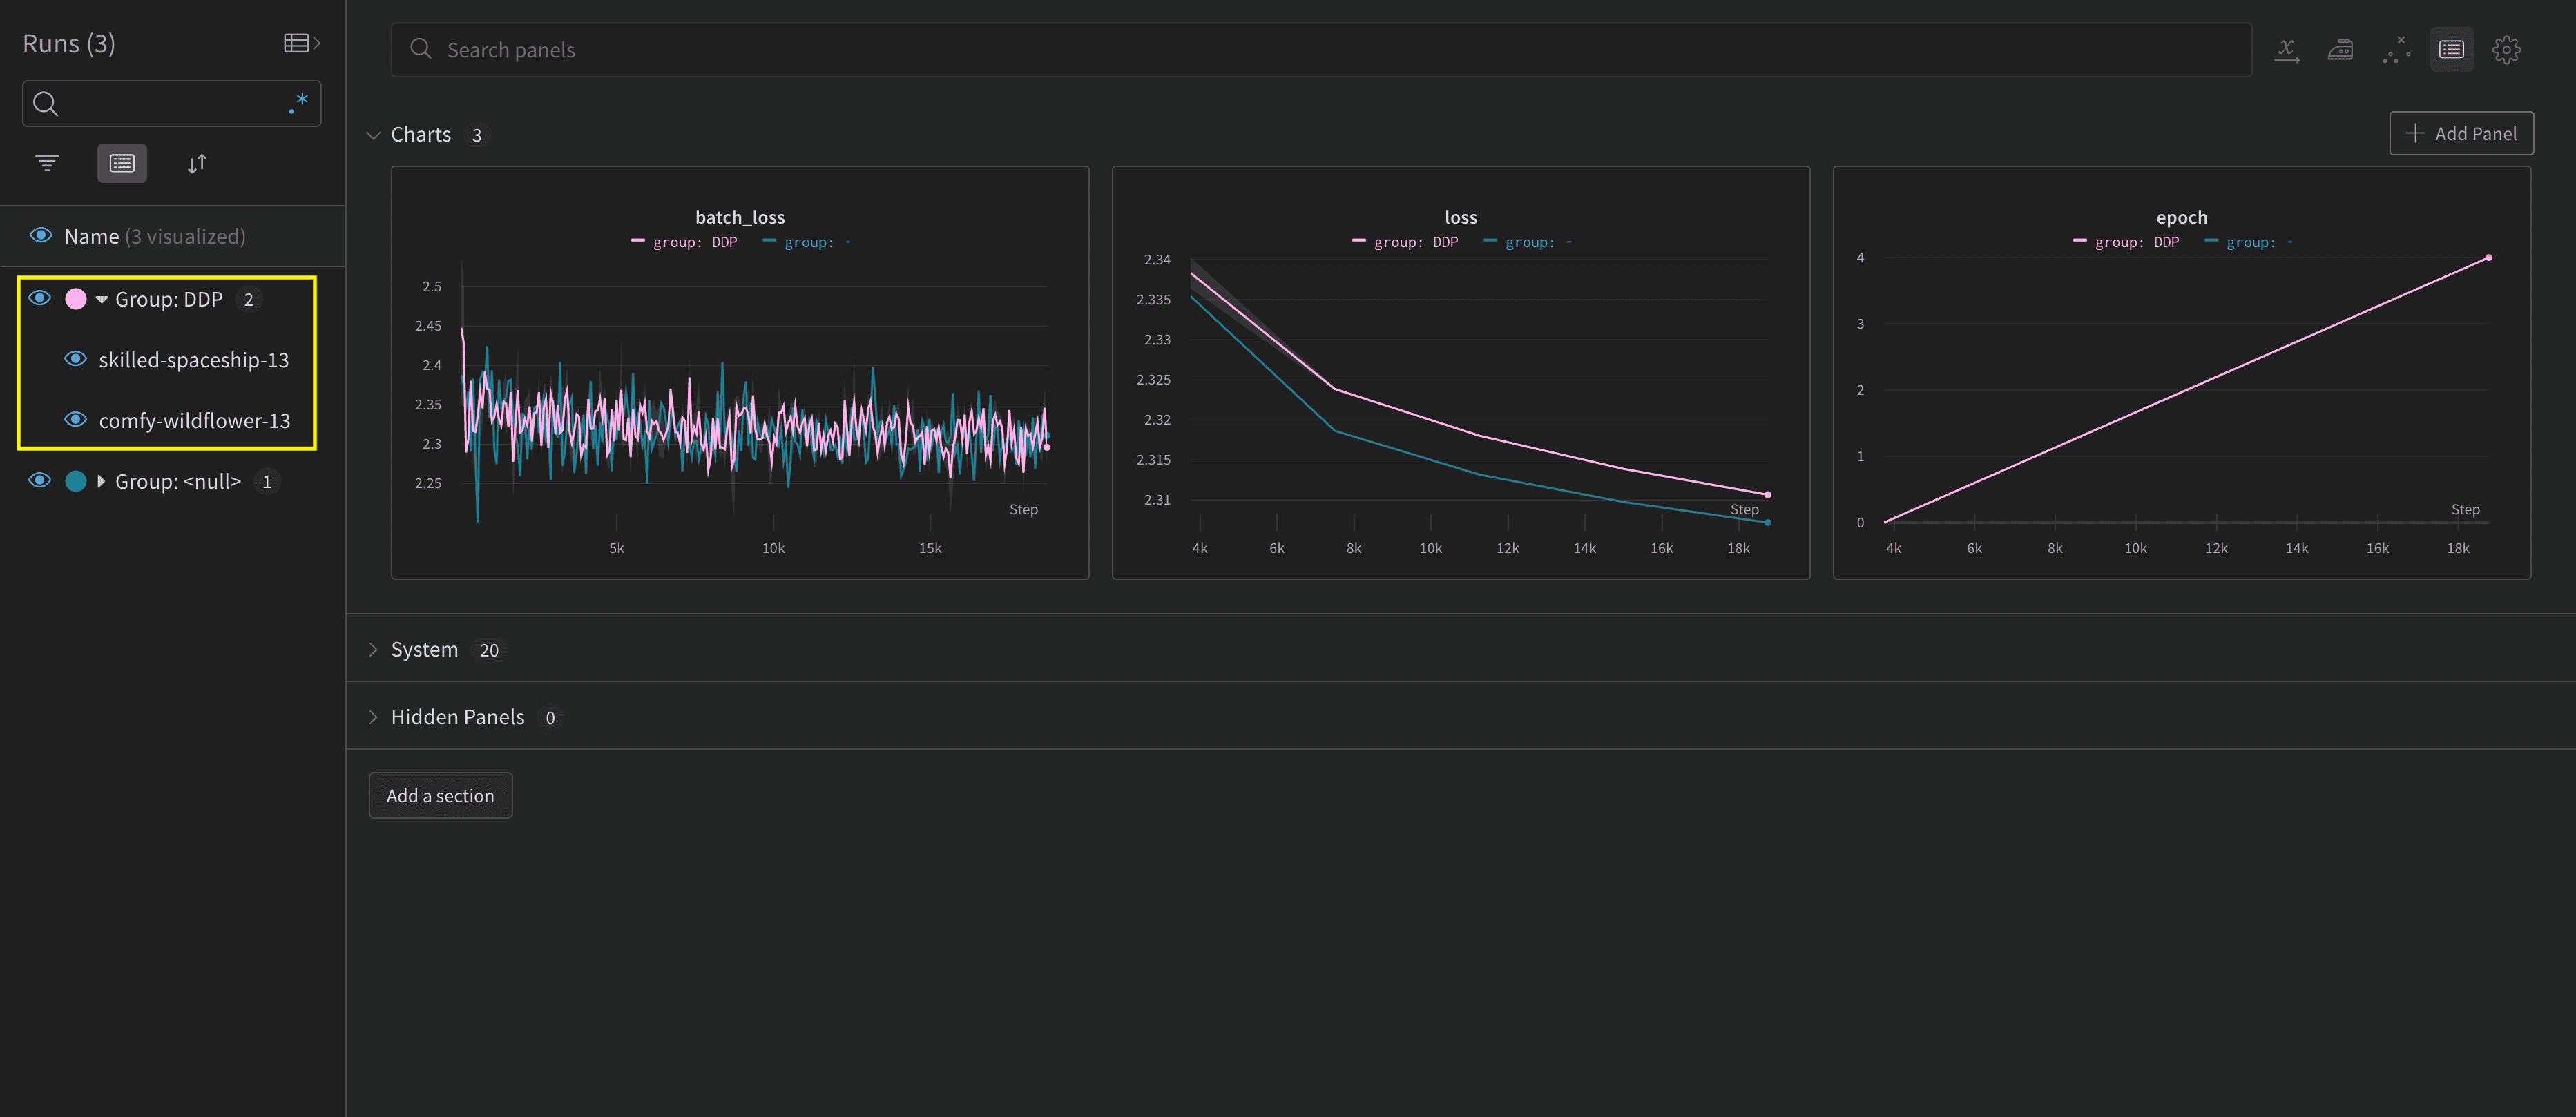 L’image précédente montre le tableau de bord de l’interface de l’application W\&B. La barre latérale affiche deux expériences : l’une intitulée 'null', l’autre (encadrée en jaune) nommée 'DPP'. Si vous développez le groupe (en sélectionnant la liste déroulante Group), vous verrez les runs W\&B associés à cette expérience.
Organiser les runs distribués
Définissez le paramètre `job_type` lors de l’initialisation de W\&B (`wandb.init(job_type='type-name')`) pour classer vos nœuds selon leur fonction. Par exemple, vous pouvez disposer d’un nœud principal chargé de la coordination et de plusieurs nœuds de calcul qui remontent des données. Vous pouvez alors définir `job_type` sur `main` pour le nœud principal de coordination et sur `worker` pour les nœuds de calcul :
```python theme={"system"}
# Nœud de coordination principal
with wandb.init(project="", job_type="main", group="experiment_1") as run:
# Code d’entraînement
# Nœuds de calcul qui remontent les résultats
with wandb.init(project="", job_type="worker", group="experiment_1") as run:
# Code d’entraînement
```
Une fois le `job_type` défini pour vos nœuds, vous pouvez créer des [vues enregistrées](/fr/products/wandb/track/workspaces#create-a-new-saved-workspace-view) dans votre workspace pour organiser vos runs. Cliquez sur le menu **action ()** en haut à droite, puis sur **Save as new view**.
Par exemple, vous pouvez créer les vues enregistrées suivantes :
* **Vue par défaut** : exclure les nœuds de calcul pour réduire le bruit
* Cliquez sur **Filter**, puis définissez **Job Type** sur `worker`.
* Affiche uniquement vos nœuds de reporting
* **Vue Debug** : cibler les nœuds de calcul pour le dépannage
* Cliquez sur **Filter**, puis définissez **Job Type** `==` `worker` et **State** sur `IN` `crashed`.
* Affiche uniquement les nœuds de calcul qui ont planté ou qui sont en état d’erreur
* **Vue de tous les nœuds** : tout afficher en même temps
* Aucun filtre
* Utile pour une supervision globale
Pour ouvrir une vue enregistrée, cliquez sur **Workspaces** dans la barre latérale du projet, puis cliquez sur le menu. Les workspaces apparaissent en haut de la liste et les vues enregistrées en bas.
Suivre tous les processus dans un seul run
Les paramètres préfixés par `x_` (comme `x_label`) sont en préversion publique. Pour nous faire part de vos commentaires, créez une [issue GitHub dans le dépôt W\&B](https://github.com/wandb/wandb).
**Exigences**
Pour suivre plusieurs processus dans un seul run, vous devez disposer des éléments suivants :
* SDK Python W\&B version `v0.19.9` ou ultérieure.
* serveur W\&B v0.68 ou ultérieur.
Cette approche repose sur un nœud principal et un ou plusieurs nœuds de calcul. Avant de démarrer le job distribué, générez un ID de run unique et configurez chaque processus pour qu’il utilise cet ID. Pendant l’entraînement, chaque nœud de calcul journalise dans le même ID de run que le nœud principal. W\&B agrège les métriques de tous les nœuds et les affiche dans l’interface de l’application W\&B.
Sur le nœud principal, initialisez un run W\&B avec [`wandb.init()`](/fr/products/wandb/ref/python/functions/init). Passez au paramètre `settings` un objet `wandb.Settings` (`wandb.init(settings=wandb.Settings()`) comportant les éléments suivants :
1. Le paramètre `mode` défini sur `"shared"` pour activer le mode partagé.
2. Un libellé unique pour [`x_label`](https://github.com/wandb/wandb/blob/main/wandb/sdk/wandb_settings.py#L638). La valeur que vous indiquez pour `x_label` vous permet d’identifier le nœud d’où proviennent les données dans les journaux et les métriques système de l’interface de l’application W\&B. Si vous ne l’indiquez pas, W\&B génère un libellé à partir du nom d’hôte et d’un hachage aléatoire.
3. Définissez le paramètre [`x_primary`](https://github.com/wandb/wandb/blob/main/wandb/sdk/wandb_settings.py#L660) sur `True` pour indiquer qu’il s’agit du nœud principal.
4. Vous pouvez également fournir une liste d’index de GPU (\[0,1,2]) à `x_stats_gpu_device_ids` pour indiquer les GPU dont W\&B doit suivre les métriques. Si vous ne fournissez pas de liste, W\&B suit les métriques de tous les GPU de la machine.
Définissez la variable d’environnement `WANDB_RUN_ID` sur l’ID de run généré avant le démarrage de chaque processus. W\&B lit automatiquement `WANDB_RUN_ID` lorsque le processus appelle `wandb.init()`.
`x_primary=True` distingue un nœud principal des nœuds de calcul. Seuls les nœuds principaux téléversent les fichiers partagés entre les nœuds, tels que les fichiers de configuration, la télémétrie, etc. Les nœuds de calcul ne téléversent pas ces fichiers.
Pour chaque nœud de calcul, initialisez un run W\&B avec [`wandb.init()`](/fr/products/wandb/ref/python/functions/init) et fournissez les éléments suivants :
1. Un objet `wandb.Settings` passé au paramètre `settings` (`wandb.init(settings=wandb.Settings()`) comportant :
* Le paramètre `mode` défini sur `"shared"` pour activer le mode partagé.
* Un libellé unique pour `x_label`. La valeur que vous indiquez pour `x_label` vous permet d’identifier le nœud d’où proviennent les données dans les journaux et les métriques système de l’interface de l’application W\&B. Si vous ne l’indiquez pas, W\&B génère un libellé à partir du nom d’hôte et d’un hachage aléatoire.
* Définissez le paramètre `x_primary` sur `False` pour indiquer qu’il s’agit d’un nœud de calcul.
2. Avant le démarrage du processus de calcul, définissez `WANDB_RUN_ID` sur l’ID de run généré utilisé par le nœud principal.
3. Vous pouvez également définir [`x_update_finish_state`](https://github.com/wandb/wandb/blob/main/wandb/sdk/wandb_settings.py#L772) sur `False`. Cela empêche les nœuds secondaires de faire passer prématurément l’[état du run](/fr/products/wandb/runs/run-states#run-states) à `finished`, de sorte que l’état du run reste cohérent et géré par le nœud principal.
* Utilisez la même entity et le même projet pour tous les nœuds. Vous vous assurez ainsi que le bon ID de run est trouvé.
* Générez l’ID de run avant de démarrer le job distribué. Utilisez votre lanceur, votre planificateur ou votre framework d’orchestration pour définir `WANDB_RUN_ID` pour chaque processus.
* Configurez les variables d’environnement W\&B avant le démarrage de chaque processus. Évitez de modifier `os.environ` à l’exécution, car le SDK W\&B risque de ne pas détecter la modification.
La façon de générer et de distribuer l’ID de run dépend du framework que vous utilisez pour orchestrer les nœuds. Ce guide ne fournit pas d’exemple de lanceur générique. Les extraits suivants montrent la configuration de W\&B dans chaque processus, une fois que votre couche d’orchestration a défini `WANDB_RUN_ID`.
L’exemple suivant initialise le run sur le nœud principal :
```python theme={"system"}
import wandb
entity = "your-entity"
project = "your-project"
# Initialiser un run sur le nœud principal
with wandb.init(
entity=entity,
project=project,
settings=wandb.Settings(
x_label="rank_0",
mode="shared",
x_primary=True,
x_stats_gpu_device_ids=[0, 1], # (Facultatif) Suivre uniquement les métriques des GPU 0 et 1
)
) as run:
# Insérer ici la logique du nœud principal
```
L’exemple suivant présente la configuration correspondante pour un nœud de calcul. Définissez le rank sur un identifiant unique du worker, basé sur votre framework d’orchestration.
```python theme={"system"}
import wandb
entity = "your-entity"
project = "your-project"
rank = 1
# Initialiser un run sur un nœud de calcul.
# W&B lit automatiquement WANDB_RUN_ID dans l’environnement du processus worker.
with wandb.init(
entity=entity, # Utiliser la même entity que le nœud principal
project=project, # Utiliser le même projet que le nœud principal
settings=wandb.Settings(
x_label=f"rank_{rank}",
mode="shared",
x_primary=False,
x_update_finish_state=False,
),
) as run:
# Logique du nœud de calcul
```
Dans un déploiement distribué, les nœuds de calcul peuvent s’exécuter sur des machines distinctes.
Consultez le rapport [Distributed Training with Shared Mode](https://forge.coreweave.com/wandb/dimaduev/simple-cnn-ddp/reports/Distributed-Training-with-Shared-Mode--VmlldzoxMTI0NTE1NA) pour un exemple complet montrant comment entraîner un modèle sur un cluster Kubernetes multinœud et multi-GPU dans GKE.
Affichez les journaux de console des processus multinœuds dans le projet dans lequel le run journalise ses données :
1. Accédez au projet qui contient le run.
2. Cliquez sur l’onglet **Runs** dans la barre latérale du projet.
3. Cliquez sur le run que vous souhaitez afficher.
4. Cliquez sur l’onglet **Logs** dans la barre latérale du projet.
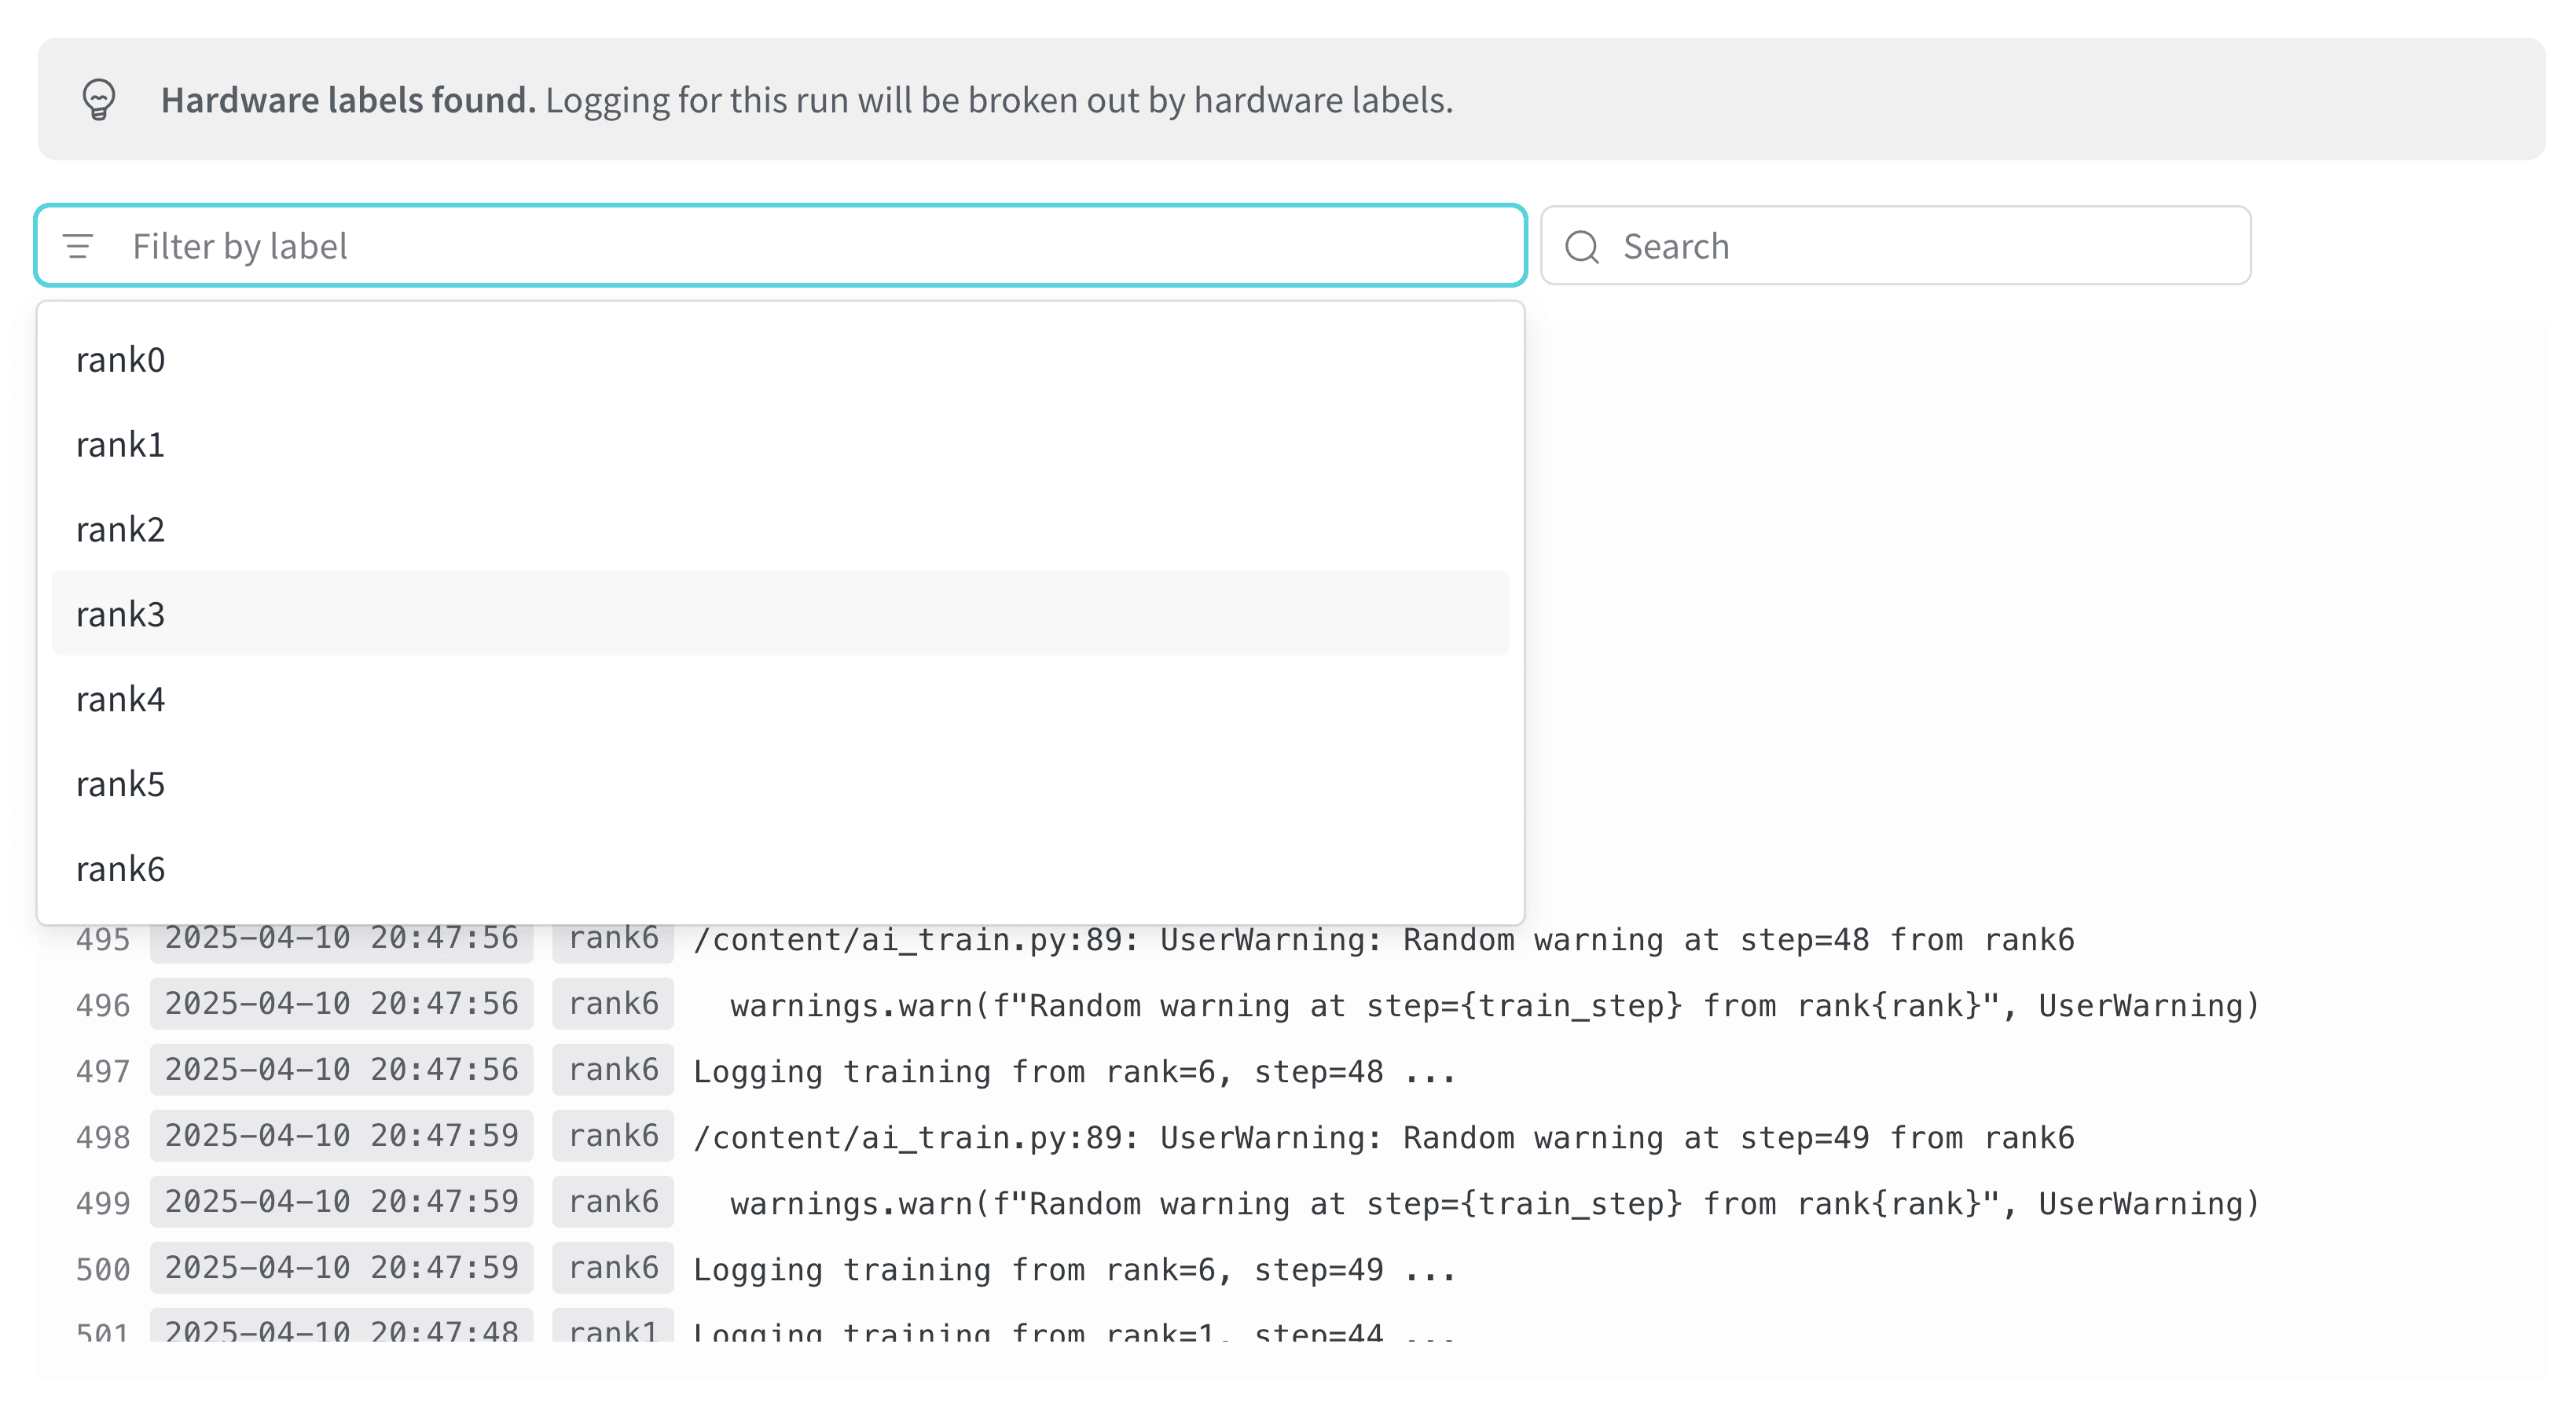
Vous pouvez filtrer les journaux de console en fonction des libellés que vous fournissez pour `x_label`, à l’aide de la barre de recherche située en haut de la page des journaux de console. Par exemple, l’image suivante montre les options de filtrage disponibles si les valeurs `rank0`, `rank1`, `rank2`, `rank3`, `rank4`, `rank5` et `rank6` sont fournies à `x_label`.\`
 Pour plus d’informations, consultez [Journaux de console](/fr/products/wandb/app/console-logs).
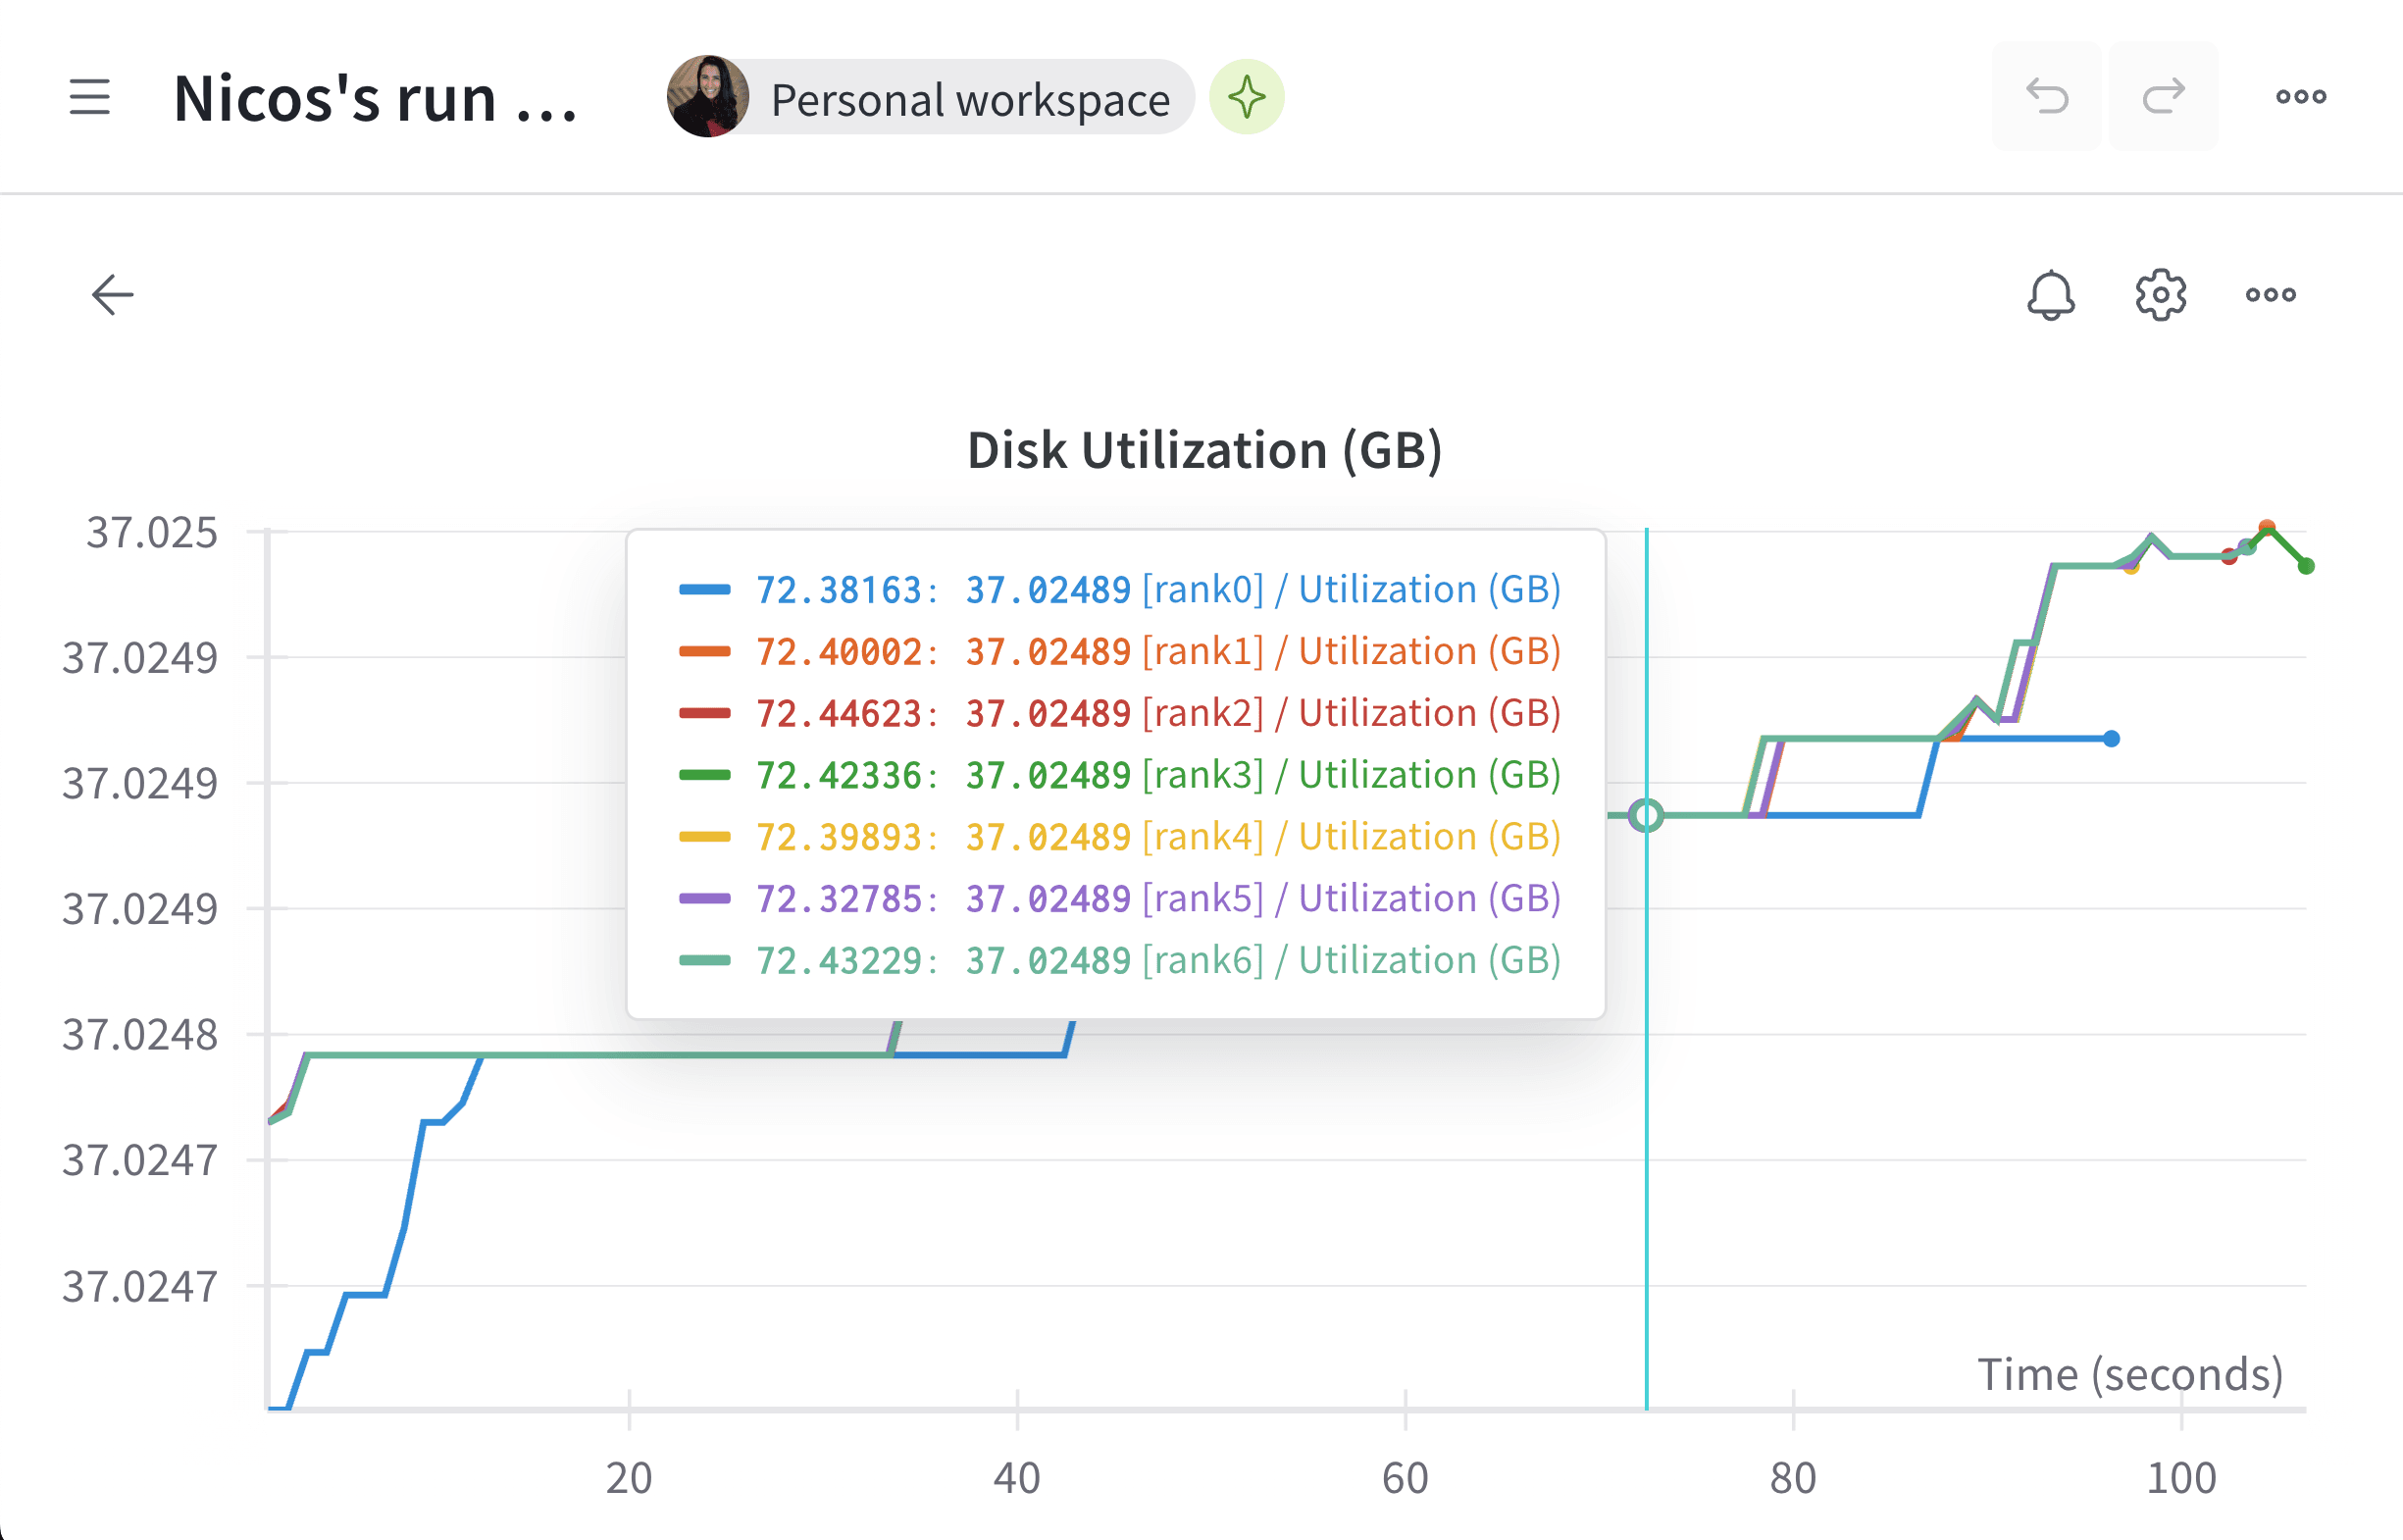
W\&B agrège les métriques système de tous les nœuds et les affiche dans l’interface de l’application W\&B. Par exemple, l’image suivante montre un exemple de tableau de bord présentant les métriques système de plusieurs nœuds. Chaque nœud possède un libellé unique (`rank_0`, `rank_1`, `rank_2`) que vous spécifiez dans le paramètre `x_label`.
 Consultez [Graphiques en courbes](/fr/products/wandb/app/features/panels/line-plot) pour savoir comment personnaliser les panneaux de graphique linéaire.
Exemples de cas d’utilisation
Les extraits de code suivants illustrent des scénarios courants d’utilisation distribuée avancée.
Processus lancé avec spawn
Utilisez la méthode `wandb.setup()`dans votre fonction principale si vous démarrez un run dans un processus créé avec spawn :
```python theme={"system"}
import multiprocessing as mp
def do_work(n):
with wandb.init(config=dict(n=n)) as run:
run.log(dict(this=n * n))
def main():
wandb.setup()
pool = mp.Pool(processes=4)
pool.map(do_work, range(4))
if __name__ == "__main__":
main()
```
Partager un run
Pour partager des runs entre plusieurs processus, passez un objet run en argument :
```python theme={"system"}
def do_work(run):
with wandb.init() as run:
run.log(dict(this=1))
def main():
run = wandb.init()
p = mp.Process(target=do_work, kwargs=dict(run=run))
p.start()
p.join()
run.finish() # marquer le run comme terminé
if __name__ == "__main__":
main()
```
W\&B ne peut pas garantir l’ordre de journalisation. La synchronisation incombe à l’auteur du script.
Dépannage
Deux problèmes courants peuvent survenir lorsque vous utilisez W\&B avec l'entraînement distribué :
1. **Blocage au début de l'entraînement** - Un processus `wandb` peut se bloquer si le multiprocessing de `wandb` interfère avec celui de l'entraînement distribué.
2. **Blocage à la fin de l'entraînement** - Une tâche d'entraînement peut se bloquer si le processus `wandb` ne sait pas à quel moment se terminer. Appelez l'API `wandb.Run.finish()` à la fin de votre script Python pour indiquer à W\&B que le run est terminé. L'API `wandb.Run.finish()` achève le téléversement des données et entraîne l'arrêt de W\&B.
W\&B recommande d'utiliser la commande `wandb service` pour améliorer la fiabilité de vos jobs distribués. Ces deux problèmes d'entraînement se rencontrent fréquemment dans les versions du SDK W\&B où wandb service n'est pas disponible.
Activer le service W\&B
Selon la version du SDK W\&B que vous utilisez, le service W\&B est peut-être déjà activé par défaut.
SDK W\&B 0.13.0 et versions ultérieures
Le service W\&B est activé par défaut à partir de la version `0.13.0` du SDK W\&B.
SDK W\&B 0.12.5 et versions ultérieures
Modifiez votre script Python pour activer le service W\&B avec le SDK W\&B 0.12.5 ou version ultérieure. Utilisez la méthode `wandb.require()` en lui passant la chaîne `"service"` dans votre fonction principale :
```python theme={"system"}
if __name__ == "__main__":
main()
def main():
wandb.require("service")
# placez-ici-le-reste-de-votre-script
```
Pour une expérience optimale, nous vous recommandons de passer à la dernière version.
**SDK W\&B 0.12.4 et versions antérieures**
Si vous utilisez le SDK W\&B en version 0.12.4 ou antérieure, définissez plutôt la variable d’environnement `WANDB_START_METHOD` sur `"thread"` afin d’utiliser le multithreading.