> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Évaluez des modèles avec W&B Weave et les tableaux W&B
> Découvrez comment évaluer des modèles de machine learning à l’aide de W&B Weave et des tableaux W&B.
Évaluer des modèles avec Weave
[W\&B Weave](/fr/products/wandb/weave) est une boîte à outils spécialement conçue pour évaluer les LLM et les applications d’IA générative. Weave offre des fonctionnalités d’évaluation complètes, notamment des évaluateurs, des juges et un traçage détaillé, pour vous aider à comprendre et à améliorer les performances de vos modèles. Weave s’intègre à W\&B Models, ce qui vous permet d’évaluer les modèles stockés dans votre registre de modèles.
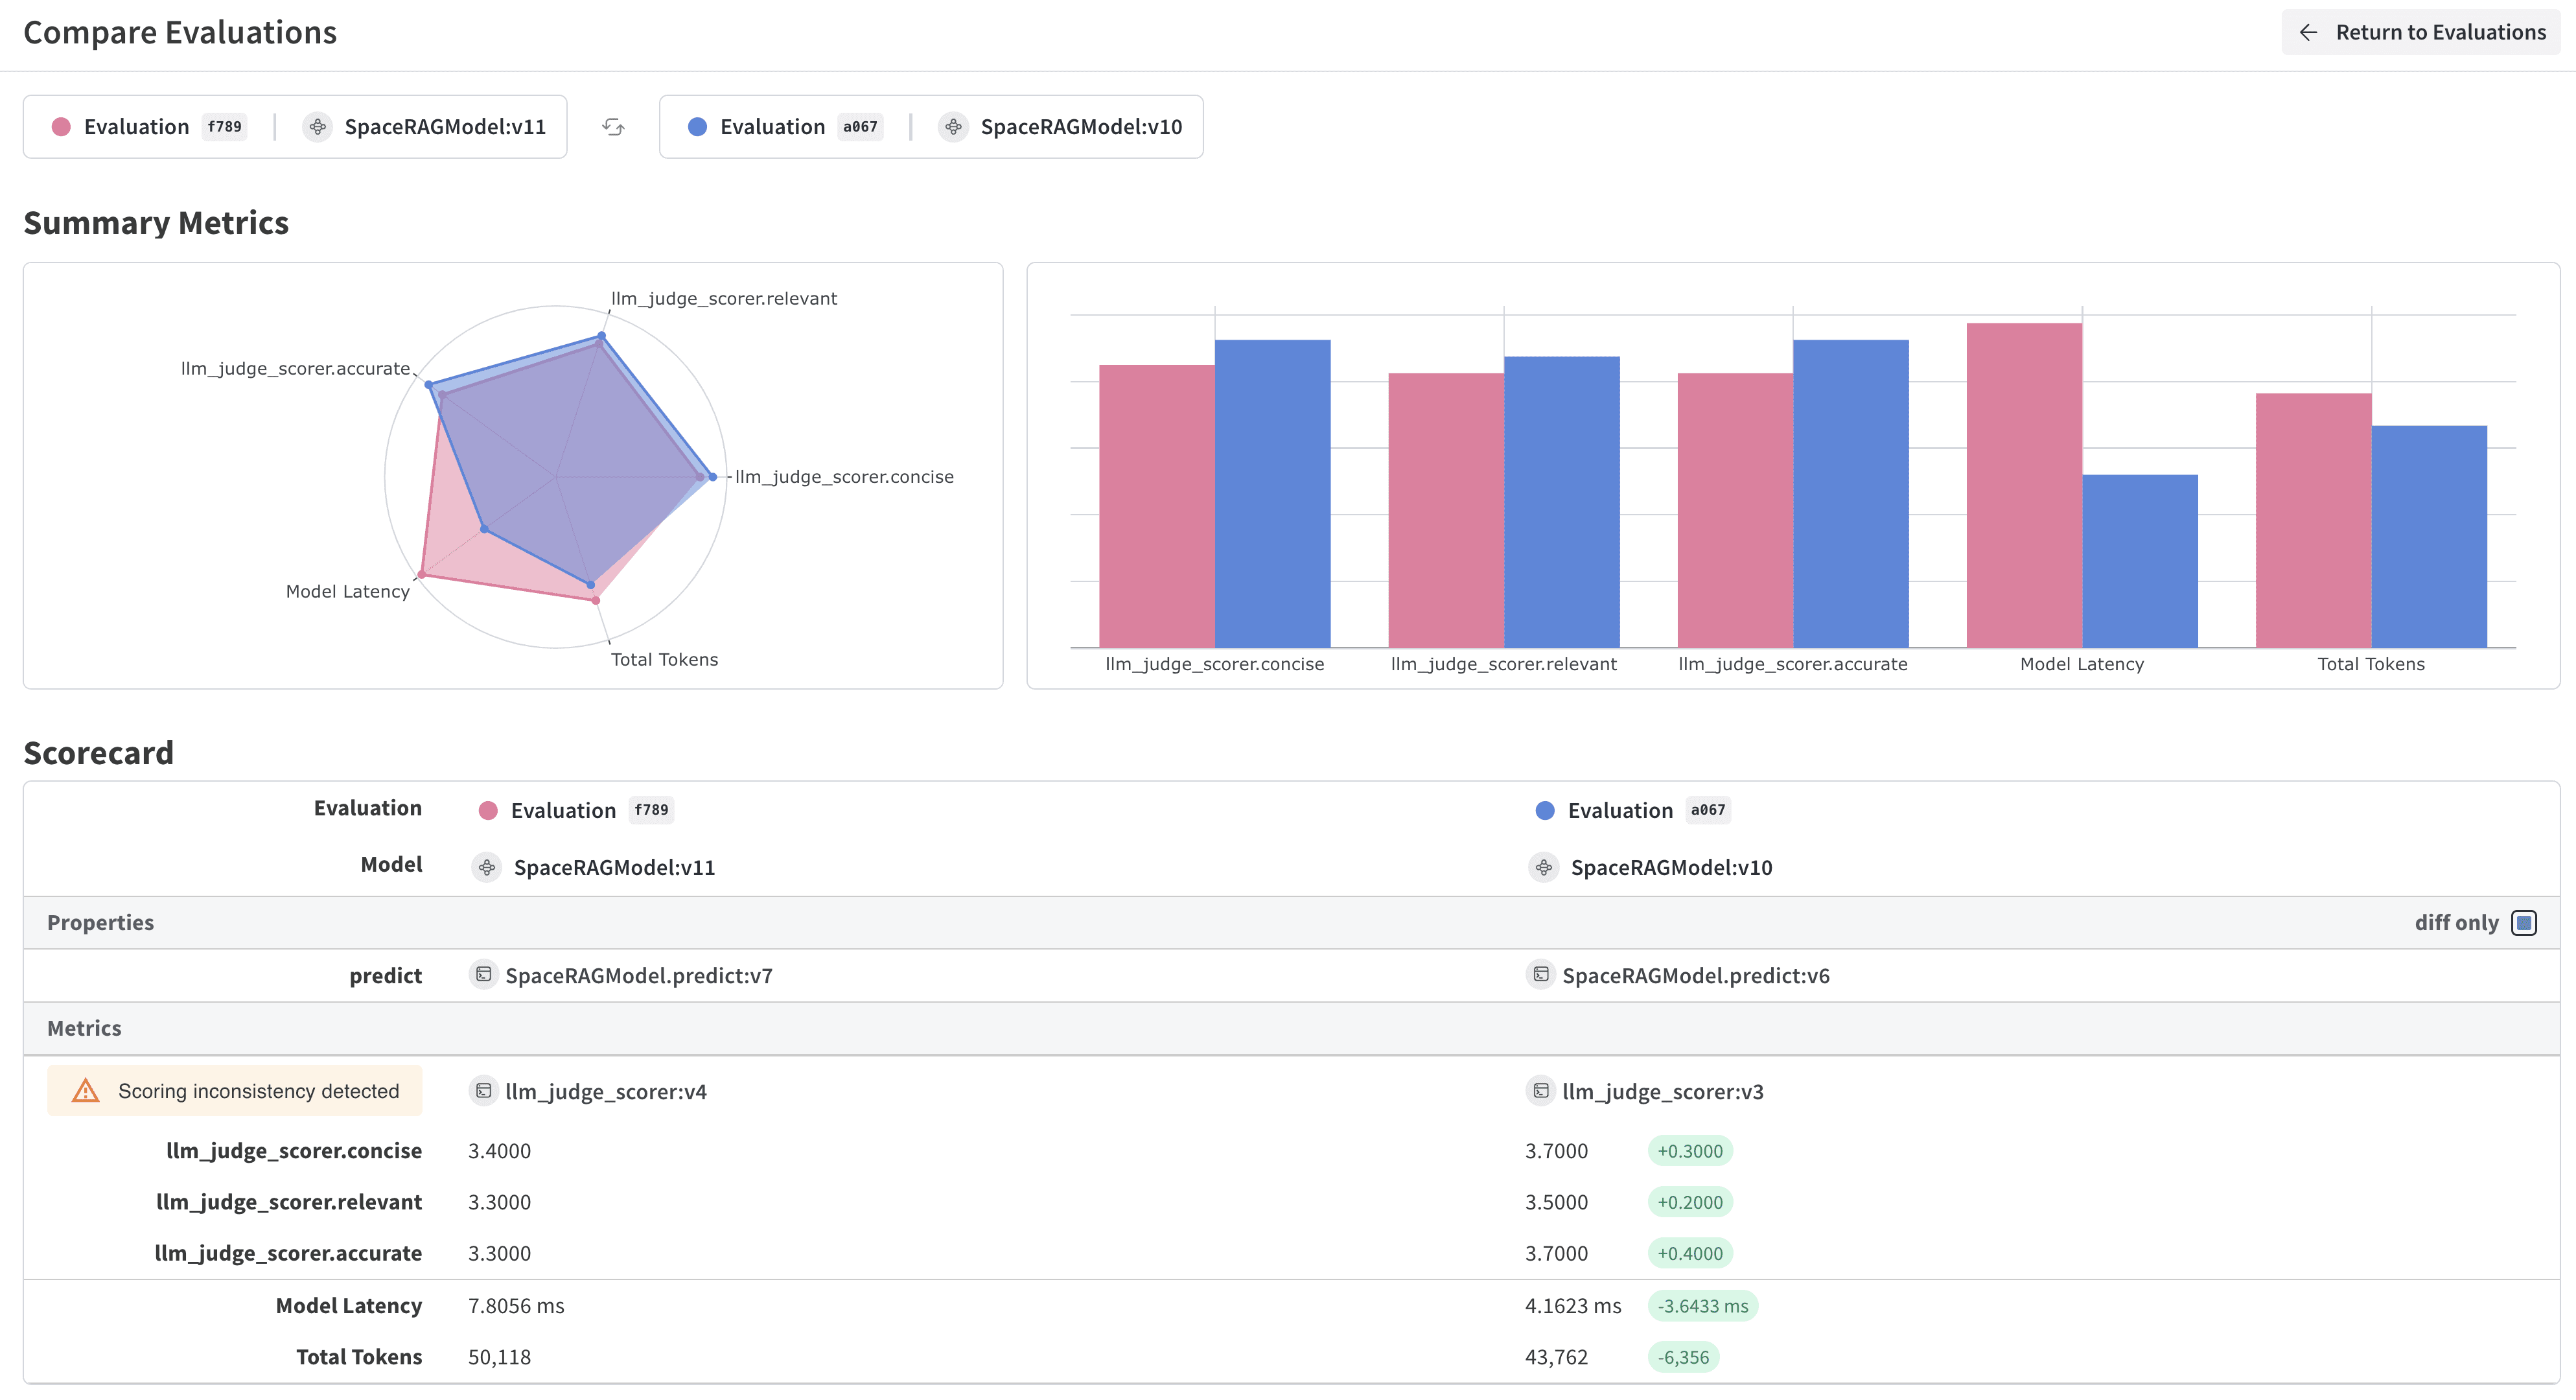
Principales fonctionnalités pour l’évaluation des modèles
* **Évaluateurs et juges** : métriques d’évaluation prédéfinies et personnalisées pour mesurer la précision, la pertinence, la cohérence et bien plus encore
* **Jeux de données d’évaluation** : jeux de test structurés avec vérité terrain pour une évaluation systématique
* **Gestion des versions des modèles** : suivez et comparez les différentes versions de vos modèles
* **Traçage détaillé** : déboguez le comportement de vos modèles grâce à des traces complètes des entrées et des sorties
* **Suivi des coûts** : surveillez les coûts d’API et l’utilisation des jetons sur l’ensemble de vos évaluations
Premiers pas : évaluer un modèle depuis le registre
Téléchargez un modèle depuis W\&B Models Registry et évaluez-le avec Weave :
```python theme={"system"}
import weave
import wandb
from typing import Any
# Initialiser Weave
weave.init("your-entity/your-project")
# Définir un ChatModel chargé depuis le registre
class ChatModel(weave.Model):
model_name: str
def model_post_init(self, __context):
# Télécharger le modèle depuis le registre de modèles W&B
with wandb.init(project="your-project", job_type="model_download") as run:
artifact = run.use_artifact(self.model_name)
self.model_path = artifact.download()
# Initialiser votre modèle ici
@weave.op()
async def predict(self, query: str) -> str:
# Votre logique d’inférence
return self.model.generate(query)
# Créer le jeu de données d’évaluation
dataset = weave.Dataset(name="eval_dataset", rows=[
{"input": "What is the capital of France?", "expected": "Paris"},
{"input": "What is 2+2?", "expected": "4"},
])
# Définir les évaluateurs
@weave.op()
def exact_match_scorer(expected: str, output: str) -> dict:
return {"correct": expected.lower() == output.lower()}
# Lancer l’évaluation
model = ChatModel(model_name="wandb-entity/registry-name/model:version")
evaluation = weave.Evaluation(
dataset=dataset,
scorers=[exact_match_scorer]
)
results = await evaluation.evaluate(model)
```
Intégrer les évaluations Weave à W\&B Models
La démo [Models and Weave Integration Demo](/fr/products/wandb/weave/cookbooks/Models_and_Weave_Integration_Demo) présente le flux de travail complet pour :
1. **Charger des modèles depuis le registre** : téléchargez des modèles affinés stockés dans le W\&B Models Registry
2. **Créer des pipelines d’évaluation** : concevez des évaluations complètes avec des évaluateurs personnalisés
3. **Journaliser les résultats dans W\&B** : associez les métriques d’évaluation aux runs de vos modèles
4. **Versionner les modèles évalués** : réenregistrez les modèles améliorés dans le registre
Journalisez les résultats d’évaluation à la fois dans Weave et dans W\&B Models :
```python theme={"system"}
# Exécuter l’évaluation avec le suivi W&B
with weave.attributes({"wandb-run-id": wandb.run.id}):
summary, call = await evaluation.evaluate.call(evaluation, model)
# Consigner les métriques dans W&B Models
wandb.run.log(summary)
wandb.run.config.update({
"weave_eval_url": f"https://wandb.ai/{entity}/{project}/r/call/{call.id}"
})
```
Fonctionnalités avancées de Weave
Évaluateurs et juges personnalisés
Créez des métriques d’évaluation avancées, adaptées à votre cas d’usage :
```python theme={"system"}
@weave.op()
def llm_judge_scorer(expected: str, output: str, judge_model) -> dict:
prompt = f"Is this answer correct? Expected: {expected}, Got: {output}"
judgment = await judge_model.predict(prompt)
return {"judge_score": judgment}
```
Évaluations par lots
Évaluez plusieurs versions ou configurations d’un modèle :
```python theme={"system"}
models = [
ChatModel(model_name="model:v1"),
ChatModel(model_name="model:v2"),
]
for model in models:
results = await evaluation.evaluate(model)
print(f"{model.model_name}: {results}")
```
Étapes suivantes
* [Tutoriel complet sur l’évaluation avec Weave](/fr/products/wandb/weave/tutorial-eval)
* [Exemple d’intégration entre Models et Weave](/fr/products/wandb/weave/cookbooks/Models_and_Weave_Integration_Demo)
Évaluer des modèles avec des tableaux
Utilisez les tableaux W\&B pour :
* **Comparer les prédictions des modèles** : comparez côte à côte les performances de différents modèles sur le même jeu de test
* **Suivre l’évolution des prédictions** : observez comment les prédictions évoluent au fil des époques d’entraînement ou des versions du modèle
* **Analyser les erreurs** : filtrez et interrogez les données pour repérer les exemples fréquemment mal classés et les schémas d’erreur récurrents
* **Visualiser des médias enrichis** : affichez des images, de l’audio, du texte et d’autres types de médias à côté des prédictions et des métriques
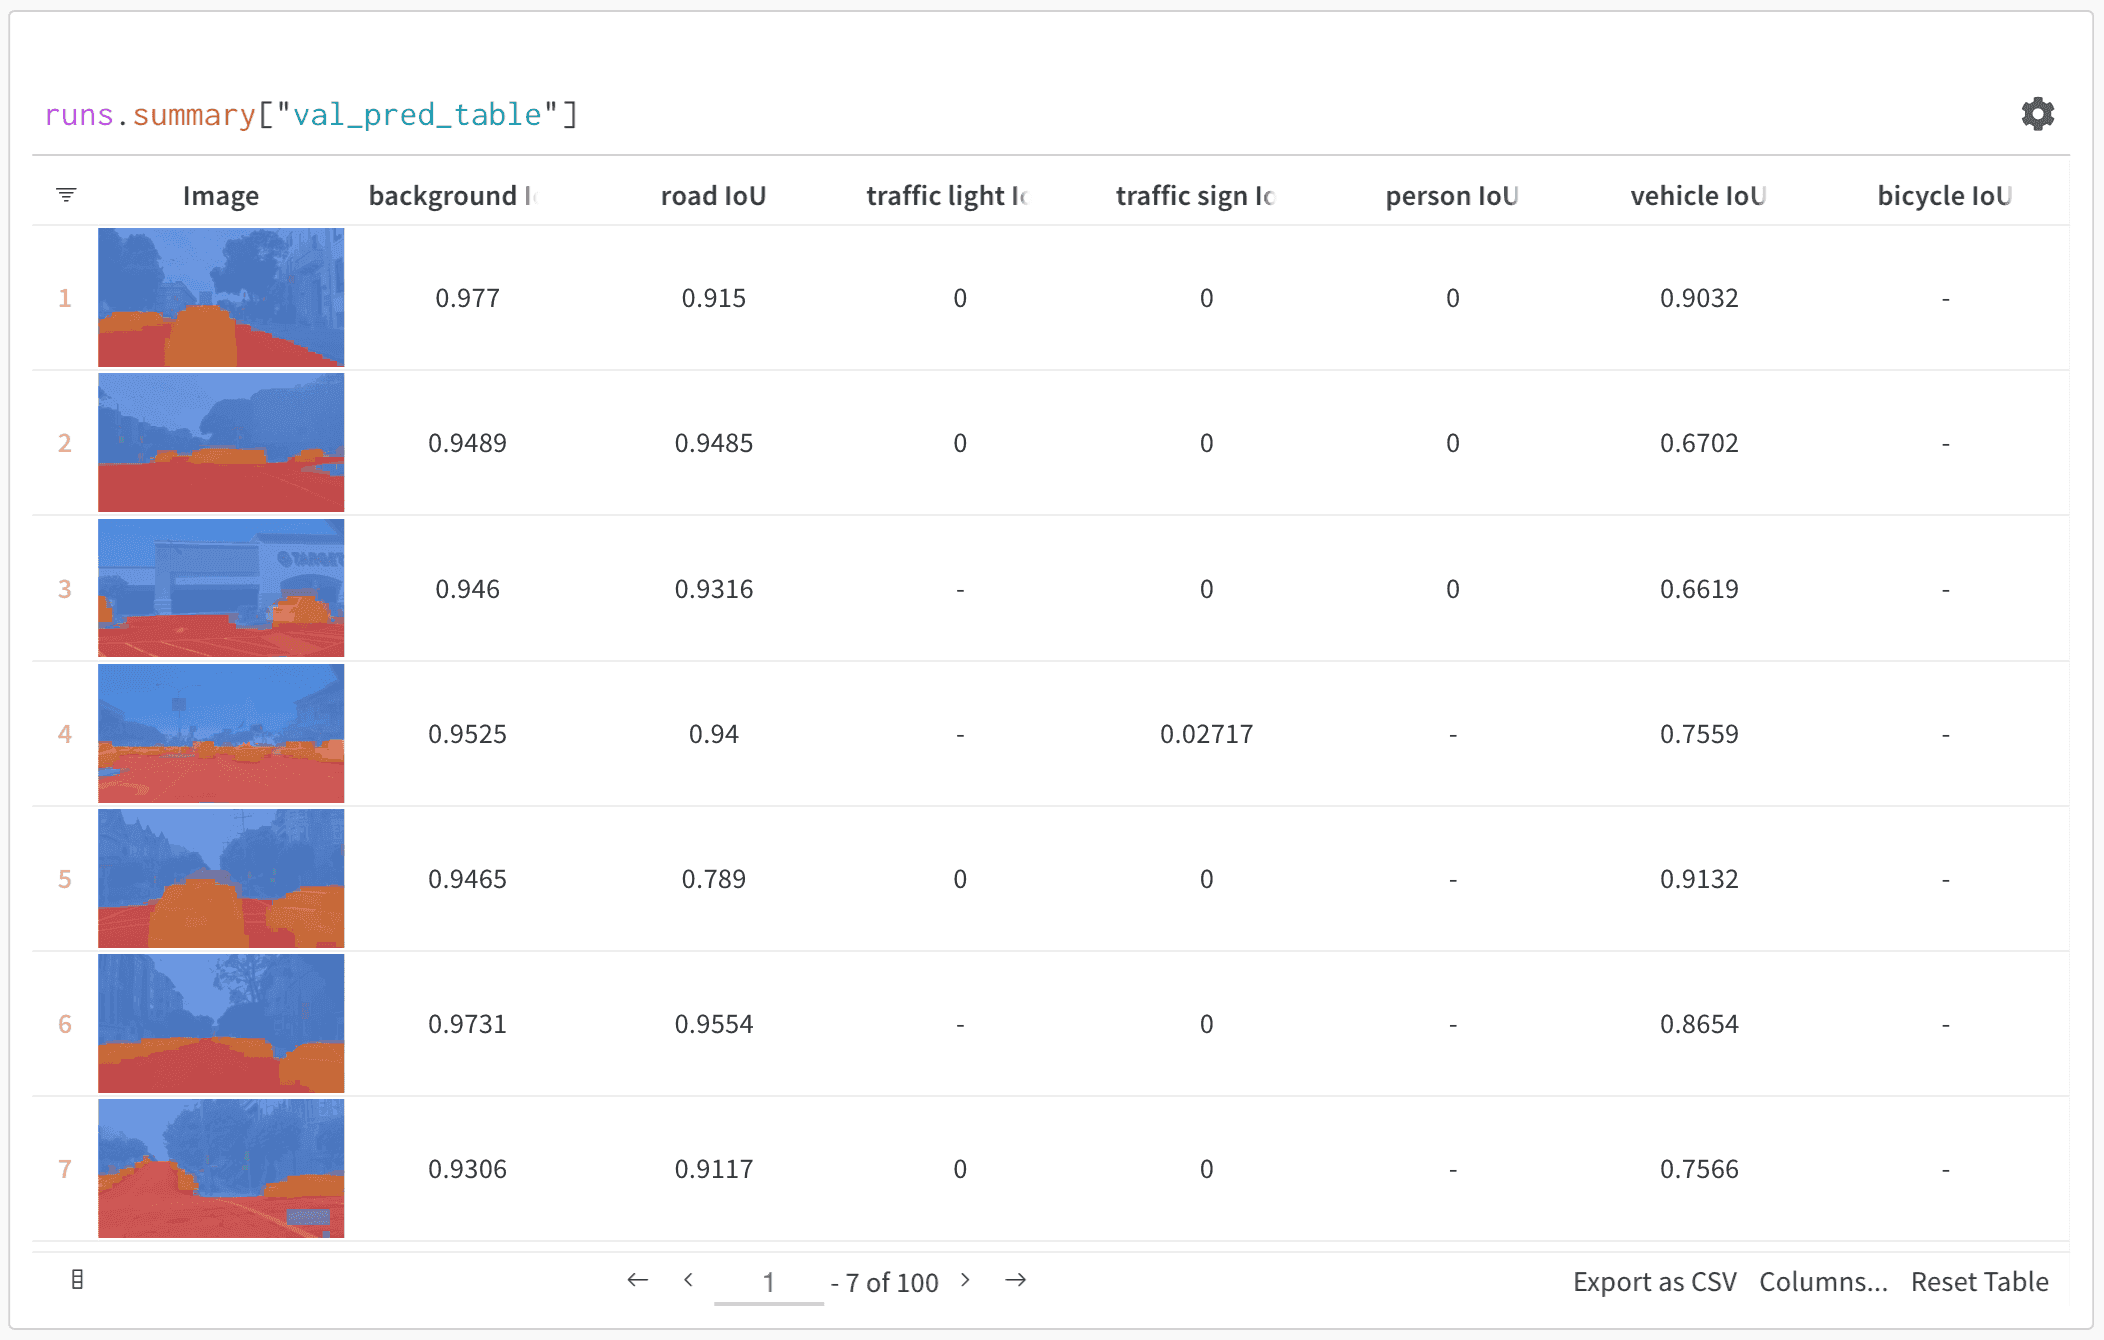
Exemple de base : journaliser les résultats d’évaluation
```python theme={"system"}
import wandb
# Initialiser un run
run = wandb.init(project="model-evaluation")
# Créer un tableau contenant les résultats de l’évaluation
columns = ["id", "input", "ground_truth", "prediction", "confidence", "correct"]
eval_table = wandb.Table(columns=columns)
# Ajouter les données d’évaluation
for idx, (input_data, label) in enumerate(test_dataset):
prediction = model(input_data)
confidence = prediction.max()
predicted_class = prediction.argmax()
eval_table.add_data(
idx,
wandb.Image(input_data), # Journaliser des images ou d’autres médias
label,
predicted_class,
confidence,
label == predicted_class
)
# Journaliser le tableau
run.log({"evaluation_results": eval_table})
```
Flux de travail avancés avec les tableaux
Comparer plusieurs modèles
Journalisez les tableaux d’évaluation de différents modèles sous la même clé pour les comparer directement :
```python theme={"system"}
# Évaluation du modèle A
with wandb.init(project="model-comparison", name="model_a") as run:
eval_table_a = create_eval_table(model_a, test_data)
run.log({"test_predictions": eval_table_a})
# Évaluation du modèle B
with wandb.init(project="model-comparison", name="model_b") as run:
eval_table_b = create_eval_table(model_b, test_data)
run.log({"test_predictions": eval_table_b})
```
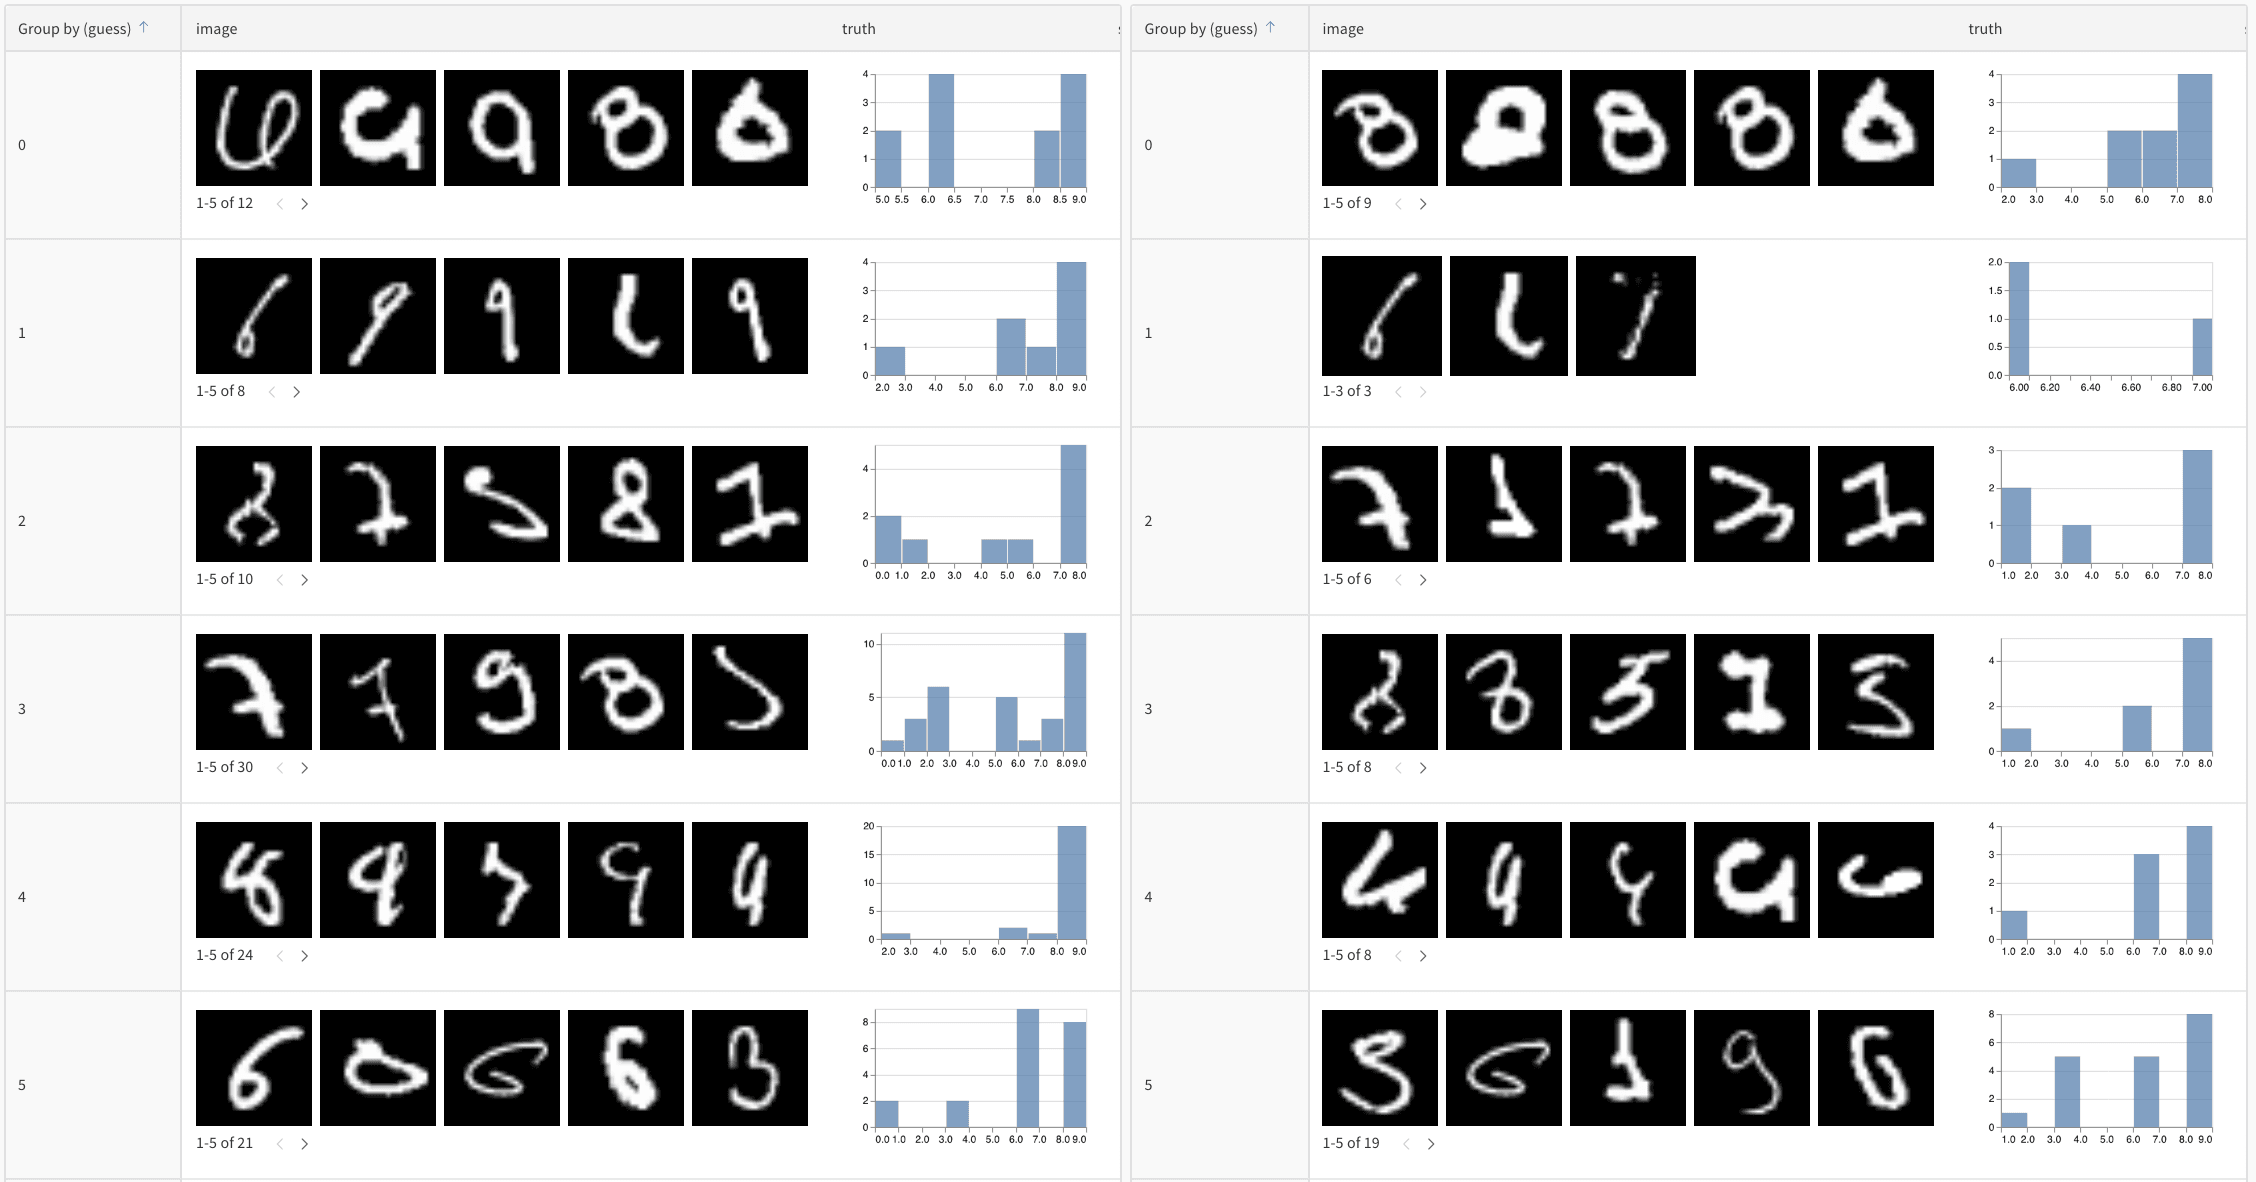
Suivre les prédictions au fil du temps
Journalisez des tableaux à différentes époques d’entraînement pour visualiser l’amélioration du modèle :
```python theme={"system"}
for epoch in range(num_epochs):
train_model(model, train_data)
# Évaluer et journaliser les prédictions de cette époque
eval_table = wandb.Table(columns=["image", "truth", "prediction"])
for image, label in test_subset:
pred = model(image)
eval_table.add_data(wandb.Image(image), label, pred.argmax())
wandb.log({f"predictions_epoch_{epoch}": eval_table})
```
Analyse interactive dans l’interface W\&B
Une fois les données journalisées, vous pouvez :
1. **Filtrer les résultats** : cliquez sur les en-têtes de colonne pour filtrer selon la précision des prédictions, des seuils de confiance ou des classes précises
2. **Comparer des tableaux** : sélectionnez plusieurs versions d’un tableau pour les comparer côte à côte
3. **Interroger les données** : utilisez la barre de requête pour trouver des motifs précis (par exemple, `"correct" = false AND "confidence" > 0.8`)
4. **Regrouper et agréger** : regroupez par classe prédite pour afficher les métriques de précision par classe
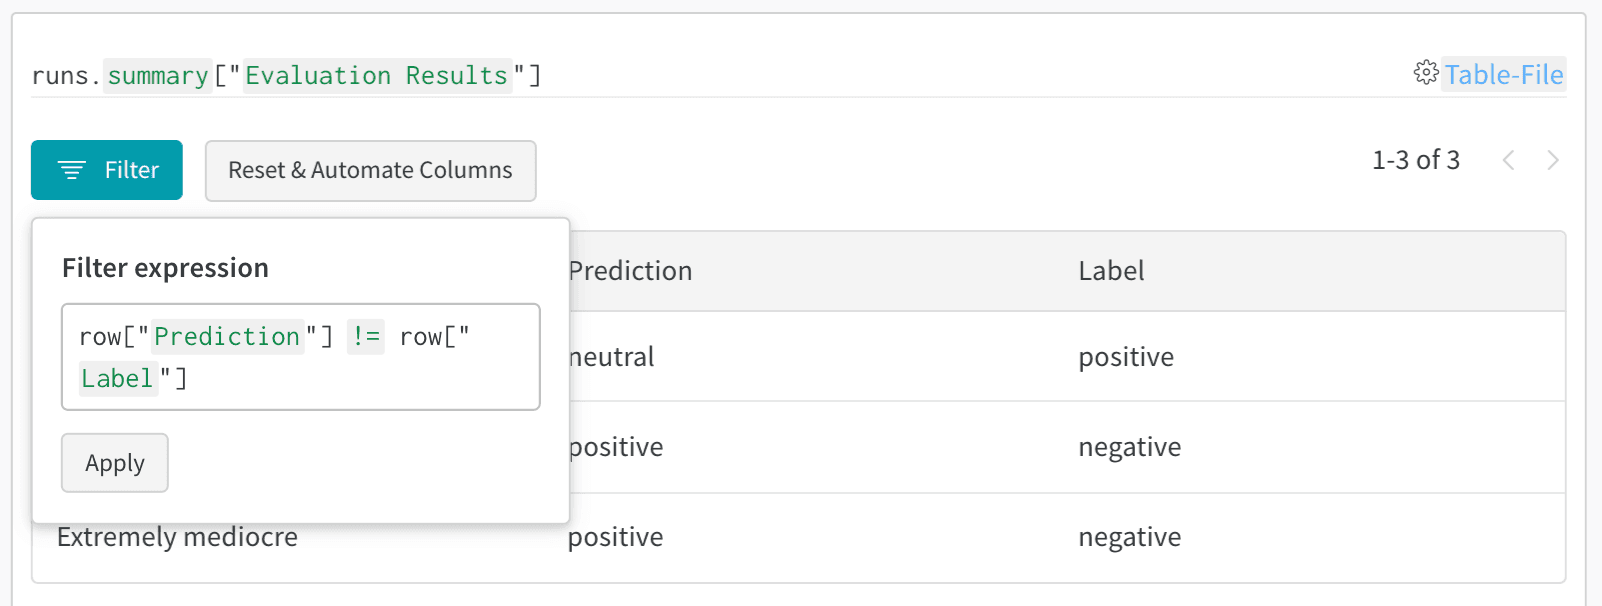
Exemple : analyse des erreurs avec des tableaux enrichis
```python theme={"system"}
# Créer un tableau modifiable pour y ajouter des colonnes d’analyse
eval_table = wandb.Table(
columns=["id", "image", "label", "prediction"],
log_mode="MUTABLE" # Permet d’ajouter des colonnes par la suite
)
# Prédictions initiales
for idx, (img, label) in enumerate(test_data):
pred = model(img)
eval_table.add_data(idx, wandb.Image(img), label, pred.argmax())
run.log({"eval_analysis": eval_table})
# Ajouter les scores de confiance pour l’analyse des erreurs
confidences = [model(img).max() for img, _ in test_data]
eval_table.add_column("confidence", confidences)
# Ajouter les types d’erreurs
error_types = classify_errors(eval_table.get_column("label"),
eval_table.get_column("prediction"))
eval_table.add_column("error_type", error_types)
run.log({"eval_analysis": eval_table})
```