> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.

# Hugging Face Transformers

> Utilisez W&B avec le Trainer de Hugging Face Transformers pour le suivi des expériences, l’enregistrement des points de contrôle du modèle et la gestion des versions des jeux de données.

export const ColabLink = ({url}) => <a href={url} target="_blank" rel="noopener noreferrer" className="colab-link">
    <svg width="20" height="20" viewBox="0 0 24 24" fill="currentColor" xmlns="http://www.w3.org/2000/svg">
      <path d="M14.25.18l.9.2.73.26.59.3.45.32.34.34.25.34.16.33.1.3.04.26.02.2-.01.13V8.5l-.05.63-.13.55-.21.46-.26.38-.3.31-.33.25-.35.19-.35.14-.33.1-.3.07-.26.04-.21.02H8.77l-.69.05-.59.14-.5.22-.41.27-.33.32-.27.35-.2.36-.15.37-.1.35-.07.32-.04.27-.02.21v3.06H3.17l-.21-.03-.28-.07-.32-.12-.35-.18-.36-.26-.36-.36-.35-.46-.32-.59-.28-.73-.21-.88-.14-1.05-.05-1.23.06-1.22.16-1.04.24-.87.32-.71.36-.57.4-.44.42-.33.42-.24.4-.16.36-.1.32-.05.24-.01h.16l.06.01h8.16v-.83H6.18l-.01-2.75-.02-.37.05-.34.11-.31.17-.28.25-.26.31-.23.38-.2.44-.18.51-.15.58-.12.64-.1.71-.06.77-.04.84-.02 1.27.05zm-6.3 1.98l-.23.33-.08.41.08.41.23.34.33.22.41.09.41-.09.33-.22.23-.34.08-.41-.08-.41-.23-.33-.33-.22-.41-.09-.41.09zm13.09 3.95l.28.06.32.12.35.18.36.27.36.35.35.47.32.59.28.73.21.88.14 1.04.05 1.23-.06 1.23-.16 1.04-.24.86-.32.71-.36.57-.4.45-.42.33-.42.24-.4.16-.36.09-.32.05-.24.02-.16-.01h-8.22v.82h5.84l.01 2.76.02.36-.05.34-.11.31-.17.29-.25.25-.31.24-.38.2-.44.17-.51.15-.58.13-.64.09-.71.07-.77.04-.84.01-1.27-.04-1.07-.14-.9-.2-.73-.25-.59-.3-.45-.33-.34-.34-.25-.34-.16-.33-.1-.3-.04-.25-.02-.2.01-.13v-5.34l.05-.64.13-.54.21-.46.26-.38.3-.32.33-.24.35-.2.35-.14.33-.1.3-.06.26-.04.21-.02.13-.01h5.84l.69-.05.59-.14.5-.21.41-.28.33-.32.27-.35.2-.36.15-.36.1-.35.07-.32.04-.28.02-.21V6.07h2.09l.14.01.21.03zm-6.47 14.25l-.23.33-.08.41.08.41.23.33.33.23.41.08.41-.08.33-.23.23-.33.08-.41-.08-.41-.23-.33-.33-.23-.41-.08-.41.08z" />
    </svg>
    Try in Colab
  </a>;

<ColabLink url="https://colab.research.google.com/github/wandb/examples/blob/master/colabs/huggingface/Optimize_Hugging_Face_models_with_Weights_&_Biases.ipynb" />

La bibliothèque [Hugging Face Transformers](https://huggingface.co/docs/transformers/index) simplifie l’utilisation de modèles de NLP comme BERT et de techniques d’entraînement comme la précision mixte et le gradient checkpointing. L’[intégration W\&B](https://huggingface.co/transformers/main_classes/callback.html#transformers.integrations.WandbCallback) y ajoute le suivi des expériences et la gestion des versions des modèles, le tout dans des tableaux de bord centralisés.

Ce guide explique comment connecter le `Trainer` de Hugging Face à W\&B. Vos runs d’entraînement consignent ensuite automatiquement les métriques, les points de contrôle du modèle et les sorties d’évaluation dans un tableau de bord centralisé. À l’issue de ce guide, vous saurez comparer des runs, enregistrer et recharger des points de contrôle de modèle depuis W\&B Artifacts, et personnaliser la journalisation selon vos propres flux de travail. Ce guide suppose que vous savez déjà entraîner des modèles avec le `Trainer` de Hugging Face Transformers.

<h2 id="quick-start">
  Démarrage rapide
</h2>

```python theme={"system"}
os.environ["WANDB_PROJECT"] = "<my-project-name>"  # nommer votre projet W&B
os.environ["WANDB_LOG_MODEL"] = "checkpoint"  # journaliser tous les points de contrôle du modèle

from transformers import TrainingArguments, Trainer

args = TrainingArguments(..., report_to="wandb")  # activer la journalisation W&B
trainer = Trainer(..., args=args)
```

<Frame>
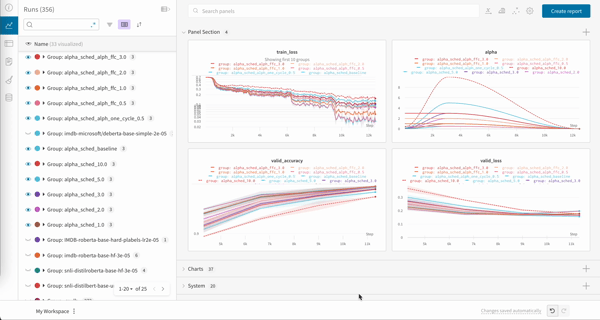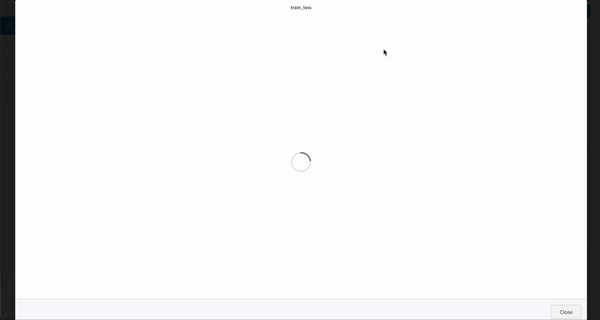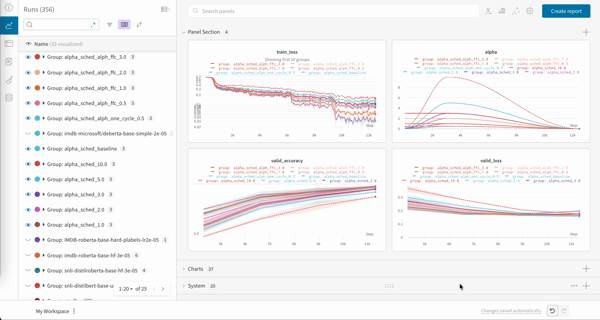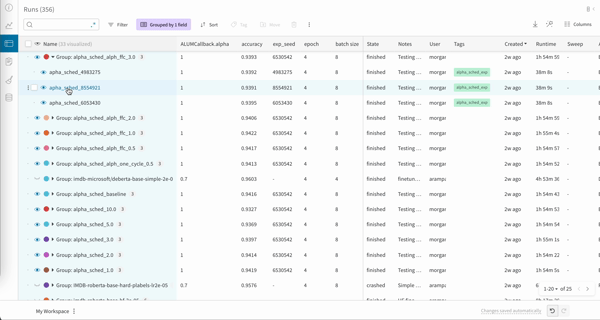
  <img src="https://mintcdn.com/coreweave-dbfa0e8d/3Dv_sw2eg8feUJlx/products/wandb/_media/huggingface_gif.gif?s=db5e1024dd0cbc0c1ea811c938358bd5" alt="Tableau de bord Hugging Face" width="600" height="320" data-path="products/wandb/_media/huggingface_gif.gif" />
</Frame>

<Note>
  Si vous préférez passer directement à un exemple de code fonctionnel, consultez ce [notebook Google Colab](https://wandb.me/hf).
</Note>

<h2 id="get-started-track-experiments">
  Premiers pas : suivre les expériences
</h2>

Cette section explique comment vous authentifier auprès de W\&B, installer la bibliothèque cliente, nommer votre projet et activer la journalisation dans votre `Trainer` afin que votre premier run d’entraînement apparaisse dans le tableau de bord W\&B.

<h3 id="sign-up-and-create-an-api-key">
  S’inscrire et créer une clé API
</h3>

Une clé API authentifie votre machine auprès de W\&B. Vous pouvez générer une clé API depuis votre profil utilisateur.

<Note>
  Pour plus de simplicité, accédez aux [Paramètres utilisateur](https://forge.coreweave.com/settings) et créez une clé API. Copiez immédiatement la clé API et enregistrez-la dans un emplacement sécurisé, par exemple un gestionnaire de mots de passe.
</Note>

1. Cliquez sur l’icône de votre profil utilisateur dans le coin supérieur droit.
2. Sélectionnez **Paramètres utilisateur**, puis faites défiler la page jusqu’à la section **API Keys**.

<h3 id="install-the-wandb-library-and-log-in">
  Installer la bibliothèque `wandb` et se connecter
</h3>

Pour installer la bibliothèque `wandb` en local et vous connecter :

<Tabs>
  <Tab title="Ligne de commande">
    1. Définissez la [variable d’environnement](/fr/products/wandb/track/environment-variables) `WANDB_API_KEY` sur votre clé API. Remplacez les valeurs entre `<>` par les vôtres :

       ```bash theme={"system"}
       export WANDB_API_KEY=<your_api_key>
       ```

    2. Installez la bibliothèque `wandb` et connectez-vous.

       ```bash theme={"system"}
       pip install wandb

       wandb login
       ```
  </Tab>

  <Tab title="Python">
    ```bash theme={"system"}
    pip install wandb
    ```

    ```python theme={"system"}
    import wandb
    wandb.login()
    ```
  </Tab>

  <Tab title="Notebook Python">
    ```notebook theme={"system"}
    !pip install wandb

    import wandb
    wandb.login()
    ```
  </Tab>
</Tabs>

Si vous utilisez W\&B pour la première fois, consultez le [guide de démarrage rapide](/fr/products/wandb/quickstart).

<h3 id="name-the-project">
  Nommer le projet
</h3>

Un projet W\&B stocke l’ensemble des graphiques, des données et des modèles journalisés par des runs associés. Nommer votre projet vous permet d’organiser votre travail et de regrouper au même endroit toutes les informations relatives à un même projet.

Pour ajouter un run à un projet, définissez la variable d’environnement `WANDB_PROJECT` sur le nom de votre projet. Le `WandbCallback` récupère le nom du projet depuis cette variable d’environnement et l’utilise lors de la configuration de votre run.

<Tabs>
  <Tab title="Ligne de commande">
    ```bash theme={"system"}
    WANDB_PROJECT=amazon_sentiment_analysis
    ```
  </Tab>

  <Tab title="Python">
    ```python theme={"system"}
    import os
    os.environ["WANDB_PROJECT"]="amazon_sentiment_analysis"
    ```
  </Tab>

  <Tab title="Notebook Python">
    ```notebook theme={"system"}
    %env WANDB_PROJECT=amazon_sentiment_analysis
    ```
  </Tab>
</Tabs>

<Note>
  Veillez à définir le nom du projet *avant* d’initialiser le `Trainer`.
</Note>

Si vous ne spécifiez pas de nom de projet, celui-ci prend par défaut la valeur `huggingface`.

<h3 id="log-your-training-runs-to-wb">
  Journaliser vos runs d’entraînement dans W\&B
</h3>

Lorsque vous définissez les arguments d’entraînement de votre `Trainer`, que ce soit dans votre code ou depuis la ligne de commande, définissez `report_to` sur `"wandb"` pour activer la journalisation avec W\&B. Sans ce paramètre, le `Trainer` n’envoie aucune donnée à W\&B.

L’argument `logging_steps` de `TrainingArguments` détermine la fréquence à laquelle les métriques d’entraînement sont téléversées vers W\&B pendant l’entraînement. Vous pouvez également nommer le run d’entraînement dans W\&B à l’aide de l’argument `run_name`.

Et voilà. Vos modèles journalisent désormais les pertes, les métriques d’évaluation, la topologie du modèle et les gradients dans W\&B pendant leur entraînement.

<Tabs>
  <Tab title="Ligne de commande">
    ```bash theme={"system"}
    python run_glue.py \     # exécuter votre script Python
      --report_to wandb \    # activer la journalisation dans W&B
      --run_name bert-base-high-lr \   # nom du run W&B (facultatif)
      # autres arguments de ligne de commande ici
    ```
  </Tab>

  <Tab title="Python">
    ```python theme={"system"}
    from transformers import TrainingArguments, Trainer

    args = TrainingArguments(
        # autres args et kwargs ici
        report_to="wandb",  # activer la journalisation dans W&B
        run_name="bert-base-high-lr",  # nom du run W&B (facultatif)
        logging_steps=1,  # fréquence de journalisation dans W&B
    )

    trainer = Trainer(
        # autres args et kwargs ici
        args=args,  # vos arguments d’entraînement
    )

    trainer.train()  # lancer l’entraînement et la journalisation dans W&B
    ```
  </Tab>
</Tabs>

<Note>
  Vous utilisez TensorFlow ? Remplacez le `Trainer` de PyTorch par le `TFTrainer` de TensorFlow.
</Note>

<h3 id="turn-on-model-checkpointing">
  Activer l’enregistrement des points de contrôle du modèle
</h3>

En plus de journaliser des métriques, vous pouvez enregistrer les poids du modèle entraîné dans W\&B afin de les versionner, de les télécharger et de les partager au sein de votre équipe.

Avec [Artifacts](/fr/products/wandb/artifacts), vous pouvez stocker gratuitement jusqu’à 100 Go de modèles et de jeux de données, puis utiliser le [registre](/fr/products/registry) W\&B. Le registre vous permet d’enregistrer des modèles pour les explorer et les évaluer, les préparer au staging ou les déployer dans votre environnement de production.

Pour journaliser les points de contrôle de votre modèle Hugging Face dans Artifacts, définissez la variable d’environnement `WANDB_LOG_MODEL` sur *l’une* des valeurs suivantes :

* **`checkpoint`** : téléverse un point de contrôle toutes les `args.save_steps` étapes, telles que définies dans les [`TrainingArguments`](https://huggingface.co/docs/transformers/main/en/main_classes/trainer#transformers.TrainingArguments).
* **`end`** : téléverse le modèle à la fin de l’entraînement, si `load_best_model_at_end` est également défini.
* **`false`** : ne téléverse pas le modèle.

<Tabs>
  <Tab title="Ligne de commande">
    ```bash theme={"system"}
    WANDB_LOG_MODEL="checkpoint"
    ```
  </Tab>

  <Tab title="Python">
    ```python theme={"system"}
    import os

    os.environ["WANDB_LOG_MODEL"] = "checkpoint"
    ```
  </Tab>

  <Tab title="Notebook Python">
    ```notebook theme={"system"}
    %env WANDB_LOG_MODEL="checkpoint"
    ```
  </Tab>
</Tabs>

Désormais, tout `Trainer` Transformers que vous initialisez téléverse les modèles dans votre projet W\&B. Les points de contrôle de modèle que vous journalisez sont consultables dans l’interface [Artifacts](/fr/products/wandb/artifacts) et incluent la traçabilité complète du modèle. Voir un [exemple de point de contrôle de modèle dans l’interface Artifacts](https://forge.coreweave.com/wandb/wandb/arttest/artifacts/model/iv3_trained/5334ab69740f9dda4fed/lineage?_gl=1*yyql5q*_ga*MTQxOTYyNzExOS4xNjg0NDYyNzk1*_ga_JH1SJHJQXJ*MTY5MjMwNzI2Mi4yNjkuMS4xNjkyMzA5NjM2LjM3LjAuMA..).

<Note>
  Par défaut, votre modèle est enregistré dans W\&B Artifacts sous le nom `model-{run_id}` lorsque `WANDB_LOG_MODEL` est défini sur `end`, ou sous le nom `checkpoint-{run_id}` lorsque `WANDB_LOG_MODEL` est défini sur `checkpoint`.
  Toutefois, si vous transmettez un [`run_name`](https://huggingface.co/docs/transformers/main/en/main_classes/trainer#transformers.TrainingArguments.run_name) dans vos `TrainingArguments`, le modèle est enregistré sous le nom `model-{run_name}` ou `checkpoint-{run_name}`.
</Note>

<h4 id="registry">
  Registre
</h4>

Après avoir journalisé vos points de contrôle dans Artifacts, vous pouvez enregistrer les points de contrôle de vos meilleurs modèles et les centraliser au sein de votre équipe grâce au [registre](/fr/products/registry). Le registre vous permet d’organiser vos meilleurs modèles par tâche, de gérer le cycle de vie des modèles, de suivre et d’auditer l’ensemble du cycle de vie ML, et d’[automatiser](/fr/products/wandb/automations) les actions en aval.

Pour lier un artifact de modèle, reportez-vous au [registre](/fr/products/registry).

<h3 id="visualize-evaluation-outputs-during-training">
  Visualiser les sorties d’évaluation pendant l’entraînement
</h3>

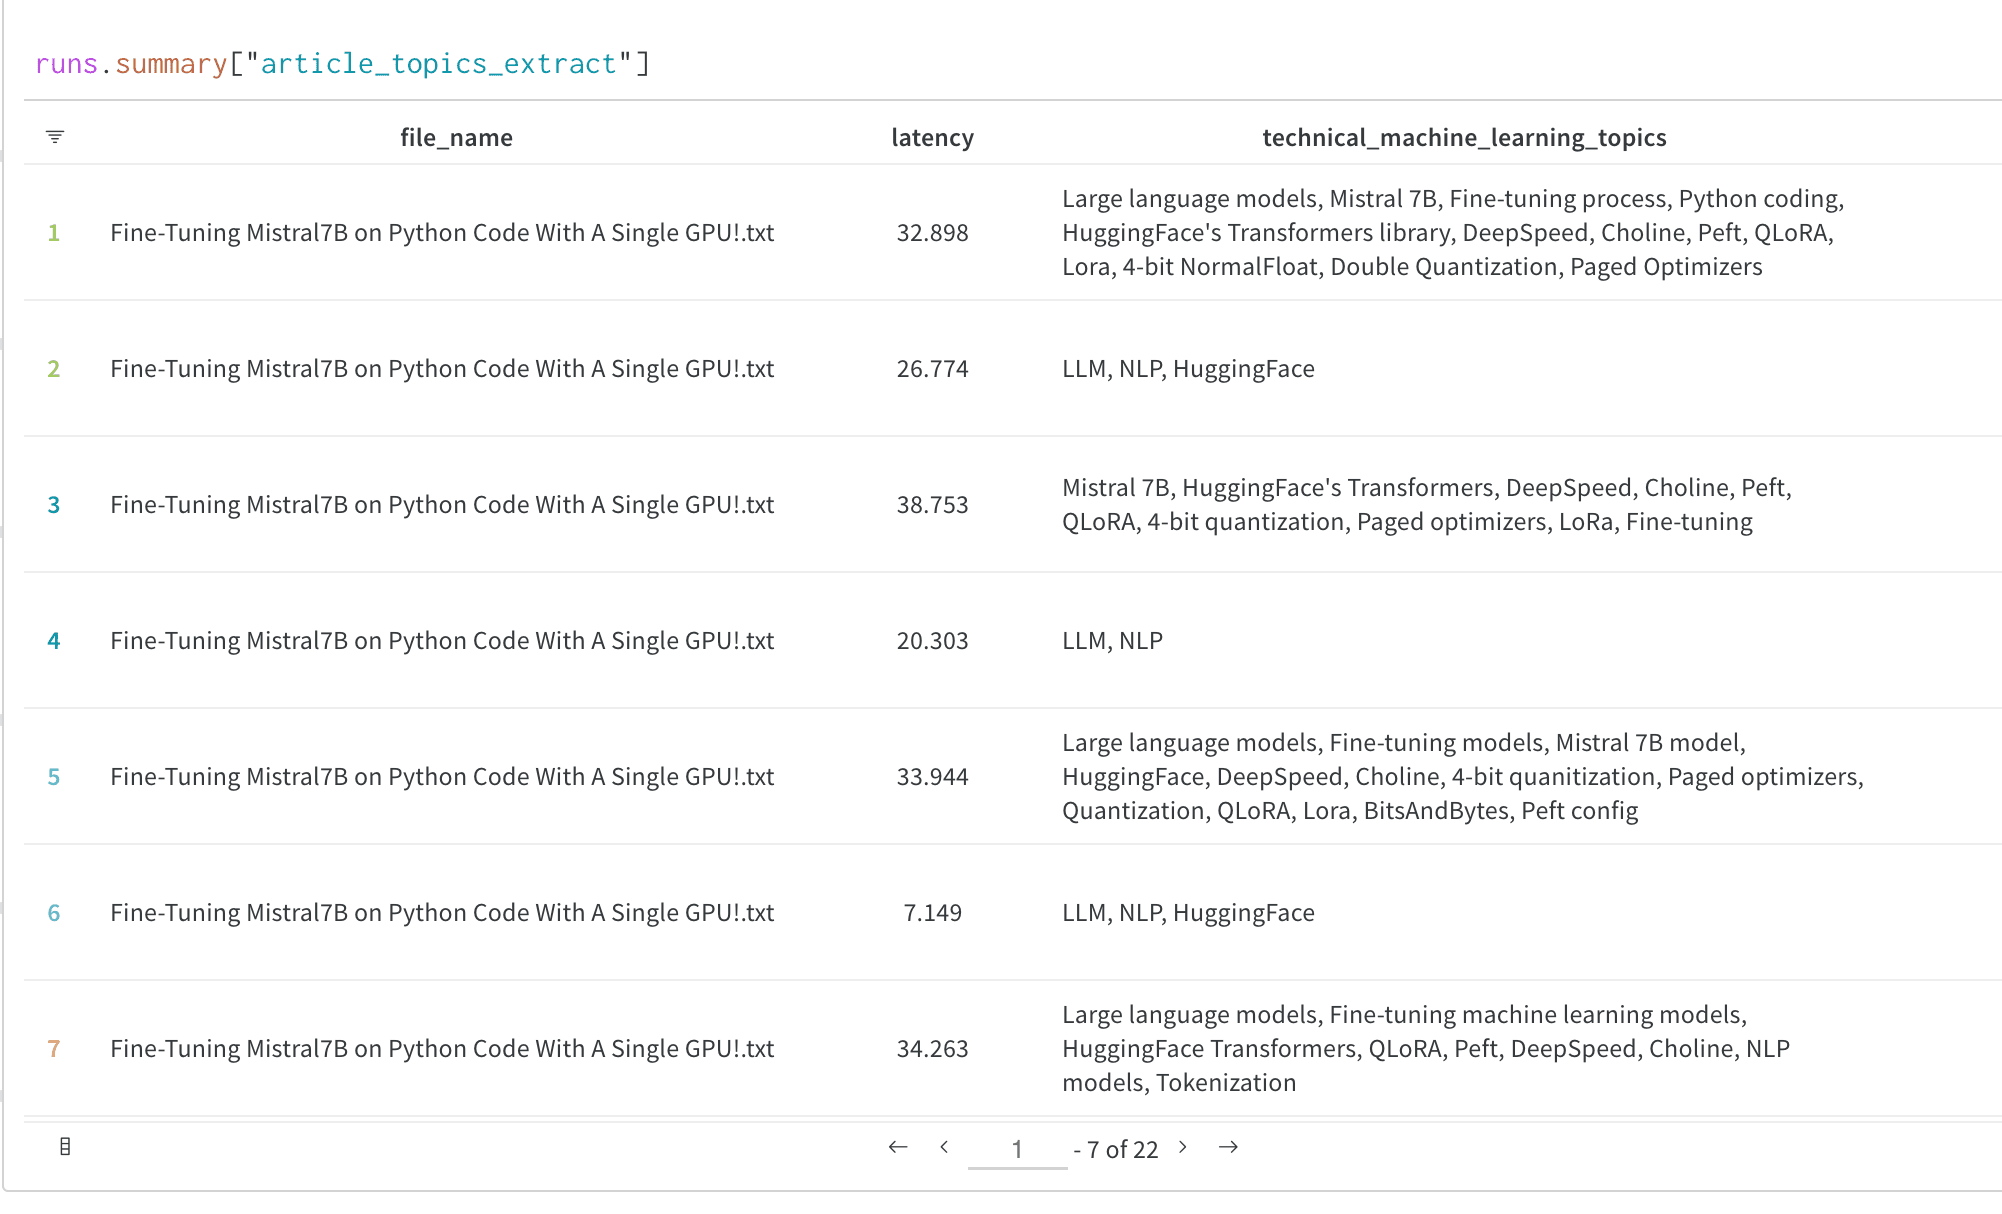
Visualiser les sorties de votre modèle pendant l’entraînement ou l’évaluation est souvent indispensable pour comprendre comment il apprend. En examinant des prédictions concrètes parallèlement aux courbes de perte, vous pouvez repérer des problèmes de qualité que les métriques agrégées risquent de masquer.

Grâce au système de callbacks du Trainer de Transformers, vous pouvez journaliser des données plus utiles dans des tableaux W\&B, par exemple les textes générés par vos modèles ou d’autres prédictions.

Pour un guide complet expliquant comment journaliser les sorties d’évaluation pendant l’entraînement dans un tableau W\&B comme celui ci-dessous, consultez [Journaliser et afficher des échantillons d’évaluation pendant l’entraînement](#log-and-view-evaluation-samples-during-training).
<Frame>
  <img src="https://mintcdn.com/coreweave-dbfa0e8d/3Dv_sw2eg8feUJlx/products/wandb/_media/huggingface_eval_tables.png?fit=max&auto=format&n=3Dv_sw2eg8feUJlx&q=85&s=5d5fcf760a5b8770fe1253e3dcf0d80c" alt="Tableau W&B contenant des sorties d’évaluation" width="2002" height="1214" data-path="products/wandb/_media/huggingface_eval_tables.png" />
</Frame>

<h3 id="finish-your-wb-run-notebook-only">
  Terminer votre run W\&B (notebook uniquement)
</h3>

Si votre entraînement est contenu dans un script Python, le run W\&B se termine à la fin de l’exécution du script.

Si vous utilisez un notebook Jupyter ou Google Colab, appelez `run.finish()` pour signaler la fin de l’entraînement.

```python theme={"system"}
run = wandb.init()
trainer.train()  # lance l'entraînement et la journalisation dans W&B

# analyse post-entraînement, tests, autre code journalisé

run.finish()
```

<h3 id="visualize-your-results">
  Visualiser vos résultats
</h3>

Après avoir journalisé vos résultats d’entraînement, vous pouvez les explorer dans le [tableau de bord W\&B](/fr/products/wandb/track/workspaces). Vous pouvez comparer des runs, examiner vos constats en détail et explorer vos données à l’aide de visualisations interactives.

À ce stade, votre intégration est fonctionnelle : votre `Trainer` journalise les métriques dans un projet nommé, enregistre éventuellement des points de contrôle dans Artifacts et affiche les sorties d’évaluation dans le tableau de bord W\&B.

<h2 id="advanced-features-and-faqs">
  Fonctionnalités avancées et FAQ
</h2>

Les sections suivantes présentent des tâches complémentaires courantes, comme l’enregistrement du meilleur modèle, la reprise de l’entraînement à partir d’un point de contrôle, la personnalisation des callbacks de journalisation et la configuration du comportement de W\&B à l’aide de variables d’environnement.

<h3 id="save-the-best-model">
  Enregistrer le meilleur modèle
</h3>

Si vous transmettez `TrainingArguments` avec `load_best_model_at_end=True` à votre `Trainer`, W\&B enregistre le point de contrôle du modèle le plus performant en tant qu’artifact.

Si vous enregistrez les points de contrôle de votre modèle en tant qu’artifacts, vous pouvez les promouvoir dans le [registre](/fr/products/registry). Dans le registre, vous pouvez :

* Organiser les versions de vos meilleurs modèles par tâche de ML.
* Centraliser les modèles et les partager avec votre équipe.
* Préparer des modèles pour la production ou les marquer en vue d’une évaluation ultérieure.
* Déclencher des processus CI/CD en aval.

<h3 id="load-a-saved-model">
  Charger un modèle enregistré
</h3>

Si vous avez enregistré votre modèle dans W\&B Artifacts avec `WANDB_LOG_MODEL`, vous pouvez télécharger ses poids pour poursuivre l’entraînement ou effectuer de l’inférence. Rechargez-les ensuite dans la même architecture Hugging Face que celle utilisée précédemment.

```python theme={"system"}
# Créer un nouveau run
with wandb.init(project="amazon_sentiment_analysis") as run:
    # Transmettre le nom et la version de l’artifact
    my_model_name = "model-bert-base-high-lr:latest"
    my_model_artifact = run.use_artifact(my_model_name)

    # Télécharger les poids du modèle dans un dossier et renvoyer son chemin
    model_dir = my_model_artifact.download()

    # Charger votre modèle Hugging Face depuis ce dossier
    #  avec la même classe de modèle
    model = AutoModelForSequenceClassification.from_pretrained(
        model_dir, num_labels=num_labels
    )

    # Poursuivre l’entraînement ou lancer l’inférence
```

<h3 id="resume-training-from-a-checkpoint">
  Reprendre l’entraînement à partir d’un point de contrôle
</h3>

Si vous avez défini `WANDB_LOG_MODEL='checkpoint'`, vous pouvez reprendre l’entraînement en indiquant `model_dir` comme argument `model_name_or_path` dans vos `TrainingArguments` et en passant `resume_from_checkpoint=True` à `Trainer`.

```python theme={"system"}
last_run_id = "xxxxxxxx"  # récupérer le run_id dans votre workspace wandb

# reprendre le run wandb à partir du run_id
with wandb.init(
    project=os.environ["WANDB_PROJECT"],
    id=last_run_id,
    resume="must",
) as run:
    # Associer un artifact au run
    my_checkpoint_name = f"checkpoint-{last_run_id}:latest"
    my_checkpoint_artifact = run.use_artifact(my_checkpoint_name)

    # Télécharger le point de contrôle dans un dossier et renvoyer le chemin
    checkpoint_dir = my_checkpoint_artifact.download()

    # réinitialiser votre modèle et votre trainer
    model = AutoModelForSequenceClassification.from_pretrained(
        "<model-name>", num_labels=num_labels
    )
    # indiquer ici vos arguments d’entraînement.
    training_args = TrainingArguments()

    trainer = Trainer(model=model, args=training_args)

    # veiller à utiliser le répertoire du point de contrôle pour reprendre l’entraînement à partir de celui-ci
    trainer.train(resume_from_checkpoint=checkpoint_dir)
```

<h3 id="log-and-view-evaluation-samples-during-training">
  Journaliser et afficher des échantillons d’évaluation pendant l’entraînement
</h3>

Le [`WandbCallback`](https://huggingface.co/transformers/main_classes/callback.html#transformers.integrations.WandbCallback) de la bibliothèque Transformers gère la journalisation vers W\&B via le `Trainer` de Transformers. Vous pouvez personnaliser ce callback pour journaliser les prédictions du modèle, des matrices de confusion ou d’autres données personnalisées. Pour ce faire, créez une sous-classe de `WandbCallback` et ajoutez-y des fonctionnalités qui s’appuient sur d’autres méthodes de la classe Trainer.

Voici le schéma général pour ajouter ce nouveau callback au Trainer de Hugging Face, suivi d’un exemple de code complet qui journalise les sorties d’évaluation dans un tableau W\&B :

```python theme={"system"}
# Instancier le Trainer comme d’habitude
trainer = Trainer()

# Instancier le nouveau callback de journalisation en lui passant l’objet Trainer
evals_callback = WandbEvalsCallback(trainer, tokenizer, ...)

# Ajouter le callback au Trainer
trainer.add_callback(evals_callback)

# Lancer l’entraînement avec le Trainer comme d’habitude
trainer.train()
```

<h4 id="view-evaluation-samples-during-training">
  Afficher des échantillons d’évaluation pendant l’entraînement
</h4>

Cette section montre comment personnaliser le `WandbCallback` pour exécuter des prédictions du modèle et journaliser des échantillons d’évaluation dans un tableau W\&B pendant l’entraînement. Ce traitement s’exécute toutes les `eval_steps` étapes via la méthode `on_evaluate` du callback du Trainer.

La fonction `decode_predictions` décode les prédictions et les étiquettes issues de la sortie du modèle à l’aide du tokenizer.

Le code crée ensuite un DataFrame pandas à partir des prédictions et des étiquettes, puis y ajoute une colonne `epoch`.

Enfin, le code crée une `wandb.Table` à partir du DataFrame et la journalise dans W\&B. Pour contrôler la fréquence de journalisation, journalisez les prédictions toutes les `freq` époques.

<Note>
  Contrairement au `WandbCallback` standard, ce callback personnalisé doit être ajouté au trainer **après** l’instanciation du `Trainer`, et non pendant son initialisation. En effet, l’instance du `Trainer` est transmise au callback lors de l’initialisation de ce dernier.
</Note>

```python theme={"system"}
from transformers.integrations import WandbCallback
import pandas as pd


def decode_predictions(tokenizer, predictions):
    labels = tokenizer.batch_decode(predictions.label_ids)
    logits = predictions.predictions.argmax(axis=-1)
    prediction_text = tokenizer.batch_decode(logits)
    return {"labels": labels, "predictions": prediction_text}


class WandbPredictionProgressCallback(WandbCallback):
    """Custom WandbCallback to log model predictions during training.

    This callback logs model predictions and labels to a wandb.Table at each
    logging step during training. It allows to visualize the
    model predictions as the training progresses.

    Attributes:
        trainer (Trainer): The Hugging Face Trainer instance.
        tokenizer (AutoTokenizer): The tokenizer associated with the model.
        sample_dataset (Dataset): A subset of the validation dataset
          for generating predictions.
        num_samples (int, optional): Number of samples to select from
          the validation dataset for generating predictions. Defaults to 100.
        freq (int, optional): Frequency of logging. Defaults to 2.
    """

    def __init__(self, trainer, tokenizer, val_dataset, num_samples=100, freq=2):
        """Initializes the WandbPredictionProgressCallback instance.

        Args:
            trainer (Trainer): The Hugging Face Trainer instance.
            tokenizer (AutoTokenizer): The tokenizer associated
              with the model.
            val_dataset (Dataset): The validation dataset.
            num_samples (int, optional): Number of samples to select from
              the validation dataset for generating predictions.
              Defaults to 100.
            freq (int, optional): Frequency of logging. Defaults to 2.
        """
        super().__init__()
        self.trainer = trainer
        self.tokenizer = tokenizer
        self.sample_dataset = val_dataset.select(range(num_samples))
        self.freq = freq

    def on_evaluate(self, args, state, control, **kwargs):
        super().on_evaluate(args, state, control, **kwargs)
        # contrôler la fréquence de journalisation en journalisant les prédictions
        # toutes les `freq` époques
        if state.epoch % self.freq == 0:
            # générer les prédictions
            predictions = self.trainer.predict(self.sample_dataset)
            # décoder les prédictions et les étiquettes
            predictions = decode_predictions(self.tokenizer, predictions)
            # ajouter les prédictions à un wandb.Table
            predictions_df = pd.DataFrame(predictions)
            predictions_df["epoch"] = state.epoch
            records_table = self._wandb.Table(dataframe=predictions_df)
            # journaliser le tableau dans wandb
            self._wandb.log({"sample_predictions": records_table})


# Instancier d'abord le Trainer
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=lm_datasets["train"],
    eval_dataset=lm_datasets["validation"],
)

# Instancier le WandbPredictionProgressCallback
progress_callback = WandbPredictionProgressCallback(
    trainer=trainer,
    tokenizer=tokenizer,
    val_dataset=lm_dataset["validation"],
    num_samples=10,
    freq=2,
)

# Ajouter le callback au Trainer
trainer.add_callback(progress_callback)
```

Pour un exemple plus détaillé, consultez ce [Colab](https://colab.research.google.com/github/wandb/examples/blob/master/colabs/huggingface/Custom_Progress_Callback.ipynb).

<h3 id="additional-wb-settings">
  Paramètres W\&B supplémentaires
</h3>

Vous pouvez configurer plus finement ce qui est journalisé avec `Trainer` en définissant des variables d’environnement. Pour obtenir la liste complète des variables d’environnement W\&B, consultez la [référence des variables d’environnement](/fr/products/wandb/platform/hosting/env-vars).

| Variable d’environnement | Utilisation |
| - | - |
| `WANDB_PROJECT` | Nom de votre projet (`huggingface` par défaut) |
| `WANDB_LOG_MODEL` | <p>Journalise le point de contrôle du modèle en tant qu’artifact W\&B (`false` par défaut) </p><ul><li><code>false</code> (par défaut) : aucun enregistrement des points de contrôle du modèle </li><li><code>checkpoint</code> : téléverse un point de contrôle toutes les `args.save_steps` étapes (valeur définie dans les `TrainingArguments` du Trainer). </li><li><code>end</code> : téléverse le point de contrôle final du modèle à la fin de l’entraînement.</li></ul> |
| `WANDB_WATCH` | <p>Indique s’il faut journaliser les gradients de votre modèle, ses paramètres, ou ni l’un ni l’autre.</p><ul><li><code>false</code> (par défaut) : aucune journalisation des gradients ni des paramètres </li><li><code>gradients</code> : journalise les histogrammes des gradients </li><li><code>all</code> : journalise les histogrammes des gradients et des paramètres</li></ul> |
| `WANDB_DISABLED` | Définissez sur `true` pour désactiver entièrement la journalisation (`false` par défaut) |
| `WANDB_QUIET` | Définissez sur `true` pour limiter les messages écrits sur la sortie standard aux seuls messages critiques (`false` par défaut) |
| `WANDB_SILENT` | Définissez sur `true` pour masquer la sortie affichée par `wandb` (`false` par défaut) |

<Tabs>
  <Tab title="Ligne de commande">
    ```bash theme={"system"}
    WANDB_WATCH=all
    WANDB_SILENT=true
    ```
  </Tab>

  <Tab title="Notebook">
    ```notebook theme={"system"}
    %env WANDB_WATCH=all
    %env WANDB_SILENT=true
    ```
  </Tab>
</Tabs>

<h3 id="customize-wandbinit">
  Personnaliser `wandb.init()`
</h3>

Le `WandbCallback` utilisé par `Trainer` appelle `wandb.init()` en arrière-plan lors de l’initialisation de `Trainer`. Vous pouvez aussi configurer vos runs manuellement en appelant `wandb.init()` avant l’initialisation de `Trainer`. Vous gardez ainsi un contrôle complet sur la configuration de votre run W\&B.

Voici un exemple de ce que vous pouvez passer à `init`. Pour plus de détails sur `wandb.init()`, consultez la [référence de `wandb.init()`](/fr/products/wandb/ref/python/functions/init).

```python theme={"system"}
wandb.init(
    project="amazon_sentiment_analysis",
    name="bert-base-high-lr",
    tags=["baseline", "high-lr"],
    group="bert",
)
```

<h2 id="additional-resources">
  Ressources supplémentaires
</h2>

Pour aller plus loin, voici six articles consacrés à Transformers et à W\&B.

<details>
  <summary>Optimisation des hyperparamètres pour Hugging Face Transformers</summary>

  * Compare trois stratégies d’optimisation des hyperparamètres pour Hugging Face Transformers : la recherche sur grille, l’optimisation bayésienne et le Population Based Training.
  * Utilise un modèle BERT uncased standard de Hugging Face Transformers, affiné sur le jeu de données RTE du benchmark SuperGLUE.
  * Les résultats montrent que le Population Based Training est l’approche la plus efficace pour optimiser les hyperparamètres du modèle Hugging Face Transformers.

  Lisez le [rapport Hyperparameter Optimization for Hugging Face Transformers](https://forge.coreweave.com/wandb/amogkam/transformers/reports/Hyperparameter-Optimization-for-Hugging-Face-Transformers--VmlldzoyMTc2ODI).
</details>

<details>
  <summary>Hugging Tweets : entraîner un modèle à générer des tweets</summary>

  * Dans cet article, l’auteur montre comment effectuer en cinq minutes le fine-tuning d’un modèle Hugging Face Transformer GPT2 pré-entraîné sur les tweets de n’importe quel compte.
  * Le modèle suit le pipeline suivant : téléchargement des tweets, optimisation du jeu de données, premières expériences, comparaison des pertes entre utilisateurs et fine-tuning du modèle.

  Lisez le [rapport HuggingTweets](https://forge.coreweave.com/wandb/wandb/huggingtweets/reports/HuggingTweets-Train-a-Model-to-Generate-Tweets--VmlldzoxMTY5MjI).
</details>

<details>
  <summary>Classification de phrases avec Hugging Face BERT et WB</summary>

  * Cet article construit un classificateur de phrases en tirant parti des avancées récentes du traitement automatique du langage naturel, avec un accent sur l’application de l’apprentissage par transfert au NLP.
  * Utilise le jeu de données Corpus of Linguistic Acceptability (CoLA) pour la classification de phrases isolées : un ensemble de phrases étiquetées comme grammaticalement correctes ou incorrectes, publié pour la première fois en mai 2018.
  * Utilise BERT de Google pour créer, avec un effort minimal, des modèles performants sur un éventail de tâches de NLP.

  Lisez le [rapport Sentence Classification With Hugging Face BERT and W\&B](https://forge.coreweave.com/wandb/cayush/bert-finetuning/reports/Sentence-Classification-With-Huggingface-BERT-and-W-B--Vmlldzo4MDMwNA).
</details>

<details>
  <summary>Guide étape par étape pour suivre les performances d’un modèle Hugging Face</summary>

  * Utilise W\&B et Hugging Face Transformers pour entraîner sur le benchmark GLUE DistilBERT, un Transformer 40 % plus petit que BERT qui conserve pourtant 97 % de sa précision.
  * Le benchmark GLUE est une collection de neuf jeux de données et tâches destinés à l’entraînement de modèles de NLP.

  Lisez le [rapport Tracking Hugging Face Model Performance](https://forge.coreweave.com/wandb/jxmorris12/huggingface-demo/reports/A-Step-by-Step-Guide-to-Tracking-HuggingFace-Model-Performance--VmlldzoxMDE2MTU).
</details>

<details>
  <summary>Exemples d’arrêt anticipé dans HuggingFace</summary>

  * Vous pouvez effectuer le fine-tuning d’un Hugging Face Transformer avec la régularisation par arrêt anticipé (Early Stopping), de manière native dans PyTorch ou TensorFlow.
  * Le callback `tf.keras.callbacks.EarlyStopping` simplifie l’utilisation d’EarlyStopping dans TensorFlow.
  * PyTorch ne fournit pas de méthode d’arrêt anticipé prête à l’emploi, mais un hook d’arrêt anticipé fonctionnel est disponible sur GitHub Gist.

  Lisez le [rapport Early Stopping in Hugging Face](https://forge.coreweave.com/wandb/ayush-thakur/huggingface/reports/Early-Stopping-in-HuggingFace-Examples--Vmlldzo0MzE2MTM).
</details>

<details>
  <summary>Comment effectuer le fine-tuning de Hugging Face Transformers sur un jeu de données personnalisé</summary>

  Effectue le fine-tuning d’un transformer DistilBERT pour l’analyse de sentiments (classification binaire) sur un jeu de données IMDB personnalisé.

  Lisez le [rapport Fine-Tune Hugging Face Transformers on a Custom Dataset](https://forge.coreweave.com/wandb/ayush-thakur/huggingface/reports/How-to-Fine-Tune-HuggingFace-Transformers-on-a-Custom-Dataset--Vmlldzo0MzQ2MDc).
</details>

<h2 id="get-help-or-request-features">
  Obtenir de l’aide ou demander des fonctionnalités
</h2>

Pour tout problème, toute question ou toute demande de fonctionnalité concernant l’intégration W\&B de Hugging Face, publiez un message dans [ce fil de discussion des forums Hugging Face](https://discuss.huggingface.co/t/logging-experiment-tracking-with-w-b/498) ou ouvrez une issue sur le [dépôt GitHub Transformers](https://github.com/huggingface/transformers) de Hugging Face.
