> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Agrégation des points
> Explorez l’échantillonnage par buckets en fidélité totale et l’échantillonnage aléatoire pour les graphiques en courbes Weights & Biases.
Utilisez les méthodes d’agrégation des points dans vos graphiques en courbes pour améliorer la précision et les performances de la visualisation des données. Cette page présente les deux modes d’agrégation disponibles et explique comment configurer chacun d’eux, afin que vous puissiez trouver le bon compromis entre niveau de détail et vitesse de rendu pour votre workspace. Deux modes d’agrégation des points sont disponibles : la [fidélité totale](#full-fidelity) et l’[échantillonnage aléatoire](#random-sampling). Par défaut, Weights & Biases utilise le mode fidélité totale.
Fidélité totale
La fidélité totale est la méthode d’agrégation par défaut ; elle préserve les valeurs extrêmes de vos données. Cette section explique le fonctionnement de la fidélité totale, ses principaux avantages et la manière de l’activer pour un seul graphique ou pour l’ensemble d’un workspace.
Lorsque vous utilisez le mode fidélité totale, Weights & Biases divise l’axe X en buckets dynamiques. Le nombre de points par courbe s’adapte à la taille du graphique et au nombre de runs. Weights & Biases calcule les valeurs minimale et maximale de chaque bucket (utilisées pour l’ombrage facultatif) et utilise la dernière valeur de chaque bucket (et non la moyenne) pour tracer la courbe principale.
Le mode fidélité totale pour l’agrégation des points présente trois avantages principaux :
* Préserver les valeurs extrêmes et les pics : conservez les valeurs extrêmes et les pics de vos données.
* Configurer le rendu des points minimum et maximum : utilisez la W\&B App pour choisir de manière interactive d’afficher ou non les valeurs extrêmes (min/max) sous forme de zone ombrée.
* Explorer vos données sans perte de fidélité : Weights & Biases recalcule la taille des buckets de l’axe X lorsque vous zoomez sur des points de données spécifiques. Vous pouvez ainsi explorer vos données sans perte de précision. Weights & Biases met en cache les agrégations déjà calculées afin de réduire les temps de chargement, ce qui s’avère utile lorsque vous parcourez de grands datasets.
Il existe deux modes de rendu des graphiques en courbes en fidélité totale :
* **Band** (par défaut) : affiche les valeurs minimale et maximale de chaque bucket sous forme de bande ombrée, tandis que la courbe montre la tendance générale.
* **Line** : relie directement les points, ce qui permet d’identifier plus facilement les pics et les creux.
Activer la fidélité totale
Weights & Biases utilise le mode fidélité totale par défaut. Pour le configurer manuellement, suivez ces étapes :
1. Accédez à votre workspace.
2. Sélectionnez l’icône d’engrenage dans le coin supérieur droit de l’écran, à gauche du bouton **Add panels**.
3. Dans le volet qui s’affiche, sélectionnez **Graphiques en courbes**.
4. Dans la section **Agrégation des points**, choisissez **Fidélité totale**.
5. Dans la liste déroulante **Affichage en fidélité totale**, sélectionnez **Band** ou **Line**.
6. Configurez l’algorithme et les paramètres de **Lissage**.
7. Définissez **Aggregation** sur **Mean**, **Min** ou **Max**.
8. Cliquez sur **Apply**.
1. Accédez à votre workspace.
2. Sélectionnez l’icône **Workspace** dans l’onglet de gauche.
3. Survolez le panneau de graphique linéaire à configurer, puis cliquez sur l’icône d’engrenage.
4. Dans la fenêtre modale qui s’affiche, définissez **Méthode d’agrégation des points** sur **Fidélité totale**.
5. Dans la liste déroulante **Affichage en fidélité totale**, sélectionnez **Band** ou **Line**.
6. Configurez l’algorithme et les paramètres de **Lissage**.
7. Cliquez sur **Apply**.
L’ombrage représente la variabilité au sein de chaque bucket, ce qui vous permet de voir dans quelle mesure les points se dispersent autour de la courbe. Dans un graphique en courbes en fidélité totale, les zones ombrées peuvent afficher :
* **Min/Max** : pour chaque point de l’axe X, la zone comprise entre les valeurs minimale et maximale est ombrée. La zone ombrée couvre tous les points de chaque bucket, de la valeur la plus basse à la plus haute :
```math theme={"system"}
\text{Min/Max Range} = [\min(x_1, x_2, \ldots, x_n),\ \max(x_1, x_2, \ldots, x_n)]
```
où $x_1, x_2, \ldots, x_n$ sont les valeurs d’un bucket donné.
* **Écart type** : pour chaque point de l’axe X, la variabilité des valeurs est calculée à l’aide de l’écart type, puis la zone obtenue est ombrée.
```math theme={"system"}
SD = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \overline{x})^2}
```
* **Erreur type** : pour chaque point de l’axe X, la probabilité d’une erreur d’échantillonnage est calculée en divisant la valeur par la racine carrée de la taille de l’échantillon :
```math theme={"system"}
SE = \frac{SD}{\sqrt{n}}
```
* **None** : aucun ombrage (valeur par défaut).
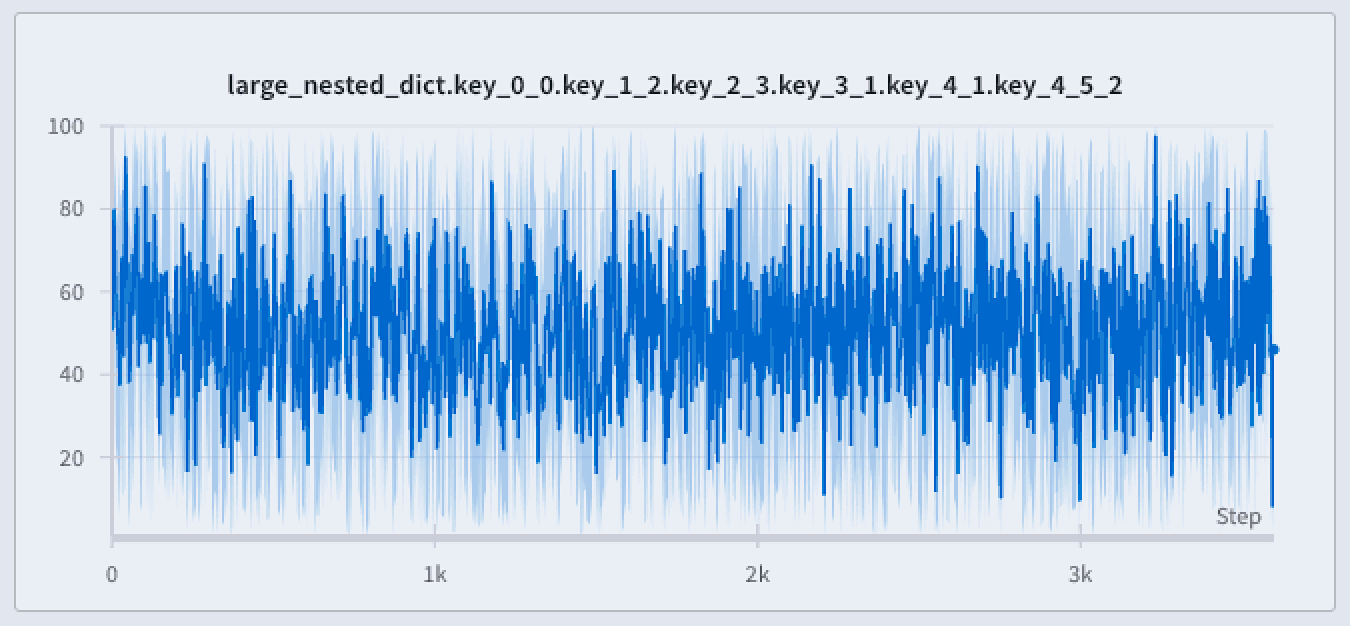
L’image suivante montre un graphique en courbes bleu. La zone ombrée bleu clair représente les valeurs minimale et maximale de chaque bucket.
 Pour configurer l’ombrage :
1. Accédez à votre workspace.
2. Survolez un graphique en courbes, puis cliquez sur l’icône d’engrenage.
3. Dans l’onglet **Data**, définissez **Agrégation des points** sur **Fidélité totale** si nécessaire, puis configurez l’algorithme de lissage.
4. Dans l’onglet **Grouping**, activez **Group runs**. Vous pouvez également définir **Group by** sur un attribut de run.
5. Définissez **Agg** sur **Mean** (par défaut), **Min** ou **Max**.
6. Définissez **Range** sur **Min/Max**, **Std Dev**, **Std Err** ou **None**.
7. Cliquez sur **Apply**.
Explorer vos données sans perdre en fidélité
Analysez des zones précises du dataset sans manquer de points critiques comme les valeurs extrêmes ou les pics. Lorsque vous zoomez sur un graphique en courbes, Weights & Biases ajuste la taille des buckets utilisés pour calculer la valeur minimale, la valeur maximale et la dernière valeur de chaque bucket.
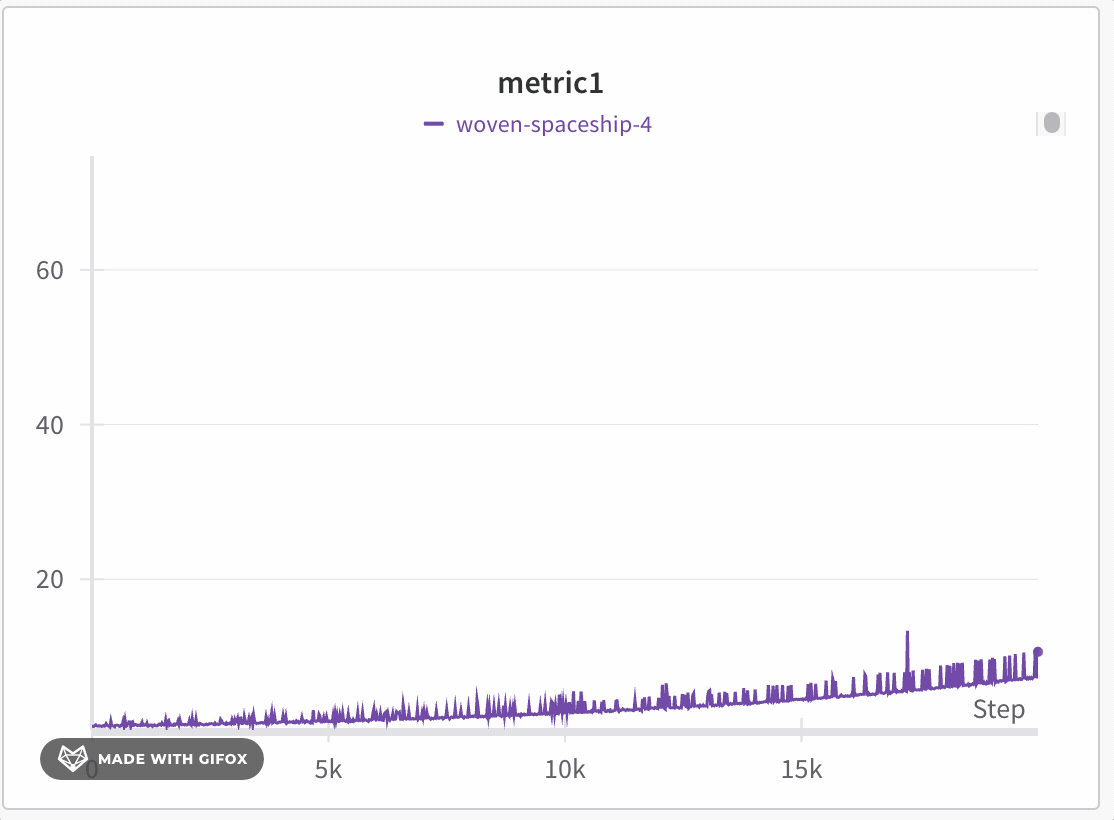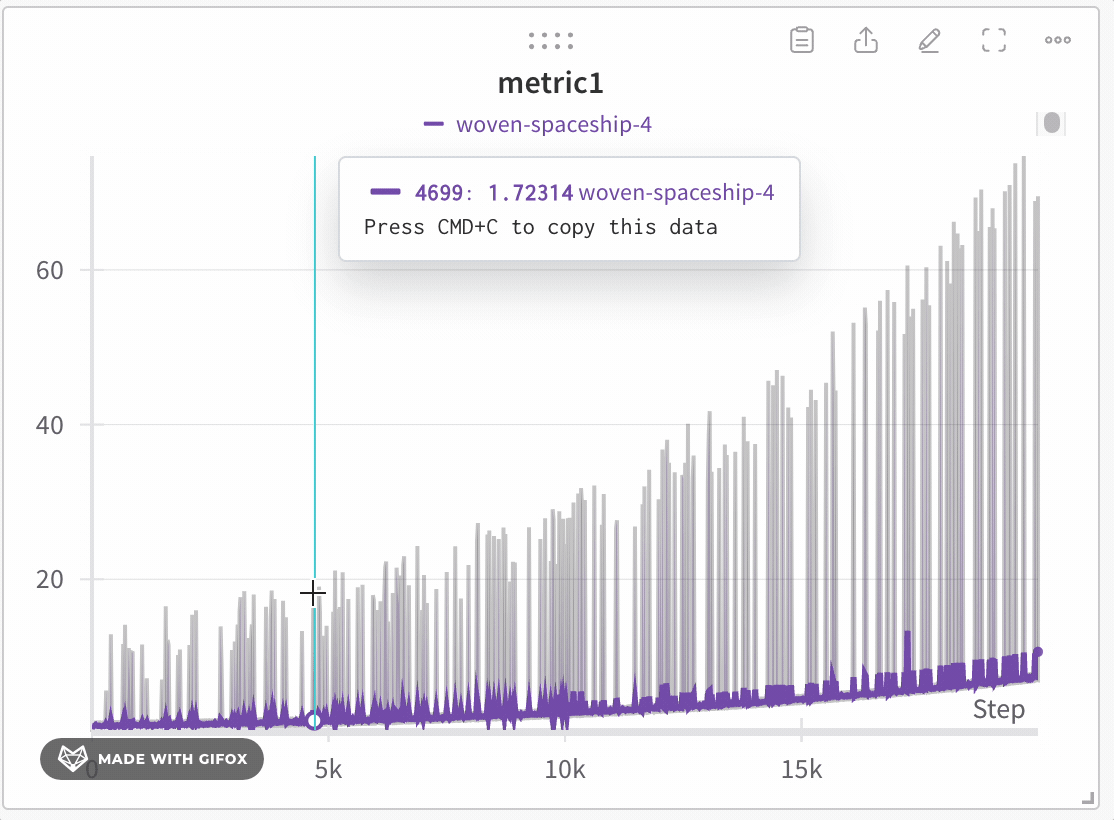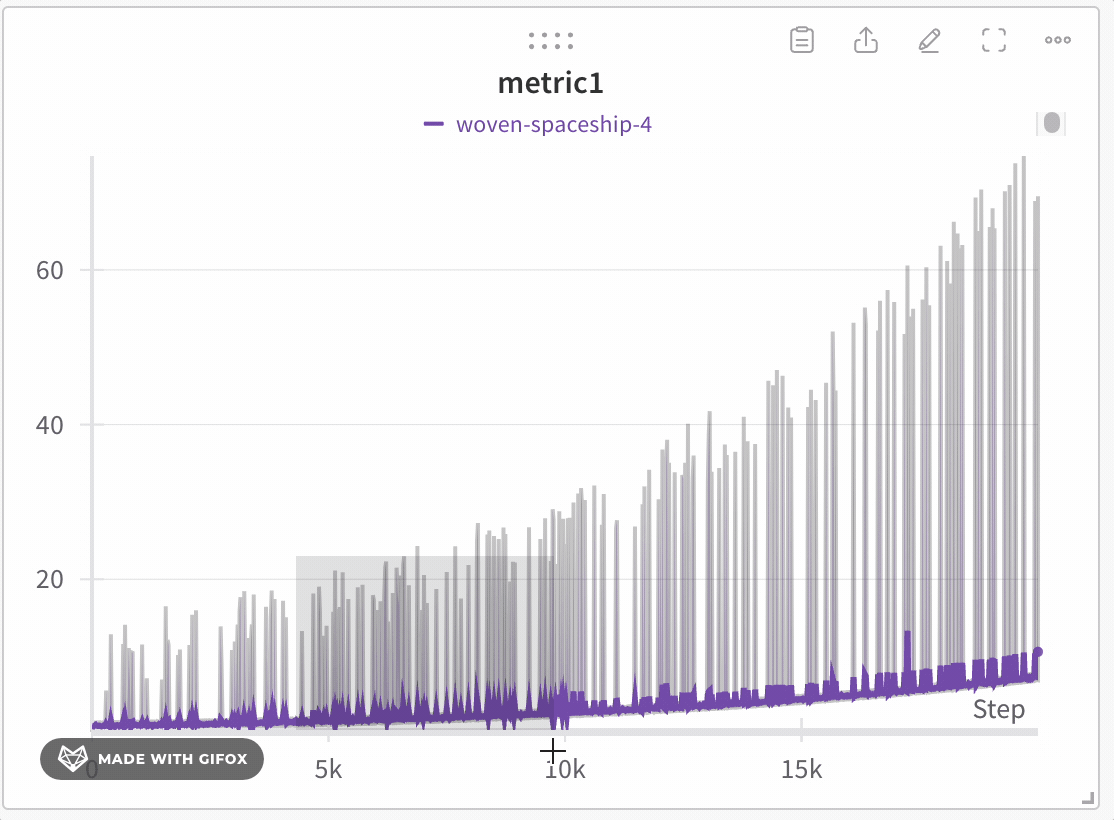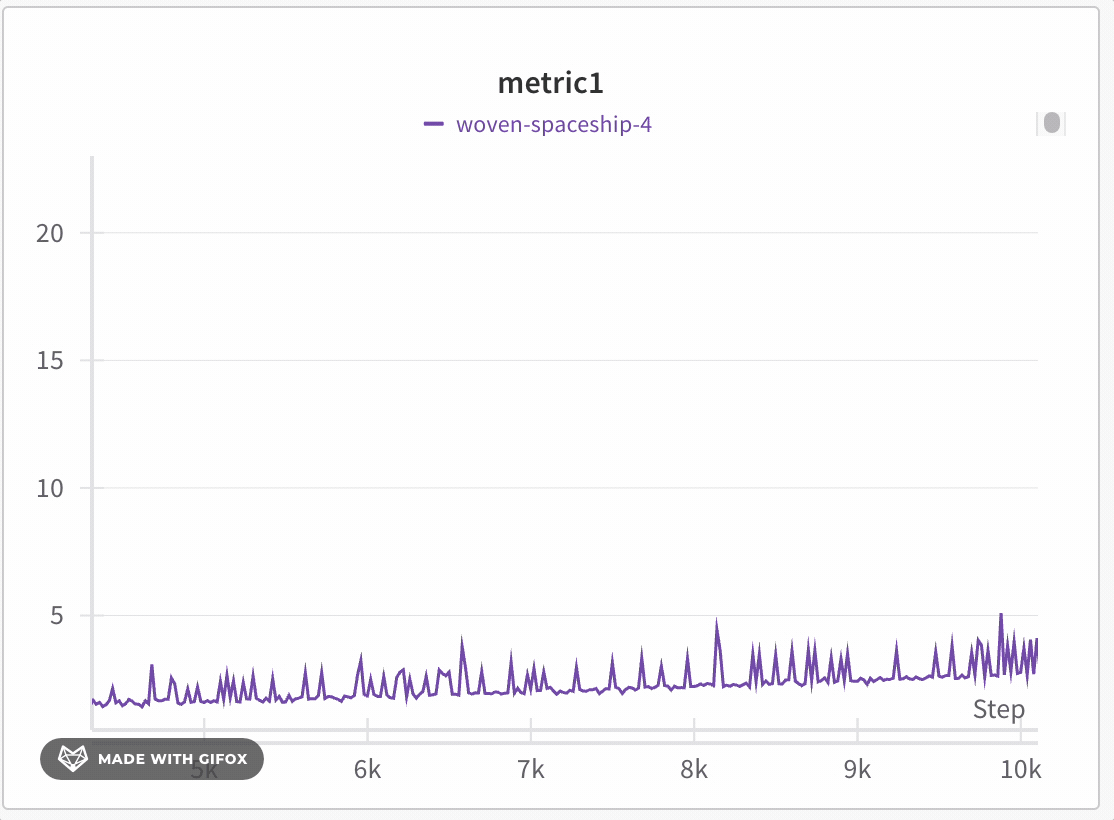 Weights & Biases utilise un regroupement dynamique pour diviser l’axe X en buckets. Le nombre de points affichés par courbe s’adapte à la taille du graphique et au nombre de runs : un graphique plus petit ou un plus grand nombre de runs peut réduire le nombre de points par courbe, afin que le graphique reste réactif et puisse afficher davantage de courbes. Pour chaque bucket, Weights & Biases calcule les valeurs suivantes :
* **Minimum** : la valeur la plus basse du bucket (utilisée pour l’ombrage).
* **Maximum** : la valeur la plus élevée du bucket (utilisée pour l’ombrage).
* **Valeur de la courbe** : la dernière valeur du bucket, utilisée pour tracer la courbe.
Weights & Biases trace les valeurs par buckets de manière à préserver une représentation complète des données et à inclure les valeurs extrêmes dans chaque graphique. La courbe est tracée à partir de la dernière valeur de chaque bucket. Si vous zoomez suffisamment, le mode fidélité totale peut afficher chaque point de données sans agrégation supplémentaire. Le seuil exact dépend des dimensions actuelles du graphique et du nombre de runs.
Pour zoomer sur un graphique en courbes, suivez ces étapes :
1. Accédez à votre projet Weights & Biases.
2. Sélectionnez l’icône **Workspace** dans l’onglet de gauche.
3. Facultatif : ajoutez un panneau de graphique linéaire à votre workspace ou accédez à un panneau de graphique linéaire existant.
4. Cliquez et faites glisser le pointeur pour sélectionner la zone à agrandir.
**Grouping et expressions des graphiques en courbes**
Lorsque vous utilisez le Grouping des graphiques en courbes, Weights & Biases applique les règles suivantes selon le mode sélectionné :
* **Échantillonnage sans fenêtre (Grouping)** : aligne les points des différents runs sur l’axe X. Weights & Biases calcule la moyenne si plusieurs points ont la même valeur x. Sinon, ils apparaissent comme des points distincts.
* **Échantillonnage par fenêtre (Grouping et expressions)** : divise l’axe X en 250 buckets ou en autant de buckets que de points dans la courbe la plus longue (la plus petite de ces deux valeurs étant retenue). Weights & Biases calcule la moyenne des points de chaque bucket.
* **Fidélité totale (Grouping et expressions)** : semblable à l’échantillonnage sans fenêtre, mais récupère jusqu’à 500 points par run afin de concilier performances et niveau de détail.
Échantillonnage aléatoire
L’échantillonnage aléatoire est une autre méthode d’agrégation, qui privilégie la vitesse de rendu au détriment de la fidélité des données. Utilisez-le lorsque vous avez besoin de graphiques plus rapides et qu’il n’est pas nécessaire de conserver chaque valeur extrême.
L’échantillonnage aléatoire utilise 1 500 points tirés au hasard pour effectuer le rendu des graphiques en courbes. Comme l’échantillonnage écarte des points, il devient plus difficile de repérer les valeurs aberrantes ou les pics.
L’échantillonnage aléatoire n’est pas déterministe. Il arrive donc qu’il exclue des valeurs aberrantes ou des pics dans les données, ce qui réduit la précision des données.
Activer l’échantillonnage aléatoire
Par défaut, Weights & Biases utilise le mode fidélité totale. Pour activer l’échantillonnage aléatoire, suivez ces étapes :
1. Accédez à votre projet Weights & Biases.
2. Sélectionnez l’icône **Workspace** dans la barre latérale gauche.
3. Sélectionnez l’icône d’engrenage dans le coin supérieur droit de l’écran, à gauche du bouton **Add panels**.
4. Dans le volet qui s’affiche, sélectionnez **Graphiques en courbes**.
5. Choisissez **Échantillonnage aléatoire** dans la section **Agrégation des points**.
1. Accédez à votre projet Weights & Biases.
2. Sélectionnez l’icône **Workspace** dans la barre latérale gauche.
3. Sélectionnez le panneau de graphique linéaire pour lequel vous souhaitez activer l’échantillonnage aléatoire.
4. Dans la fenêtre modale qui s’affiche, sélectionnez **Échantillonnage aléatoire** dans la section **Méthode d’agrégation des points**.
Accéder aux données non échantillonnées
Si l’échantillonnage aléatoire écarte des points dont vous avez besoin, vous pouvez tout de même accéder par programmation à l’historique complet et non échantillonné des métriques. L’[API publique](/fr/products/wandb/ref/python/public-api/runs) permet d’accéder à l’historique complet des métriques journalisées pendant un run. L’exemple suivant montre comment récupérer et traiter les valeurs de perte d’un run donné :
```python theme={"system"}
# Initialiser l’API W&B
api = wandb.Api()
run = api.run("l2k2/examples-numpy-boston/i0wt6xua")
# Récupérer l’historique de la métrique 'Loss'
history = run.scan_history(keys=["Loss"])
# Extraire de l’historique les valeurs de perte
losses = [row["Loss"] for row in history]
```